
Zusammenfassung
- Eric Dumazet ist derzeit als Maintainer für General Networking, TCP und Sockets in Linux verzeichnet und gehört außerdem dem Technical Steering Committee der Netdev Foundation an. Dabei handelt es sich um Verantwortlichkeiten, die mit anderen Maintainern und Reviewern geteilt werden, nicht um die alleinige Kontrolle über das Linux-Netzwerk.
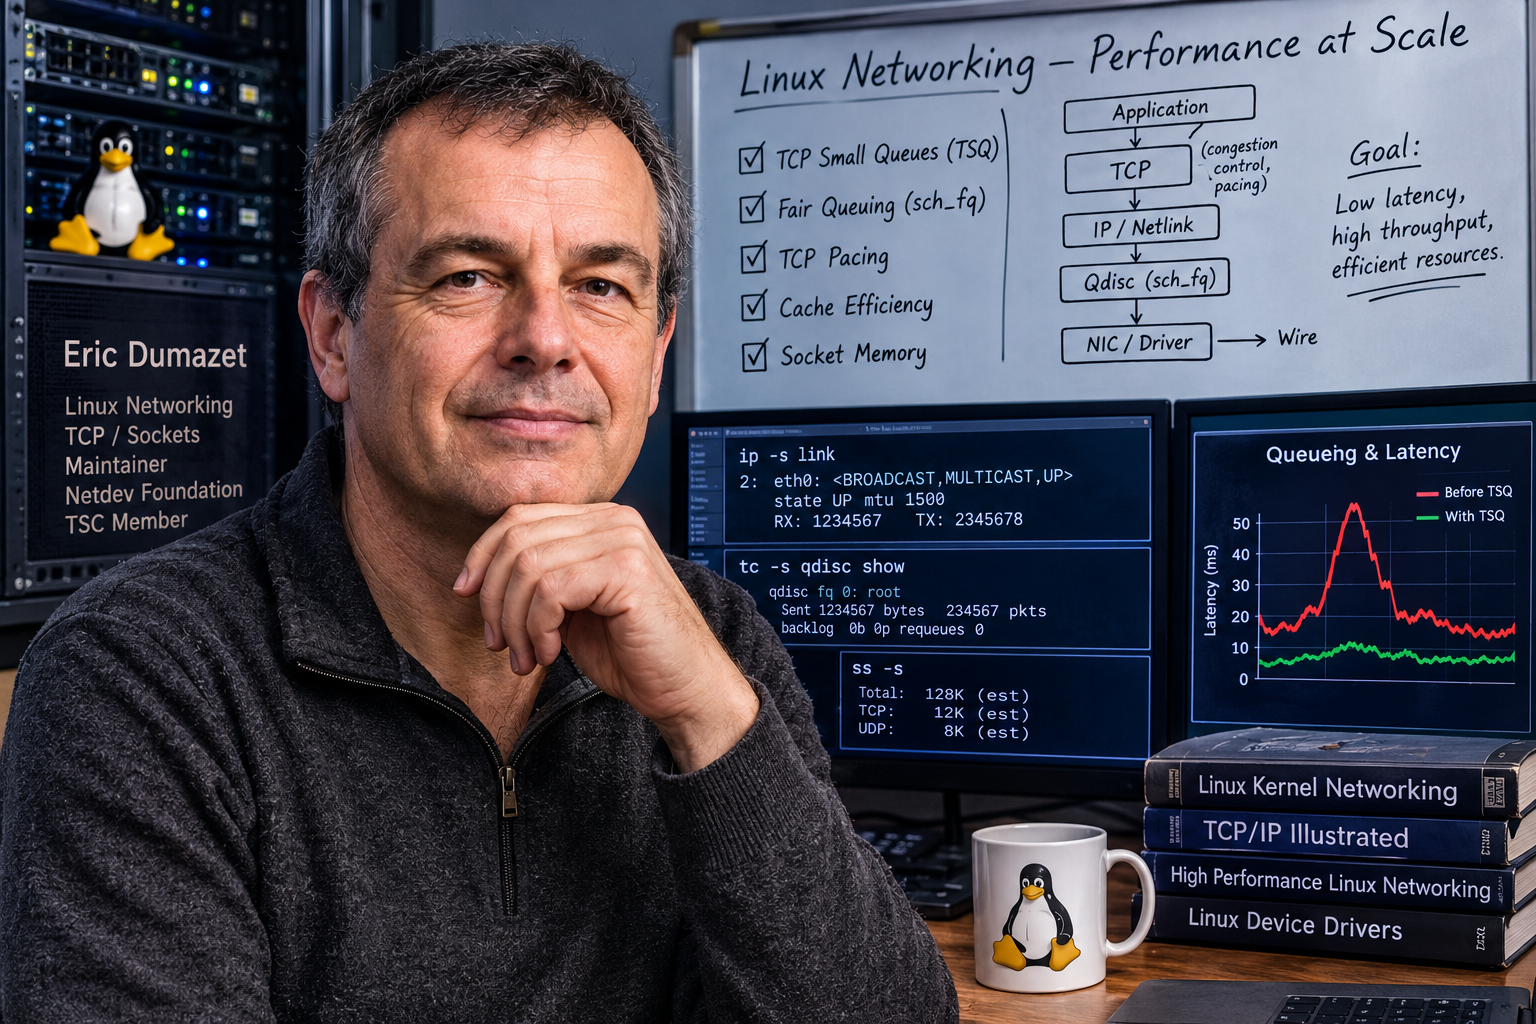
- Der am klarsten identifizierbare Beitrag sind die TCP Small Queues, die er mit einer Patch-Reihe von 2012 einführte. TSQ begrenzt, wie viele Daten ein einzelner TCP-Flow in die darunterliegenden Gerätewarteschlangen legen kann, und verknüpft das lokale Sendekontingent eines Sockets mit dem Abschluss von Paketen. Das reduziert Latenz und Speicherdruck auf der Sendeseite, beseitigt aber nicht alle Warteschlangen auf dem Pfad.
- Dumazets Arbeit an
sch_fqund dem TCP-internen Pacing machte nicht nur »wie viel gesendet wird«, sondern auch »wann gesendet wird« zu einem expliziten Steuerungsgegenstand. Fair Queuing trennt Flows, Pacing verteilt Pakete über die Zeit. Viele Congestion-Control-Verfahren, auch Umgebungen mit BBR, nutzen diese Grundlage; Entwurf und Autoren von BBR sind jedoch gesondert zu betrachten. - Öffentliche Forschungsarbeiten der letzten Jahre verbinden das Layout von Strukturen, die Bewegung von Cache-Zeilen und den Zustand pro Socket mit der Effizienz großer Flotten. Linux-Netzwerk ist auch Buchführung über CPU, Speicher, Warteschlangentiefe und Zeit. Die wirtschaftlichen Auswirkungen können erheblich sein, doch aus öffentlichen Unterlagen lassen sich keine Geldbeträge oder universellen Leistungsverbesserungen ableiten.
Auch schnelle Server warten hinter ihren eigenen Paketen
Der Ausgangspunkt der Geschichte ist nicht ein Titel, sondern die Sende-Warteschlangen eines Linux-Hosts. Eine Anwendung schreibt Daten, TCP entscheidet, dass mehr gesendet werden kann, und der Kernel übergibt sie an die unteren Schichten. Aus Sicht der Anwendung erscheinen sie als gesendet, tatsächlich können sie aber noch in derselben Maschine stecken.
Da die Linkauslastung hoch ist, bleibt das Problem leicht verborgen. Interaktive Anfragen warten hinter großen Übertragungen, Puffer belegen Speicher, und die von TCP angenommenen »Daten unterwegs im Netzwerk« weichen von den Daten ab, die lediglich im Host warten. TCP Small Queues begrenzen, wie viel ein Socket unterhalb von TCP ablegen darf, und erlauben neues Senden erst, wenn das Gerät die Verarbeitung tatsächlich abgeschlossen hat.
Öffentliche Aufzeichnungen beschreiben die Technik detailliert, füllen aber keine biografischen Lücken
Die stärksten Quellen zu Dumazet liegen in Linux selbst.MAINTAINERS, Patch-Diskussionen, offizielle Dokumentation, technische Vorträge und langjährige öffentliche Reviews belegen die aktuelle Verantwortung für General Networking, TCP und Sockets, seine Rolle bei der Netdev Foundation und eine in Maintainer-E-Mails erkennbare Verbindung zu Google.
Eine vollständige persönliche Biografie, eine aktuelle offizielle interne Stellenbezeichnung, die Gesamtzahl aller Patches und Reviews und die zeitliche Verteilung sind dagegen nicht bestätigt. Statt plausible Informationen zu ergänzen, ist es genauer, sich auf die nachprüfbare Arbeit zu konzentrieren. Gezeichnet wird hier keine markentaugliche Persönlichkeit, sondern ein Ingenieur, der Verantwortung in einem Prozess trug, in dem Entwürfe erst durch Reviews, Korrekturen, Tests und Bereitstellungen anderer zu gemeinsamer Infrastruktur wurden.
Die Maintainer-Rolle bringt Entscheidungen näher, stellt aber niemanden über die Gemeinschaft
Mit Stand 4. August 2026 führten die Linux-Aufzeichnungen Dumazet als Maintainer für General Networking, TCP und Sockets. Maintainer verlangen Neugestaltungen von Schnittstellen, lehnen Änderungen mit zu hohem Wartungsaufwand ab, wenden genehmigte Patches an und sind dafür verantwortlich, Subsysteme in den Mainline-Kernel zu überführen.
Dieselben Aufzeichnungen zeigen auch geteilte Zuständigkeiten. Für General Networking stehen David S. Miller, Jakub Kicinski und Paolo Abeni nebeneinander, TCP wird außerdem mit Neal Cardwell geteilt. Auch bei Architektur, Treibern, Sicherheit, Tests, Stable-Zweigen und dem endgültigen Mainline-Kernel gibt es unabhängige Entscheidungen. Dumazets Einfluss ist innerhalb dieser verteilten Grenzen gewachsen.
Als die Verbindungszahlen stiegen, wurden Linux-Details zur Frage der Serverökonomie
Auf einem kleinen Host fällt kaum auf, wenn eine Socket-Struktur einige Bytes größer ist oder ein Cache-Fehler mehr auftritt. Auf Servern mit Hunderttausenden Verbindungen vervielfacht sich dieser Unterschied und konkurriert mit Anwendungs-CPU, Speicherkapazität und Strom.
»Serverökonomie« meint hier keine veröffentlichten Geldbeträge. Gemeint sind betriebliche Ergebnisse: wie viele Verbindungen ein einzelner Rechner bewältigt, wie viel CPU die Netzwerkverarbeitung abzieht, wie viel Speicher der Socket-Zustand belegt und wie oft lokale Warteschlangen Latenzziele reißen. Distributionen und Betreiber wählen Kernel, qdisc, Congestion Control und Netzwerkkarte. Was Dumazet veränderte, ist die gemeinsame Grundlage dieser Entscheidungen.
Hinter der vertrauten Rolle von TCP steckt eine komplexe Ressourcenbuchführung
TCP wird als zuverlässiger Bytestrom beschrieben. Eine Implementierung muss zugleich Menge unbestätigter Daten, Übertragungswiederholungen, Speicherkontierung, Paketreihenfolge sowie die gemeinsame Nutzung von CPU und Warteschlangen festlegen.
Auch wenn das Protokoll korrekt ist, verschlechtert sich die Leistung durch lokale Rückstände, Bursts, Lock-Konflikte und cacheverschwendende Strukturen. Dumazets Arbeiten verbindet die Perspektive der Buchführung: Bytes werden dem Socket angelastet, bei Abschluss werden Gutschriften zurückgegeben, Sendezeitpunkte berechnet, Flows getrennt und heiße von kalten Feldern separiert. Das Ziel ist, Bandbreite zu nutzen, ohne im Host ein unkontrolliertes zweites Netz entstehen zu lassen.
Vor TSQ konnte die Sendeseite einen nicht selbst beherrschbaren Rückstau erzeugen
Vor TSQ konnte TCP große Datenmengen an qdisc und Treiber übergeben. Selbst wenn das Congestion Window für den gesamten Pfad angemessen war, blieben viele Pakete in lokalen Warteschlangen, und selbst bei dringenden Flows konnte die Anwendung nichts zurückholen.
Dieser Rückstau schwächt das Feedback. TCP beurteilt den Pfad anhand der ACKs des entfernten Endes, aber ein Teil der Daten hat den Host noch gar nicht verlassen. Wenn zahlreiche Flows dasselbe tun, wird außerdem Speicher verbraucht. Es brauchte einen Mechanismus, der hohen Durchsatz erhält und zugleich verhindert, dass jeder Socket die unteren Schichten als unbegrenztes Lager benutzt.
Die TSQ von 2012 gab das Budget lokaler Warteschlangen an den Socket zurück
Die TCP-Small-Queues-Patches von 2012 begrenzten, wie viele Daten jeder Socket unterhalb von TCP ablegen darf. Ist das Guthaben aufgebraucht, stoppt das Senden und setzt erst mit dem Abschluss von Paketen wieder ein.
Die Idee ist klein: Bytes zählen, die lokal abgelegt wurden, und Abschlüsse als Fortschritt der unteren Schichten behandeln. Entscheidend war jedoch, den Steuerungspunkt zurück in die Transportschicht zu verlagern, die Flows versteht. Es war nicht mehr nötig, große Batches vorab zu puffern, nur um die Verbindung auszulasten; Anwendungen erhielten ohne Änderungen disziplinierteres Verhalten.
Paketabschlüsse wurden zu praktischem Feedback im Inneren des Hosts
Ein Completion kann wie bloßes Aufräumen wirken. TSQ machte daraus ein Signal: Die unteren Schichten kommen voran, und neues Sendeguthaben kann gewährt werden.
Lokale Abschlüsse und ACKs des entfernten Endes liefern unterschiedliche Informationen. ACKs zeigen den Fortschritt des gesamten Pfads, Completions den Fortschritt unterhalb von TCP, und qdisc- oder NIC-Statistiken weisen auf andere Überlastungen hin. Mit einer einzigen Größe ist nicht alles erklärbar. TSQ nutzte eine davon, um lokale überhöhte Warteschlangen zu dämpfen.
TSQ verringerte einen Teil des Bufferbloats, nicht alle Warteschlangen auf dem Pfad
TSQ hat Bufferbloat nicht beseitigt. Ziel ist der Rückstau unterhalb von TCP auf der Sendeseite. In qdisc, Treibern, Netzwerkkarte, Zugangsnetz, Routern, Switches und auf der Empfangsseite gibt es weiterhin Warteschlangen.
Die präzise Beschreibung lautet: TSQ schwächte die Fähigkeit eines einzelnen Sockets, im Host eine große versteckte Warteschlange aufzubauen. Es reduziert Latenz und Speicherdruck und bringt den TCP-Zustand näher an den Gerätefortschritt, ersetzt aber weder Active Queue Management noch Congestion-Control jenseits des Endgeräts.
Schwellen, Offloading und Arbeitslasten bestimmen die Wirkung von TSQ
Die Wirkung von TSQ hängt von lokalen Obergrenzen, Paketgröße, qdisc, Gerätewarteschlangen, Segmentierung und Flow-Zusammensetzung ab. Kurze interaktive Kommunikation und stundenlange Massenreplikation führen zu unterschiedlichen Ergebnissen.
Auch die Implementierung ist nicht mehr die von 2012. Nachfolgende Entwickler haben umgebenden Code, Schwellen und Wechselwirkungen korrigiert. Der Ursprung ist Dumazet zuzuschreiben, zugleich muss festgehalten werden, dass der heutige Mechanismus ein Ergebnis gemeinsamer Wartung ist.
sch_fqtrennt Flows und bringt Zeit in die Planung
Dumazet veröffentlichte 2013 die grundlegenden Arbeiten fürsch_fq. Die Struktur führt Zustände je Flow und eine zeitlich geordnete Organisation, sodass Pakete passend zum angestrebten Sendezeitpunkt freigegeben werden. Neue Flows werden rasch behandelt, gepacte Flows warten bis zu ihrem geplanten Zeitpunkt.
Dadurch wird verhindert, dass große Flows lokale Warteschlangen monopolisieren, und die von TCP berechneten Sendezeiten können umgesetzt werden. Es macht nicht alle Anwendungen gleich, sondern ist eine Richtlinie, die den lokalen Dienst disziplinierter macht.
Fair Queuing ist eine Richtlinie und garantiert keine gleichen Ergebnisse
Das Wort »fair« klingt stark. Selbst wenn Flows getrennt werden, unterscheidet sich die Leistung nach Paketgröße, Pfad, Empfänger, Congestion Control, Offloading und Verbindungszahl.
Auch die Definition eines Flows ist eine Richtlinie. Öffnet eine Anwendung viele Verbindungen, wird sie nicht so behandelt wie die eine Verbindung einer anderen Anwendung.sch_fqverringert lokale Monopole einzelner Flows, entscheidet aber nicht automatisch über Fairness zwischen Nutzern oder Unternehmen.
Pacing verwandelt eine Raten-Schätzung in eine Folge von Sendezeitpunkten
Selbst wenn die Congestion Control eine korrekte durchschnittliche Rate wählt, entstehen Bursts, wenn erlaubte Daten auf einmal freigegeben werden. Der Mittelwert stimmt, aber kurzfristige Warteschlangen wachsen.
Pacing verteilt Pakete über die Zeit. Es stabilisiert Warteschlangen, verbessert das Miteinander von Flows und bildet die Absicht des Congestion-Modells genauer ab. Die Implementierung erfordert, dass Zeitstempel, Timer, qdisc, Segmentierung und Netzwerkkarte dasselbe Zeitverständnis teilen.
Pacing und Congestion Control lösen unterschiedliche Teile des Problems
Congestion Control entscheidet, wie stark ein Pfad genutzt wird; Pacing entscheidet, wann erlaubte Daten gesendet werden. Auch ein gutes Modell kann durch Bursts zerstört werden, und perfektes Pacing kann eine falsche Rate treu ausführen.
Dumazets Arbeit ist die Grundlage, auf der mehrere Algorithmen Raten in Zeit übersetzen. Autoren bestimmter Congestion-Control-Modelle sind die Personen, die diese Modelle entworfen haben.
BBR nutzt die Pacing-Grundlage, hat aber eigene Autoren und eine eigene Entwurfsgeschichte
BBR stützt sich stark auf Pacing und entstand im TCP-Umfeld von Google, weshalb es leicht mit Dumazet in Verbindung gebracht wird. Es ist jedoch nicht die Erfindung einer einzelnen Person. BBR hat eigene Autoren, Modelle und eine eigene Versionsgeschichte.
Die zutreffende Einordnung lautet: Warteschlangen, Pacing, Socket-Kontierung und Messungen schufen die Voraussetzungen dafür, dass spätere Algorithmen praktisch nutzbar wurden. Dumazets grundlegender Beitrag lässt sich anerkennen, ohne die gesonderte Arbeit von Neal Cardwell und anderen zu übergehen.
TSO spart CPU und kann die Bursts wiederherstellen, die Pacing vermeiden wollte
TCP Segmentation Offload übergibt große Segmente an die Netzwerkkarte, die sie später in Pakete auf der Leitung zerlegt. Das senkt CPU-Kosten pro Paket, schiebt aber eine Hardware-Schicht zwischen den Sendezeitpunkt der Software und die tatsächliche Übertragung.
Werden große Einheiten auf einmal freigegeben, erzeugt die Netzwerkkarte Bursts. TSQ, qdisc, TSO, Treiber und Hardware müssen als ein System betrachtet werden. Passt die CPU-Optimierung nicht zur Verkehrsform, verschlechtert sich die Latenz.
Pacing-Quantum, Zeitstempel und Netzwerkkarte müssen dieselbe Realität abbilden
Der Kernel arbeitet mit Quanten, Timer-Präzision, Zeitstempeln, Offload-Einheiten und physischen Warteschlangen. Ein zu großes Quantum erzeugt Bursts, ein zu kleines belastet die CPU, und weicht die Granularität der Netzwerkkarte ab, verschiebt sich das Verhalten auf der Leitung.
Eine qdisc ist kein bloßer Standardwert, sondern Teil der Kapazitätsplanung. Entwickler müssen den gesamten Sende-Pfad messen, und Benchmarks sollten nicht nur Congestion-Control-Name und Verbindungsgeschwindigkeit angeben, sondern auch diese Bedingungen.
TCP-internes Pacing verringerte die Abhängigkeit von einer bestimmten qdisc
2017 veröffentlichte Dumazet das TCP-interne Pacing. TCP konnte das Senden nun anhand seines eigenen Raten-Zustands und eigener Timer hinauszögern, auch wenn eine erwartete qdisc nicht vorhanden war.
Die qdisc bleibt für Reihenfolge und Richtlinien zuständig. Nur ein Teil der Steuerung wurde näher an TCP als Träger der Absicht herangerückt; der endgültige Zeitpunkt ist ein gemeinsames Ergebnis von TCP, qdisc, Treiber und Netzwerkkarte.
Die Wahl der qdisc bleibt eine Entscheidung der Betreiber und beeinflusst den Dienst
Linux kennt mehrere qdiscs mit unterschiedlichen Zielen.sch_fqist auf Pacing ausgerichtet, FQ-CoDel kombiniert Flow-Trennung mit Active Queue Management. Beides ist nicht dasselbe.
Distributionen, Cloud-Images, Appliances und Container-Hosts setzen unterschiedliche Standardwerte, und mit Hardware-Offloading ändert sich auch der Ausführungsort. Upstream stellt Funktionen bereit, erst Betreiber machen daraus tatsächliches Dienstverhalten.
Einige Bytes pro Socket werden zur Beschränkung für die gesamte Flotte
Jede Verbindung besitzt Sequenznummern, Timer, Congestion-Zustand, Warteschlangen und Buchungsfelder. Mit steigender Verbindungszahl summieren sich wenige Bytes, und häufig berührte Felder belegen den Cache.
Speicherreduzierungen pro Socket erhöhen die Dichte, und gutes Layout kann Cache-Fehler sowie Kohärenzverkehr zwischen CPUs verringern. Das ist der verlässlichste Bezug zur Serverökonomie, doch eine universelle Einsparungsquote oder ein individueller Geldwert lässt sich nicht berechnen.
Wer sie bei jedem Paket berührt, macht Cache-Zeilen zur Infrastruktur
Eine CPU transportiert keine einzelnen Felder, sondern Cache-Zeilen. Liegen heiße Daten und kalte Felder in derselben Zeile, bewegen sich auch unnötige Bytes, und wenn verschiedene CPUs unterschiedliche Felder derselben Zeile aktualisieren, entstehen Kohärenzkonflikte.
Dumazets jüngere Arbeiten nehmen diese physische Sicht ein. Sie trennen Heißes von Kaltem und verringern Speicherverkehr, der mit Paket- und Socketzahl wächst. Die Wirkung hängt von CPU und Arbeitslast ab; ein einzelnes Produktionsprofil ist kein universelles Gesetz.
Die Datenstruktur-Forschung von 2024 zeigt eine gereifte Stufe der Performance-Technik
Der Vortrag von 2024 begann nicht mit einem neuen Algorithmus, sondern mit Profilen. Er untersuchte, welche Felder heiß sind, welche Zeilen sich bewegen und welche Strukturen den Speicher dominieren, um das Layout neu zu durchdenken.
Werkzeuge können Kandidaten liefern, doch Entscheidungen über Alignment, Locks, Kompatibilität und Wartbarkeit bleiben beim Menschen. In gereifter Infrastruktur wird schon die Vermeidung eines einzelnen Cache-Fehlers oder das Verschieben eines Feldes zum großen Erfolg.
Hyperscale-Profile sind starke Evidenz, aber keine vollständige öffentliche Wissenschaft
Große Betreiber können Verbindungszahlen, Verkehrsmengen und Netzwerkkarten beobachten, die normale Labore nicht reproduzieren können. Die Verbindung zu Google bietet eine Umgebung, in der winzige Kosten in einer großen Flotte sichtbar werden.
Andererseits lassen sich interne Arbeitslasten, Werkzeuge und vollständige Daten oft nicht veröffentlichen. Vorträge können Methode und Richtung zeigen, aber keine vollständigen Reproduktions-Eingaben liefern. Statt die Schlussfolgerungen zu verwerfen, muss man den Geltungsbereich begrenzen und reale Arbeitslasten so weit wie möglich in öffentliche Tests und CI überführen.
Auch Locks und Warteschlangen auf der Empfangsseite gehören zu derselben Ressourcengeschichte
Das zentrale Thema ist das Senden, doch Dumazets breiteres Werk reicht bis zu Sockets und Empfangspfad. Empfangene Pakete erfordern Polling, Speicherzuweisung, Klassifikation, Warteschlangen und Weitergabe zwischen CPUs; bei hohen Raten wird gemeinsamer Zustand zum Kostenfaktor.
Linux skaliert durch Batching, Verlagerung von Arbeit und Abbau von Locks. Nötige Korrekturen für die Korrektheit bleiben erhalten; das Prinzip, dass Buchführungsaufwand nicht die Anwendungsleistung auffrisst, ist dasselbe.
Batching erhöht den Durchsatz und verändert Latenz und Fairness
Werden mehrere Pakete oder Completions gesammelt, lassen sich Locks, Funktionsaufrufe und Cache-Bewegungen amortisieren. NAPI, Treiber und Offloading sind darauf angewiesen.
Das Bilden eines Batches erfordert jedoch Wartezeit und erreicht die nächste Schicht als Burst. Größere Batches sind effizienter, erhöhen aber auch das Warten des ersten Elements und die Dominanz einzelner Flows. TSQ, Fair Queuing und Pacing schaffen Batches nicht ab, sondern halten sie in beherrschbaren Grenzen.
Die Leistung von Linux-TCP ist eine Komposition von Schichten, die einander aufheben können
Congestion Control bestimmt die Absicht, TCP erzeugt Pakete und Zeitpunkte, TSQ begrenzt den lokalen Rückstau, die qdisc legt die Reihenfolge fest, TSO bündelt, der Treiber verwaltet Puffer, und die Netzwerkkarte sendet. Danach kommen Warteschlangen und Verluste des Netzes selbst hinzu.
Eine Verbesserung in einer Schicht kann in der nächsten wieder verschwinden. Präzises Pacing zerbricht an grobem Offloading, eine latenzarme qdisc wird von übermäßigem Enqueue erstickt, und kompakte Strukturen werden durch neue Locks verlangsamt. Dumazets Bedeutung liegt darin, genau diese Nahtstellen zu behandeln.
Öffentliche Patch-Reviews machen lokale Optimierungen zu geteilter Infrastruktur
Performance-Änderungen beginnen mit Behauptungen wie »schneller«, »sparsamer« oder »niedrigere Latenz«. Um in Linux zu gelangen, müssen sie auf netdev Fragen zu Messungen, Allgemeingültigkeit, seltenen Architekturen, Tests und künftigem Wartungsaufwand bestehen.
Maintainer können Serien aufteilen lassen, herstellerspezifische Abstraktionen ablehnen und unfertige Änderungen verschieben. Das ist langsamer als interne Patches, übersetzt aber einzelne Anforderungen in öffentliche Fähigkeiten. Dumazets Einfluss liegt in der Fähigkeit zu beurteilen, ob etwas nicht nur heute funktioniert, sondern auch künftig tragfähig ist.
netundnet-nexttrennen dringende Korrekturen von künftiger Entwicklung
Korrekturen gehen üblicherweise innet, neue Funktionen und größere Aufräumarbeiten innet-next. So wird der aktuelle Wartungspfad nicht durch Änderungen künftiger Versionen destabilisiert.
Die Grenze erfordert Urteilsvermögen. Eine »Korrektur« kann Verhalten ändern, und eine neue Funktion kann alte Fehler sichtbar machen. Serien werden getrennt, rückportierbare Korrekturen und künftige Entwürfe gesondert behandelt. Ein Produkt-Launchtermin allein ist kein Merge-Grund.
Reviews, Ablehnungen und Neugestaltungen tauchen in Commit-Zahlen nicht auf
Commits zählen sichtbare Autoren, aber keine Reviews, die eine neue Schnittstelle erzwangen, und keine Ablehnungen, die künftigen Aufwand verhinderten. Einen Patch anzuwenden heißt, Integrationsverantwortung zu übernehmen, nicht Erfinder einer Idee zu werden.
Dumazets Bild setzt sich aus klar benennbaren Arbeiten wie TSQ,sch_fq, internem Pacing und Strukturforschung sowie aus schwer zählbarer Wartung zusammen. Nicht jeder angewendete Patch darf zu seiner persönlichen Erfindung umgedeutet werden.
Tests senken das Risiko, können aber nicht alle Maschinen repräsentieren, auf die Linux trifft
Builds, Selftests, KUnit, syzbot, Treiberlabore und Downstream-Bereitstellungen finden viele Regressionen. Alle CPUs, Netzwerkkarten, qdiscs, Protokolle und Arbeitslasten können sie aber nicht abdecken.
Eine für Hyperscale vorteilhafte Änderung kann seltene Embedded-Geräte beschädigen. Urteile über Kompatibilität, Rollback und unbeobachtete Pfade bleiben nötig. Tests stärken die öffentliche Governance, machen Erfahrung aber nicht überflüssig.
Der Backport in Stable-Zweige ist eine zweite Entscheidung nach der Mainline-Übernahme
Ein Patch im Mainline-Kernel gelangt nicht automatisch in alle Stable-Zweige. Es wird erneut geprüft, ob er ein reales Problem behebt, eng begrenzt ist und keine neuen Funktionen oder unnötigen Risiken einbringt. Auch Distributionen treffen eigene Entscheidungen.
Performance-Patches hängen oft von umgebendem Code ab; werden sie allein in alte Zweige übernommen, können sie neue Regressionen erzeugen. Der Einfluss verläuft stufenweise über Upstream, Stable-Zweige, Distributionen, Cloud und Betriebskonfigurationen; niemand kontrolliert den gesamten Prozess allein.
Die heutige Wartung von TCP und Sockets ist bewusst geteilt
MAINTAINERSverteilt die Verantwortung auf Dumazet, Neal Cardwell sowie weitere Maintainer und Reviewer. Das verringert das Risiko, dass alles stehen bleibt, wenn eine Person ausfällt, und verbindet Wissen über Congestion, Sockets, Treiber und Tests.
Geteilte Zuständigkeit braucht klare Ownership. Denken in überlappenden Bereichen alle, jemand anderes sei zuständig, entstehen Lücken. Gesunde Nachfolge leugnet Dumazets Wissen nicht, sondern schafft einen Zustand, in dem andere Entwurfsgründe erklären und sicher ändern können.
Die Netdev Foundation kann Mittel bereitstellen, aber keine Merge-Rechte verleihen
Die unter Aufsicht der Linux Foundation stehende Netdev Foundation unterstützt Tests, Werkzeuge, Reisen und Forschung; Dumazet gehört dem TSC an. Die Mittelvergabe beeinflusst die Fähigkeiten der Gemeinschaft, garantiert aber keine Patch-Übernahme.
Tiefe Wartung braucht Gehälter, Hardware und CI. Die Existenz von Finanzierung zu leugnen wäre unrealistisch. Zugleich beruht die Legitimität von Upstream auf öffentlicher technischer Prüfung. Geld stärkt die Urteilsfähigkeit, kauft aber nicht das Urteil selbst.
Die Verbindung zu Google liefert Ingenieursressourcen, aber kein Eigentum an Linux-TCP
Maintainer-E-Mails einer Google-Domain belegen eine Verbindung, aber keine vollständige Stellenbezeichnung. Große Betreiber können Produktionsprofile, Hardware und langfristige Review-Zeit bereitstellen; upstream gegangene Änderungen erreichen auch Akteure außerhalb des Unternehmens.
Das Problem ist die Evidenz-Asymmetrie. Große Anforderungen werden leichter sichtbar, während ein Teil der Daten nicht öffentlich ist. Öffentliche Reviews sind das Gegengewicht. Änderungen müssen auch außerhalb von Google funktionieren und von unabhängigen Maintainern verstanden und akzeptiert werden. Ein Unternehmen stellt Ressourcen bereit, besitzt aber nicht den Stack.
Downstream-Betreiber machen Upstream-Verbesserungen zu realen Diensten
Distributionen wählen Kernel und Backports, Clouds wählen qdisc und Congestion Control, Appliances frieren alte Versionen ein, Netzwerkkarten-Hersteller bestimmen Funktionen, und Anwendungen erzeugen Verkehr. Es gibt keine belastbare Statistik zur weltweiten Nutzung von TSQ-Einstellungen odersch_fq.
Selbst wenn ein Mechanismus im Kernel vorhanden ist, kann er deaktiviert sein; manchmal läuft er als Standard, ohne dass Nutzer seinen Namen kennen. Dumazets Einfluss ist breit und indirekt: Er verändert die Upstream-Optionen, und jeder Betreiber macht daraus eigene Erfahrungen.
Userspace-Stacks konkurrieren in spezialisierten Anwendungen, ersetzen aber nicht die gesamte Rolle von Linux
DPDK, VPP und dedizierte Stacks umgehen Teile des Kernel-Pfads und erreichen hohe Paketraten oder starke Kontrolle. Dafür benötigen sie oft eigene CPUs, Huge Pages, Geräte-Binding und getrennten Betrieb.
Linux-TCP bietet breite Integration mit Standard-Sockets, Sicherheit, Namespaces, Beobachtbarkeit, Treibern und Anwendungen. Dumazets Arbeit senkt die Kosten des allgemeinen Pfads, behauptet aber nicht, in jedem Anwendungsfall am schnellsten zu sein. Spezialisierte Systeme umgehen selektiv, während Linux als gemeinsame Basis bleibt.
Linux bleibt Standard wegen der Breite der Integration, nicht wegen der Paketgeschwindigkeit
Ein Netzwerk-Stack muss nicht nur schnell sein, sondern auch Kompatibilität, Sicherheitsupdates, Routing, Namespaces, Beobachtbarkeit und unzählige Treiber tragen. Ein isolierter schneller Pfad hat eigene Betriebskosten.
Linux-Anwendungen erben TSQ, Pacing und Speicherkontierung allein dadurch, dass sie Standard-Sockets nutzen. Genau diese Unsichtbarkeit ist die Stärke von Infrastruktur: Die Wirkung bleibt, auch wenn Nutzer den Namen des Autors nicht kennen.
Ein schnellerer Host bedeutet nicht, dass der gesamte Netzwerkpfad besser geworden ist
Verbesserte lokale Warteschlangen beheben weder überlastete Zugangsnetze noch überlastete Ziele oder Verluste dazwischen. TSQ und Pacing disziplinieren den sendenden Host, beherrschen aber nicht den gesamten Pfad.
Selbst wenn eine Latenzursache verringert und Pakete geglättet werden, ist die Anwendungserfahrung ein gemeinsames Ergebnis von Senden und Empfangen, Pfad und Konfiguration. Kernel-Verbesserungen dürfen nicht einfach in End-to-End-Garantien umgedeutet werden.
Ein einzelner Benchmark vertritt nicht alle Server, Netzwerkkarten und Arbeitslasten
Ergebnisse hängen von Paketgröße, Verbindungszahl, CPU, Cache, Netzwerkkarte, Offloading, qdisc, Timern, Kernel-Version und Last ab. Profile in Google-Maßstab zeigen reale Kosten, sagen aber keine exakten Anteile für andere Umgebungen voraus.
Guter Technikjournalismus bewahrt die Rahmenbedingungen. Dumazets Vorträge sind wertvolle Betriebsevidenz aus erster Hand, aber zur Verallgemeinerung braucht es öffentliche Tests und unabhängige Messungen.
Nachfolge ist eine technische Frage, und viele Entwurfsgründe liegen im Gedächtnis von Menschen
Seltsame Einschränkungen existieren oft wegen alter Netzwerkkarten, weiter genutzter APIs oder früherer Regressionen. Der heutige Code allein verrät den Grund nicht.
Langjährige Maintainer tragen dieses Gedächtnis und schaffen damit zugleich Wert und Schlüsselpersonen-Risiko. Dokumentation, Tests, E-Mail-Archive und gemeinsame Maintainer verwandeln individuelles Gedächtnis in institutionelles Wissen. Gute Nachfolge bewahrt Prinzipien und ermöglicht, Implementierungen an neue Hardware anzupassen.
Hardware-Pacing und Gerätespeicher könnten die Grenzen erneut verschieben
Neue Netzwerkkarten planen Pakete, verwalten viele Warteschlangen und bieten umfangreiche Telemetrie oder gerätelokalen Speicher. Sie entlasten die CPU, verlagern das Verhalten aber in die Firmware.
Das nächste Problem ist die Abstimmung. Linux muss die Sendeabsicht übermitteln, erfahren, was die Hardware tatsächlich tat, und Abweichungen beheben können. Treiber-APIs, Zeitstempel und Fehlermeldungen werden ähnlich wichtig wie die Ratenberechnung. Die Prinzipien bleiben: nahe an der Absicht buchen, Feedback erhalten, versteckte Warteschlangen begrenzen und Grenzen beobachtbar machen.
Die nächste große Verbesserung könnte eher aus der Cache-Ökonomie kommen als aus neuen Transportverfahren
Neue Congestion-Control-Verfahren werden weiterhin entstehen. Auf großen Hosts bringen aber Struktur-Aufteilungen, weniger Locks, angepasste Batches und weniger Bewegung von Cache-Zeilen mitunter größeren Nutzen.
Solche Änderungen tragen keine auffälligen Namen, wirken aber gleichzeitig auf mehrere Algorithmen und Anwendungen. Die Arbeit von 2024 zeigt eine Phase, in der ein gereifter Stack an den Kosten physischer Ressourcen geschliffen wird. Die Frage verschiebt sich von »Welches neue Protokoll gewinnt?« zu »Wie viel Maschine verbraucht eine Verbindung unbemerkt?«
Dumazets nachhaltiger Beitrag ist Ressourcendisziplin, keine heroische Einzelerfindung
Die eine falsche Erzählung macht Dumazet zum alleinigen Erfinder des modernen Linux-TCP oder von BBR. Die andere lässt individuelles Urteil in einer riesigen Gemeinschaft verschwinden. Die Evidenz stützt eine mittlere, genauere Einordnung.
Er führte TSQ ein, legte die Grundlage fürsch_fq, trieb das interne Pacing voran und zeigte cachebewusste Strukturoptimierungen. Zugleich trägt er bis heute Verantwortung im geteilten Maintainer-System. Pakete und Sockets als Ansprüche auf endliche Zeit, Speicher, Warteschlangen und CPU-Lokalität zu behandeln, ist der gemeinsame Beitrag.
Die endgültige Wirkung verteilt sich auf Entwurf, Review, Integration und Betrieb. Commits können signiert sein, doch Flottendichte oder verhinderte Ausfälle lassen sich keiner einzelnen Person exakt zuordnen. Diese Schwierigkeit ist kein Grund für Übertreibung oder das Auslöschen Einzelner; sie zeigt, dass Infrastrukturwert aus identifizierbaren technischen Entscheidungen und kollektiver Umsetzung entsteht.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten