
Zusammenfassung
- Ein Fehler in einer schrittweise veröffentlichten Cloudflare-Software bewirkte, dass einige partnerschaftlich betriebene F-Root-Knoten erforderliche Glue Records nicht lieferten. Dadurch kam es sporadisch zu Fehlern bei der Auflösung von .net.
- ISC dokumentierte 17:33 UTC als Zeitpunkt der Kenntnisnahme und 20:51 UTC als vollständige Wiederherstellung. Die unmittelbare Reparatur ist beschrieben; die geprüften öffentlichen Unterlagen belegen jedoch nicht, ob die anschließend vereinbarten regelmäßigen Tests des BGP-Rückzugs später mit definierten Kriterien und unabhängiger Überprüfung durchgeführt wurden.
Der Fehler lag nicht einfach in der Zahl der Knoten
Ein weltweit verteilter Root-Server-Dienst soll verhindern, dass der Ausfall einer einzelnen Maschine oder eines einzelnen Standorts den gesamten Dienst unterbricht. Geografische Verteilung, mehrere Instanzen und Anycast-Routing sind deshalb wichtige Bestandteile der Widerstandsfähigkeit. Sie beantworten jedoch nicht jede Ausfallfrage. Insbesondere schützen viele Instanzen nicht automatisch vor einem Fehler, der durch einen gemeinsamen Veröffentlichungsprozess auf mehrere dieser Instanzen gelangt.
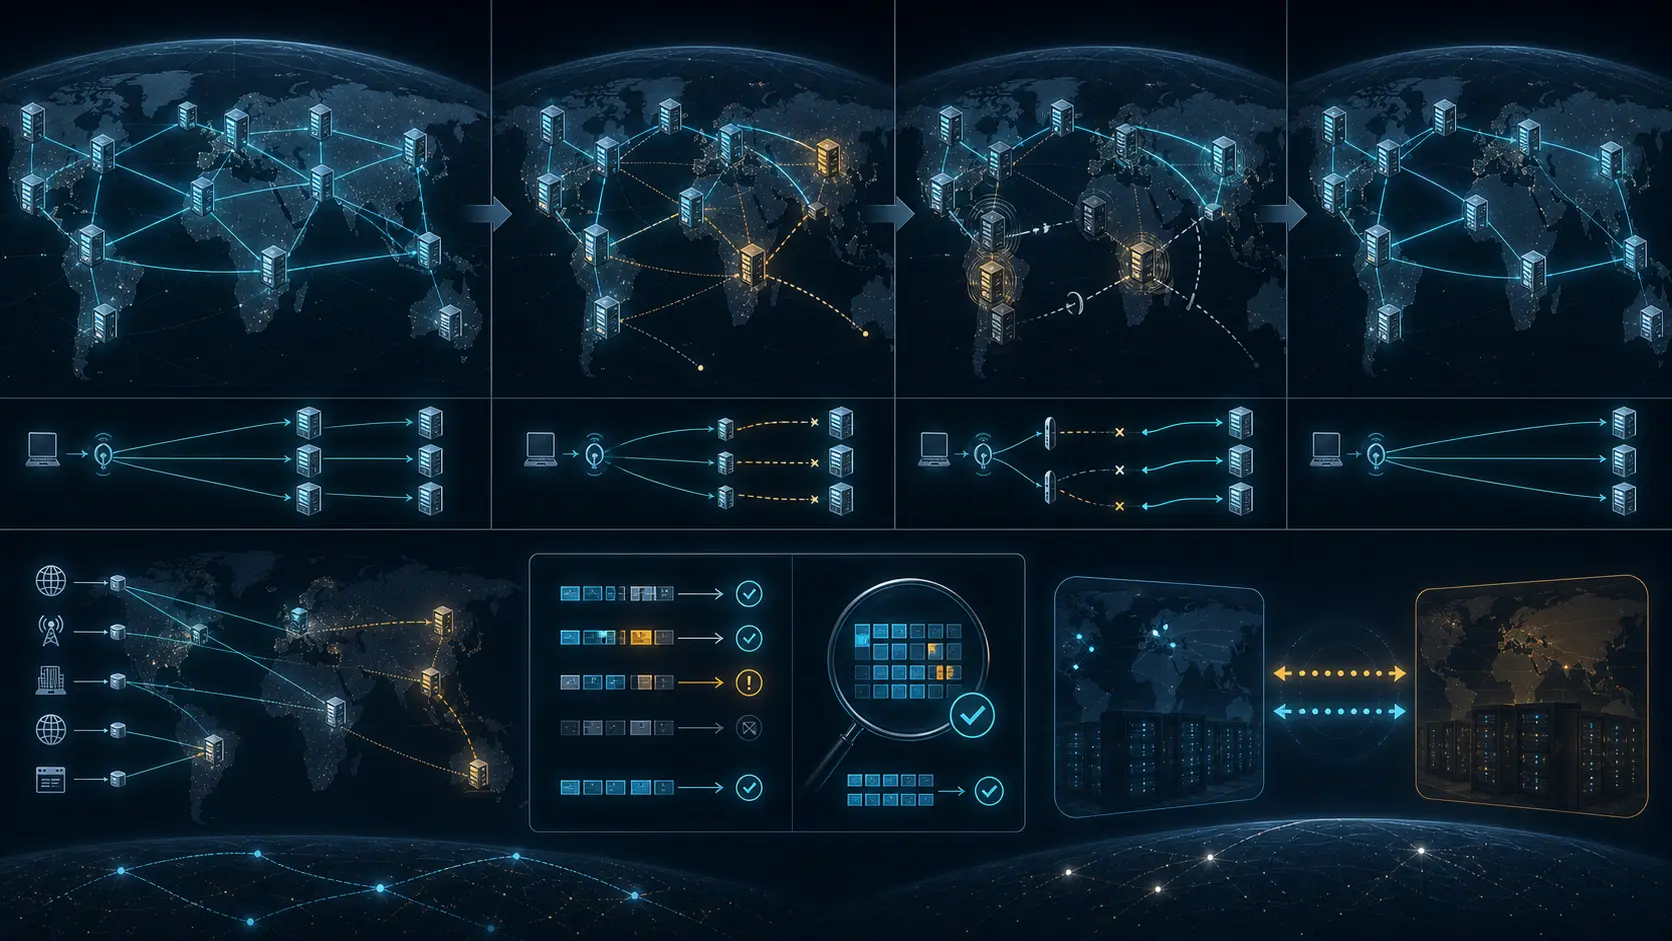
An dieser Grenze begann der F-Root-Vorfall vom 23. Januar 2020. Nach dem veröffentlichten Bericht der Internet Systems Consortium enthielt eine schrittweise ausgerollte Softwareversion von Cloudflare einen Fehler. Einige im Rahmen der Partnerschaft betriebenen F-Root-Instanzen ließen deshalb notwendige Glue Records aus. Die fehlerhaften Antworten führten nicht zu einem einheitlichen weltweiten Totalausfall. Stattdessen traten sporadische Probleme bei der Auflösung der Zone .net auf. ISC beschreibt den Fehlermechanismus und den Ablauf in seinem öffentlichen Vorfallsbericht.
Das unregelmäßige Fehlerbild ist für die Bewertung entscheidend. Ein Teil der Anfragen konnte weiterhin funktionieren, während andere abhängig vom erreichten Knoten oder Antwortpfad scheiterten. Ein Nutzer konnte deshalb einen Fehler sehen, obwohl ein Test von einem anderen Netz aus eine korrekte Antwort erhielt. Die geprüfte öffentliche Quelle beziffert weder die Gesamtzahl betroffener Nutzer noch die Zahl betroffener Resolver oder fehlgeschlagener Anfragen. Eine belastbare Schadensschätzung lässt sich daraus nicht ableiten.
Glue Records sind in diesem Zusammenhang kein nebensächliches Detail. Sie helfen einem Resolver dabei, den nächsten zuständigen Nameserver zu erreichen, wenn dessen Name innerhalb der delegierten Zone liegt. Fehlen die erforderlichen Angaben, kann die weitere Auflösung scheitern oder erst nach zusätzlichen Versuchen gelingen. Eine Instanz kann dabei technisch erreichbar bleiben und auf eine Anfrage antworten, obwohl der Inhalt der Antwort unvollständig ist.
Genau deshalb muss zwischen Verfügbarkeit und Korrektheit unterschieden werden. Eine Überwachung, die nur Paketverlust, Latenz, Prozesszustand oder die Annahme von Anfragen misst, kann einen semantischen Fehler übersehen. Der Server erscheint erreichbar, doch seine Antwort erfüllt nicht vollständig die Funktion, für die er betrieben wird. Bei einem verteilten Dienst kann sich diese Diskrepanz zudem nur auf einen Teil der Pfade beschränken.
Der Vorfall beweist nicht, dass Redundanz wertlos wäre. Die Verteilung begrenzte vielmehr bestimmte Ausfallarten und verhinderte einen gleichförmigen Totalausfall. Sie bewies aber nicht aus eigener Kraft, dass der Dienst gegen einen gemeinsam eingeführten Softwarefehler geschützt war. Redundanz beschreibt zunächst vorhandene Alternativen. Resilienz verlangt zusätzlich, dass fehlerhafte Teile erkannt, isoliert und sicher wieder in Betrieb genommen werden können.
Wer Veröffentlichung, Erkennung und Rückzug kontrollierte
Die praktische Kontrolle über den Vorfall war auf mehrere Beteiligte verteilt. Nach der veröffentlichten Darstellung kontrollierte Cloudflare den schrittweisen Software-Rollout, die betroffene Implementierung auf den partnerschaftlich betriebenen Instanzen und die Korrektur des Softwarefehlers. ISC nahm dagegen das externe Warnsignal entgegen, prüfte das gemeldete Verhalten, eskalierte den Vorfall und verlangte den Rückzug betroffener F-Root-Präfixe. Das erste dokumentierte Signal stammte von einem großen Netzbetreiber. Diese Rollenverteilung ergibt sich aus der von ISC veröffentlichten Chronologie.
Diese Zuordnung ist keine Feststellung über Absicht, Fahrlässigkeit oder alleinige Verantwortung. Der geprüfte Bericht reicht für solche weitergehenden Wertungen nicht aus. Er zeigt jedoch, warum die Organisationsgrenze für die Reaktion wichtig war: Die Stelle, bei der das erste dokumentierte Signal einging und die den Fehler verifizierte, kontrollierte nicht selbst den betroffenen Softwarecode oder dessen Veröffentlichung. Die Organisation, die die fehlerhafte Implementierung korrigieren konnte, war wiederum nicht die Stelle, bei der das erste dokumentierte externe Warnsignal einging.
Damit entstand eine Abhängigkeitskette. Zunächst musste ein externer Beobachter erkennen, dass Antworten nicht korrekt waren. Danach musste ISC die Meldung entgegennehmen, nachvollziehen und eskalieren. Cloudflare musste den Softwarefehler untersuchen und korrigieren. Zugleich musste der Verkehr von betroffenen Instanzen ferngehalten werden. Dafür wurden betroffene Präfixe zurückgezogen und später wieder angekündigt.
Diese Kombination aus Codekorrektur und Routingmaßnahme verdeutlicht zwei unterschiedliche Kontrollflächen. Die Softwarekorrektur beseitigt den Defekt in der Implementierung. Ein BGP-Rückzug kann dagegen fehlerhafte Instanzen auf der Routingebene aus dem Dienst nehmen, bevor oder während die Software repariert wird. Der Rückzug ist damit nicht bloß ein technisches Detail des Netzes, sondern ein Notfallweg zur Begrenzung eines Fehlers.
Bei geteilter Kontrolle genügt es nicht, wenn jede beteiligte Organisation ihren eigenen Bereich grundsätzlich beherrscht. Auch die Übergaben müssen funktionieren. Kontaktwege, Eskalationsschwellen, Entscheidungsbefugnisse, technische Zugriffsmöglichkeiten und die Fähigkeit zur sicheren Wiederankündigung werden zu Bestandteilen des Resilienzmodells. Eine unklare Übergabe kann einen technisch lösbaren Vorfall verlängern, ohne dass dafür zwingend ein weiterer technischer Defekt erforderlich ist.
Die wichtigste Kontrollfrage lautet deshalb nicht nur: Wer betrieb die betroffenen Knoten? Sie lautet ebenso: Wer konnte die Veröffentlichung stoppen, wer konnte einen inhaltlichen Fehler erkennen, wer durfte den Rückzug veranlassen und wer konnte ihn technisch ausführen? Erst die vollständige Kette zeigt, ob ein Notfallweg unter realen Bedingungen verfügbar ist.
Die dokumentierte Wiederherstellung dauerte drei Stunden und 18 Minuten
ISC hielt vier zentrale Zeitpunkte fest. Um 17:33 UTC erfuhr die Organisation von einem großen Netzbetreiber von dem Problem. Um 17:41 UTC bestätigte sie den Eingang der Meldung. Um 17:46 UTC hatte ISC das Verhalten verifiziert und an Cloudflare eskaliert. Die vollständige Wiederherstellung wurde für 20:51 UTC dokumentiert. Zwischen der Kenntnisnahme durch ISC und der vollständigen Wiederherstellung lagen damit drei Stunden und 18 Minuten. Die Zeitangaben stammen aus der veröffentlichten Chronologie von ISC.
Dieser Zeitraum darf nicht mit einer exakt gemessenen Dauer sämtlicher Nutzerbeeinträchtigungen gleichgesetzt werden. Der Bericht nennt den Zeitpunkt, an dem ISC von dem Problem erfuhr. Er belegt damit nicht zwingend den allerersten fehlerhaften Antwortvorgang. Ebenso enthält die geprüfte Quelle keine vollständige Messreihe darüber, wie häufig Auflösungen in jeder Phase scheiterten. Die drei Stunden und 18 Minuten beschreiben den dokumentierten Wiederherstellungszeitraum aus Sicht der Chronologie, nicht die Gesamtmenge des Schadens.
Die ersten Schritte nach der Meldung erfolgten vergleichsweise schnell. Zwischen Kenntnisnahme und Bestätigung lagen acht Minuten. Weitere fünf Minuten vergingen bis zur Verifikation und Eskalation. Der größere Teil des dokumentierten Intervalls folgte danach. Daraus lässt sich nicht ohne zusätzliche Belege schließen, dass eine bestimmte Partei vermeidbar langsam handelte. Es zeigt aber, an welcher Stelle die anspruchsvollere Arbeit begann: Ursache eingrenzen, Zuständigkeiten koordinieren, Software korrigieren, betroffene Routen zurückziehen, Antworten prüfen und die Präfixe anschließend sicher wieder ankündigen.
Die Wiederherstellung verband somit zwei Maßnahmen. Eine Codekorrektur behob den Softwarefehler. Der BGP-Rückzug isolierte betroffene Instanzen, sodass sie keine Anfragen mehr über die zurückgezogenen Routen erhielten. Nach Korrektur und Prüfung wurden die Präfixe wieder angekündigt. ISC beschreibt diese Verbindung von Softwarekorrektur, Rückzug und späterer Wiederankündigung.
Diese Reihenfolge macht deutlich, dass Wiederherstellung mehr bedeutet als das Einspielen einer neuen Softwareversion. Ein reparierter Code hilft erst dann vollständig, wenn der operative Zustand überprüft und der Verkehr kontrolliert zurückgeführt wurde. Umgekehrt kann ein Routingrückzug die Wirkung begrenzen, ohne die Ursache zu beseitigen. Dauerhafte Wiederherstellung verlangt beides: Ursachenbeseitigung und kontrollierte Rückkehr.
Warum Verteilung das Koordinationsrisiko nicht beseitigte
Anycast und geografische Verteilung können Last verteilen, Wege verkürzen und einzelne Standortausfälle abfangen. Bei einem ungleichmäßigen Fehler können sie die Beobachtung jedoch erschweren. Wenn nur ein Teil der Instanzen unvollständige Antworten liefert, sehen Nutzer je nach Netz und Route unterschiedliche Ergebnisse. Ein Testpunkt kann eine korrekte Instanz erreichen, während ein anderer an eine fehlerhafte Instanz geroutet wird.
Ein globaler Statusindikator kann deshalb zu grob sein. Meldet er nur, dass der Dienst grundsätzlich erreichbar ist, kann er grün erscheinen, obwohl ein relevanter Teil der Antwortpfade beschädigt ist. Ein aussagekräftiger Test muss nicht nur aus mehreren Regionen und Netzen erfolgen. Er muss auch den Inhalt der Antworten prüfen und Unterschiede zwischen Pfaden sichtbar machen.
Der Vorfall legt drei voneinander zu trennende Kontrollfragen offen.
Erstens: Welche Prüfungen verhindern, dass eine neue Version fehlerhafte DNS-Antworten auf produktive Knoten bringt? Ein gestaffelter Rollout kann die Reichweite eines Fehlers begrenzen. Seine Schutzwirkung hängt jedoch davon ab, ob die frühe Kohorte auf die richtige Eigenschaft geprüft wird. Wenn Messungen vor allem Erreichbarkeit und Leistung beobachten, kann ein inhaltlicher Protokollfehler unentdeckt bleiben.
Zweitens: Wer erkennt einen Fehler, der nur auf einigen Antwortpfaden auftritt? Der veröffentlichte Ablauf begann mit der Meldung eines großen Netzbetreibers. Das unterstreicht den Wert externer Beobachtung. Es wirft zugleich die Frage auf, ob semantische Tests aus mehreren Netzen das Problem früher hätten identifizieren können. Die geprüfte Quelle liefert nicht genug Daten, um eine konkrete frühere Erkennungszeit zu behaupten. Belegt ist nur, dass das erste dokumentierte Signal von außen kam.
Drittens: Wer kann betroffene Instanzen rasch aus dem Dienst nehmen? Bei Anycast kann der Rückzug eines Präfixes verhindern, dass Verkehr weiterhin einen fehlerhaften Standort erreicht. Dieser Weg ist aber nur dann belastbar, wenn die zuständigen Personen erreichbar sind, die Befugnisse feststehen, der technische Vorgang funktioniert und die Folgen der Maßnahme verstanden werden.
Ein dokumentierter Notfallweg ist deshalb nicht automatisch ein erprobter Notfallweg. Eine Anleitung kann korrekt sein und dennoch im Ernstfall an einer veralteten Kontaktliste, einer unklaren Freigabe oder einer unerwarteten Routingwirkung scheitern. Resilienz entsteht nicht allein aus dem Vorhandensein eines Eingriffs. Sie entsteht aus der nachgewiesenen Fähigkeit, ihn rechtzeitig und kontrolliert auszuführen.
Was die vereinbarten Tests belegen – und was nicht
Der öffentliche Nachbericht hielt fest, dass ISC und Cloudflare regelmäßige Tests der BGP-Rückzugsfunktion vereinbart hatten. Diese Vereinbarung ist relevant, weil sie genau den im Vorfall sichtbar gewordenen Kontrollpunkt adressiert. Sie zeigt, dass die Rückzugsfähigkeit nicht als einmalige Reparatur behandelt werden sollte. Die Vereinbarung zu regelmäßigen Tests wird im veröffentlichten Vorfallsbericht beschrieben.
Eine Vereinbarung belegt jedoch noch keine spätere Durchführung. In dem geprüften öffentlichen Material finden sich keine ausreichenden Angaben dazu, wann solche vorfallsbezogenen Übungen stattfanden, wie häufig sie wiederholt wurden, welche Präfixe oder Standorte einbezogen waren, welche Erfolgsgrenzen galten, welche Abweichungen auftraten oder ob Ergebnisse unabhängig überprüft wurden.
Diese Evidenzgrenze muss genau formuliert werden. Das Fehlen öffentlich geprüfter Nachweise beweist nicht, dass keine Tests stattgefunden haben. Es bedeutet nur, dass ihre spätere Ausführung, Häufigkeit und Wirksamkeit aus dem untersuchten Material nicht festgestellt werden können. Aus einer öffentlichen Dokumentationslücke darf keine Tatsachenbehauptung über das tatsächliche interne Handeln abgeleitet werden.
Damit ergeben sich zwei unterschiedlich starke Befunde. Die unmittelbare Wiederherstellung ist dokumentiert: Der Fehler wurde korrigiert, betroffene Präfixe wurden zurückgezogen und später wieder angekündigt. Die Dauerhaftigkeit der organisationsübergreifenden Notfallfähigkeit ist dagegen öffentlich nicht in vergleichbarer Weise belegt. Eine Absicht zur regelmäßigen Prüfung ist schwächer als ein nachvollziehbarer Nachweis ausgeführter Prüfungen mit festgelegten Kriterien.
Eine dauerhafte Reparatur besteht außerdem nicht nur aus verändertem Code. Sie umfasst die Fähigkeit, denselben oder einen verwandten Fehler künftig früher zu erkennen und schneller zu begrenzen. Wenn der entscheidende Eingriffsweg mehrere Organisationen umfasst, muss auch der Test diese Grenze überschreiten. Eine isolierte Prüfung eines BGP-Befehls genügt nicht, wenn im Ernstfall zusätzlich Meldung, Diagnose, Freigabe, Ausführung und sichere Rückkehr zusammenwirken müssen.
Ein begrenzter Nachweis für Betreiber und Aufsichtsgremien
Der Vorfall bietet keinen Grund, Redundanz pauschal abzuwerten. Er liefert vielmehr einen Prüfrahmen dafür, welche Behauptungen über Resilienz tatsächlich belegt werden sollten. Die Zahl der Standorte oder Instanzen ist ein wichtiger Ausgangswert, aber kein vollständiger Ergebnisnachweis.
Ein belastbarer Nachweis würde mindestens sechs Fragen beantworten:
- Werden DNS-Antworten während eines gestaffelten Rollouts nicht nur auf Erreichbarkeit, sondern auch auf protokollgerechte Vollständigkeit und semantische Korrektheit geprüft?
- Beobachten Messpunkte aus unterschiedlichen Netzen und Regionen, ob verschiedene Anycast-Pfade widersprüchliche Ergebnisse liefern?
- Ist eindeutig festgelegt, wer einen Rollout stoppen, einen Vorfall eskalieren und den Rückzug betroffener Präfixe anordnen darf?
- Wird der Rückzug unter kontrollierten Bedingungen praktisch ausgeführt, anstatt nur in einer Dokumentation beschrieben zu werden?
- Gibt es messbare Kriterien für Erkennungszeit, Freigabezeit, Zeit bis zum wirksamen Rückzug, korrekte Verkehrsverlagerung und sichere Wiederankündigung?
- Werden Ergebnisse, Abweichungen und notwendige Korrekturen so festgehalten, dass eine unabhängige Prüfung möglich ist?
Dieser Prüfrahmen ist keine Behauptung darüber, welche Kontrollen ISC oder Cloudflare heute betreiben. Die untersuchte Quelle reicht für eine solche aktuelle Bestandsaufnahme nicht aus. Der Rahmen übersetzt lediglich die dokumentierte Kontrollkette des Vorfalls in überprüfbare Anforderungen.
Die engste belastbare Schlussfolgerung lautet daher: Der Dienst wurde am 23. Januar 2020 wiederhergestellt, und der unmittelbare Reparaturweg ist öffentlich beschrieben. Die Zahl verteilter Instanzen beweist für sich allein jedoch keine Widerstandsfähigkeit gegen gemeinsam eingeführte Softwarefehler. Dauerhafte Gewissheit würde zusätzlich nachprüfbare Belege verlangen, dass semantische Fehler früh erkannt, Zuständigkeiten ohne Verzögerung aktiviert und betroffene Anycast-Präfixe wiederholt nach definierten Kriterien zurückgezogen und sicher reaktiviert werden können.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten