
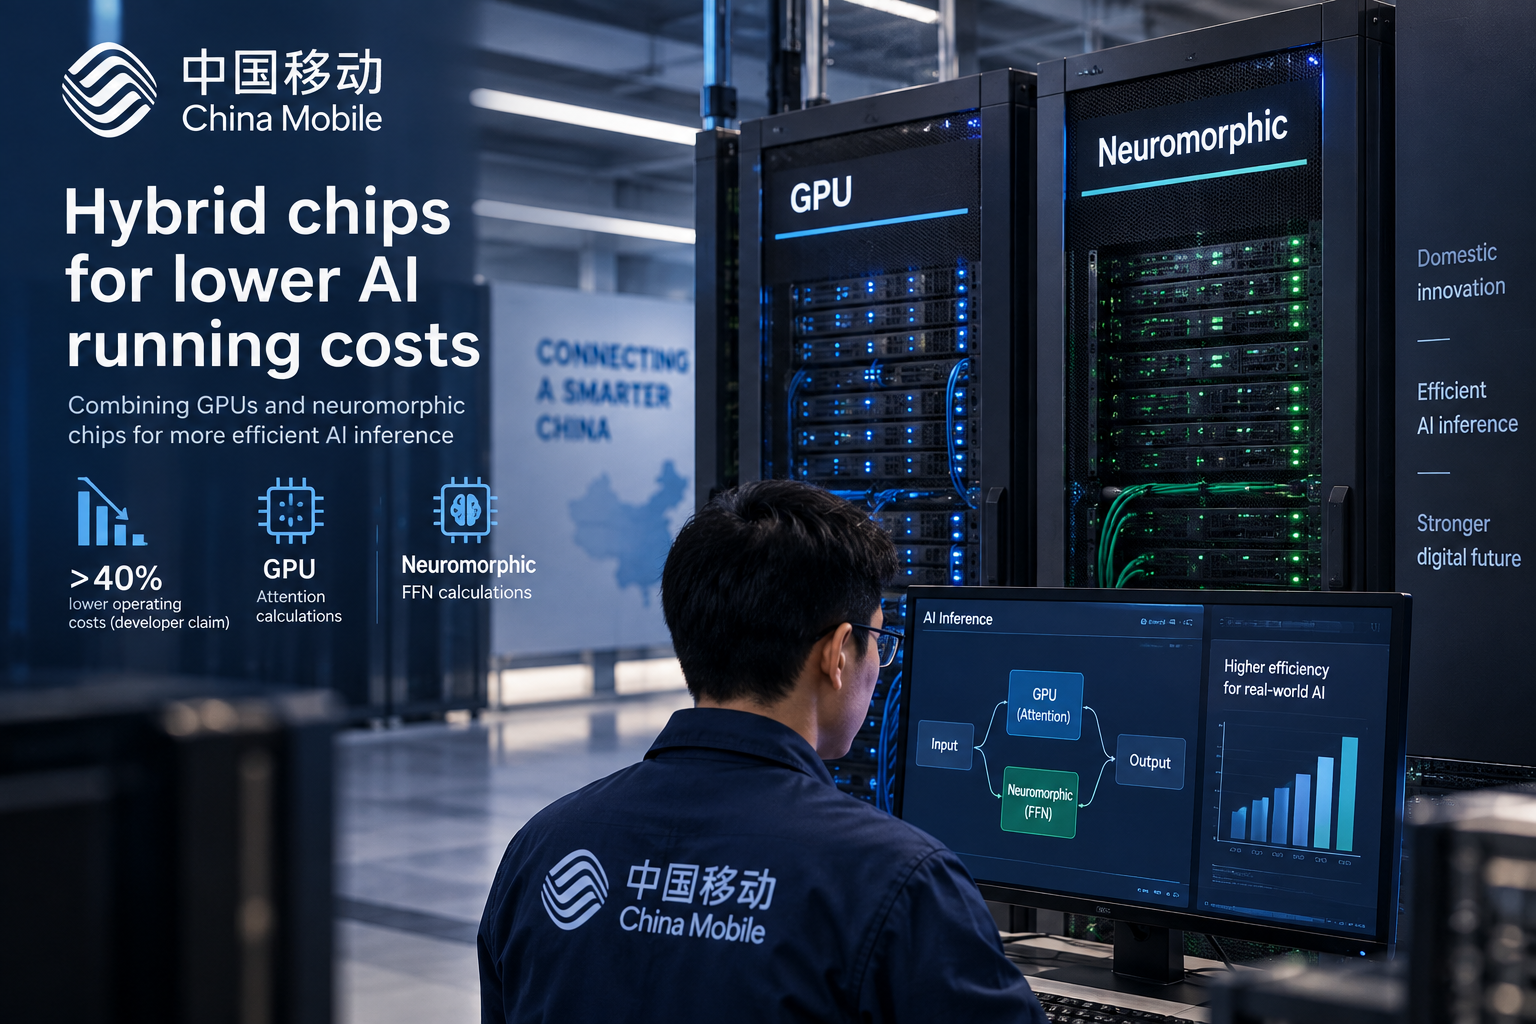
- Mobile Cloud und seine Partner haben chinesische GPUs und neuromorphe Chips in einem KI-Inferenzsystem kombiniert, das Modellberechnungen zwischen den beiden Prozessortypen aufteilt
- Die Entwickler berichten, dass Tests mit DeepSeek V4 Flash gegenüber einem vergleichbaren chinesischen GPU-Cluster um mehr als 40 % niedrigere Betriebskosten ergaben
Die Fakten
Der Geschäftsbereich Mobile Cloud von China Mobile und seine Partner haben ein KI-Inferenzsystem eingeführt, das chinesische GPUs mit neuromorphen Chips kombiniert. Das System wurde während der vom 11. bis 13. September in Langfang, Hebei, abgehaltenen China Computing Conference vorgestellt.
Das Projekt wurde gemeinsam mit CETC Nanhu Research Institute, Lynxi Technology, Iluvatar CoreX, Tsinghua University und Peking University entwickelt. Nach Angaben der Entwickler erzielten Tests mit DeepSeek V4 Flash gegenüber einem vergleichbaren chinesischen GPU-Cluster ein mehr als doppelt so hohes Preis-Leistungs-Verhältnis und senkten die Betriebskosten um mehr als 40 %. Die Zahlen stammen vom Entwicklungsteam und wurden nicht unabhängig überprüft.
Das System verteilt die Arbeit auf die beiden Chiptypen. Attention-Berechnungen laufen auf chinesischen GPUs, während FFN-Berechnungen neuromorphen Prozessoren zugewiesen werden. Ein Modell-Compiler, ein Hochgeschwindigkeits-Interconnect-Protokoll und eine gemeinsame Inferenz-Engine steuern die Aufgabenverteilung, die Ablaufplanung und die Verarbeitung der Ergebnisse. Separat meldete Iluvatar für das erste Halbjahr 2026 einen Umsatz von 654 Millionen Yuan mit Inferenzprodukten, was 69,2 % seines Gesamtumsatzes entsprach.
Die Einordnung
Die Idee ist einfach: Nicht ein einziger Prozessortyp soll jeden Teil des Modells bearbeiten. Die GPU übernimmt die Aufgaben, die für einen Allzweckbeschleuniger geeignet sind, während der neuromorphe Chip jene Berechnungen ausführt, die er nach Einschätzung der Entwickler effizienter bewältigen kann. Wenn sich diese Aufteilung im Produktivbetrieb bewährt, könnte ein Cloud-Betreiber die Kosten für die Bearbeitung von KI-Anfragen senken, ohne seinen gesamten GPU-Stack zu ersetzen.
Schwierig ist alles, was zwischen den beiden Chips liegt. Daten müssen zum richtigen Zeitpunkt übertragen werden, die Software muss entscheiden, wo jede Berechnung ausgeführt wird, und keiner der beiden Prozessoren darf zu lange auf den anderen warten. Die bei einer einzelnen DeepSeek-Konfiguration gemessene Einsparung könnte schrumpfen, wenn Anfragen länger ausfallen, das Anfragevolumen steigt oder das Modell wechselt.
Für die BTW-Leserschaft muss die Angabe von 40 % daher durch einen Vergleich des Gesamtsystems geprüft werden. Kunden müssten dieselbe Arbeitslast bei gleicher Antwortzeit und Ausgabequalität ausführen und dabei beide Prozessoren, den Interconnect und die Software in die Rechnung einbeziehen. Wenn das gemischte System unter diesen Bedingungen weiterhin weniger kostet, wird die Architektur kommerziell interessant.
Worauf zu achten ist
Kundentests sollten statt eines weiteren Spitzenbenchmarks die Kosten des Gesamtsystems, die Antwortzeit und den Durchsatz ausweisen. Ergebnisse mit mehreren Modellen und unterschiedlichen Lastmustern würden zeigen, ob die gemeldete Einsparung außerhalb des Tests mit DeepSeek V4 Flash Bestand hat. Kommerzielle Aufträge oder Implementierungen bei Cloud- und Unternehmenskunden würden stärkere Belege liefern als weitere Demonstrationen.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten