
Zusammenfassung
- Argonne Network ist ein aktueller Unternehmenseintrag im BTW-Verzeichnis, der mit einer realen Netzwerkverwaltungsrolle verbunden ist. ARIN führt Argonne National Laboratory als Registranten für AS683 und AS75 und weist Argonne Network Administration als technische Kontaktgruppe aus; dadurch wird kein eigenständiges rechtliches Unternehmen begründet.
- Registereinträge belegen eine rechenschaftspflichtige Identität für Nummernressourcen, während öffentliche Routing-Beobachtungen begrenzte Einblicke in das laufende Verhalten liefern. Weder das eine noch das andere ist eine private Topologiekarte, ein Service-Level-Ergebnis oder ein Nachweis exklusiver Routenkontrolle.
- Offizielle Materialien der Einrichtung und von ESnet beschreiben eine reale Forschungsverkehrsfläche, die Instrumente, Speicher, Rechenleistung, Identität, Campus-Netze, externe Anbieter und entfernte Kooperationspartner umfasst. Fähigkeitsbeschreibungen und Projektbeispiele belegen weder universelle Zuverlässigkeit noch Nutzerergebnisse.
- Überwachung, Integration, Wartung, Portabilität und Ausnahmebehandlung bleiben wiederkehrende Kosten, weil Einträge, Routen, Einrichtungen, externe Betreiber und Forschungsworkflows auch bei Veränderungen und Ausfällen aufeinander abgestimmt bleiben müssen.
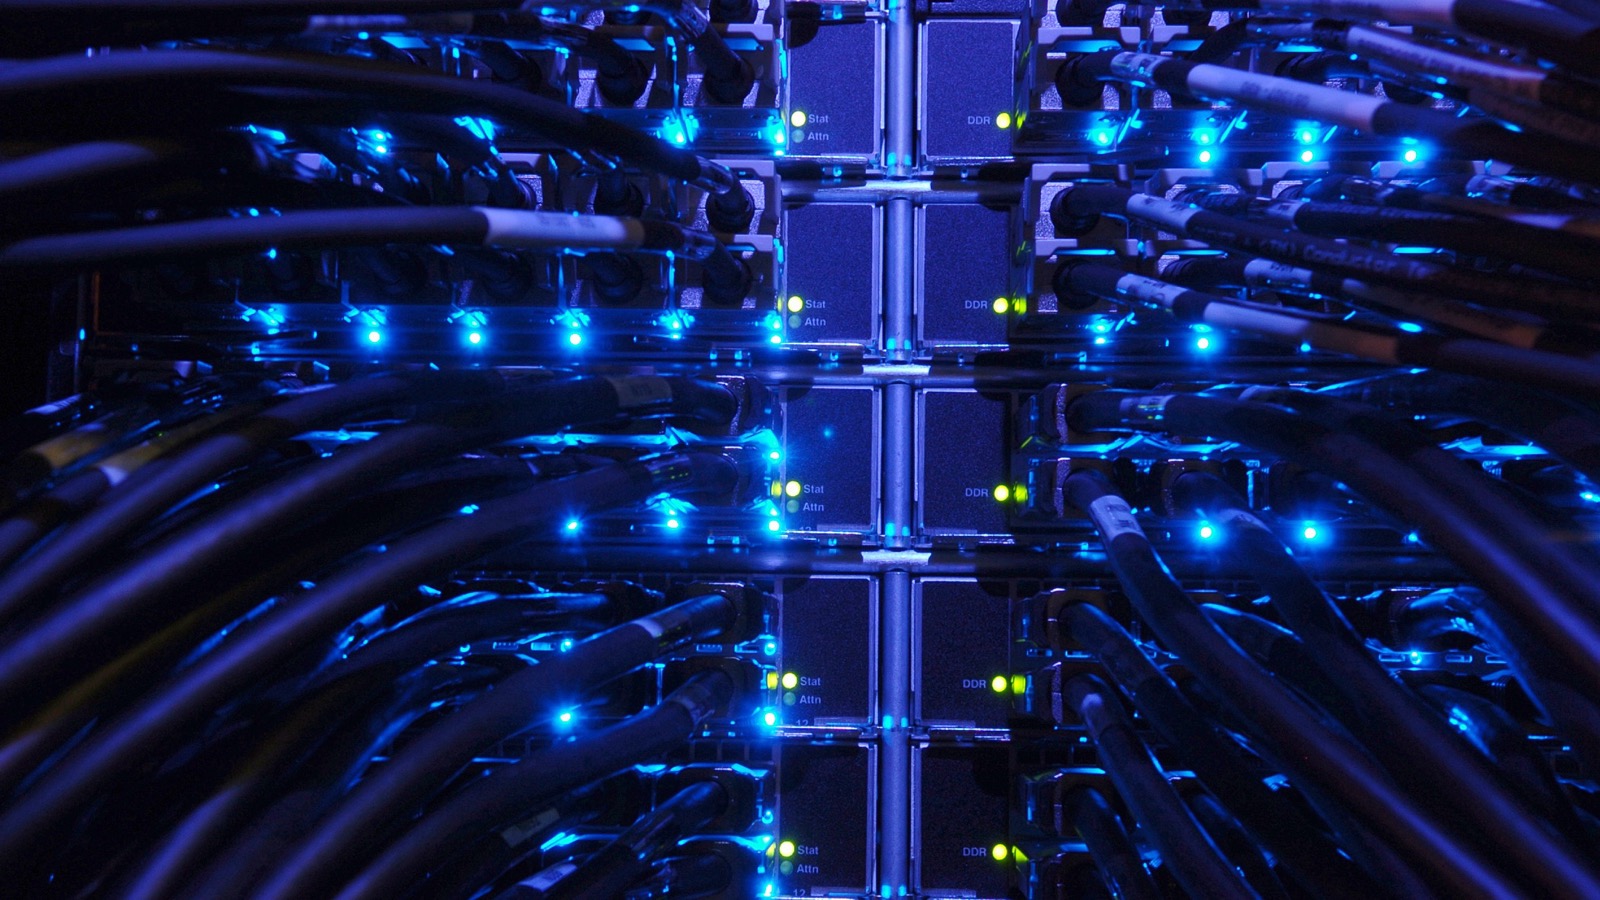
Hinweis zum Bild:Das beigefügte Creative-Commons-Foto zeigt Computerausrüstung im Center for Nanoscale Materials des Argonne National Laboratory. Es zeigt nicht Argonne Network Administration, das Routing von AS683 oder AS75, das Campus-Backbone, ESnet- oder MREN-Verbindungen, private Topologie, aktuelle Kontrollen, Vorfälle, gemessene Zuverlässigkeit oder Nutzerergebnisse.
Argonne Network erscheint im BTW-Verzeichnis als Unternehmenseintrag, doch die nützlichsten öffentlichen Belege stützen es nicht, dieses Label als eigenständigen kommerziellen Netzbetreiber zu behandeln. Die American Registry for Internet Numbers führt Argonne National Laboratory als Registranten für AS683 und AS75. Dieselben Einträge weisen Argonne Network Administration als technische Kontaktgruppe aus.[1][2] Diese Unterscheidung ist der Ausgangspunkt einer verantwortungsvollen Analyse.
Sie bindet den Verzeichniseintrag an eine reale Netzsteuerungsrolle, ohne ein separates rechtliches Unternehmen, eine private Architektur oder ein Dienstleistungsportfolio zu erfinden, das die öffentlichen Aufzeichnungen nicht offenlegen.
Die beiden Autonomous-System-Nummern bilden eine konkrete technische Oberfläche. Registereinträge belegen zugewiesene Identitäten und rechenschaftspflichtige Kontakte. Öffentliche Routing-Beobachtungsdienste zeigen, was externe Kollektoren zu einem begrenzten Zeitpunkt sehen konnten. Argonne und seine Einrichtungen beschreiben Speicherung, lokale und Weitverkehrsvernetzung, Datenbewegung, Zugriffskontrollen, Campus-Investitionen und Forschungsworkflows.
Das Energy Sciences Network des Department of Energy beschreibt seine eigene Rolle und veröffentlicht Berichte und Fallstudien, die Argonne in einen größeren Forschungsnetzkontext einordnen.[3][4][5][6][7][8][9][10][11][12][13][14][15][16][17][18][19][20][21][22][23][24][25]
Zusammen zeigen diese Quellen eher ein Steuerungsproblem als eine einfache Produktgeschichte. Wissenschaftliche Instrumente, Hochleistungsrechnersysteme, gemeinsamer Speicher, externe Forschungsnetze, Identitätssysteme, Sicherheitskontrollen und von Nutzern betriebene Workflows müssen Daten über mehrere Verwaltungsgrenzen hinweg austauschen. Das Netz muss Adress- und Routing-Identität bewahren, während sich Geräte, Anwendungen, Anbieter und Forschungsanforderungen ändern. Eine öffentliche Route kann sichtbar sein, während ein Transfer langsam bleibt.
Eine Einrichtung kann starke Fähigkeiten ausweisen, während ein einzelner Workflow dennoch scheitert. Eine erfolgreiche Demonstration kann belegen, dass ein Design möglich ist, ohne die routinemäßige Zuverlässigkeit für jeden Nutzer zu beweisen.
Dieser Artikel trennt daher durchgängig drei Ebenen:
- Systemfähigkeitbedeutet, dass eine dokumentierte Komponente oder ein Protokoll eine definierte Funktion ausführen kann, etwa eine Route ankündigen, Daten bewegen, Speicher bereitstellen, einen Nutzer authentifizieren oder einen Pfad messen.
- Betriebszuverlässigkeitbedeutet, dass diese Funktion unter realen Wartungs- und Ausfallbedingungen verfügbar, korrekt, sicher, beobachtbar und wiederherstellbar bleibt.
- Nutzer- oder Forschungsergebnisbedeutet, dass ein benannter Workload über einen festgelegten Zeitraum ein messbares Ergebnis erbracht hat, mit genügend Kontext, um Netzeffekte von Speicher-, Software-, Instrumenten- und Workflow-Effekten zu unterscheiden.
Die öffentliche Quellenlage ist reichhaltig genug, um Fähigkeit und Betriebslast zu untersuchen. Sie enthält mehrere klar abgegrenzte Projektbeispiele. Sie liefert jedoch weder einen flottenweiten Verfügbarkeits-Benchmark, eine vollständige Vorfallhistorie, eine private Topologiekarte noch einen kontrollierten Vergleich von Nutzerergebnissen. Diese Grenzen sind keine Lücken, die mit Annahmen gefüllt werden sollten. Sie legen fest, was geschlussfolgert werden kann und was nicht.
Die Entitätsgrenze: Verzeichnislabel, Labor und Betriebsrolle
Die ARIN-Einträge für AS683 und AS75 liefern die stärksten Identitätsanker.[1][2] In beiden Fällen ist Argonne National Laboratory der Registrant. Argonne Network Administration erscheint als technische Kontaktgruppe. Ein Registereintrag ist eine Aufzeichnung über die Verwaltung von Nummernressourcen und die Kontaktverantwortung. Er ist weder eine Unternehmenssatzung, ein Architekturdiagramm, eine Service-Level-Vereinbarung noch ein Beleg dafür, dass jede unter einer ASN beobachtete Route ausschließlich von einem Team betrieben wird.
Diese Grenze ist wichtig, weil Namen mehrere verschiedene Dinge vermischen können. „Argonne Network“ kann sich informell auf Infrastruktur, eine Verwaltungsfunktion, eine technische Gruppe oder den BTW-Verzeichniseintrag beziehen. „Argonne National Laboratory“ ist die im Register genannte Institution. Einzelne Einrichtungen wie die Argonne Leadership Computing Facility, die Advanced Photon Source und das Laboratory Computing Resource Center veröffentlichen ihre eigene Betriebsdokumentation. ESnet ist ein separater Netzbetreiber des Department of Energy.
Sie alle als ein Produkt zu behandeln, würde die Übergaben verschleiern, die das System funktionieren lassen.
Eine präzise Unternehmensanalyse fragt, was der Verzeichniseintrag valide repräsentieren kann. Hier steht er für die Kontrollfläche der Netzwerkverwaltung, die mit den registrierten Autonomous-System-Identitäten von Argonne verbunden ist. Diese Fläche umfasst die Pflege korrekter Kontakt- und Registrierungsdaten, die Koordination von Routing-Änderungen, die Unterstützung der Konnektivität auf dem Campus und zu externen Netzen sowie die Mitwirkung an Vorfalls- und Kontinuitätsarbeit. Öffentliche Einrichtungsdokumente zeigen, warum diese Aufgaben wichtig sind.
Sie zeigen nicht, dass Argonne Network Administration jeden Switch, jedes Speichersystem, jede Anwendung, jeden Identitätsdienst oder jede externe Leitung, die in diesen Dokumenten beschrieben wird, unmittelbar besitzt.
Die Unterscheidung verhindert auch eine einfache, aber irreführende Kundenerzählung. Forschende, die eine Einrichtung nutzen, sind nicht unbedingt Kunden eines eigenständigen Argonne-Network-Produkts. Sie können Nutzer einer DOE-Einrichtung, Mitglieder eines Projekts, Kooperationspartner oder Beschäftigte sein. Ihre Workflows hängen von Netzdiensten ab, ihre Ergebnisse aber auch von Instrumenten, Speicher, Rechenzeitkontingenten, Software, Berechtigungen, Datenrichtlinien und externen Partnern. Das Netz ist in vielen Fällen eine notwendige Ebene; Notwendigkeit ist nicht dasselbe wie alleinige Kausalität.
Diese rollenbasierte Lesart ist nützlicher als ein breites Markenprofil. Sie lenkt die Aufmerksamkeit auf Einträge, laufende Systeme, Übergaben und Wiederherstellung. Eine ASN hat nur dann betriebliche Bedeutung, wenn Registerdaten, Routenankündigung, Upstream-Konnektivität, Überwachung, Zugriff und Reaktionsbefugnis fortlaufend aufeinander abgestimmt bleiben. Ein Gruppenname in einem Register hilft während eines Vorfalls nur, wenn der Kontaktweg aktuell ist und die Empfänger handeln können. Der Wert liegt in der Kontinuität zwischen der dokumentierten Rolle und dem laufenden Netz.
Was AS683 und AS75 belegen – und was nicht
Eine Autonomous-System-Nummer kennzeichnet eine Routing-Domäne für das Interdomain-Routing. Die RDAP-Einträge von ARIN zeigen, dass AS683 und AS75 aktive Registrierungen sind, die mit Argonne National Laboratory verbunden sind.[1][2] Die öffentlichen APIs von RIPEstat liefern zeitlich begrenzte Außenbeobachtungen für die beiden Ressourcen, darunter Übersichtsbezeichnungen, Beobachtungen angekündigter Präfixe und Routing-Statusdaten.[3][4][5][6][7][8] Diese beiden Evidenzklassen dienen unterschiedlichen Zwecken.
Das Register ist der rechenschaftspflichtige Datensatz. Es weist die zugewiesene Ressource, den Registranten, den Status und die Kontaktrollen aus. Es ist kein Live-Routenmonitor. Ein korrekter Registereintrag belegt weder, dass ein Präfix derzeit erreichbar ist, dass der beabsichtigte Ursprung global sichtbar ist, noch dass der Verkehr einem bestimmten Pfad folgt. Umgekehrt kann ein Routenkollektor eine Route beobachten, belegt damit aber weder rechtliche Zuweisung noch Befugnis. Register- und Beobachtungsdaten sollten dort übereinstimmen, wo sich ihre Geltungsbereiche überschneiden, aber keines ersetzt das andere.
Die RIPEstat-Beobachtungen sind Momentaufnahmen. Sie können Präfixe zeigen, die zum Erhebungszeitpunkt als von einer ASN angekündigt beobachtet wurden, und bieten eine begrenzte Routing-Statusansicht.[5][6][7][8] Sie können keine exklusive Kontrolle über jedes Präfix, vollständige globale Sichtbarkeit, historische Kontinuität, interne Topologie, Verkehrsvolumen oder Dienstqualität belegen. Kollektorabdeckung, Routing-Politik, vorübergehende Änderungen und Beobachtungszeitpunkt beeinflussen alles, was ein externer Dienst meldet.
Das Vorhandensein zweier ASNs ist betrieblich interessant, verrät aber nicht, warum die Institution beide unterhält. Öffentliche Aufzeichnungen allein belegen nicht, dass die Nummern unterschiedlichen Einrichtungen, Generationen, Richtlinien, Anbietern oder Redundanzdomänen entsprechen. Sie schaffen jedoch zwei Sätze von Einträgen, die korrekt und unterstützbar bleiben müssen. Jede kann eigene Routenrichtlinien, Kontaktverläufe, beobachtete Präfixe, Abhängigkeiten und Wiederherstellungsanforderungen haben.
Für einen Betreiber schafft die Verwaltung zweier ASNs mindestens vier wiederkehrende Aufgaben. Erstens müssen Registereinträge und Kontakte aktuell bleiben. Zweitens müssen beabsichtigte Routenankündigung und externe Beobachtungen abgeglichen werden. Drittens müssen Änderungen autorisiert und gestaffelt werden, ohne die eine Ressource mit der anderen zu verwechseln. Viertens brauchen Vorfallshelfer einen verlässlichen Weg, um zu entscheiden, ob ein Symptom spezifisch für eine ASN ist, beide betrifft oder außerhalb der Kontrolle von Argonne liegt.
Das kritische Gut ist nicht die Nummer selbst. Es ist die Kette aus Befugnis und laufender Konfiguration rund um die Nummer. Diese Kette umfasst Registerzugang, Routing-Politik, Präfixinventar, Upstream- und Peer-Beziehungen, Überwachung, Filter, Sicherheitsmetadaten, Kontakteskalation und Wiederherstellungsnachweise. Öffentliche Quellen legen Teile der Kette offen. Sie geben die vollständige Implementierung nicht preis.
Forschungsverkehr ist ein System von Übergaben
Die Argonne Leadership Computing Facility beschreibt Speicherung und Vernetzung als miteinander verbundene Ressourcen statt als isolierte Produkte.[9] Ihre öffentlichen Materialien behandeln Speichersysteme, lokale Infrastruktur, Weitverkehrsanbindung und Verbindungen zu externen Forschungsnetzen.
Separate ALCF-Leitfäden weisen Nutzern Verantwortlichkeiten für Datenaufbewahrung, -übertragung und -weitergabe zu.[10] Die Datenfreigabeseite der Einrichtung beschreibt Dienste und Mechanismen, mit denen Daten über einen einzelnen Rechenauftrag hinaus bereitgestellt oder bewegt werden.[11] Diese Dokumente stützen eine klare Schlussfolgerung: Nützliche Forschungsdatenbewegung überschreitet Speicher-, Netz-, Identitäts- und Anwendungsgrenzen.
Diese Schlussfolgerung sollte nicht zu einer Verfügbarkeitsbehauptung überdehnt werden. Eine Einrichtungsseite beschreibt die vorgesehene Architektur und verfügbare Dienstklassen. Sie berichtet nicht über jedes Wartungsereignis, jede Überlastungsphase, jeden fehlgeschlagenen Transfer oder jedes Konfigurationsproblem von Nutzern. Kapazitätsangaben beschreiben, wo sie genannt werden, bestimmte Schnittstellen oder Systeme, keine Ende-zu-Ende-Garantie. Ein Pfad wird durch seine engste oder am stärksten beeinträchtigte Komponente begrenzt, die außerhalb der Einrichtung liegen kann.
Die Datenrichtlinie von ALCF fügt eine weitere Grenze hinzu.[12] Die Umgebung wird als offenes Forschungsnetz mit definierten Erwartungen an den Umgang mit Daten beschrieben. Diese Richtlinie beeinflusst, welche technischen Kontrollen angemessen sind. Ein für große wissenschaftliche Datenströme optimiertes Forschungsnetz hat andere Annahmen als ein Zahlungsnetz, ein klassifiziertes System oder ein allgemeines Büronetz. Sicherheit lässt sich nicht durch das Kopieren von Kontrollen aus einem anderen Kontext bewerten; sie muss den tatsächlichen Workflow und die Daten schützen und zugleich die legitime wissenschaftliche Nutzung erhalten.
Das Laboratory Computing Resource Center veröffentlicht Cybersicherheits-Leitlinien für seine gemeinsam genutzte Infrastruktur.[13] Die Leitlinien beschreiben ausgewählte Authentifizierungs- und Nutzerpflichten. Solche Kontrollen sind Fähigkeiten und Richtlinienzusagen. Sie belegen weder, dass Zugangsdaten niemals kompromittiert werden, noch, dass jeder Nutzer die Richtlinie befolgt. Zuverlässigkeit hängt von Durchsetzung, Überwachung, Support, Ausnahmebehandlung und Wiederherstellung ab, wenn der normale Identitätspfad ausfällt.
Das IT-Leitbild der Advanced Photon Source benennt Verantwortlichkeiten für Netz, Firewall, Zugriff, Server, Backup und Support.[14] Das ist wichtig, weil ein moderner Instrumentenworkflow nicht nur eine Verbindung zwischen zwei Maschinen ist. Er umfasst Erfassungssysteme, Steuerungsnetze, Nutzerzugang, Speicher, Rechendienste und Supportteams. Ein Leitbild legt Umfang und Absicht fest. Es ist kein gemessener Dienstbericht.
Das gemeinsame Muster ist eine Kette:
- Ein Instrument oder ein Nutzer erzeugt Daten.
- Lokale Systeme puffern, benennen und schützen diese Daten.
- Identitäts- und Richtlinienkontrollen entscheiden, wer oder was sie bewegen darf.
- Campus-Netze transportieren sie zwischen Einrichtungen oder zu einer externen Netzkante.
- Forschungsnetze und Partnernetze transportieren sie über Verwaltungsdomänen hinweg.
- Speicher- und Rechendienste empfangen und verarbeiten sie.
- Anwendungen, Workflow-Engines und Menschen entscheiden, was als Nächstes geschieht.
Jeder Übergang ist zugleich Integrationspunkt und Ausfallgrenze. Das Netz kann Pakete zustellen, während ein Dienstkonto ungültig ist. Speicher kann Daten annehmen, während Metadaten falsch sind. Ein Pfad kann nominell ausreichend Kapazität haben, während ein Host, ein Protokoll oder eine Workflow-Einstellung den Durchsatz begrenzt. Ein Transfer kann abgeschlossen sein, während die resultierenden Daten unbrauchbar sind. Deshalb müssen Netzfähigkeit, Betriebszuverlässigkeit und Forschungsergebnis getrennt bleiben.
Campus-Infrastruktur, externe Anbieter und Kontinuität
Der Einrichtungs-Designleitfaden von Argonne dokumentiert Governance und technische Standards für Gebäude und Infrastruktur, einschließlich Überlegungen zu Kommunikation und Verkabelung.[15] Ein Standard schafft eine gemeinsame Entwurfssprache und einen Prüfpunkt. Er kann inkompatible Installationen verringern und die Wartung berechenbarer machen. Er belegt aber nicht, dass jede installierte Komponente kürzlich aktualisiert, dokumentiert oder getestet wurde.
Der Einrichtungs- und Infrastrukturplan des Labors von 2024 beschreibt Campus-Glasfaser, Kernnetz-Redundanz, Rechenzentren und geplante Investitionen.[16] Pläne sind wertvolle Belege für erkannte Bedarfe, Abfolgen und vorgesehene Kontrollen. Sie müssen zeitlich eingeordnet werden. Eine vorgeschlagene oder finanzierte Verbesserung ist nicht dasselbe wie eine abgeschlossene Implementierung. Ein formuliertes Redundanzziel ist kein Beleg dafür, dass alle Ausfalldomänen unabhängig sind.
Der DOE-Bericht zu Netzanforderungen für Basic Energy Sciences liefert einen spezifischeren externen Kontext.[22] Er beschreibt die Campus- und Weitverkehrsarchitektur von Argonne zum Zeitpunkt des Berichts, einschließlich externer Netzanbieter, Verbindungskapazitäten, redundanter Knoten und diverser Pfade. Der Bericht ist nützlich, weil er zeigt, wie Laborverkehr über eine einzelne Campus-Netzkante hinausreicht. Er ist kein aktuelles Verfügbarkeitsaudit, und seine Architektur kann sich nach der Veröffentlichung ändern.
ESnet beschreibt sich selbst als DOE-Forschungsnetz im Dienst wissenschaftlicher Zusammenarbeit.[21] Diese Rolle sollte nicht Argonne zugeschrieben werden. Argonne ist von externen Betreibern und Partnern abhängig, während diese Betreiber viele Institutionen bedienen. Die Verantwortung ist verteilt. Ein Argonne-Team kann eine Campus-Route kontrollieren und eine externe Änderung koordinieren, ohne jede Zwischendomäne zu kontrollieren.
Diese verteilte Verantwortung schafft ein Kontinuitätsproblem. Ein Dienst kann wegen lokaler Glasfaser, Routing-Politik, einer Upstream-Leitung, einer entfernten Institution, eines Hosts, Speichers, einer Authentifizierung, Middleware oder eines Anwendungsverhaltens ausfallen. Ein brauchbares Betriebsmodell benötigt genügend gemeinsam verfügbare Evidenz, um den Fehler einzugrenzen, ohne dass jede Organisation ihr privates Netz offenlegen muss.
Pfadmessung ist ein Weg, solche gemeinsame Evidenz aufzubauen. Die ESnet-Fallstudie zum Datentransfer zwischen Argonne und der University of Michigan beschreibt eine mehrschichtige Diagnose mit Werkzeugen wie perfSONAR und einer neuen Verbindung.[24] Der Fall zeigt, dass die beobachtete Leistung von mehreren Ebenen abhängen kann und die Diagnose koordinierte Änderungen erfordern kann. Es ist ein abgegrenzter Fall, kein flottenweiter Leistungsbenchmark.
Historische Dokumente zeigen, dass dieses Problem nicht neu ist. Ein Netzanforderungsbericht von 2007 hielt eine frühere Ausgangslage für die Konnektivität und den wissenschaftlichen Bedarf von Argonne fest.[25] ESnet dokumentiert zudem historische Software-Defined-Networking-Experimente mit priorisierter Bandbreite.[23] Diese Quellen belegen einen langjährigen Druck, Instrumente, Einrichtungen und entfernte Kooperationspartner zu verbinden. Sie belegen jedoch keine aktuelle Topologie oder aktuelles Produktionsverhalten.
Kontinuität erfordert daher mehr als Verbindungsredundanz. Sie erfordert aktuelle Einträge, Routing-Politik, wo gerechtfertigt diverse physische Pfade, unabhängige Beobachtung, getestete Eskalation, verwendbare Zugangsdaten, wiederherstellbare Konfigurationen und einen Weg, kritische Workflows am Laufen zu halten, wenn eine Komponente oder Organisation nicht verfügbar ist. Existenz und Qualität dieser Kontrollen lassen sich aus öffentlichen Dokumenten nicht vollständig ableiten. Es sind die richtigen Fragen, weil das sichtbare System so viele Grenzen überschreitet.
Fähigkeit, Zuverlässigkeit und Forschungsergebnisse
Das öffentliche Material enthält mehrere Beispiele integrierter Forschungsworkflows.
Ein ALCF-Artikel beschreibt ein von Argonne geleitetes Team, das vor einer Technologiedemonstration auf der SC19 Netzprobleme diagnostizierte und behob.[17] Ein weiterer beschreibt die Verbindung von Supercomputern und Experimenten zur Beschleunigung von Entdeckungen.[18] Ein weiterer Artikel behandelt die Automatisierung von Datenverarbeitungs-Workflows, die Instrumente, Transfer, Speicher und Rechenleistung verbinden.[19] Der Jahresbericht-Beitrag von ALCF zu Nexus und integrierter Forschungsinfrastruktur beschreibt Dienstkonten, Globus-gestützte Datenbewegung und On-Demand-Workflowmuster.[20]
Das sind nützliche Beispiele, aber sie beantworten unterschiedliche Fragen.
Der SC19-Bericht stützt eine Aussage zur Ausnahmebehandlung: Ein Team stieß auf Netzprobleme, untersuchte sie, nahm Änderungen vor und schloss eine Demonstration ab.[17] Er belegt nicht, wie oft ähnliche Probleme auftreten, wie lange eine Reparatur normalerweise dauert oder ob die Lösung für jeden Pfad gilt.
Die Geschichten von Instrument zu Rechenleistung stützen eine Aussage zur Systemfähigkeit: Einrichtungen können experimentelle Datenquellen mit entfernten oder On-Demand-Rechenworkflows verbinden.[18][19][20] Sie veranschaulichen Komponenten und Betriebsmuster. Sie belegen nicht, dass jedes Projekt das Muster ohne Integrationsarbeit übernehmen kann.
Eine Aussage über ein Forschungsergebnis bräuchte einen benannten Workload, eine Ausgangsbasis, ein Messfenster und eine vertretbare Darstellung der Kausalität. Einige veröffentlichte Projektberichte liefern Elemente dieses Kontexts, bleiben aber auf die beschriebene Arbeit begrenzt. Sie sind kein Beleg dafür, dass Argonne Network als Verzeichniseintrag ein bestimmtes wissenschaftliches Ergebnis oder einen Produktivitätsgewinn garantiert.
Diese Trennung ist in der Analyse von Technologieunternehmen wichtig, weil Fähigkeitsbehauptungen oft mit Zuverlässigkeitsbehauptungen verwechselt und Zuverlässigkeitsbehauptungen dann in Ergebnisversprechen umgewandelt werden. Eine 100-Gigabit-Schnittstelle etwa ist ein Kapazitätsmerkmal. Sie bedeutet nicht, dass eine Anwendung diese Rate dauerhaft erreicht. Ein erfolgreicher Transfer belegt, dass ein Transfer unter bestimmten Bedingungen abgeschlossen wurde. Er belegt keinen kontinuierlichen Dienst.
Ein Forschungsergebnis mag von schnellerer Datenbewegung abhängen, es hängt aber auch von Instrumentenqualität, Algorithmen, Rechenzeit, Speicher, Software und Menschen ab.
Eine strenge Bewertung sollte daher drei Fragengruppen stellen.
Zur Fähigkeit:
- Welche Systeme, Protokolle und Schnittstellen sind dokumentiert?
- Welche Teile werden lokal kontrolliert und welche gehören externen Betreibern?
- Welche Identitäten und Autorisierungspfade sind erforderlich?
- Welche Datenklassen, Anwendungen und Sicherheitsgrenzen fallen in den Geltungsbereich?
Zur Zuverlässigkeit:
- Wie wird das beabsichtigte Routing mit externen Beobachtungen verglichen?
- Wie werden physische, Routing-, Host-, Speicher-, Identitäts- und Anwendungsausfälle unterschieden?
- Welche Änderungen werden getestet, zurückgerollt und überprüft?
- Was kann weiterlaufen, wenn die normale Kontrollfläche nicht verfügbar ist?
Zum Ergebnis:
- Welcher benannte Workload hat sich verbessert?
- Wie lauteten Ausgangsbasis und Messzeitraum?
- Welche Beschränkungen haben sich verändert und welche blieben bestehen?
- Lässt sich der Effekt von Änderungen bei Rechenleistung, Speicher, Software oder Versuchsmethode trennen?
Die öffentlichen Quellen stützen das Stellen dieser Fragen. Sie liefern keine vollständige Bewertungstabelle.
Überwachungskosten
Überwachungskosten sind der Aufwand, der nötig ist, um eine technisch mögliche Änderung mit der autorisierten institutionellen Absicht zu verbinden. In einer Dual-AS-Umgebung umfasst das die Entscheidung, wer Registereinträge, Routing-Politik, Filter, Überwachung, Kontakte und externe Peering- oder Transitvereinbarungen ändern darf. Dazu gehört auch die Prüfung, ob die angeforderte Änderung für AS683, AS75 oder beide gilt.
Die Kosten sind nicht einfach Genehmigungszeit. Ein Prüfer braucht genug Kontext, um ein Präfix zu erkennen, das unter der falschen ASN eingetragen wurde, einen veralteten Kontakt, eine Routing-Politik, die über den vorgesehenen Umfang hinausgeht, oder eine Wartungsfolge, die beide nutzbaren Pfade gleichzeitig entfernt. Dieser Kontext muss verfügbar bleiben, während sich Personal, Anbieter, Systeme und Forschungsanforderungen ändern.
Wissenschaftliche Umgebungen erhöhen die Governance-Komplexität. Einrichtungen können unterschiedliche Betriebszeiten, Nutzergruppen, Sicherheitsanforderungen und Änderungsfenster haben. Eine campusweite Kontrolle, die für ein Segment sinnvoll ist, kann anderswo ein Instrument oder eine lange laufende Berechnung stören. Überwachung muss lokale Expertise bewahren und zugleich institutionelle Rechenschaftspflicht sicherstellen.
Ein wirksames Überwachungsmodell würde ein klares Inventar von Nummernressourcen, maßgeblichen Kontakten, Routenabsichten, externen Abhängigkeiten und Entscheidungsverantwortlichen führen. Es würde Evidenz proportional zur Tragweite verlangen. Eine beschreibende Änderung mag eine Prüfung benötigen; eine Änderung, die Routenankündigung, Sicherheitspolitik oder externe Kontinuität betrifft, mag unabhängige Verifikation und einen getesteten Rollback erfordern.
Die öffentlichen Aufzeichnungen geben das private Genehmigungsmodell von Argonne nicht preis. ARIN-Einträge belegen Kontaktrollen, und Einrichtungsdokumente belegen Verantwortungsbereiche.[1][2][14] Diese Aufzeichnungen machen Überwachung zu sichtbaren Betriebskosten, auch wenn sie diese nicht messen.
Integrationskosten
Integrationskosten entstehen dort, wo getrennt verwaltete Systeme wie eine einzige nutzbare Forschungsumgebung funktionieren müssen. Die sichtbare Kette umfasst ARIN-Registerdaten, BGP-Routing, Campus-Infrastruktur, Einrichtungsnetze, ESnet und andere externe Anbieter, Speichersysteme, Identität, Datentransferdienste, Anwendungen, Instrumente und entfernte Institutionen.
Standards verringern Mehrdeutigkeit, beseitigen aber nicht den Koordinationsbedarf. BGP kann Routen austauschen, während zwei Organisationen über die beabsichtigte Richtlinie uneins sind. Ein Transferwerkzeug kann Bytes bewegen, während Identität oder Dateiberechtigungen das Ergebnis unbrauchbar machen. Ein Instrument kann Daten schneller erzeugen, als ein nachgelagerter Workflow sie validieren oder speichern kann. Überwachungssysteme können unterschiedliche Uhren, Bezeichnungen und Schwellenwerte verwenden, was eine gemeinsame Vorfalls-Zeitachse erschwert.
Integration hat eine technische und eine Zuständigkeitsseite. Die technische Seite umfasst Schnittstellen, Protokolle, Benennung, Authentifizierung, Kapazität und Beobachtbarkeit. Die Zuständigkeitsseite umfasst, wer diagnostizieren, wer genehmigen, wer ändern, wer kommunizieren und wer Restrisiken akzeptieren darf. Ausfälle werden teuer, wenn der technische Pfad sichtbar, die Befugnis aber nicht geklärt ist – oder wenn die Befugnis klar ist, die nötige Evidenz aber an anderer Stelle liegt.
Die Dual-AS-Fläche fügt eine weitere Übersetzungsebene hinzu. Interne Teams denken möglicherweise in Einrichtungen oder Diensten, während externe Betreiber Präfixe, AS-Pfade, Schnittstellen und Leitungen sehen. Eine nützliche Vorfallsaufzeichnung muss diese Sichtweisen verbinden, ohne unnötig sensible Details preiszugeben.
Auch die öffentlichen ALCF-Leitfäden machen Nutzerintegration sichtbar.[10][11][12] Nutzer tragen Verantwortung für Datenverwaltung und -weitergabe. Ein zentrales Netzteam kann nicht jeden Workflow allein zuverlässig machen. Dokumentation, Werkzeuge, Support und Feedback müssen Nutzern helfen, ein Netzproblem von Speicher-, Anwendungs- oder Richtlinienverhalten zu unterscheiden.
Integrationskosten lassen sich durch gemeinsame Evidenzformate, stabile Identifikatoren, klare Grenzen, unabhängige Messung und geübte Eskalation senken. Sie lassen sich nicht allein durch den Kauf zusätzlicher Kapazität beseitigen.
Wartungskosten
Wartungskosten halten den Abstand zwischen dokumentiertem Entwurf und laufendem Dienst aufrecht. Sie umfassen den Lebenszyklus von Geräten und Software, Konfigurationsprüfung, Zertifikats- und Anmeldedatenerneuerung, Routen- und Filterpflege, Aktualisierung von Registerkontakten, Änderungen an der Überwachung, Backup-Validierung, Dokumentation, Kapazitätsplanung und Arbeiten an der physischen Infrastruktur.
Der Einrichtungs-Designleitfaden und der strategische Plan zeigen, dass Vernetzung in langlebige Gebäude, Glasfasersysteme, Rechenzentren und institutionelle Investitionen eingebettet ist.[15][16] Manche Komponenten lassen sich per Software aktualisieren; andere erfordern physische Arbeiten, Budget, Genehmigungen, Zugang und koordinierte Ausfälle. Ein logischer Entwurf kann mehrere Hardware-Generationen überdauern, während ein physischer Pfad spätere Entscheidungen einschränken kann.
Wartung umfasst auch Wissen. Ein Wiederherstellungsverfahren kann technisch korrekt, aber unbrauchbar sein, weil der Kontoinhaber gegangen ist, ein Schlüssel abgelaufen ist, ein Gerät ersetzt wurde oder sich ein externer Kontakt geändert hat. Selten genutzte Verfahren müssen gerade deshalb getestet werden, weil sie unbemerkt veralten können.
Der Forschungsbedarf ist nicht statisch. Neue Instrumente, größere Datensätze, andere Workflow-Engines und neue externe Partner können Verkehrsmuster verändern. Kapazitätsplanung allein auf Basis durchschnittlicher Nutzung kann Lastspitzen und Fristen übersehen. Planung allein auf Basis der Spitzennachfrage kann Ressourcen verschwenden oder Engpässe an anderer Stelle ignorieren. Der Betreiber braucht Messwerte, die sowohl für das Engineering als auch für die Priorisierung nützlich sind.
Wartung sollte nicht mit einem Zuverlässigkeitsnachweis verwechselt werden. Ein veröffentlichter Standard oder Investitionsplan zeigt, dass Wartbarkeit berücksichtigt wird. Zuverlässigkeit erfordert Evidenz, dass die laufende Umgebung beobachtet, aktualisiert, getestet und wiederherstellbar ist. Öffentliche Quellen liefern diese vollständige Evidenz nicht.
Kosten der Ausnahmebehandlung
Ausnahmebehandlung beginnt, wenn die erwartete Abfolge nicht mehr vertrauenswürdig ist. Eine Route kann von einigen Kollektoren sichtbar sein, von anderen aber nicht. Ein Transfer kann nur für einen entfernten Standort langsam sein. Ein Identitätstoken kann für einen interaktiven Nutzer funktionieren, für einen automatisierten Workflow aber fehlschlagen. Ein Wartungsereignis kann eine verborgene Abhängigkeit offenlegen. Ein Status-Dashboard kann grün bleiben, während Arbeiten auf Anwendungsebene fehlschlagen.
Der ESnet-Transferfall veranschaulicht, warum mehrschichtige Diagnose wichtig ist.[24] Ein Symptom, das als schlechte Netzleistung beschrieben wird, kann Host-Tuning, lokale Pfadbedingungen, Weitverkehrs-Routing oder einen entfernten Endpunkt betreffen. Kapazität hinzuzufügen, ohne die begrenzende Ebene zu lokalisieren, kann das Problem unverändert lassen. Mehrere Ebenen gleichzeitig zu ändern, kann es unmöglich machen zu erkennen, was gewirkt hat.
Ausnahmebehandlung verbraucht Expertise, Zeit und Koordination. Die Beteiligten brauchen eine gemeinsame Zeitachse, stabile Identifikatoren, externe Beobachtungen, Konfigurationsverlauf und klare Änderungsbefugnis. Sie brauchen auch Zurückhaltung. Eine einzelne fehlgeschlagene Prüfung ist kein Beleg für einen Ausfall. Ein erfolgreicher Ping ist kein Beleg dafür, dass ein wissenschaftlicher Workflow funktioniert. Eine Routenankündigung ist kein Beleg dafür, dass der beabsichtigte Dienst erreichbar oder sicher ist.
Der öffentliche SC19-Bericht zeigt ein Team, das vor einer Demonstration ein abgegrenztes Problem löst.[17] Er ist ein Beleg dafür, dass Diagnose und Reparatur Teil der Arbeit waren. Er ist kein Beleg für eine übliche Vorfallsrate, eine typische Reaktionszeit oder dauerhafte Immunität gegen ähnliche Fehler.
Gute Ausnahmebehandlung endet nicht nur mit dem wiederhergestellten Dienst. Sie sollte festhalten, was beobachtet wurde, was sich geändert hat, warum die Änderung autorisiert war, welche Unsicherheit bleibt und welche präventive Kontrolle überarbeitet werden sollte. Diese Aufzeichnungen senken die Kosten des nächsten Ereignisses und helfen, wiederkehrende systemische Fehler von unabhängigen Symptomen zu unterscheiden.
Ausfallmodus-Register
Die folgenden Ausfallmodi sind Entscheidungstests, die aus der öffentlichen Kontrollfläche abgeleitet sind. Sie sind keine Behauptungen, dass diese Ereignisse bei Argonne aufgetreten sind.
1. Registerkontakt-Drift
Der Registrant bleibt korrekt, während ein technischer oder administrativer Kontakt unerreichbar, unbefugt oder an eine stillgelegte Identität gebunden wird. Das normale Routing kann weiterlaufen, sodass die Schwäche verborgen bleibt, bis eine folgenreiche Änderung nötig ist. Die Erkennung erfordert regelmäßige Prüfungen von Befugnis und Erreichbarkeit – nicht nur ein nicht leeres Feld.
2. Abweichung zwischen ASN und Präfixinventar
Ein internes Inventar ordnet ein Präfix der falschen ASN zu oder lässt einen legitimen Ursprung aus. Eine auf diesem Inventar beruhende Änderung kann eine unbeabsichtigte Ankündigung oder einen falschen Filter erzeugen. Der Abgleich sollte maßgebliche Zuweisung, beabsichtigte Richtlinie, Konfiguration und externe Beobachtung vergleichen.
3. Verwechslung bei Änderungen an einer oder zwei ASNs
Ein für AS683 gedachter Wartungsplan wird auf AS75 angewendet, oder eine gemeinsame Änderung wird fälschlich als Abdeckung beider ASNs angenommen. Ähnliche Benennung und gemeinsame Eigentümerschaft machen dies zu einem normalen Betriebsrisiko. Stabile Identifikatoren und ressourcenbezogene Genehmigungen verringern es.
4. Veraltete Routenobjekt- oder Filterdaten
Ein Upstream oder Peer wendet Richtlinien auf Basis veralteter Registrierungs- oder Filterdaten an. Die lokale Konfiguration kann korrekt sein, während die Route abgelehnt bleibt. Die Diagnose erfordert zu wissen, welche Datenquelle jede externe Partei nutzt und wann sie aktualisiert wurde.
5. Partielle externe Sichtbarkeit
Eine Route ist über einige Kollektoren oder Anbieter sichtbar, über andere jedoch nicht. Eine einzelne erfolgreiche Beobachtung verschleiert den begrenzten Umfang. Der Betreiber braucht mehrere Beobachtungspunkte und eine explizite Definition der beabsichtigten Erreichbarkeit.
6. Route-Leak oder unbeabsichtigte Verbreitung
Ein Präfix wird über die beabsichtigte Richtliniengrenze hinaus oder über einen unerwarteten Pfad angekündigt. Das Register verhindert dies nicht von selbst. Die Erkennung hängt von Routenbeobachtung, Richtlinienabgleich und reaktionsfähigen Kontakten ab.
7. Verzögerung bei der Ursprungsautorisierung
Sicherheitsmetadaten und laufende Routing-Politik werden während einer Änderung inkonsistent. Eine legitime Ankündigung kann als ungültig behandelt werden, oder eine alte Autorisierung bleibt nach einer Absichtsänderung bestehen. Änderungsabfolge und unabhängige Verifikation sind die wichtigen Kontrollen.
8. Gemeinsamer Fehlermodus physischer Pfade
Zwei als redundant beschriebene logische Verbindungen teilen sich Leerrohre, Stromversorgung, Gebäudeeintritt, Geräte oder Wartungsbefugnis. Das Design wirkt divers, bis ein physisches Ereignis beide betrifft. Diversitätsbehauptungen erfordern Evidenz über tatsächliche Ausfalldomänen, nicht nur unterschiedliche Schnittstellennamen.
9. Zuständigkeitslücke zwischen Campus und WAN
Ein Fehler liegt zwischen einer Einrichtungsgrenze und einer Grenze des externen Anbieters, und keiner der ersten Beteiligten hat vollständige Evidenz. Jede Komponente kann im eigenen Dashboard gesund aussehen. Eine gemeinsame Übergabeaufzeichnung und ein gemeinsamer Testplan verkleinern die Lücke.
10. Host-begrenzter Transfer
Das Netz hat verfügbare Kapazität, aber Sender oder Empfänger werden durch CPU, Speicher, Datenspeicher, Protokolleinstellungen oder Schnittstellenkonfiguration begrenzt. Das Symptom als Netzkapazitätsproblem zu behandeln, verschwendet Zeit und kann unzusammenhängende Änderungen einführen.
11. Speicher-Gegendruck
Daten kommen schneller an, als eine Speicherebene sie aufnehmen, auslagern oder der nächsten Stufe bereitstellen kann. Netzgraphen können ungenutzte Kapazität zeigen, während der Workflow verzögert ist. Ende-zu-Ende-Beobachtbarkeit muss den Speicherzustand einschließen.
12. Identitätsablauf während der Automatisierung
Ein Dienstkonto, Zertifikat, Token oder eine delegierte Berechtigung läuft während eines langlaufenden oder unbeaufsichtigten Workflows ab. Interaktive Zugriffstests können für Menschen weiterhin funktionieren. Die Kontrolle besteht in der Verantwortung für den Lebenszyklus und einem Test, der die tatsächliche Automatisierungsidentität beansprucht.
13. Inkonsistente Richtliniendurchsetzung
Die Dokumentation erlaubt einen Datenfluss, während eine Firewall, Zugriffsliste oder Anwendungsrichtlinie ihn blockiert – oder umgekehrt. Dokumentierte und laufende Richtlinien weichen voneinander ab. Der Abgleich sollte sowohl beabsichtigten Zugriff als auch abgewiesene Pfade testen.
14. Abweichende Zeitbasen
Systeme zeichnen Ereignisse mit inkonsistenten Uhren, Zeitzonen oder Aufbewahrungsfristen auf. Beteiligte können Routenänderung, Transferverlangsamung, Authentifizierungsfehler und Speicherereignis nicht aufeinander abstimmen. Verlässliche Zeit und gemeinsame Identifikatoren sind grundlegende Vorfallsinfrastruktur.
15. Blinder Fleck der Überwachung
Die Überwachung hängt von demselben Pfad, denselben Zugangsdaten oder derselben Steuerungsebene ab wie der beobachtete Dienst. Ein gemeinsamer Ausfall lässt beide verschwinden, oder der Monitor meldet Erfolg von einem Standort, der die Nutzer nicht repräsentiert. Unabhängige Beobachtung verringert dieses Risiko.
16. Abweichende Dashboard-Semantik
Ein Team meldet Schnittstellenverfügbarkeit, ein anderes Pfaderreichbarkeit, und ein Workflow-Verantwortlicher meldet abgeschlossene Daten. Alle verwenden das Wort „up“ für unterschiedliche Bedingungen. Vorfallskoordination erfordert explizite Metriken und Geltungsbereiche.
17. Geplante Arbeiten als abgeschlossene Resilienz dargestellt
Ein strategischer Plan beschreibt künftige Redundanz oder Modernisierung, und spätere Leser behandeln ihn als aktuelle Architektur. Entscheidungen beruhen dann auf Schutz, der möglicherweise noch nicht existiert. Pläne brauchen Abschlussnachweise und ein Wirksamkeitsdatum.
18. Standard als installierter Zustand dargestellt
Ein Designleitfaden legt Verkabelungs- oder Netzpraktiken fest, aber ältere oder abweichende Installationen bleiben bestehen. Ein Standard verbessert künftige Konsistenz; er ist kein Inventar. Wartungsentscheidungen brauchen Ist-Zustands- und Testergebnisse.
19. Fehlgeschlagene Eskalation zum externen Anbieter
Der richtige externe Betreiber ist identifiziert, aber Kontaktweg, Supportberechtigung oder diagnostische Übergabe scheitern. Technische Redundanz hilft nicht, wenn niemand eine Maßnahme autorisieren kann. Eskalationswege sollten vor einem Vorfall getestet werden.
20. Zu weit gefasste Notfalländerung
Beteiligte ändern gleichzeitig mehrere Routen, Filter, Hosts oder Dienste, um einen kritischen Workflow wiederherzustellen. Der Dienst kehrt zurück, aber Kausalität und Rollback werden unklar, und ein begrenzter Fehler kann sich ausbreiten. Kontrollierte Hypothesen und reversible Schritte verringern den Explosionsradius.
21. Unvollständige Wiederherstellungskonfiguration
Ein Backup enthält Geräte- oder Dienstkonfigurationen, lässt aber Zugangsdaten, Zertifikate, externe Richtlinien, Abhängigkeitsversionen oder Genehmigungskontext aus. Die Wiederherstellung erzeugt ein syntaktisch gültiges, aber unbrauchbares System. Wiederherstellungstests müssen das Dienstverhalten validieren, nicht nur das Vorhandensein von Dateien.
22. Abhängigkeitsdrift in Forschungsworkflows
Ein Workflow fügt still einen neuen Endpunkt, ein Datenformat, einen Identitätsumfang oder eine Zeitannahme hinzu. Netz- und Sicherheitskontrollen beruhen weiterhin auf dem früheren Design. Das erste sichtbare Symptom tritt während eines hochwertigen Laufs auf. Die Änderungsverantwortung muss Anwendung und Infrastruktur gleichermaßen umfassen.
23. Missverständnis bei der Datenaufbewahrung
Nutzer nehmen an, eine Einrichtung oder ein Transferdienst bewahrt Daten länger auf als dokumentiert, oder Betreiber nehmen an, Nutzer hätten eine dauerhafte Kopie erstellt. Auf einen erfolgreichen Transfer folgen Verlust oder Unzugänglichkeit. Klare Aufbewahrungsgrenzen und Verifikation gehören zum Workflow.
24. Asymmetrie entfernter Standorte
Ein Argonne-Pfad funktioniert zu einem Kooperationspartner, aber nicht zu einem anderen, weil sich entferntes Netz, Richtlinie, Host oder Route unterscheiden. Ein lokaler Erfolgstest wird als universeller Beleg behandelt. Vor der Ursachenzuweisung ist vergleichende Pfadevidenz nötig.
25. Übertragung von Demonstration auf Produktion
Eine Forschungsdemonstration belegt, dass eine Integration unter vorbereiteten Bedingungen funktionieren kann. Sie wird dann als Beleg dafür behandelt, dass Routine-Nutzer dieselbe Zuverlässigkeit und denselben Support erhalten. Produktionsreife erfordert wiederholten Betrieb, Zuständigkeit, Wiederherstellung und gemessenes Dienstverhalten.
Ein praktischer Bewertungsrahmen
Eine verantwortungsvolle Prüfung von Argonne Network sollte mit den rechenschaftspflichtigen Aufzeichnungen beginnen und sich dann dem laufenden Verhalten zuwenden.
Erstens: Identität prüfen. Bestätigen Sie Verzeichniseintrag, ARIN-Registranten, AS-Nummern, Kontaktgruppen und das Datum der Beobachtung. Halten Sie Mehrdeutigkeiten fest, statt sie durch Namensannahmen aufzulösen.
Zweitens: das beabsichtigte Routing definieren. Listen Sie die unter jeder ASN erwarteten Präfixe, die autorisierten Ursprünge, die für jede Route erforderlichen externen Beziehungen und die zugehörigen Sicherheitsmetadaten auf. Vergleichen Sie diese Absicht mit mehreren externen Beobachtungen.
Drittens: den Workflow statt nur der Verbindung abbilden. Bestimmen Sie Instrument oder Erzeuger, lokalen Speicher, Identität, Campus-Pfad, externes Netz, entfernten Speicher oder Rechenleistung, Orchestrierungsebene und rechenschaftspflichtigen Verantwortlichen an jeder Grenze. Definieren Sie, was „funktionieren“ auf jeder Ebene bedeutet.
Viertens: Fähigkeitstests von Zuverlässigkeitsevidenz trennen. Eine erfolgreiche Protokollantwort oder ein erfolgreicher Transfer ist eine Fähigkeitsbeobachtung. Zuverlässigkeit erfordert wiederholte Messungen, Wartungsverhalten, Wiederherstellung und ein bekanntes Beobachtungsfenster. Erheben Sie einen punktuellen Erfolg nicht zu einem Verfügbarkeitsprozentsatz.
Fünftens: Ergebnisse nur auf der Evidenzebene messen. Wenn ein benanntes Projekt ein Ergebnis meldet, bewahren Sie Projektumfang, Ausgangsbasis und Abhängigkeiten. Schreiben Sie nicht die gesamte Verbesserung dem Netz zu, es sei denn, die Studie isoliert den Netzbeitrag.
Sechstens: Kontinuität testen. Fragen Sie, was geschieht, wenn ein Registerkonto nicht verfügbar ist, ein Kontakt veraltet ist, eine ASN zurückgezogen wird, ein Campus-Pfad ausfällt, ein externer Anbieter nicht erreichbar ist, ein Identitätsdienst ausfällt oder ein Speicherendpunkt keine Daten annehmen kann. Prüfen Sie, ob Befugnis, Evidenz und Wiederherstellungszugang dasselbe Ereignis überstehen.
Siebtens: Portabilität und Lock-in prüfen. In diesem Kontext ist Lock-in nicht bloß ein Anbietervertrag. Es umfasst Konfigurationen, Routing-Politik, Überwachungsverlauf, Zugangsdaten, einrichtungsspezifisches Wissen, proprietäre Workflow-Annahmen und externe Abhängigkeiten, die nicht reproduziert oder übergeben werden können. Ein System ist portabler, wenn ein anderes autorisiertes Team die Absicht verstehen, das wesentliche Verhalten wiederherstellen und das Ergebnis validieren kann.
Schließlich: Unsicherheit bewahren. Öffentliche Routenbeobachtungen ändern sich. Einrichtungsseiten beschreiben abgegrenzte Umgebungen. Berichte haben Daten. Pläne können künftige Arbeiten beschreiben. Fallstudien wählen besondere Ereignisse aus. Eine fundierte Bewertung gibt genau an, welche Ebene und welchen Zeitpunkt jede Quelle stützt.
Das Bild ist Kontext, kein Beweis
Das Beitragsfoto zeigt Computerausrüstung im Center for Nanoscale Materials des Argonne National Laboratory. Es dient als visueller Kontext für physische Rechen- und Verkabelungsarbeiten. Es zeigt nicht Argonne Network Administration, das Routing von AS683 oder AS75, das Campus-Backbone, ESnet- oder MREN-Konnektivität, private Topologie, aktuelle Sicherheitskontrollen, einen Vorfall, gemessene Zuverlässigkeit oder ein Nutzerergebnis.
Diese Grenze ist substanziell. Infrastrukturfotos können einen Artikel konkret wirken lassen, während sie mehr suggerieren, als sie belegen. Sichtbare Racks und Kabel verraten weder Routing-Politik, Redundanz, Kapazität, Eigentumsverhältnisse, aktuelle Konfiguration noch Betriebsqualität. Die sachlichen Aussagen in diesem Artikel stammen aus den zitierten Register-, Einrichtungs-, Betreiber- und Berichtsquellen, nicht aus visuellen Schlüssen.
Fazit
Argonne Network lässt sich am besten als reale Kontrollfläche der Netzwerkverwaltung verstehen, die an die registrierten AS683- und AS75-Identitäten des Argonne National Laboratory gebunden ist – nicht als erfundener eigenständiger kommerzieller Betreiber.
ARIN-Einträge belegen das Verhältnis von Registrant und technischem Kontakt.[1][2] Öffentliche Routing-Dienste liefern begrenzte Beobachtungen.[3][4][5][6][7][8] Einrichtungsdokumente von Argonne und ESnet-Material erklären, warum Routing-Identität, Campus-Infrastruktur, externe Konnektivität, Speicher, Sicherheit und Workflow-Integration für den wissenschaftlichen Betrieb wichtig sind.[9][10][11][12][13][14][15][16][17][18][19][20][21][22][23][24][25]
Die Evidenz stützt eine starke Fähigkeitsgeschichte: Forschungseinrichtungen können Instrumente, Speicher, Rechenleistung und externe Netze über dokumentierte Systeme und Betriebsbeziehungen verbinden. Sie stützt Beispiele für Diagnose und integrierte Workflows. Sie stützt weder eine universelle Zuverlässigkeitsbewertung, eine Behauptung über eine private Architektur noch ein Versprechen von Kundenergebnissen.
Die bleibende technische Frage ist Kontinuität. Zwei ASNs, mehrere Einrichtungen, externe Anbieter, gemeinsamer Speicher, Identitätssysteme und Forschungsanwendungen müssen bei Veränderungen und Ausfällen aufeinander abgestimmt bleiben. Diese Abstimmung verursacht wiederkehrende Kosten für Überwachung, Integration, Wartung und Ausnahmebehandlung. Registergenauigkeit ist wichtig, weil sie Befugnis verankert. Beobachtung des laufenden Codes ist wichtig, weil Einträge allein keinen Verkehr bewegen.
Wiederherstellung ist wichtig, weil wissenschaftliche Arbeit nicht darauf angewiesen sein kann, dass jede normale Kontrollfläche gleichzeitig verfügbar bleibt.
Für Beschaffende, Kooperationspartner und technische Prüfer ist die nützliche Frage nicht, ob Argonne eine beeindruckende Kapazitätsaussage oder eine erfolgreiche Demonstration veröffentlicht. Sondern ob rechenschaftspflichtige Aufzeichnungen, beabsichtigte Routen, beobachtetes Verhalten, Workflow-Abhängigkeiten und Wiederherstellungsbefugnis genau dann in Einklang gebracht werden können, wenn sie gebraucht werden. Die öffentliche Evidenz zeigt die Form dieser Verantwortung. Aussagen über ihre gemessene Leistung erfordern Betriebsdaten, die nicht öffentlich sind.
Quellen
Strategischer Investitionsplan für Einrichtungen und Infrastruktur von Argonne
Von Argonne geleitetes Team löst Netzprobleme vor der SC19-Demonstration
ALCF-Jahresbericht: Nexus und integrierte Forschungsinfrastruktur
ESnet-Fallstudie: Verbesserung des Datentransfers zwischen Argonne und der University of Michigan
Historischer Workshop-Bericht zu den Netzanforderungen für Basic Energy Sciences
Wikimedia Commons: Nanoscience High-Performance Computing Facility
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten