
Zusammenfassung
- RFC 1900 trennte die Befugnis, eine Adresse zu ändern, von der Fähigkeit, alle Verweise auf diese Adresse zu entdecken und zu berichtigen.
- Domainnamen verringerten die feste Kopplung, bewiesen aber weder abgelaufene Caches noch erneute Auflösung, geänderte ACLs oder die Mitwirkung externer Betreiber.
- Spätere RFCs machten aus der Umnummerierung eine Bestandsaufnahme über Router, DNS, DHCP, Sicherheit, Verwaltung, Anwendungen, Lizenzen und fremde Zuständigkeitsbereiche hinweg.
Der Änderungsauftrag kannte seine Abhängigkeiten nicht
RFC 1900 begann mit alltäglichen Gründen: Ein Host wechselte das Subnetz, ein überfülltes Subnetz wurde geteilt oder eine Organisation entwarf ihren Adressplan neu. Die öffentlich wirksame Ursache lag in CIDR. Aggregation erlaubte einem Provider, einen großen Block statt vieler kleiner Kundenrouten anzukündigen. Behielt ein Kunde nach dem Providerwechsel einen Teil des alten Blocks, konnte eine spezifischere Route die globale Routingtabelle mit den Folgen einer lokalen Entscheidung belasten. Umnummerierung tauschte lokalen Aufwand gegen globale Aggregation.
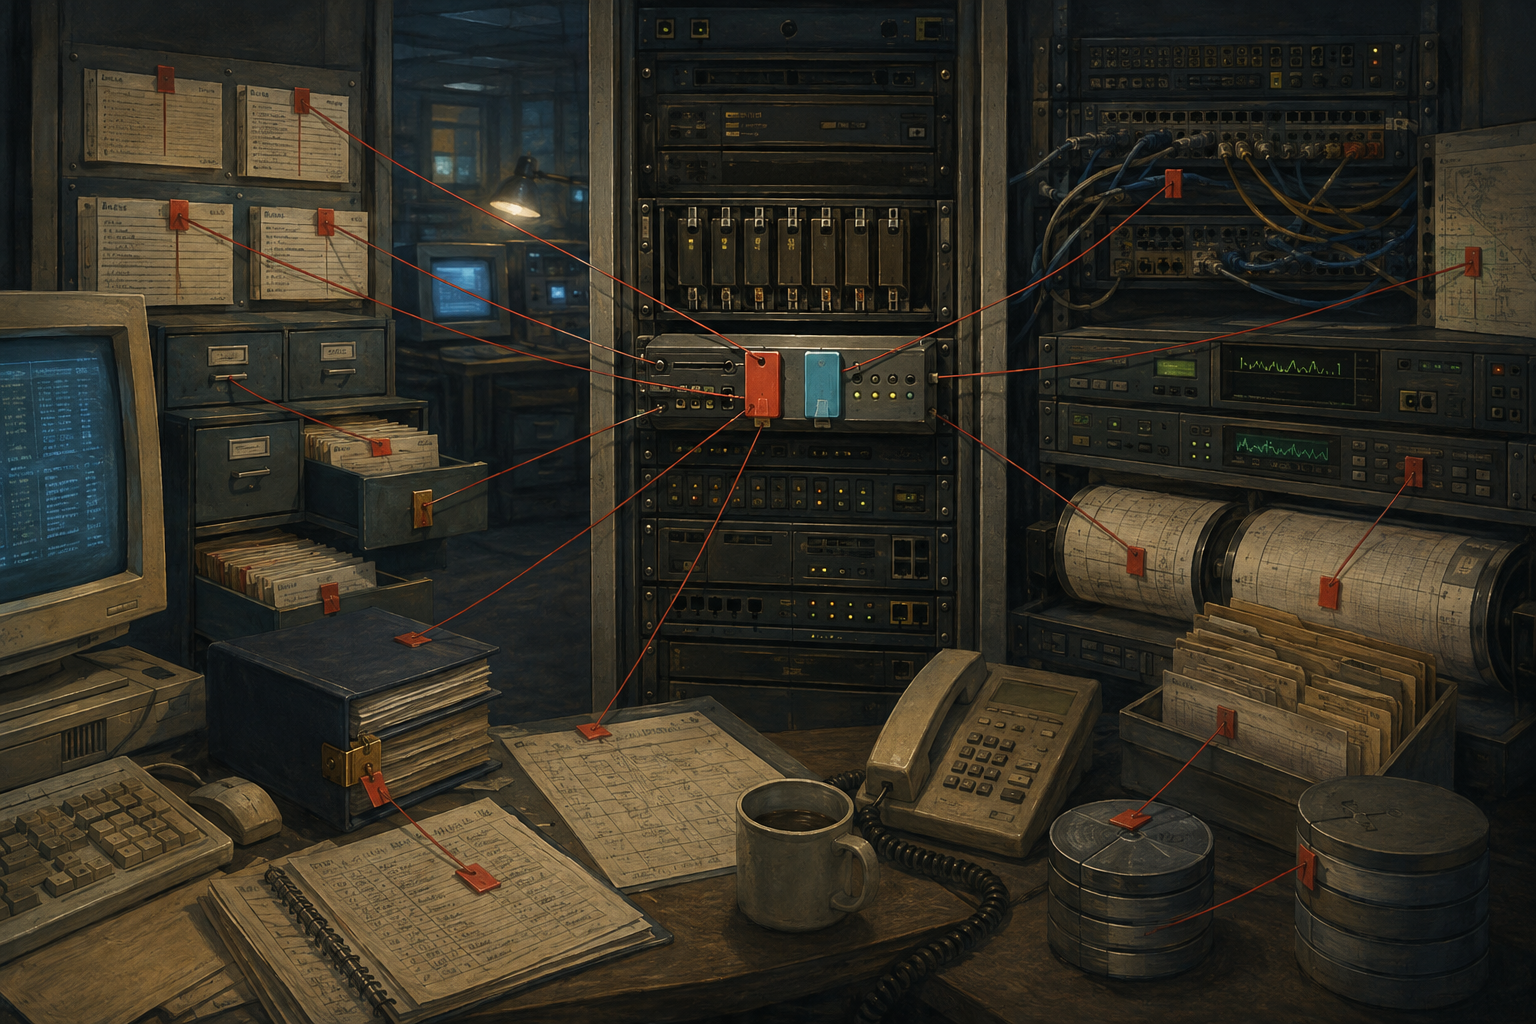
Dieser Tausch schuf keinen zentralen Abschlussbefehl. Der Provider konnte einen neuen Präfix zuteilen und den alten zurückziehen. Der Betreiber konnte Interfaces und Routen ändern. Keiner von beiden wusste deshalb, dass eine alte Adresse in einer Firewallregel, einem Überwachungsziel, einer Druckerkonfiguration, einer Lizenzdatei oder der Freigabeliste eines Partners stand.
Genau diese Asymmetrie verbirgt das Wort Renumbering. Die Entscheidung ist kompakt und sichtbar, der Abhängigkeitsgraph verteilt und womöglich nicht vollständig aufzählbar. Der Zuteilungsnachweis belegt eine Berechtigung. Eine Route zeigt die Verbreitung eines Präfixes. Eine Konfiguration beschreibt die Absicht eines Systems. Ein Diensttest liefert ein beobachtetes Ergebnis. Diese Belege hängen zusammen, doch keiner enthält die übrigen.
RFC 1900 nannte den Prozess teuer, mühsam und fehleranfällig und verwies auf wenige Werkzeuge und kaum dokumentierte Erfahrung. Das war nicht bloß unreife Software. Es war eine Wissensgrenze: Ein unbekannter Verweis lässt sich nicht aktualisieren, und die Adressautorität führt kein Register aller Kopien, die unabhängige Systeme angelegt haben.
DNS verschob die Bindung, nicht jeden Benutzer
Der dauerhafteste Rat lautete, Namen und Adressen auseinanderzuhalten. Der DNS-Namensraum war vom Adressraum unabhängig. Ein Name konnte eine relativ stabile Funktion ausdrücken; eine Adresse verortete ein Interface in einer Topologie. Speicherten Konfigurationen den Namen und lösten ihn bei Gebrauch auf, konzentrierte sich die Änderung im autoritativen DNS statt in zahllosen Dateien.
Das verringerte Zustand, beseitigte ihn aber nicht. Die DNS-Autorität kontrollierte ihren Eintrag. Resolver behielten Antworten im Cache. Anwendungen entschieden, ob sie erneut auflösten. Reverse DNS konnte beim Provider liegen. Ein Sicherheitsprodukt konnte das Ergebnis in eine ACL übernehmen, ein Partner die Zahl in ein System kopieren, das der umnummerierende Betreiber nicht einsehen durfte.
Auch dynamische Aktualisierung verlangte Authentisierung und erreichte nicht jedes Altsystem. RFC 1900 empfahl daher, Adressliterale zu vermeiden, FQDN sowie DHCP, Router- und Diensterkennung und authentisiertes dynamisches DNS einzusetzen. An IP-Adressen gebundene Lizenzen sollten verschwinden; Alt-Konfigurationen ließen sich aus kontrollierten Quellen erzeugen. DNS verkleinerte die Kopplungsfläche, stellte aber kein Abschlusszertifikat aus.
Sicherheitsassoziationen hatten eine eigene Lebensdauer. Eine Sitzung oder Richtlinie behielt ihre Bedeutung nur, solange die Bedingungen ihrer Einrichtung galten. Nach einer Adressänderung durfte niemand annehmen, eine authentisierte Sitzung, IPsec-Regel oder quellbasierte Identität bezeichne unverändert denselben Akteur.
Aus der Warnung wurde eine Inventarliste
RFC 2071 verlangte ein Inventar von Geräten, DNS, SNMP, Filtern und Zugriffslisten sowie eine Übergangsfrist. RFC 2072 weitete die Planung aus: Nicht nur Router, auch Dienste, Managementsysteme und Abläufe trugen Adressen.
RFC 4192 beschrieb für IPv6 ein „erst aufbauen, dann abbauen“. Neue und alte Präfixe konnten zeitweise nebeneinander bestehen. Diese Überlappung verringerte Unterbrechungen, bewies aber nicht die Migration aller Verweise. DNS-TTLs, Verwaltungsgrenzen und Geräte mit nur einem Konfigurationssatz blieben Ausnahmen. Koexistenz war ein Arbeitsfenster, kein Nachweis des Endes.
2010 erklärte schon der Titel von RFC 5887, Umnummerierung brauche weiterhin Arbeit. Ein einziger statischer Host konnte den Übergang blockieren. Adressen steckten in schreibgeschützten Medien, URLs, Cookies, Proxys, Socket-APIs, Lizenzen und proprietärer Software; manche Caches konnten unbegrenzt fortbestehen. Die 34 expliziten Abhängigkeiten in 257 Spezifikationen belegten das Problem in Normen, waren aber kein vollständiges Verzeichnis installierter Software. Private Implementierungen blieben von außen unbekannt.
RFC 6879 betonte erneut FQDN, Diensterkennung, Parametrisierung und systematische DNS-Nutzung. RFC 7010 ordnete Automatisierung in Bereitstellung, Erkennung, Konfiguration und Überwachung ein, fand jedoch keinen universellen Aktualisierungspunkt. Selbst Logsammler konnten die Quell-IP als Geräteidentität behandeln und damit nach dem Wechsel eine zusammenhängende Betriebsgeschichte in zwei scheinbare Geräte zerlegen.
Die historische Lehre ist konkret: Umnummerierung ersetzt nicht nur eine Zeichenfolge. Sie ersetzt Verweise auf allen relevanten Flächen und prüft, ob Dienst, Sicherheit und Beobachtbarkeit fortbestehen. Der neue Präfix beweist die Möglichkeit. Erst Inventar und beobachtete Ergebnisse beweisen Abhängigkeit für Abhängigkeit den Ausstieg aus dem alten.
Quellen
- RFC 1900 — Renumbering Needs Work
- RFC 2071 — Network Renumbering Overview
- RFC 2072 — Router Renumbering Guide
- RFC 4192 — Procedures for Renumbering an IPv6 Network without a Flag Day
- RFC 5887 — Renumbering Still Needs Work
- RFC 6879 — IPv6 Enterprise Network Renumbering Scenarios, Considerations, and Methods
- RFC 7010 — IPv6 Site Renumbering Gap Analysis
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten