
الخلاصة
- خصص RFC 2152 الرمز
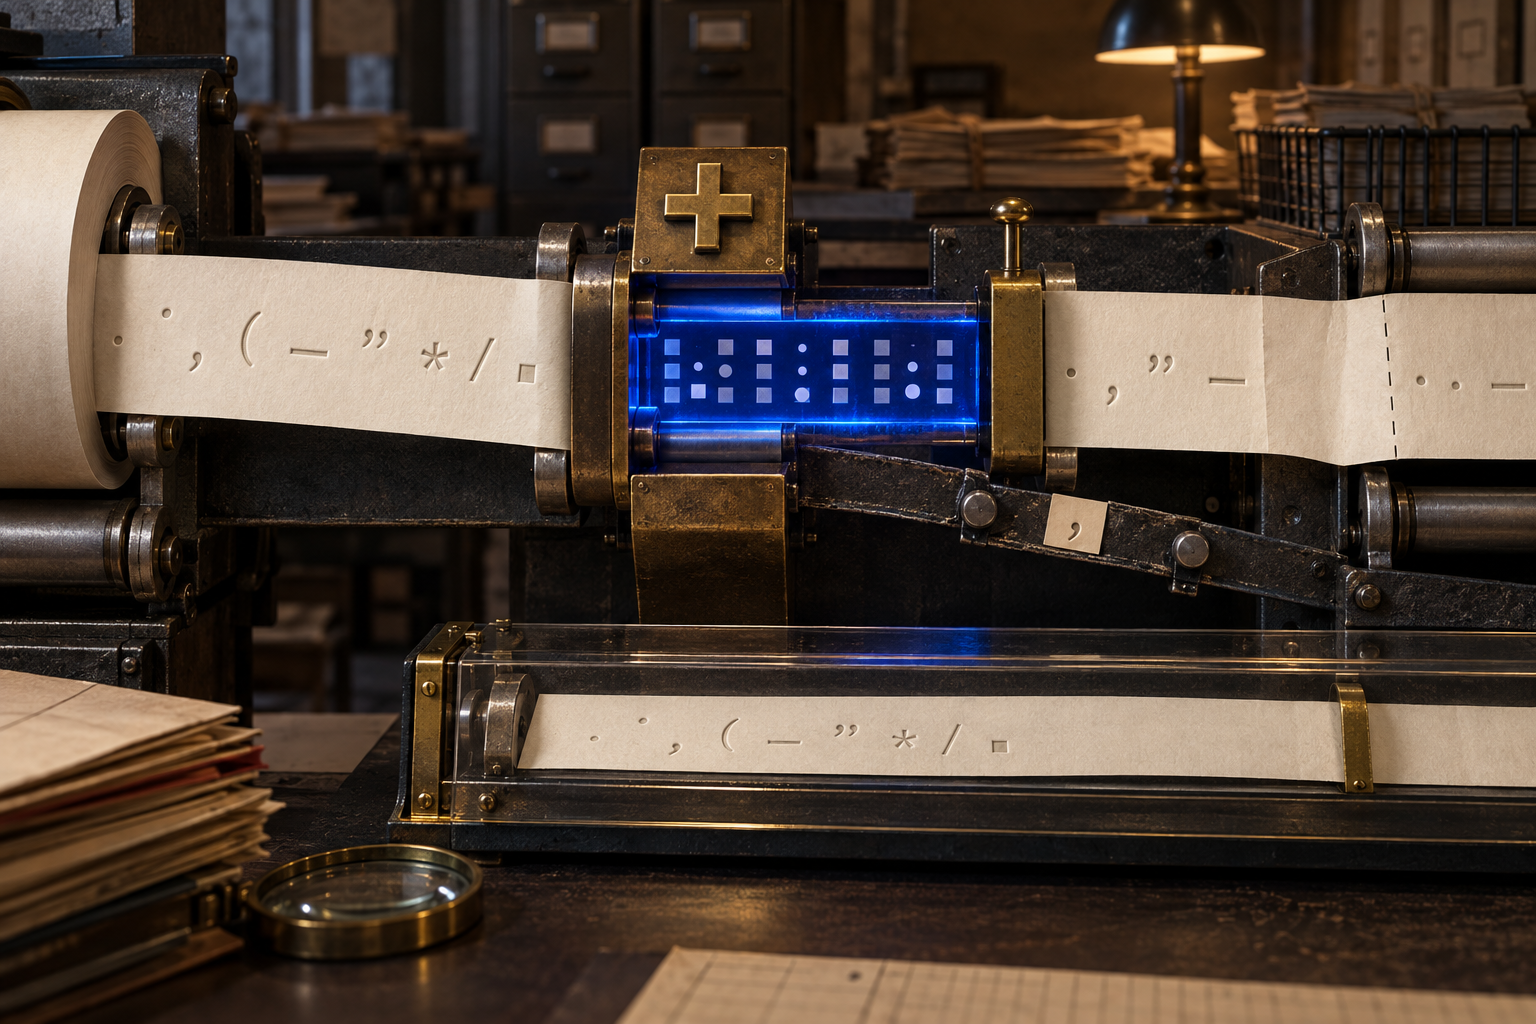
+لفتح Modified Base64 بلا حشو=فوق كميات Unicode ذات 16 بت وبترتيب البايت الأعلى أولاً؛ وينتهي المقطع عند رمز خارج الأبجدية ولا يمكنه عبور نهاية سطر. - أتاح Set O إرسال علامات مباشرة رغم خطر البوابات، كما جاز تحويل أي تسلسل Unicode. لذلك يثبت نجاح الفك تسلسل محارف، لا بايتات UTF-7 الأصلية ولا حدود الأسطر أو مسار النقل أو قصد الكاتب.
قد يبدو ترحيل أرشيف بريدي ناجحاً لأن العناوين اللاتينية ما زالت واضحة ولأن المفكّك لا يعرض خطأ. لكن إذا حل النص المشتق محل الرسالة الخام فلن يعود ممكناً معرفة العلامات التي أرسلت مباشرة، أو الموضع الذي أعادت فيه بوابة بناء السطر، أو البايتات التي شملها توقيع قديم.
نشر David Goldsmith وMark Davis الوثيقة RFC 2152 في مايو 1997 بوصفها وثيقة Informational تحل محل RFC 1642، لا معيار إنترنت. كانت المشكلة بريد US-ASCII ذا السبعة بتات. أما UTF-8 مع ترميز نقل MIME آخر فكان قد يفرض تحويلين وتوسعاً كبيراً على النص غير ASCII. أخرج UTF-7 بايتات ASCII فقط وأبقى المقاطع الموافقة لذلك المخزون قابلة للقراءة.
وقيّد RFC الحل بنفسه: يستخدم عادة في قنوات السبعة بتات مثل البريد، بينما يفضَّل Unicode المباشر أو UTF-8 في البيئات الأخرى.
المباشر لم يكن آمناً بالدرجة نفسها
ضم Set D الحروف والأرقام وتسع علامات مباشرة، واستبعد + و=. وسمح Set O بإرسال علامات إضافية مباشرة اختيارياً، مع تحذير صريح من أن بعضها غير قانوني في حقول الرؤوس أو لا يعبر بعض البوابات صحيحاً. واستُبعدت الشرطة المائلة العكسية وعلامة التلدة لأن بعض تنويعات ASCII تعيد تعريفهما.
عرض الملحق A نسختين من النص الصيني نفسه. استخدمت إحداهما علامات Set O الاختيارية وقد تفشل في بعض البوابات؛ وتجنبت الثانية ذلك. ما كان أوضح للعين لم يكن بالضرورة أكثر حفظاً.
فتح رمز الجمع حالة داخل الرسالة
بعد + تقرأ الرموز وفق أبجدية Base64 في RFC 2045 من دون =. ينهي رمز خارج Set B المقطع؛ وإذا كان امتصه المفكّك، بينما يمثّل +- علامة جمع حرفية. ويكون التسلسل مشوهاً إذا أعقب الجمع فوراً رمز ليس من Set B ولا شرطة.
قبل Base64، تُسلسل كميات Unicode ذات 16 بت بالبايت الأعلى أولاً، وتُعامل كل نصف من زوج UTF-16 البديل كمية مستقلة. العدد الفردي من البايتات غير صحيح، ولا يجوز أن تكون بتات الذيل المهملة غير صفرية.
تجعل القواعد النحو قابلاً للاختبار، لكنها لا تصادق على المصدر. يعيد المثال Hi Mom +Jjo-! الوجه المبتسم إذا بقي الإدخال كاملاً؛ ولا يجيب عن اختيار المرمّز الأول أو تدخل الوسيط أو الشكل الذي رآه الكاتب.
نهاية السطر حد للبروتوكول
ينتهي المقطع المحوّل دائماً عند نهاية السطر ولا يجوز أن يعبرها. لذا يجب تقسيم السطور قبل UTF-7 أو إنجاز العمليتين معاً، واستخدام content-transfer encoding من MIME إذا ظل السطر طويلاً بدلاً من قطعه داخل المقطع.
أوصى RFC أيضاً بأسطر SMTP قصيرة تنتهي بـCRLF وتحويل فاصلي السطر والفقرة في Unicode لتحسين القراءة في الأنظمة القديمة. قد يكون هذا التحويل صحيحاً للتشغيل البيني لكنه يغير التسلسل الأصلي؛ صحة التشغيل لا تعني حفظ البايتات.
يفقد الفك تاريخ الاختيار
تسمح Rule 2 بتحويل أي تسلسل Unicode، بينما تتيح Rule 1 وRule 3 إبقاء بعض المحارف مباشرة. لذلك يمكن لتيارين مختلفين من UTF-7 أن ينتهيا إلى النص نفسه. ينجح المفكّك في مهمة النص حتى لو لم يحفظ الطريق.
ينبغي فصل أربعة إيصالات: بايتات الرسالة الخام ونهايات سطورها، وحكم النحو الصارم، وتسلسل Unicode الناتج، وعرض العميل. وعند الحاجة إلى توقيع أو تحقيق أو نزاع، يجب حفظ الأصل وبصماته عبر كل حد.
ما زالت IANA تسجل UTF-7 وMIBenum 1012 وcsUTF7. يثبت السجل الاسم، لا الانتشار أو السلامة. أما UTF-7-IMAP فهو ترميز آخر لأسماء صناديق IMAP فقط، وتقول IANA إنه لا يستخدم خارج ذلك السياق.
لم يناقش RFC 2152 مسائل الأمن. تناولت إرشادات Unicode اللاحقة مخاطر اختلاف المقارنة والتحويل بين المكونات، لكنها توضح اليوم أن UTR 36 مستقر وغير مُصان وأن لبعض توصياته خلفاء. لا يصبح صمت 1997 ضماناً، ولا يصبح التحذير اللاحق قياساً لمنتج بعينه.
هناك تصويبان verified: القيمة 96 تخص grave accent، وكلمة مفقودة أعيدت إلى جملة نهاية السطر. أما اقتراح ثالث فكان rejected. حالة التصويب جزء من الدليل.
تساعد فكرة Heng Lu عن الحد الأدنى للمواصفة في ضبط الادعاء: اشترك في نحو حتمي بقدر حاجة التشغيل البيني فقط. وتطلب أولوية الشفرة العاملة مراقبة البوابة الفعلية، بينما تمنع طبقات الواقع رفع وسم charset أو نص مقروء إلى نتيجة حفظ منفذة.
المصادر
إحاطة الأعضاء
سياق أعمق للملف الشخصي
سجّل الدخول بمستوى العضوية المناسب لفتح الإحاطة الكاملة وملاحظات المصادر.
للدائرة الاستراتيجية فقط
الدائرة الاستراتيجية
مفتوح لجميع القراء. افتح إحاطات الملف الشخصي بعد الانضمام وتسجيل الدخول.
انضم إلى الدائرة الاستراتيجيةلأعضاء تحالف القيادات فقط
تحالف القيادات
لأصحاب الأصول الفكرية المؤهلين وللإدارة؛ سجّل الدخول للوصول إلى إحاطات التحالف.
انضم إلى تحالف القيادات