
Кратко
- Slurm распределяет узлы, CPU, память, GPU и другие ресурсы, преобразуя разделы, приоритеты, правила качества обслуживания, справедливого распределения и резервирования в решения об очередности.
- TRES, GRES, топология и cgroups позволяют операторам планировать ускорители как физические ресурсы с ограничениями; одного количества GPU недостаточно, чтобы гарантировать подходящее размещение или эффективное выполнение.
- Разработчики Slurm основали SchedMD в 2010 году для коммерческой разработки, поддержки и обучения; 15 декабря 2025 года NVIDIA приобрела компанию и пообещала продолжить открытую и нейтральную по отношению к поставщикам разработку.
- Доверие после приобретения будет зависеть от тестирования оборудования разных поставщиков, практики выпуска версий и характера вкладов в проект, при этом каждый оператор кластера по-прежнему отвечает за политику, с которой фактически сталкиваются его пользователи.
Простаивающий GPU не обязательно является доступным GPU
В кластере Slurm физически простаивающий ускоритель не переходит автоматически к следующему запросившему его пользователю. Сначала задание должно соответствовать условиям раздела, укладываться в запрошенную конфигурацию ресурсов, удовлетворять правилам учётной записи и качества обслуживания, не попадать под резервирование требуемых узлов и иметь более высокий приоритет, чем конкурирующие задания. Только после этого планировщик выделяет ресурсы и разрешает запуск.
Такая последовательность делает Slurm чем-то большим, чем очередь. Это уровень управления допуском и распределением ресурсов для значительной части систем высокопроизводительных вычислений и ИИ. Пользователи отправляют задания;slurmctldсопоставляет их с состоянием и политикой кластера; процессыslurmdна вычислительных узлах запускают и контролируют работу;slurmstepdуправляет отдельными этапами заданий. Необязательная службаslurmdbdзаписывает в базу данных сведения о заданиях, использовании ресурсов и связях между учётными записями.
Последствия носят не только технический, но и экономический характер. В кластере ИИ может быть достаточно GPU в совокупности, однако крупное задание обучения всё равно не запустится, если свободные устройства фрагментированы между неподходящими узлами, находятся за неудачно устроенной топологией или зарезервированы для другого проекта. Планировщик может сократить такие потери, если соответствующие ограничения представлены в его модели. Но он не способен создать недостающие GPU, устранить перегрузку коммуникационной среды или сделать неэффективное приложение полезным.
Поэтому значение Slurm определяется решениями, которые он принимает до запуска приложения. Более двух десятилетий проект превращал простой вопрос — кому сейчас разрешено использовать какую машину? — в настраиваемую систему распределения всё более неоднородной и дорогостоящей инфраструктуры.
Slurm превращает локальную политику в машинное время
Slurm возник в рамках сотрудничества под руководством Lawrence Livermore National Laboratory и впервые появился в 2002 году. Изначально он координировал независимо отправляемые параллельные задания в крупных Linux-кластерах, не требуя от каждого приложения понимания всей вычислительной системы. Первоначальная архитектура отделяла распределение ресурсов от выполнения заданий и предоставляла общий уровень управления, который можно было адаптировать для разных учреждений.
Это базовое разделение сохраняется. Контроллер поддерживает централизованное представление об узлах, заданиях и состоянии планирования, а демоны вычислительных узлов выполняют уже разрешённую работу. Резервный контроллер и сохраняемое состояние могут уменьшить последствия отказа основного контроллера, однако высокая доступность по-прежнему зависит от согласованности состояния, исправной аутентификации, сетевой доступности и проверенных процедур восстановления. «Отказоустойчивость» — это архитектурная возможность, а не гарантия безвредности любого сбоя уровня управления.
Более глубокие изменения произошли по мере появления в Slurm механизмов политики. Разделы объединяют узлы в классы обслуживания или административные пулы. Ассоциации связывают пользователей и учётные записи с долями, ограничениями и историей использования. Правила качества обслуживания могут менять приоритеты, лимиты или порядок вытеснения. Резервирования удерживают ресурсы для обслуживания, мероприятий или указанных пользователей. Многофакторный приоритет может учитывать возраст задания, справедливое распределение, размер задания, раздел, QOS и заданные площадкой факторы.
У Slurm нет универсального определения справедливости. Один университет может отдавать предпочтение проектам, которые использовали меньше своей долгосрочной квоты. Национальная лаборатория может резервировать мощности для определённой программы. Коммерческий оператор GPU может создавать разные уровни обслуживания. Одно и то же программное обеспечение способно выразить все три модели, поскольку политику определяет сама площадка.
Такая гибкость одновременно является сильной стороной Slurm и его операционным риском. Очередь становится трудно объяснить, когда разделы пересекаются, исключения накапливаются, а несколько систем весовых коэффициентов взаимодействуют друг с другом. Тогда пользователи воспринимают результат как произвольный, даже если программа в точности исполняет конфигурацию. Планировщик может вычислить приоритет, но обосновать политику всё равно должно учреждение.
Справедливое распределение определяет, кто ждёт, но не объясняет, что считать справедливостью
О справедливом распределении часто говорят как об объективном свойстве планировщика. На практике это механизм, который переносит решения учреждения о распределении ресурсов во времени. История использования, иерархия учётных записей и настроенные доли могут влиять на будущий приоритет, чтобы группа, израсходовавшая меньше положенной доли, получила преимущество перед группой, использовавшей больше.
Поэтому учёт становится частью управления.slurmdbdможет записывать задания, этапы, ассоциации и отслеживаемые ресурсы одного или нескольких кластеров. Администраторы используют эти записи для отчётности, внутреннего расчёта стоимости, ограничений использования и вычисления справедливых долей. Таким образом, поле базы данных, выглядящее чисто административным, может повлиять на то, когда исследователь или инженерная команда в следующий раз получит дефицитные вычислительные ресурсы.
Качество такого реестра имеет значение. Если пользователи привязаны к неверной учётной записи, использование ресурсов фиксируется непоследовательно или исторические данные хранятся неправильно, получившийся приоритет может быть технически корректным, но институционально ошибочным. Изменения состава проектов, общие служебные учётные записи и вручную исправленные данные требуют надлежащего управления, поскольку планировщик может считать их свидетельствами права на ресурсы.
Поэтому споры об очереди трудно свести к программной ошибке. Долгое ожидание может быть вызвано спросом, неточной оценкой времени выполнения, резервированием, низким коэффициентом справедливой доли, требованиями к топологии, правилом QOS или тем, что задание просто не помещается в текущий набор свободных ресурсов. Slurm предоставляет механизмы, но оператору нужна достаточная наблюдаемость, чтобы восстановить, какой из них оказался решающим.
Для пользователей объяснимость становится частью качества услуги. Очередь легче принять, когда видно, почему задание ожидает, какая политика применяется и что позволит ему запуститься. По мере удорожания кластеров и роста их коммерческого значения такая прозрачность превращается из удобства для исследователей в управленческий вопрос.
Обратное заполнение превращает пустые интервалы в полезную работу
Строгая приоритетная очередь может расходовать мощности впустую. Крупное высокоприоритетное задание может стоять первым, но не запускаться, пока не освободится достаточно узлов. Без дополнительной логики меньшие задания, способные завершиться до этого момента, также будут ждать, оставляя ресурсы без дела.
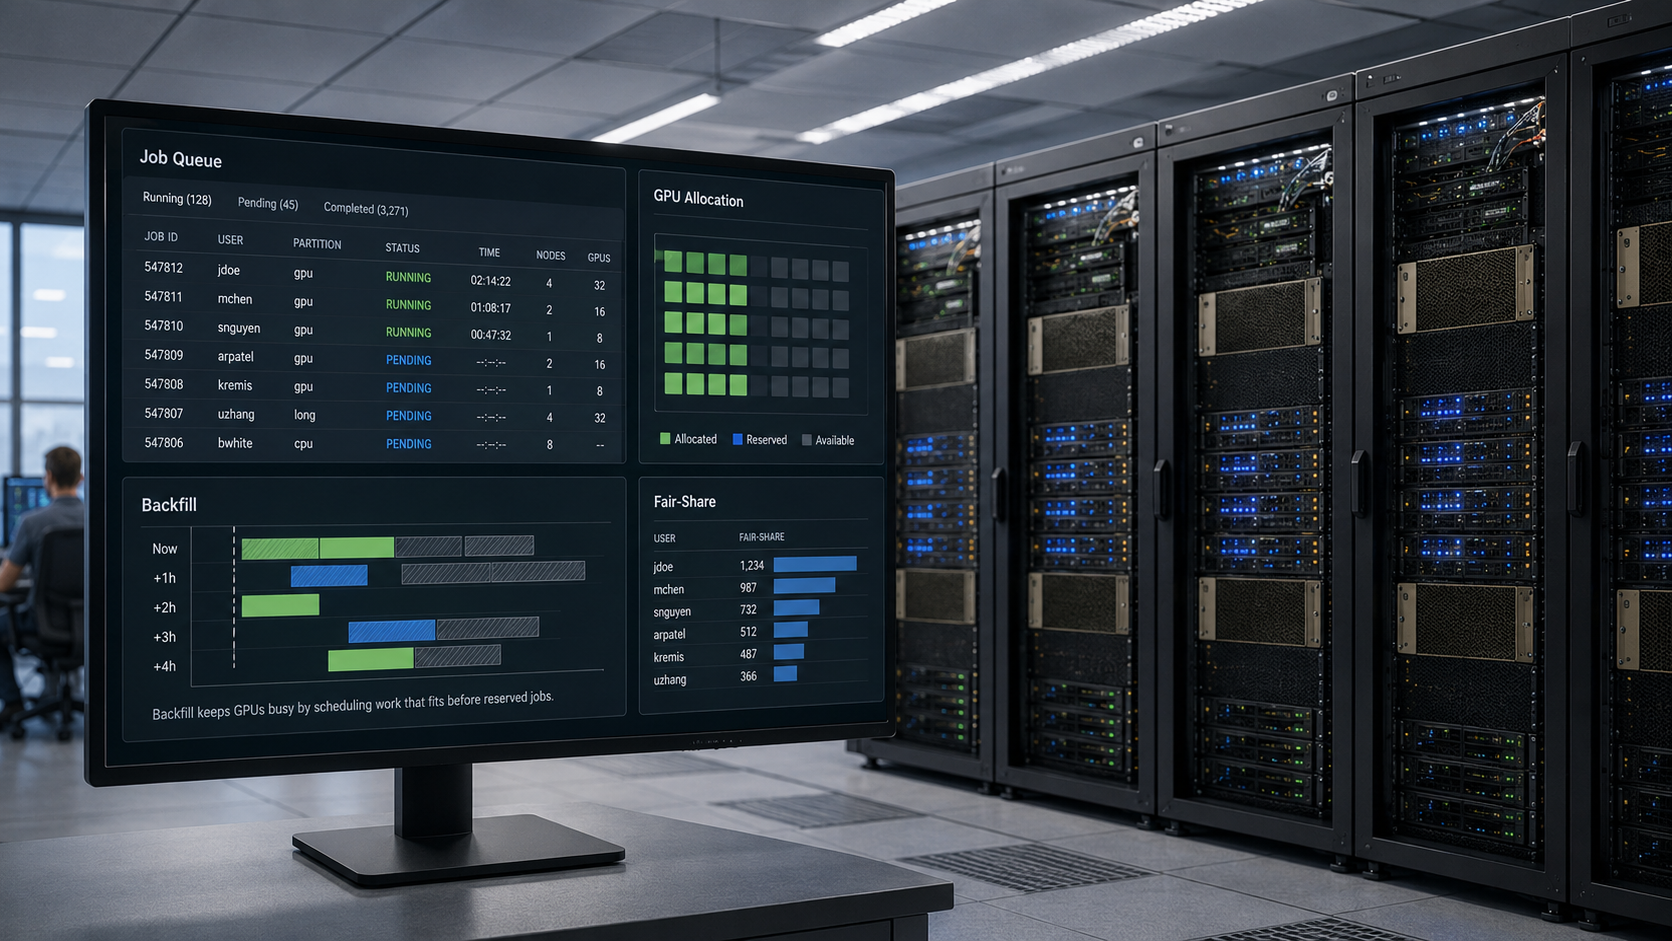
Планировщик обратного заполнения Slurm решает эту проблему: он оценивает, когда смогут начаться более приоритетные задания, а затем запускает менее приоритетную работу, которая должна завершиться, не задерживая их. Планировщик спрашивает не просто о том, какое задание следующее. Он определяет, может ли задание использовать временно свободный интервал, сохранив ожидаемое время запуска работы, стоящей впереди.
Этот механизм эффективен, поскольку крупные кластеры часто фрагментированы. Одни узлы освобождаются раньше, другие остаются занятыми. Короткое задание может поместиться в образовавшийся промежуток, не меняя времени запуска задания, которое учреждение считает более важным. Поэтому обратное заполнение способно одновременно повысить загрузку и сократить ожидание.
Эффективность зависит от поступающей информации. Если пользователи запрашивают намного больше времени, чем им требуется, планировщик может решить, что задание нельзя безопасно разместить в промежутке. Если времени запрошено слишком мало, задание могут завершить принудительно до окончания работы. Ограничения топологии и ускорителей могут сделать теоретически свободный интервал непригодным. Сбои способны нарушить ожидаемое расписание.
Обратное заполнение в миниатюре показывает модель работы Slurm. Программа может принять сложное решение на основе заявленного состояния, но не может идеально предсказать будущее. Для улучшения очереди нужны точные запросы, надёжные сведения о состоянии кластера и политика, оставляющая планировщику достаточно пространства для компромиссов.
GPU сделали конфигурацию выделяемых ресурсов не менее важной, чем их объём
Ускорители изменили смысл понятия «доступная мощность». Восемь CPU зачастую более взаимозаменяемы, чем восемь GPU для распределённого обучения. Модель ускорителя, объём памяти, связи PCIe или NVLink, положение в сети и состав узла могут определять, будет ли выделенная конфигурация работать ожидаемым образом.
Slurm представляет неоднородные ресурсы через Trackable RESources, или TRES, и Generic RESources, или GRES. GPU можно учитывать по количеству и типу и связывать с узлами. Интеграция устройств и cgroups позволяет ограничить задание выделенными ему ускорителями. Плагины топологии и ограничения помогают планировщику размещать задания с некоторым учётом физического устройства системы.
Так GPU превращается из подключённого периферийного устройства в планируемую экономическую единицу. Администраторы могут учитывать использование ускорителей, ограничивать доступ, резервировать определённые типы устройств и строить политику вокруг дефицитного оборудования. Для инфраструктуры ИИ это важно, поскольку очередь часто определяет доступ к самому дорогому компоненту кластера.
Однако модель ресурсов полезна лишь настолько, насколько полно она отражает топологию. Восемь свободных GPU, распределённых по узлам с неподходящими каналами связи, могут быть неравноценны восьми GPU в двух тесно связанных серверах. Планировщик способен выбирать на основе настроенной топологии, но не может автоматически вывести все зависимости сети, памяти или приложения.
То же ограничение относится к загрузке. Панель мониторинга может показывать, что GPU выделены, хотя задание ждёт хранилище, коллективные операции связи, загрузку данных или восстановление после повторяющихся сбоев. Slurm может сообщить оператору, кто и когда занимал ресурс. Сам по себе он не доказывает, что ускоритель выполнял полезную работу.
Планировщик находится над коммуникационной средой, но всё равно зависит от неё
Slurm не находится на пути передачи данных. После запуска задания трафик приложения проходит через процессоры, память, межсоединения и хранилища, минуя планировщик. Однако это не делает планировщик независимым от физической инфраструктуры.
Решения о размещении могут сосредоточивать или распределять работу между коммутаторами, блоками или доменами ускорителей. Выделение ресурсов с учётом топологии способно сократить расстояние обмена данными для параллельного задания. Игнорирование топологии может превратить достаточную сырую мощность в плохо работающее задание, поскольку полезная пропускная способность находится в другом месте.
Планировщик также зависит от точных данных о состоянии узлов. GPU может присутствовать, но быть неисправным. Узел может оставаться доступным для контроллера, хотя его путь к хранилищу деградировал. При разделении сети выполняемое задание может выглядеть для контроллера иначе, чем в действительности. Плагины, проверки состояния узлов и локальные операционные процессы должны преобразовывать физические условия в состояния, на которые планировщик способен реагировать.
Это создаёт границу, которую легко неверно истолковать в отчётах о производительности. Если задание выполняется медленно, причиной могут быть выделение ресурсов, поведение приложения, хранилище, сетевая конкуренция, состояние ускорителя или их сочетание. Если кластер простаивает, причиной может быть низкий спрос, фрагментация, резервирование или сбои, а не плохой алгоритм планирования.
Поэтому оператору полезно измерять весь путь от запроса до завершённой работы: задержку в очереди, качество выделения ресурсов, успешность запуска, время выполнения, повторные попытки, потерянную работу и окончательное завершение. Совокупное выделение GPU информативно, но не равнозначно полезному результату.
SchedMD превратила открытый проект в бизнес поддержки
Когда Slurm вышел за пределы лаборатории, организациям потребовался не только исходный код. Производственным кластерам были нужны предсказуемые выпуски, отладка, помощь с обновлениями, обучение и инженеры, способные работать с необычными конфигурациями площадок. В 2010 году разработчики Slurm создали SchedMD для предоставления этого коммерческого уровня.
Так возникла привычная модель открытого ПО. Код оставался открыто доступным по лицензии проекта, а клиенты платили за экспертизу, поддержку и разработку для сложных производственных систем. Коммерческая работа давала сопровождающим возможность финансировать устойчивую разработку, а операторам — путь эскалации, когда очередь, управляющая крупным кластером, вела себя неожиданно.
SchedMD также стала центром концентрации знаний. В крупных системах планирования накапливаются операционные подробности, которые трудно освоить только по документации: восстановление после сбоев, порядок обновлений, взаимодействие плагинов, пограничные случаи учёта и последствия необычной политики. Компания, в которой работают ключевые сопровождающие, может превратить этот опыт в преимущество поддержки, не владея каждым вкладом в проект или каждым развёртыванием.
Это различие важно, поскольку политика Slurm всегда оставалась локальной. SchedMD могла поставлять код, исправления и рекомендации, но не определяла коэффициенты справедливого распределения, резервирования или права учётных записей в университете, национальной лаборатории или коммерческом сервисе ИИ. Пользовательский опыт Slurm складывается из вышестоящего ПО и собственного устройства учреждения.
К моменту, когда ИИ повысил ценность планируемых мощностей GPU, роль SchedMD стала шире роли обычного поставщика ПО. Компания была главным коммерческим куратором открытого уровня управления, который многие операторы уже встроили в рабочие процессы, сценарии, системы учёта и операционные процедуры.
NVIDIA изменила стимулы, связанные с сопровождением проекта
15 декабря 2025 года NVIDIA объявила о приобретении SchedMD. Компания заявила, что Slurm останется открытым и нейтральным по отношению к поставщикам, а разработчики SchedMD получат доступ к большему числу ускоренных систем и инженерных ресурсов. Лицензия не стала внезапно проприетарной, а приобретение не передало NVIDIA локальную политику планирования операторов.
Изменилась структура стимулов вокруг главного коммерческого куратора проекта. NVIDIA — не просто компания-разработчик, финансирующая сопровождающих. Она также является ведущим поставщиком GPU, сетевого оборудования и систем, производительность которых может зависеть от обнаружения, размещения и запуска рабочих нагрузок.
Это создаёт и потенциальную выгоду, и обоснованное опасение. Более ранний доступ к сложным системам ИИ может улучшить тестирование и сократить путь от изменений оборудования до его поддержки планировщиком. Такая же близость вызывает закономерный вопрос: продолжат ли конкурирующие ускорители, межсоединения и архитектуры систем получать равное внимание.
Данные первых месяцев после приобретения не позволяют объявить ни о захвате проекта, ни о безупречной нейтральности. Открытая разработка продолжалась. Slurm 26.05 и последующие исправления свидетельствовали об активной работе над выпусками, а июльские обновления 2026 года устраняли аварийные завершения и другие операционные проблемы. Разработка Slinky также продолжалась. Это более весомые признаки качества сопровождения, чем обещание в день приобретения, но они не разрешают долгосрочный сравнительный вопрос.
NVIDIA также называла Slurm широко используемой системой в ведущих суперкомпьютерах и сообщала, что на момент приобретения SchedMD поддерживала сотни клиентов. Эти заявления показывают масштаб, но исходят от самой компании и относятся к определённой дате. Они не являются полной переписью частных кластеров ИИ, исследовательских систем или всех развёртываний планировщика.
Поэтому вопрос нейтральности следует рассматривать как проверяемый инженерный тест. Остаются ли интерфейсы универсальными там, где это возможно? Решаются ли проблемы конкурирующего оборудования открыто и своевременно? Проверяют ли процессы выпуска и среды непрерывной интеграции действительно неоднородную аппаратную базу? Могут ли внешние участники по-прежнему влиять на код, не проходя через проприетарный продукт NVIDIA?
Открытый код даёт операторам право на выход, но не бесплатную замену
Открытая лицензия Slurm важна, поскольку операторы могут изучать, изменять и распространять код на её условиях. Это создаёт формальный барьер для простого превращения проекта в закрытое ПО и даёт сообществу законный путь к созданию ответвления, если сопровождение станет неприемлемым.
Однако жизнеспособное ответвление не возникает благодаря одной лицензии. Для крупномасштабного планирования нужны специалисты, понимающие состояние контроллера, учёт, плагины, выпуски, безопасность и широкую матрицу оборудования. Нужны тестовые системы, доверие пользователей и люди, готовые переносить исправления в поддерживаемые версии.
Практическая стоимость перехода также намного выше замены одного исполняемого файла. В зрелых средах Slurm накапливаются сценарии заданий, структуры учётных записей, история использования, собственные плагины, мониторинг, операционные процедуры и привычки пользователей. Другой планировщик может быть технически пригоден, но всё равно потребовать дорогостоящего переноса политики и институциональной памяти.
Поэтому собственность NVIDIA заслуживает внимания, однако возможность ответвления нельзя считать исчерпывающим ответом. Сильнейшая форма нейтральности — не теоретическая возможность уйти после возникновения проблемы, а сохранение полезности проекта для неоднородной инфраструктуры до того, как уход станет необходимым.
Та же логика относится к коммерческой поддержке. Операторы могут зависеть от экспертизы компании, в которой работают ключевые сопровождающие, даже при открытом коде. Если эта экспертиза сузится до одной аппаратной экосистемы, исходный код останется доступным, но практическая граница поддержки станет менее нейтральной.
Slinky объединяет два уровня управления в одной инфраструктуре
Современная инфраструктура ИИ всё чаще сочетает пакетное планирование с Kubernetes. Платформенные команды могут использовать Kubernetes для подготовки ресурсов, операторов, сервисов и жизненного цикла контейнеров, сохраняя модель заданий Slurm, справедливое распределение, резервирования и семантику параллельных нагрузок.
Slinky — попытка SchedMD связать эти два мира. Компонентslurm-operatorможет развёртывать компоненты Slurm и управлять ими средствами, ориентированными на Kubernetes, аslurm-bridgeкоординирует работу Kubernetes и Slurm с общими ресурсами. Версия 1.2.0 вышла 2 июля 2026 года после появления первой стабильной ветки в конце 2025 года.
Преимущество очевидно. Организация может сохранить сложившуюся политику Slurm и при этом использовать облачные инструменты для управления окружающей инфраструктурой. Это способно уменьшить потребность в создании полностью отдельной операционной среды для пакетных вычислений.
Сложность заключается в полномочиях. Kubernetes и Slurm по-разному представляют желаемое состояние, владение рабочими нагрузками и восстановление. Если после сбоя обе системы считают, что управляют узлом, устройством или нагрузкой, интеграция должна однозначно определять, чьё состояние является главным и как с ним согласуется другая система.
Это не основание отвергать подход. Это причина оценивать Slinky по операционным данным, а не по архитектурной стройности. Производственные развёртывания должны показывать, как при участии двух систем оркестрации обрабатываются обновления, изоляция отказавших узлов, RBAC, сбои контроллеров и частичное разделение сети.
На протяжении истории Slurm границы координируемой планировщиком области неоднократно расширялись. Интеграция с Kubernetes продолжает эту тенденцию, но каждая новая поверхность управления повышает важность понимания того, к кому переходит ответственность при сбое.
Очередь может повысить загрузку и всё равно дать плохой результат
Slurm предоставляет операторам множество способов эффективнее использовать дорогостоящие мощности. Обратное заполнение сокращает простои. Справедливое распределение распределяет доступ во времени. Размещение с учётом топологии улучшает локальность. Резервирования защищают критически важную работу. Вытеснение освобождает ресурсы для срочных или премиальных заданий.
У каждого механизма есть цена. Резервирование может оставить мощности без дела, если ожидаемое задание не поступит. Вытеснение может уничтожить полезную работу, если приложение не умеет создавать контрольные точки. Правило топологии может сохранить производительность одного задания, усилив фрагментацию для других. Справедливое распределение может поддерживать политику, которая больше не соответствует приоритетам учреждения.
Риск возрастает, когда операторы оптимизируют один показатель. Высокого уровня выделения GPU можно достичь, удерживая устройства за заданиями, остановившимися по другой причине. Малое время ожидания можно получить, допуская задания к конфигурациям ресурсов, которые увеличивают время выполнения. Агрессивное вытеснение может обеспечить один уровень обслуживания, растрачивая уже затраченные на прерванные задания энергию и вычисления.
Для инфраструктуры ИИ более подходящий показатель — объём завершённой полезной работы на единицу дефицитной мощности и времени. Slurm влияет на результат, но представляет лишь один уровень. Среды обучения, хранилища, архитектура сети, контрольные точки, состояние ускорителей и качество пользовательских запросов также определяют, создаёт ли выделение ресурсов ценность.
Здесь же проходит граница между вышестоящей и локальной ответственностью. Если площадка выбирает политику, отдающую преимущество одной учётной записи, чрезмерно использует резервирования или задаёт нереалистичные правила вытеснения, результат не следует автоматически приписывать SchedMD или NVIDIA. Если планировщик неверно рассчитывает состояние, неправильно работает с устройством или вносит регрессию, значимым становится поведение вышестоящего проекта.
Надёжной эксплуатации нужна достаточная проверяемость, чтобы различать эти случаи.
Реальная поверхность управления разделена между несколькими сторонами
Сопровождение Slurm может выглядеть централизованным, поскольку кластер планирует один контроллер, а в одной компании теперь работает много экспертов проекта. На практике управление разделено.
Сопровождающие вышестоящего проекта решают, какой код войдёт в выпуски. NVIDIA владеет SchedMD и может распределять инженерные ресурсы. Поставщики оборудования вносят вклад в интеграцию и предоставляют системы для тестирования. Администраторы кластеров выбирают версии, плагины, модели топологии, учётные записи, QOS и ограничения. Руководители учреждений решают, кто имеет право на дефицитные вычислительные ресурсы. Пользователи определяют, какие ресурсы запрашивать и насколько точно описывать время выполнения. Затем приложение определяет, насколько эффективно будет использовано выделенное.
Такое многоуровневое управление — центральный факт Slurm. Ни одна сторона не контролирует результат целиком.
Это также объясняет, почему управление очередью приобрело стратегическое значение. Когда ускорители были менее дефицитными и ценными, неоптимальное правило могло лишь раздражать. В крупной инфраструктуре ИИ то же правило способно изменить время ожидания, степень фрагментации и долю дорогостоящих мощностей, которые завершают полезную работу.
Достижение Slurm состоит в том, что единая открытая система может выражать совершенно разные модели распределения, не навязывая всем учреждениям одно определение справедливости. Его ограничение заключается в том же: программа не может гарантировать, что выбранная модель разумна, понятна или легитимна.
Поэтому долгосрочная проверка заключается не просто в том, продолжает ли Slurm планировать задания. Важно, смогут ли операторы и дальше восстанавливать причины, по которым задание получило или потеряло доступ к дефицитным вычислительным ресурсам, а вышестоящий проект — сохранять доверие применительно к неоднородному оборудованию, которое хотят эксплуатировать эти операторы.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров