
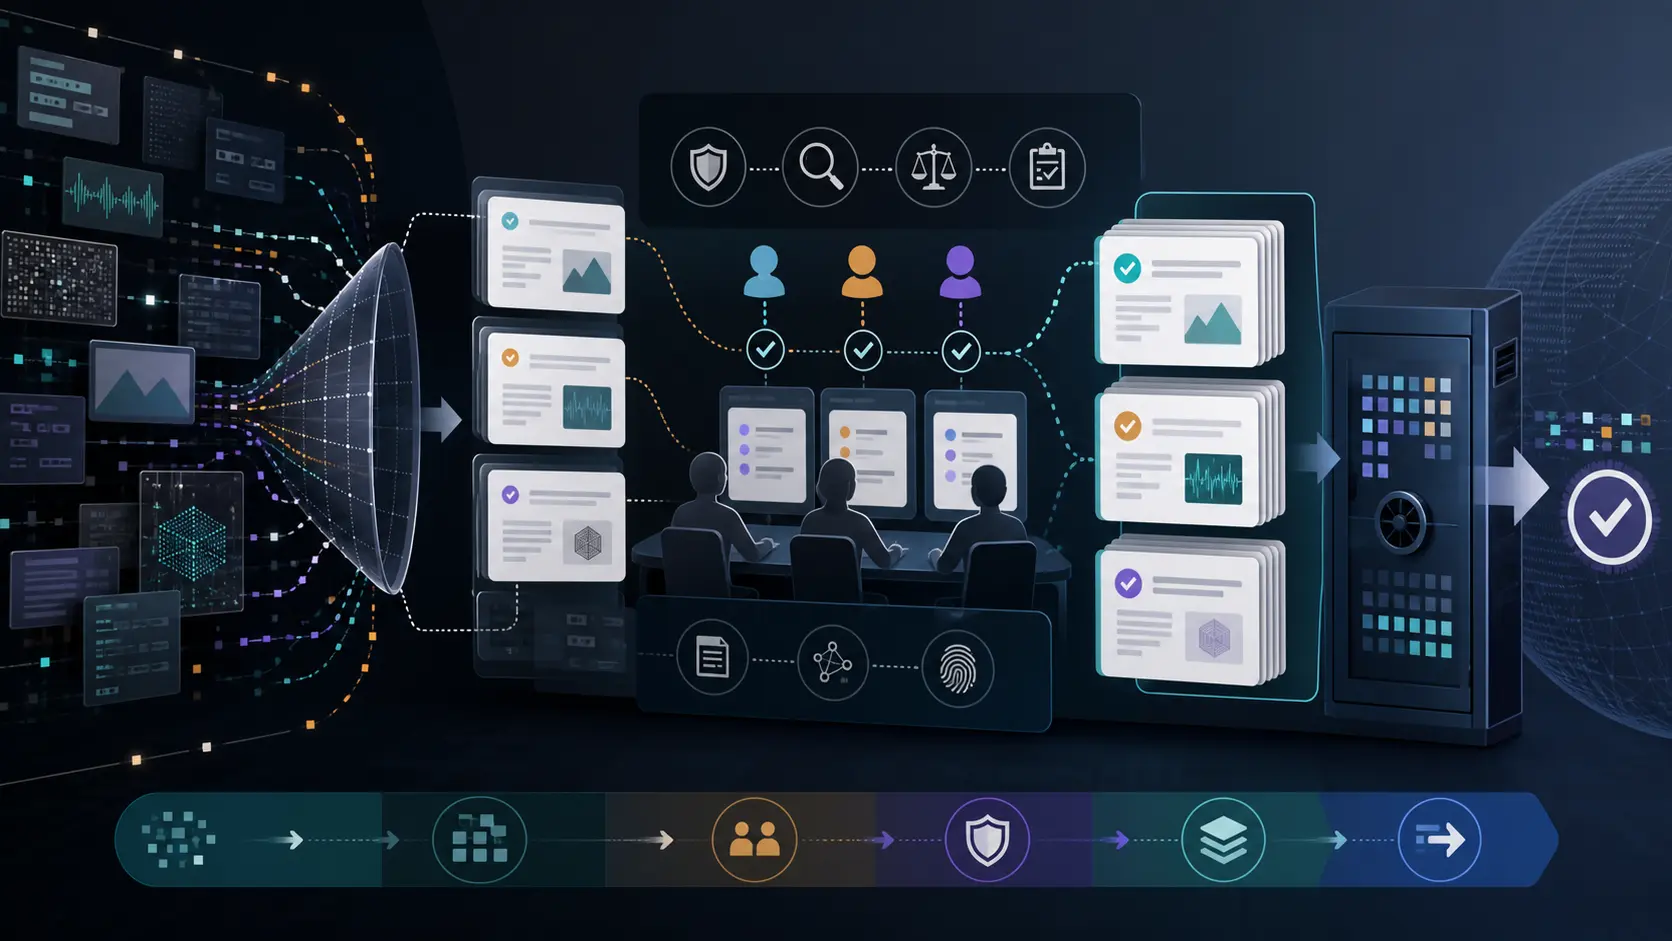
Резюме
- Scale AI следует оценивать по принятой единице данных или оценки: задаче, строке, метке, результату рецензирования или записи оценки модели, которым покупатель может доверять настолько, чтобы обучать на них модель, проводить оценку, экспортировать, проверять и повторно использовать.
- Публичная продуктовая поверхность Scale располагает нужными примитивами для этого: проекты, задачи, пакеты, таксономии, колбэки, статусы аудита, разделение ролей рецензентов, дашборды, трейсы, интеграции с хранилищами и варианты защищённого развёртывания. Эти примитивы делают качество управляемым, но не автоматическим.
- Самые трудные риски — не риски бренда. Это неоднозначные инструкции, низкое согласие между рецензентами, утечка бенчмарков, слабое происхождение данных, ошибки в правах доступа к хранилищам, ограничения по локализации данных, устаревшие оценочные наборы, переобучение на тест, циклы переделок и издержки на поддержание согласованности между людьми и автоматическими оценщиками.
- Покупателям стоит сравнивать Scale с ручной проверкой, собственными операциями по данным, инструментами провайдеров моделей, открытыми стеками для оценки и с сокращением объёма задачи, измеряя стоимость принятой единицы, долю переделок, расхождения рецензентов, полноту происхождения данных, конфигурацию безопасности, предельное улучшение модели и стоимость перехода к другому поставщику.
Принятая единица — это продукт
Scale AI находится в самой неприметной части ИИ-стека. Её работа идёт до демонстрации модели и после выгрузки сырых данных. Это место, где изображение, документ, диалог, ответ кода, цепочка рассуждений, сценарий безопасности или операционная запись становятся тем, на чём команда модели может обучаться или что может оценивать. Публичная история часто подаёт это как проблему масштаба: больше разметчиков, больше меток, больше задач, больше спроса со стороны бизнеса и государства. Производственная история уже и сложнее. Покупателю нужна единица свидетельства, которую можно принять.
Принятая единица — это не просто метка. Это запись с причиной существования, набором инструкций, таксономией, путём рецензирования, следом происхождения, экспортируемым результатом и достаточным контекстом, чтобы другая команда поняла, почему она должна влиять на модель. Вдокументации Scale по задачамзадача — это отдельная единица работы, сопоставленная с фрагментом данных, который нужно разметить. Вдокументации по ключевым понятиямпроекты организуют задачи, пакеты группируют задачи, а выполненные задачи дают структурированные ответы. Это правильный знаменатель для оценки Scale: он достаточно мал, чтобы его можно было проверить, и достаточно велик, чтобы иметь значение при повторении миллионы раз.
Та же логика применима к оценке. Оценка модели полезна настолько, насколько полезны примеры, рубрики, рецензенты и правила выборки, которые её сформировали. Страница Scale об оценке для разработчиков моделей описывает проблему как нехватку качественных, заслуживающих доверия оценочных наборов и стабильности в отчётности, предупреждая о таких рисках, как дезинформация, приватность, предвзятость, киберзлоупотребления и опасный контент.
Это продуктовое утверждение важно, потому что оно называет настоящую проблему покупателя: не может ли модель однажды обойти бенчмарк, а может ли организация продолжать оценивать нужное поведение, не допуская утечки ответов, не переобучаясь на тест и не теряя согласованности оценщиков со временем.
Поэтому полезный вопрос не в том, есть ли у Scale операции с данными, большая ли у неё сеть исполнителей или пользовался ли ею какой-то клиент. Полезный вопрос в том, помогает ли Scale покупателю превращать неопределённость в принятые свидетельства с меньшими совокупными издержками, чем альтернативы. Сырой пример может быть неоднозначным. Политика может измениться. Два рецензента могут не согласиться. Модель может улучшиться на простых случаях, но провалиться на важных краевых. Автоматический оценщик может стать источником предвзятости, а не ускорением. Право доступа к хранилищу может быть удобным при загрузке и опасным при экспорте.
Пакет может выглядеть завершённым, тогда как следующая команда не сможет воспроизвести основания приёмки.
Принятая единица разделяет также три слоя, которые обычно смешивают. Возможности модели — это то, что умеет модель заказчика. Надёжность продукта — это то, могут ли инструменты, рецензенты, API, дашборды и варианты развёртывания Scale предсказуемо обрабатывать свидетельства. Производственный результат заказчика — это то, улучшается ли реальная задача покупателя с учётом контроля, интеграции, рецензирования, обработки исключений, хранения, безопасности и издержек перехода. Scale может обеспечить второй слой и влиять на третий. Она не владеет каждым результатом модели заказчика.
Эта граница важна для существующей записи о компании Scale AI в справочнике. Scale AI — компания, которая здесь оценивается, вместе с управляемыми Scale продуктами, такими какData Engine,Generative AI Data Engine, Scale Evaluation,GenAI PlatformиDonovan. Статья — не суждение о каждой модели, обученной на данных Scale, о каждой государственной программе, где упоминается Scale, о каждом клиентском приложении поверх провайдера моделей или о каждом утверждении о рынке труда в сфере данных. Всё это может влиять на доверие покупателя, но не является основным техническим знаменателем.
Основной знаменатель — принятая единица данных для обучения или оценки. Если такая единица надёжна, Scale может стать инфраструктурой. Если нет, Scale превращается в дорогую маршрутизацию задач.
Scale продаёт повторяемый цикл, а не готовую модель
Самая сильная публичная продуктовая история Scale — это цикл. СтраницаData Engineописывает цикл как сбор, курирование и разметку данных, затем обучение и оценку моделей, затем повторение. СтраницаGenerative AI Data Engineрасширяет эту историю на заказные наборы данных, рецензирование экспертами в предметной области, RLHF, оценку моделей, редтиминг и работу по безопасности. Цикл важен, потому что полезная разработка моделей редко заканчивается одним набором данных. Модель отказывает по-новому, покупатель добавляет новую политику, в производстве появляется краевой случай, регулятор требует свидетельств, меняется сегмент клиентов или провайдер моделей выпускает новую версию. Тогда процесс работы с данными и оценки должен сдвинуться с места.
Для покупателя этот повторяемый цикл — одновременно причина рассмотреть Scale и причина быть осторожным. Разовый проект по разметке можно вести как сервисный контракт. Повторяемый цикл становится операционной инфраструктурой. Как только команда модели покупателя начинает зависеть от вендора в таксономиях, процессах рецензирования, пулах исполнителей, дашбордах оценки, кейсах редтима, интеграциях с хранилищами и экспорте, вендор перестаёт просто заполнять бэклог. Он формирует то, что организация покупателя считает свидетельством.
За этим утверждением в документации Scale стоит реальная механика. Проекты привязаны к сценарию использования и инструкциям.Документация по управлению проектамиговорит, что задачи в проекте должны использовать одни и те же инструкции и что значительные изменения инструкций должны приводить к созданию нового проекта. Это небольшое, но важное ограничение. Оно признаёт, что дрейф инструкций меняет смысл метки. Если команда меняет определение вредного ответа, действительного налогового документа, дорожной разметки, клинически значимого симптома или успешного вызова инструмента в середине набора данных, полученные примеры могут перестать быть сопоставимыми. Новая граница проекта может сохранить смысл.
Пакеты добавляют ещё один операционный слой.API пакетовпозволяет командам создавать пакеты внутри проектов, настраивать колбэки, получать статус и считать задачи по состояниям. Там также отмечено, что приоритизация влияет на ещё не начатые задачи и не гарантирует порядок выполнения. Эта оговорка полезна, потому что производственные покупатели часто предполагают, что очередь вендора работает как внутренний планировщик заданий. Это может быть не так. Если срочный набор примеров нужен для диагностики сбоя живой модели, покупатель должен знать, что приоритет может и не может обещать.
Колбэки делают единицу операционной.Документация по колбэкамописывает JSON-результаты, отправляемые на конечные точки покупателя, поведение при повторах, если не получен успешный ответ, и события завершения задачи, изменения статуса аудита и отзыва задач. Колбэк — не гламурная функция, но это разница между проектом в веб-консоли и системой, которая может встроиться в процесс релиза покупателя. Если выполненная задача приходит с правильным статусом, ответом и состоянием рецензирования, команда модели может запустить последующую валидацию, экспорт, обучение или рецензирование. Если колбэки молча падают или не аутентифицированы и не мониторятся должным образом, принятые единицы могут теряться между командами.
Коммерческий аргумент Scale поэтому зависит от того, будет ли цикл дешевле и надёжнее альтернатив покупателя. Альтернативы не вымышленные. Крупная ИИ-лаборатория может построить собственную операцию по данным. Предприятие может нанять профильных рецензентов и вести более лёгкий внутренний процесс. Облачный или модельный провайдер может предложить инструменты оценки рядом с API модели. Открытые фреймворки оценки могут закрыть часть задачи. Команда может сократить объём работы, сузив продукт, выбрав меньшую модель, отказавшись от высокорисковой автоматизации или сократив число действий, требующих одобрения человека.
Scale выигрывает только тогда, когда её цикл даёт лучшие принятые единицы на доллар и на неделю, чем эти альтернативы.
Покупателю стоит устоять перед соблазном измерять цикл только объёмом. Больше выполненных задач — это не то же самое, что больше полезных свидетельств. Если используется неправильная таксономия, результат — точные отходы. Если рецензенты не согласны, но разногласие скрыто, результат — ложная уверенность. Если краевые случаи недопредставлены в выборке, модель может улучшиться в среднем, но провалиться именно на тех ситуациях, которые оправдывают проект. Если оценочный набор становится знаком команде разработки модели, оценка может расти, а реальное поведение — нет. Объём полезен только тогда, когда приёмка осмысленна.
Согласие людей — дефицитный ресурс
Самое трудное в продукте Scale — не перемещение данных через API. Это согласование людей и моделей вокруг спорных суждений. Многие задачи обучения и оценки легки только на примерах. Рецензент может опознать знак остановки на чётком изображении, но сбои моделей обычно накапливаются на периферии: перекрытие объектов, шум сенсоров, сарказм, локальный контекст, неоднозначные намерения, низкоресурсный язык, конфликты политик, частичные документы, смешанные сигналы безопасности или примеры, где правильный ответ зависит от внутреннего правила заказчика.
Чем экономически ценнее поведение модели, тем вероятнее, что свидетельство требует суждения, а не транскрипции.
Публичная документация Scale показывает, что компания понимает рецензирование как многошаговый процесс. Вдокументации платформы GenAI Platform по разметке оценоклюди-разметчики могут работать над назначенными задачами, метки сохраняются, неопределённые элементы можно пропускать, а задачи можно помечать для рецензирования с комментариями. Вдокументации по аудитупроцессы оценки могут иметь два уровня аудита, при этом разметчик, первый аудитор и второй аудитор должны быть разными людьми. Аудиторы могут одобрить, запросить пересмотр или исправить задачу.
Эти проектные решения важны. Разделение ролей рецензентов снижает риск того, что непонимание одного человека станет окончательным ответом. Пометка неопределённых задач даёт рецензентам путь сохранять неоднозначность, а не втискивать каждый пример в ложную бинарность. Запросы на пересмотр создают запись о том, что первый проход не был принят. Метрики исполнителей и аудиторов помогают выявить, не является ли какой-то рецензент необычно снисходительным, необычно строгим или непоследовательным. Сами по себе этого недостаточно, но это правильные примитивы.
Покупателю всё равно приходится спрашивать, хорошо ли используются примитивы. Двухуровневый аудит может стать простой формальностью, если рецензенты торопятся, плохо обучены или оптимизируют пропускную способность. Метрики исполнителей могут поощрять поверхностное согласие, если цель слишком узкая. Опция пропуска может защищать качество, а может стать способом избегать трудных случаев. Второй аудитор может улучшить суждение, а может добавить издержек, не меняя результат, если рубрика плохая. Продуктовая поверхность может поддерживать качество; она не может определять истину заказчика.
Именно поэтому критерии приёмки нужно писать до роста объёмов. Покупатели должны определить, что считается согласием, какие виды разногласий допустимы, какие примеры требуют эскалации, какие свидетельства должен предоставлять рецензент, как часто вставляются эталонные или проверенные экспертами примеры, когда пересматривается таксономия и как мигрируют старые метки при изменении политики. Измерять стоит не только итоговую долю приёмки, но и отклонение на первом проходе, частоту пересмотров, расхождения между рецензентами, категории пропущенных задач, время разрешения спорных примеров и влияние на модель после использования принятых единиц.
Документация Scale по аудиту без исправлений (Fixless Audits)полезна здесь, потому что она рассматривает обратную связь как структурированные данные, а не просто комментарий. В ней описаны область обратной связи, серьёзность, состояние, принятые или отклонённые результаты и правила расчёта показателя качества.Документация Pro Qualityпоказывает пути «одобрить», «изменить» и «отклонить» и сообщает итоги рецензирования, результаты по задачам и информацию о рецензентах. Это не говорит покупателю, что итоговые метки хорошие. Это говорит покупателю, где требовать свидетельств.
Опасность — ложный консенсус. Если задача лёгкая, рецензенты соглашаются. Если рубрика расплывчатая, рецензенты тоже могут согласиться, потому что выводят из примеров один и тот же короткий путь, а не применяют предписанное правило. Если покупатель обучает модель на таком результате, модель может выучить короткий путь. Позже, когда задача переходит в новый регион, сегмент клиентов, тип документов или политический контекст, короткий путь ломается. Поэтому хороший процесс работы с данными нуждается в разногласиях. Ему нужна система, которая показывает, где суждение неопределённо и где рубрика не переносится.
Ценность Scale растёт, когда она делает разногласия видимыми, разрешает их последовательно и сохраняет причину. Её ценность падает, когда она превращает разногласия в проблему пропускной способности.
Оценку нельзя сводить к лидерборду
Оценка моделей — место, где проблема доверия покупателя к Scale проявляется ярче всего. Обучающий набор можно проверять задачу за задачей, но система оценки становится авторитетом внутри организации. Она говорит командам, какая модель лучше, приемлем ли релиз, работает ли защитный механизм, исправлена ли проблема из редтима и можно ли переводить продукт из пилота в производство. Если этот авторитет слаб, организация может с уверенностью развернуть не то поведение.
Страница продукта Evaluation for Model Developersкомпании Scale называет две проблемы, которые покупателям стоит воспринимать серьёзно: заслуживающие доверия оценочные наборы и стабильность. Она также подчёркивает значимость проприетарных оценочных наборов и целевых оценок. Это правильное направление, потому что публичные бенчмарки часто слишком общие или слишком засвеченные, чтобы ответить на вопрос покупателя. Банку, оценивающему ответы клиентской поддержки, оборонному заказчику, оценивающему поддержку планирования, медиакомпании, оценивающей суммаризацию, и софтверной компании, оценивающей поведение код-ассистента, не нужен один и тот же набор приёмки. Им нужны задачи, отражающие именно те сбои, которых они опасаются.
Академические работы по оценке указывают в том же направлении. ПроектHELMСтэнфорда выступает за оценку языковых моделей по нескольким измерениям, таким как точность, калибровка, устойчивость, справедливость, предвзятость, токсичность и эффективность. Это важно для Scale, потому что один показатель может скрыть компромисс, который решает, стоит ли использовать модель. Модель может быть точнее в среднем и менее безопасна на узком классе высокорисковых запросов. Может быть эффективной и плохо откалиброванной. Может хорошо работать на английском и плохо на локальном языке. Может избегать оскорбительного контента и при этом давать безответственные советы. Серьёзная система оценки должна сохранять эти измерения, а не схлопывать их в удобное для закупок число.
Есть и проблема контаминации. Исследования контаминации бенчмарков, включая статью в ACL Anthology оконтаминации данных в современных бенчмарках больших языковых моделей, показывают, почему пересечение обучающего материала с оценочным может завышать результаты. Риск не ограничивается публичными бенчмарками. Частный покупатель может контаминировать собственный оценочный набор, используя одни и те же примеры для настройки, итераций инструкций, обучения рецензентов и утверждения релизов. Чем больше команда оптимизирует под фиксированный оценочный набор, тем больше набор перестаёт измерять общую способность и начинает измерять знакомство с примерами.
Документация GenAI Platform компании Scale показывает несколько инструментов, которые могут помочь, если покупатель использует их дисциплинированно.Обзор оценки следующего поколенияописывает оценки как строки данных и задачи, с переиспользуемыми наборами данных и асинхронными результатами.Документация по автоматической оценкеописывает модельное управляемое декодирование, которое может возвращать обоснования и баллы.Документация по дашбордам оценкиописывает мониторинг метрик через таблицы, графики, гистограммы, точечные диаграммы, временные ряды и агрегирующие запросы.Обзор трейсингаописывает спаны и трейсы, которые фиксируют входы, выходы, идентификаторы, тайминги, метаданные, статус и тип.
Вместе эти части могут поддерживать серьёзный процесс оценки. Они позволяют покупателю собирать строки, запускать задачи с участием людей и автоматикой, изучать трейсы, отслеживать тренды и сравнивать релизы. Но они создают и новые обязанности. Автоматические оценщики нуждаются в собственной валидации. Дашбордам нужны правила выборки. Трейсы могут содержать чувствительные данные. Переиспользуемые наборы данных требуют версионирования и контроля контаминации. Улучшение временного ряда может отражать реальный выигрыш продукта, изменённую выборку, другого оценщика, вычищенный шаблон инструкций или сдвиг в пользовательской аудитории.
Дашборд — это не истина; это инструмент, который нужно калибровать.
Поэтому полезный вопрос покупателя — не «Может ли Scale проводить оценки?». Может. Полезный вопрос — «Может ли Scale помочь нам доказать, что оценка по-прежнему означает то, что мы думаем?». Такое доказательство требует отложенных примеров, калибровки рецензентов, свежих состязательных кейсов, явных версий политик, фиксации обоснований, проверок контаминации, доверительных интервалов там, где это практично, и правила релиза, которое мешает командам оптимизировать только под отображаемый балл.
Оценка ценна, когда она создаёт трение в нужный момент. Она должна замедлять релиз при появлении сбоев, связанных с галлюцинациями, приватностью, безопасностью, предвзятостью, правовыми вопросами, предметной областью или контекстом клиента. Она должна выявлять класс сбоев, которому нужно больше данных. Она должна различать улучшение модели, обходной путь в конфигурации и артефакт измерения. Если оценочная поверхность Scale делает это, это продукт доверия покупателя. Если она лишь выдаёт балл, это более красивый бенчмарк.
Происхождение данных и хранение — это контроль качества
Происхождение данных часто считают темой комплаенса, но в системе обучения и оценки это прежде всего тема качества. Команда модели должна знать, откуда взялся пример, какая версия инструкции применялась, кто или что его проверило, какие данные были прикреплены, какой результат был экспортирован и можно ли использовать запись для следующей модели. Если этих фактов нет, команда всё ещё может обучить модель, но не может объяснить, почему свидетельству стоит доверять.
Документация Scale показывает несколько поверхностей происхождения. Метаданные задач и теги могут нести контекст покупателя. Пакеты могут сегментировать работу по проекту, времени или операционной группе. Полезные нагрузки колбэков могут передавать завершение и изменения рецензирования в систему покупателя. Трейсы в GenAI Platform могут сохранять входы, выходы и статус для единиц работы. Согласновведению в рабочие процессы Scaleируководству по оценке в рабочих процессах, workflow могут импортировать данные из трейсов, CSV-файлов, баз данных и облачных хранилищ, вызывать модели или сервисы приложений, соединять с эталонными данными, запускать задачи-оценщики, экспортировать как оценки и планировать повторные запуски.
Это основы полезной записи. Они позволяют покупателю восстановить, как пример перемещался от исходного источника к принятому результату. Они также позволяют отделить свидетельства, созданные человеком, свидетельства, созданные автоматическим оценщиком, свидетельства, импортированные из системы покупателя, и свидетельства, полученные из прогона модели. Это различие важно, потому что не все свидетельства должны иметь одинаковый авторитет. Отклонение медицинского ответа экспертом-человеком не эквивалентно дешёвой оценке модельного судьи. Трейс вызова инструмента под задачу клиента не эквивалентен обычной строке бенчмарка.
Кейс редтима, написанный после инцидента, может заслуживать большего веса, чем рутинный пример валидации.
Хранилище и контроль доступа определяют, можно ли доверять такой записи. Публичная документация Scale показывает практические варианты интеграции.Документация по AWS S3рекомендует делегированный доступ IAM с внешним идентификатором и предупреждает о риске «запутанного заместителя» в некоторых кросс-аккаунтных схемах.Документация по Google Cloud Storageаналогично предупреждает о рисках угадывания URL в схемах кросс-проектного доступа.Документация по Azure Blob Storageотмечает, что отключение соединения в Scale не отзывает разрешения Azure. Это не абстрактные юридические сноски. Это операционные факты, которые определяют, знает ли покупатель, кто всё ещё может читать базовые данные.
Документация по защищённым URL результатовособенно важна. В ней сказано, что некоторые результаты сегментации, видео и лидаров по умолчанию загружаются в публичные S3-URL с UUID, а аутентифицированные URL результатов можно включить, обратившись в поддержку. Это не значит, что покупателю нужно паниковать, и не доказывает плохое развёртывание. Это значит, что доставка результатов — вопрос конфигурации, который должен быть частью плана приёмки. Если данные чувствительные, покупатель должен знать, требуют ли результаты аутентификации, как долго работают ссылки, где хранятся объекты, как логируется доступ и не копируют ли нижестоящие команды результаты в менее контролируемые места.
Локализация данных и суверенитет добавляют ещё один слой. Публичные поверхности Scale включают заявления о госсекторе и защищённом развёртывании, включая позиционирование Donovan для закрытых, изолированных от внешних сетей сред и контекста FedRAMP High. В маркетплейсе FedRAMP платформаScale AI Data Platformуказана как сертифицированная по FedRAMP, класс D High, с датой сертификации 9 сентября 2024 года. Это важно для покупателей из госсектора, поскольку показывает путь авторизации для определённого продукта. Это не решает автоматически все требования по локализации, режиму секретности, миссии, экспортному контролю или данным заказчика.
Правильный вывод — происхождение и хранение являются частью продукта, а не контролем задним числом. Если покупатель не может проследить принятую единицу данных до её источника, версии политики, пути рецензирования и места хранения результата, эта единица хрупкая. Она может всё ещё быть полезной для быстрого эксперимента, но её недостаточно, чтобы управлять релизом модели или поддерживать серьёзный аудит.
Надёжность видна в лимитах, колбэках и инцидентах
Надёжность Scale стоит измерять на двух уровнях. Первый — надёжность продуктовой поверхности: API, состояния задач, колбэки, дашборды, доступ к хранилищам, идентичность и доступность продукта. Второй — надёжность произведённых свидетельств: метки, результаты оценки, решения рецензентов и трейсы. Важны оба, и они могут отказывать независимо. Стабильный API может поставлять слабые метки. Сильный процесс рецензирования может быть заблокирован сбоем сервиса или сломанным колбэком.
Публичная документация API даёт покупателям достаточно деталей, чтобы начать чек-лист надёжности.Документация по аутентификацииразделяет боевой и тестовый режимы и отмечает, что боевые задачи выполняются людьми и тарифицируются, тогда как тестовый режим может возвращать некорректные тестовые ответы. Это напоминание о том, что интеграционные тесты — не тесты качества. Покупатель может проверить подключение API в тестовой среде, но не может судить о качестве работы людей по тестовым ответам. Боевая валидация требует контролируемой выборки и бюджета.
Технические лимиты тоже важны.Документация по техническим лимитамперечисляет такие ограничения, как скорость запросов на создание задач, размер метаданных, количество атрибутов, метаданные загрузки файлов, размер вложений и рекомендации по поддержке браузеров. Это не дисквалифицирующие ограничения. У каждой платформы есть лимиты. Суть в том, что их нужно учесть до того, как покупатель запустит высоконагруженный процесс. Операция с данными, которая зависит от богатых метаданных, больших вложений или быстрой подачи задач, должна проектироваться с учётом этих ограничений, а не обнаруживать их в производстве.
Обработка ошибок — ещё одна проблема принятой единицы.Документация по ошибкамохватывает сбои вложений, ошибки аутентификации, ошибки оплаты, отсутствующие ресурсы, конфликты идемпотентности, лимиты скорости и серверные ошибки.Документация по колбэкамговорит, что повторы колбэков могут продолжаться до 20 попыток в течение 24 часов, если не получен успешный ответ. Покупателям стоит превратить эти факты в средства контроля: обработка недоставленных сообщений, процедуры повторного воспроизведения, обнаружение дубликатов, аутентификация колбэков, алертинг, отложенная обработка экспорта и сверка состояния задач Scale с системой покупателя.
Публичная страница статуса Scale добавляет полезный, но неполный операционный сигнал. 11 июля 2026 годаконечная точка сводки статусасообщала, что все системы работают штатно по компонентам, включая API, Platform, Web Application, Document AI, Nucleus, Spellbook, Catalog Forge, Catalog Explorer и Donovan. Публичнаяконечная точка инцидентоввернула историю устранённых инцидентов, включая ухудшение производительности в январе 2025 года, ухудшение производительности Nucleus в марте 2024 года, отключение веб-приложения Donovan в ноябре 2023 года и более ранние проблемы платформы или приложений.
Эту историю не стоит ни преувеличивать, ни игнорировать. Страница статуса управляется вендором и часто скупа. Она не даёт полного набора данных об уровне сервиса, анализа корневых причин или влияния на конкретного клиента. Но она доказывает, что на продуктовой поверхности были публичные инциденты, и покупателям стоит проектировать процессы с учётом задержек, деградации и отказов отдельных компонентов.
Для операции с данными или оценкой простой может иметь эффект второго порядка: релизы моделей ждут, очереди рецензирования растут, при разборе инцидента не хватает свежих примеров, и команда может развернуть модель без предусмотренного прохода оценки.
Покупателям стоит определять надёжность на уровне принятой единицы. Сколько поданных задач доходит до конечного состояния? Сколько принятых единиц доставляется в систему покупателя без ручной сверки? Как часто колбэки падают или требуют повторного воспроизведения? Как часто ошибки вложений вызваны правами доступа к хранилищу покупателя? Как быстро можно исправить отклонённую задачу? Какой объём рецензирования задерживается из-за проблем платформы? Сколько прогонов оценки аннулировано из-за пропавших трейсов или изменённой конфигурации оценщика?
Это лучшие вопросы, чем вопрос о том, написано ли на маркетинговой странице, что платформа готова для предприятий.
Возможность Scale в том, что её примитивы достаточно явны для такого измерения. Её риск в том, что покупатели могут принять наличие примитивов за гарантию результата.
Истории клиентов и госзаказы — сигналы спроса, а не доказательство приёмки
У Scale есть заметные сигналы спроса. На главной странице говорится, что компания работает с ведущими ИИ-лабораториями, предприятиями и правительствами. На страницах продуктов описана работа с данными, оценкой и ИИ-приложениями.История клиента TIMEописывает функции TIME AI, такие как суммаризация, голос, перевод и чат, с тонкой настройкой, редтимингом, защитными механизмами, мониторингом и тысячами векторов атак. Инновационное подразделение Министерства обороны (DIU) объявило о проектеThunderforge— прототипе с участием Scale AI для поддержки принятия решений на основе ИИ в оперативном и театральном планировании. Scale также объявила, что Управление главного цифрового и ИИ-офицера Минобороны расширило корпоративное соглашение допотолка в 500 миллионов долларов, охватывающего такие области, как компьютерное зрение, поддержка принятия решений и операции с данными.
Это значимые рыночные сигналы. Они показывают, что покупатели с серьёзными потребностями готовы оценивать или использовать Scale. Они также показывают, почему необходим взгляд через принятую единицу. История клиента — не независимое исследование окупаемости. Правительственный прототип — не доказательство конечного успеха миссии. Потолок контракта — не то же самое, что потреблённая ценность. Логотип клиента не может сказать другому покупателю, была ли таксономия удачной, согласились ли рецензенты, остались ли данные в заданных границах, изменили ли выводы редтима модель и предсказал ли оценочный набор производственное поведение.
Та же осторожность относится к оборонным и государственным свидетельствам. Внедрение в госсекторе повышает ставки, потому что принятая единица может влиять на поддержку принятия решений, разведывательные процессы, оперативное планирование или mission-программное обеспечение. СтраницаDonovanкомпании Scale подчёркивает тестирование, оценку, мониторинг, защитные механизмы, прослеживаемость, независимость от моделей и варианты защищённого развёртывания. Это правильные категории для покупателей из госсектора. Но чем значимее применение, тем консервативнее должен быть стандарт свидетельств. Предложение, поддержанное моделью, в контексте миссии не должно приниматься потому, что дашборд аккуратный. Оно должно приниматься потому, что исходная запись, контекст поиска, выход модели, путь рецензирования, обработка сбоев и полномочия человека — всё ясно.
Коммерческие покупатели сталкиваются с той же закономерностью при меньших ставках. Медиакомпания может использовать генеративный ИИ для суммаризации статей или ответов на вопросы читателей. Программная компания может использовать оценки для сравнения код-ассистентов. Финансовая организация может проверять извлечение документов. Ритейлер может обучать модель рекомендаций или борьбы с мошенничеством. В каждом случае покупатель должен спросить: что является принятой единицей? Кто её проверял? Что видел рецензент? Как находятся ошибки? Что происходит при изменении политики? Какие примеры отложены?
Откуда мы знаем, что модель улучшилась, потому что улучшились данные?
Свидетельства клиентов Scale сильнее всего, когда их используют как карту возможных сценариев. Они слабее всего, когда их используют как доказательство того, что любой конкретный покупатель увидит тот же результат. Задача покупателя, данные, допустимый риск, пул рецензентов, среда безопасности и процесс релиза определяют, переносится ли результат.
Это особенно важно, потому что многие решения о закупках ИИ принимаются под давлением. Руководители хотят видимого внедрения. Продуктовые команды хотят двигаться быстро. Команды моделей хотят лучших данных. Команды безопасности хотят контроля. Финансовые команды хотят знать, создают ли расходы измеримое улучшение модели. Знаменатель принятой единицы даёт всем им общий язык. Он переводит разговор с вопроса «Кто ещё пользуется Scale?» на вопрос «Что именно мы принимаем, и какие свидетельства делают это приемлемым?»
Инвестиция Meta сделала нейтральность вопросом продукта
Корпоративная структура обычно остаётся за рамками технической оценки, но в случае Scale она пересекается с доверием покупателя. В июне 2025 года Scale объявила об инвестиции Meta с оценкой компании более чем в 29 миллиардов долларов; Alexandr Wang перешёл в Meta, оставаясь в совете директоров Scale, Jason Droege стал временным генеральным директором, а Meta получила миноритарную долю. Scale заявила, что остаётся независимой и продолжит защищать данные клиентов. Вскоре TechCrunch, ссылаясь на Reuters и ответы компаний, сообщила об опасениях, что некоторые крупные клиенты пересматривают отношения после инвестиции Meta.
Технический вопрос не в том, произошла ли каждая описанная реакция клиента именно так. Вопрос для покупателя проще: Scale обрабатывает чувствительные свидетельства разработки моделей. ИИ-лаборатория, предприятие или государственный заказчик могут передавать данные, раскрывающие слабости моделей, направление продукта, сбои безопасности, рубрики оценки, частные шаблоны инструкций, отраслевые краевые случаи, данные клиентов или приоритеты будущих релизов. Даже если контрактные гарантии сильны, восприятие нейтральности важно, потому что переданные данные могут быть стратегически чувствительными.
Ответ Scale должен быть операционным, а не риторическим. Покупателям стоит искать контрактные границы использования данных, контроль доступа, сегрегацию, права аудита, правила хранения, место хранения, политику доступа рецензентов, работу с субподрядчиками, процедуры экспорта, уведомления об инцидентах, процесс удаления и чёткие обязательства в отношении конкурентной информации. Им также стоит изучить, как Scale обращается с оценочными наборами конкретного заказчика.
Если приватный оценочный набор покупателя — жемчужина, его не следует небрежно переиспользовать, показывать конкурентам или использовать для улучшения универсального сервиса без явного разрешения.
Это не значит, что инвестиция Meta делает Scale непригодной. Многие корпоративные вендоры обслуживают конкурентов, сохраняя границы данных. Облачные провайдеры размещают соперников. Поставщики ПО анализируют чувствительные данные клиентов в рамках контрактных ограничений. Оборонные подрядчики поддерживают несколько программ. Вопрос в том, сможет ли Scale сделать границу достаточно убедительной для покупателей, чьи данные и оценки раскрывают стратегию моделей.
Взгляд через принятую единицу снова помогает. По каждой единице покупатель должен знать, какие данные попали в Scale, кто или что их обработало, какая модель или рецензент их видел, где был сохранён результат, какие метаданные к нему прилагались и можно ли его удалить, экспортировать или изолировать. Если такая запись сильна, опасения по поводу корпоративной нейтральности можно урегулировать контрактами и контролем. Если запись слаба, доверие зависит от заверений.
В ИИ заверений недостаточно. Артефакты слишком ценны.
Экономика — предельная, а не волшебная
Коммерческий вопрос Scale — превосходят ли лучшие данные и результаты оценки издержки на труд разметчиков, экспертные рецензии, настройку безопасности, интеграцию, переделки, зависимость от вендора и предельное улучшение модели. Эта фраза намеренно лишена романтики, потому что качество данных само по себе не создаёт ценность. Оно создаёт ценность, только когда достаточно меняет модель, продукт или решение, чтобы оправдать издержки.
Самая распространённая ошибка — сравнивать цену единицы Scale с внутренней почасовой ставкой или с упрощённой функцией оценки провайдера моделей. Это упускает весь стек издержек. Покупатель платит за проектирование проекта, написание таксономии, выборку примеров, интеграцию хранилища, проверку безопасности, юридическую проверку, время команды модели, калибровку рецензентов, проектирование аудита, переделки, экспорт, мониторинг, интерпретацию дашбордов и последующий эксперимент, который доказывает, улучшили ли принятые единицы модель. Если улучшение модели невелико, дорогие свидетельства всё равно могут быть плохой инвестицией.
Вторая ошибка — считать человеческое рецензирование фиксированной статьёй расходов. Человеческое рецензирование дорожает по мере того, как задача становится более неоднозначной, чувствительной, отраслевой или многоязычной. Обычный рецензент может классифицировать очевидный контент. Для медицинских, юридических, оборонных, сетевых, кодовых, финансовых задач или задач безопасности может понадобиться отраслевой эксперт. Позиционирование GenAI Data Engine вокруг экспертов в предметной области коммерчески привлекательно именно по этой причине, но экспертное рецензирование меняет экономику.
Покупатель должен измерять стоимость принятой единицы с экспертной проверкой, а не только стоимость поданной задачи.
Третья ошибка — игнорировать переделки. Переделки — это не только отклонённые задачи. Сюда входят неясные инструкции, изменения таксономий, переобучение рецензентов, исправление прав доступа к хранилищам, сверка колбэков, обновление оценочных наборов, расследование контаминации, дублирующиеся метки, устаревшие примеры и эксперименты с моделями, которым новые данные не принесли пользы. Примитивы рецензирования и аудита Scale могут вскрывать переделки, если покупатели инструментируют их. Если нет, переделки становятся невидимым съеданием маржи.
Правильный экономический показатель — предельное улучшение модели или продукта на принятую единицу. Для обучающих данных покупатель должен сравнивать поведение модели до и после добавления принятых примеров, желательно по классам сбоев. Упали ли галлюцинации в целевой категории? Улучшилась ли точность извлечения на сложных документах? Лучше ли модель компьютерного зрения справилась с краевым условием? Стала ли модель политики реже давать небезопасные одобрения? Улучшилась ли модель на отложенных примерах, которые не использовались для настройки процесса?
Если нет, принятые единицы могут быть хорошо сформированными, но стратегически малоценными.
Для оценки показатель другой. Хорошая система оценки может не улучшать модель напрямую. Она может предотвратить плохой релиз, раньше найти сбой, сократить время отладки, выявить регрессии модели, поддержать управление или сделать рискованный сценарий использования неприемлемым до того, как он причинит вред. Эта ценность реальна, но её труднее посчитать. Покупателям стоит отслеживать предотвращённые инциденты релизов, время выявления класса сбоев, число находок, блокирующих релиз, сокращение ручной проверки на релиз, уверенность в сравнениях моделей и то, предсказывает ли оценка наблюдаемые проблемы в производстве.
Ценностное предложение Scale сильнее всего там, где у покупателя есть повторяющиеся потребности в свидетельствах с высокими ставками и нет желания строить полную операцию по данным самостоятельно. Разработчики моделей уровня frontier, корпоративные ИИ-команды и государственные пользователи подходят под этот профиль, потому что им нужен постоянный поток доверенных примеров, рубрик оценки, кейсов редтима и артефактов рецензирования. Ценностное предложение слабее там, где задача простая, разовая, низкорисковая, легко решается внутренними рецензентами или не связана с измеримым модельным решением.
Сокращение объёма задачи — легитимная альтернатива. Если модельное приложение нельзя достаточно хорошо оценить, ответом может быть сужение продукта, сохранение одобрения человеком, отказ от автоматизации в чувствительном сегменте или перенос развёртывания. Scale конкурирует не только с другими вендорами, но и со сдержанностью.
Что покупателям измерять до масштабирования
Покупателю, оценивающему Scale, стоит начать с небольшого репрезентативного плана приёмки. План не должен спрашивать: «Может ли Scale обработать наши данные?» Он должен спрашивать: «Может ли Scale произвести принятые единицы, которые меняют решение о модели или релизе так, как мы можем проверить?» Этому плану нужны знаменатель, выборка, базовый уровень и таксономия сбоев.
Для работы с данными покупатель должен определить тип единицы: метка изображения, извлечение документов, классификация безопасности, рецензирование ответов кода, суждение о цепочке рассуждений, пара предпочтений, кейс редтима, ответ с опорой на поиск, оценка вызова инструмента или экспертная правка. Стоит определить исходные данные, версию инструкций, таксономию, квалификацию рецензентов, путь эскалации и формат экспорта. В план нужно включить известные трудные случаи и примеры, где правильный ответ намеренно неоднозначен. Если каждый пробный пример лёгкий, тест — в основном интеграционный театр.
Первый показатель — приёмка с первого прохода. Сколько поданных единиц принимается без исправлений? Второй — разногласия. Как часто рецензенты расходятся и по каким категориям? Третий — переделки. Сколько единиц требует изменённых инструкций, пересмотренных меток или дополнительной экспертной проверки? Четвёртый — полнота происхождения. Может ли покупатель восстановить источник, версию инструкций, путь рецензирования, результат и место экспорта для каждой принятой единицы? Пятый — влияние на модель. Улучшает ли добавление или использование принятой единицы целевое поведение на отложенном наборе?
Для работы по оценке покупатель должен измерять стабильность и прогностичность. Если одну и ту же модель оценить дважды в одинаковых условиях, насколько изменится балл? Если меняются рецензенты, сохраняется ли результат? Если используется автоматический оценщик, как часто он согласуется с экспертной человеческой проверкой на трудных случаях? Выявляет ли оценка известные исторические сбои? Находит ли она новые сбои, которые позже подтверждают производственные логи? Остаётся ли она полезной после того, как команда модели увидела часть примеров, или превращается в цель для обучения?
Для безопасности и управления данными покупатель должен проверить путь хранения и результатов до передачи любых чувствительных данных. Какие права доступа к облачному хранилищу предоставляются? Кто может их отозвать? Аутентифицированы ли URL результатов? Где хранятся трейсы? Что сохраняется после экспорта? Аутентифицируются ли и логируются ли конечные точки колбэков? Разделены ли ключи API по средам? Ограничены ли роли рецензентов и аудиторов нужными данными?
Требуют ли государственные или регулируемые развёртывания поверхностей с авторизацией FedRAMP, сред без доступа к внешним сетям, ограничений по регионам или ключей, управляемых заказчиком?
Для надёжности покупатель должен инструментировать путь от подачи до последующего использования. Поданная задача — не принятая задача. Принятая задача — не задача, потреблённая процессом обучения или оценки. Потреблённое обучение или оценка — не улучшение продукта. Каждая передача должна иметь сверку. Сбои колбэков, задержанные пакеты, ошибки вложений, изменения статуса аудита и отклонённые задачи должны быть видимы. Инциденты со страницы статуса должны иметь плейбуки на стороне покупателя: что ставится на паузу, что повторяется, что переключается на резерв и какие релизные решения ждут.
Для зависимости от вендора покупатель должен спроектировать тест выхода. Можно ли экспортировать принятые единицы в полезном формате? Можно ли воссоздать таксономию в другом месте? Переносятся ли комментарии рецензентов и статусы аудита? Переносимы ли приватные оценочные наборы? Заменимы ли определения рабочих процессов и дашборды? Может ли покупатель вести урезанный внутренний процесс, если Scale недоступна или стратегически неподходяща? Издержки перехода — не причина избегать вендора, но их стоит знать до того, как зависимость вырастет.
Эти измерения не против Scale. Это условия, при которых Scale может доказать свою ценность. Покупатель, проделавший эту работу, может обнаружить, что Scale значительно лучше внутренних операций или разрозненных инструментов. Он также может обнаружить, что достаточно узкого внутреннего процесса рецензирования. Любой результат лучше, чем покупка объёма без приёмки.
Вывод
Scale AI — одна из самых важных компаний в слое свидетельств ИИ, потому что индустрия усвоила: модели ограничены качеством данных, качеством оценки и дисциплиной рецензирования. Публичные продуктовые поверхности компании показывают серьёзную механику: API задач и пакетов, таксономии, колбэки, аудиты, разделение ролей рецензентов, строки оценки, дашборды, трейсы, оркестрацию рабочих процессов, интеграции с облачными хранилищами, заявления о защищённом развёртывании и сигналы авторизации для госсектора. Это правильные строительные блоки для компании, пытающейся превращать неопределённые данные в принятые единицы обучения и оценки.
Строительные блоки не решают вопрос. Трудная работа — не существование задач. Это то, означает ли задача одно и то же после тысяч примеров, нескольких рецензентов, изменений политик, передач хранилищ, итераций модели и релизных решений. Это то, остаётся ли оценочный набор свежим и неконтаминированным. Это то, помогают ли автоматические оценщики, а не отмывают ли предвзятость модели в балл. Это то, остаются ли приватные данные и приватная логика оценки в заданных покупателем границах. Это то, стоит ли предельное улучшение поведения модели издержек на операцию со свидетельствами.
Рыночные сигналы Scale сильны. ИИ-лаборатории, предприятия и государственные покупатели имеют причины хотеть внешнюю систему для работы с данными и оценкой. Авторизация FedRAMP и оборонные продуктовые заявления делают Scale значимой в средах, где доверие покупателя не является опцией. Инвестиция Meta и сообщения о реакции клиентов делают нейтральность и границы данных важнее, а не менее важными. Истории клиентов и анонсы контрактов должны усиливать проверку, а не заменять её.
Лучший аргумент за Scale — не в том, что каждый клиент должен отдавать работу с данными самому крупному видимому вендору. Лучший аргумент в том, что современным ИИ-командам нужен воспроизводимый способ производить заслуживающие доверия свидетельства, и Scale собрал многие продуктовые примитивы, необходимые для этого. Лучшая критика в том, что качество свидетельств локально. Оно зависит от инструкций покупателя, рецензентов, данных, краевых случаев, выбора безопасности и дисциплины релизов. Ни один вендор не может сделать слабый процесс приёмки сильным, просто обработав его в масштабе.
Поэтому решение покупателя должно быть конкретным. Выберите поведение модели, которое важно. Определите принятую единицу. Запустите репрезентативную выборку. Измерьте согласие рецензентов, происхождение, переделки, риск контаминации, конфигурацию безопасности и влияние на модель. Сравните Scale с внутренним рецензированием, инструментами провайдеров моделей, открытыми стеками оценки и более узким продуктовым охватом. Затем масштабируйте процесс только в том случае, если принятая единица выдерживает проверку.
Настоящий продукт Scale AI — доверие к единице данных, которую команда модели готова использовать. Это доверие дорогое, хрупкое и измеримое. И именно здесь решится следующий этап конкуренции в ИИ.