Кратко
- После сбоя RRDP валидатор может оставить прежний кэш, загрузить гораздо более крупный снимок или перейти на rsync; единого для всех таймера восстановления нет.
- Срок хранения дельт, свежесть manifest и пороги валидатора распределяют стоимость, время восстановления и риск повтора старых данных между разными участниками.
- Оператору нужен протокол восстановления по каждому репозиторию и сравнение независимых валидированных наборов, а не только зелёный индикатор HTTP.
В девять утра валидатор запрашивает следующую небольшую дельту из репозитория RPKI. Ссылка есть в уведомлении, но файл недоступен. Один валидатор продолжает использовать кэш последней успешной загрузки. Второй запрашивает полный snapshot. Третий ждёт случайный интервал и пробует rsync. Каждое решение может быть технически оправдано, но они не гарантируют одну и ту же версию настоящего в одну и ту же минуту.
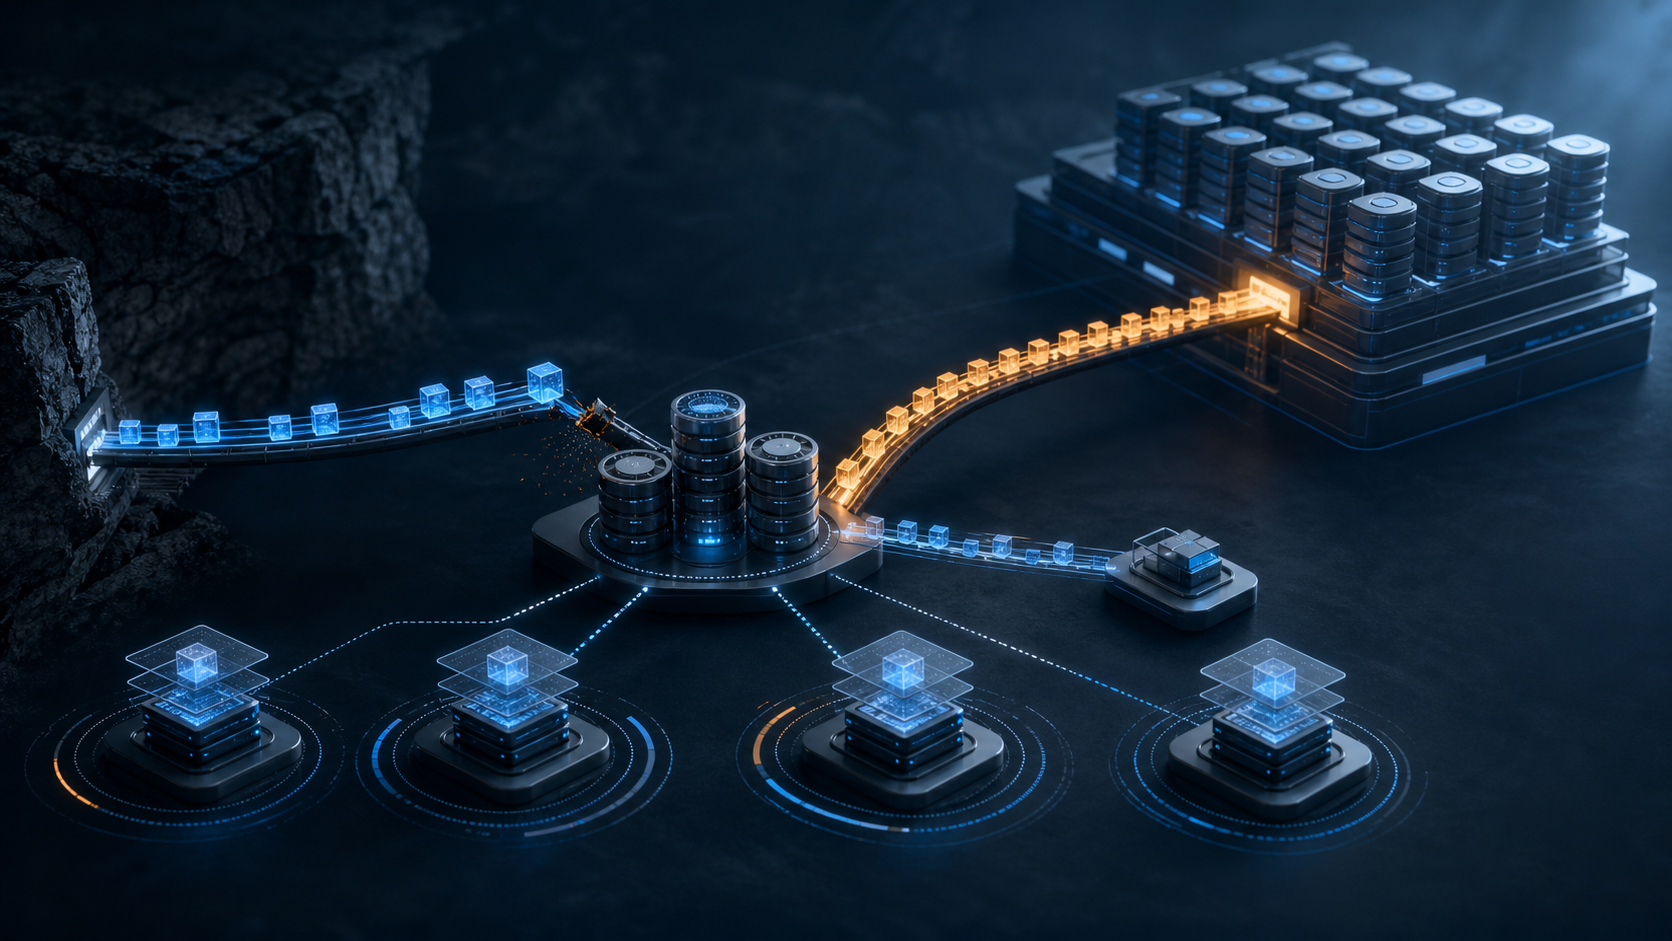
Поэтому восстановление репозитория превращается в точку управления маршрутизацией. RPKI обычно объясняют от подписанного объекта: владелец ресурсов разрешает источник, доверяющая сторона проверяет его, маршрутизатор применяет политику проверки происхождения. В эксплуатации цепочка начинается раньше. Подписанное намерение должно покинуть центр сертификации, пройти публикацию и транспорт репозитория, проверки manifest, сертификатов и отзыва и лишь затем стать валидированным набором для маршрутизаторов. Подпись может оставаться безупречной, а сбой доставки всё равно изменит доказательства, доступные следующему звену.
Дельта, снимок, резервный путь
RFC 8182 определяет три элемента RRDP. Файл уведомления указывает сессию и серийный номер репозитория. Дельты несут инкрементальные изменения. Snapshot содержит полное текущее состояние. Если от локального номера до текущего есть непрерывная цепочка дельт, валидатор выбирает лёгкий путь. Если файл пропущен или отклонён, он переходит к снимку.
Стоимость путей различна. Дельта может быть небольшой, а snapshot — занимать десятки или сотни мегабайт. Версия проекта SIDROPS о сервисах публикации от мая 2026 года описывает каскад: после неудачи с одной или несколькими дельтами доверяющая сторона обычно пробует более крупный снимок; если он тоже не загружается, возможен переход на rsync; при следующем запуске RRDP работа часто снова начинается со снимка. Перегрузка запускает восстановление, которое ещё больше повышает спрос. Аварийный груз оказывается самым тяжёлым именно тогда, когда платформа слабее всего.
Документ остаётся рабочим Internet-Draft группы IETF, а не RFC. Приведённые в нём цифры имеют чёткие границы. В одном крупном репозитории в январе 2024 года уведомление со 144 дельтами за 14 часов создало 251 ГБ из 55,5 ТБ общего трафика — менее 0,5%. Большее окно дельт помогает отставшему валидатору догнать состояние инкрементально, но удлиняет уведомление для всех. Меньшее окно экономит обычный трафик и отправляет больше клиентов за снимком. Проект рекомендует хранить не менее четырёх часов дельт, поскольку в 2024 году некоторые RP синхронизировались лишь раз в один-два часа. Параметр не устраняет затраты, а выбирает их место и время.
У валидатора есть ещё один слой политики. Текущая документация Routinator предлагает never, stale и new для перехода на rsync после отказа RRDP. Документированное значение по умолчанию — stale: локальная копия RRDP используется, пока считается актуальной, после чего rsync запускается в случайный для каждого репозитория момент. Максимальная граница по умолчанию — 3600 секунд. Разброс нужен, чтобы все валидаторы не пришли к запасному входу одновременно.
Документация перечисляет и другие пороги: snapshot при необходимости более 100 дельт; список считается пустым, если в нём более 500; 600 секунд на получение ресурса RRDP, 10 секунд на чтение и 300 секунд на команду rsync. Это настройки продукта, а не константы RPKI. Их изменение превращает один и тот же отказ в другую последовательность запросов и решений о кэше.
Кэш входит в цепочку доказательств
RFC 9286 рекомендует после неудачной загрузки использовать данные предыдущей успешной до следующего успеха. Так неполное состояние репозитория не превращается в ложную трактовку нового намерения маршрутизации. Отсюда следует: текущая доступность HTTPS-адреса не показывает возраст доказательств, которые в итоге получит маршрутизатор.
Manifest ограничивает такую непрерывность. Он перечисляет объекты, которые издатель намерен опубликовать, и помогает выявить удаление, подмену или сокрытие новой версии. Он обнаруживает расхождение, но не восстанавливает отсутствующий объект. thisUpdate, nextUpdate, CRL и срок действия объектов задают конечное окно использования старого кэша.
Проект 2026 года прямо описывает компромисс. Более долгий срок действия оставляет больше времени на ремонт, но расширяет окно replay. Более короткий снижает эту экспозицию и увеличивает число перевыпусков. В одном крупном репозитории переход от перевыпуска manifest и CRL каждые 24 часа к циклу в 48 часов сократил объём данных примерно наполовину, поскольку большинство изменений составляли перевыпуски, а не новые ROA или ASPA. Это не мировой коэффициент. Но структура власти очевидна: CA задаёт ритм, а репозиторий и все доверяющие стороны обрабатывают нагрузку.
Стандарты продолжают уточнять границы восстановления. RFC 9981, опубликованный в мае 2026 года, разбирает исключительный случай достижения максимального номера manifest. До нового правила одни реализации могли принять замену только после истечения текущего manifest, другие — отвергать новые бессрочно. Обычный счёт практически не достигнет предела; реальны ошибка или неверная конфигурация. Ценность примера не в частоте, а в прямом доказательстве: неуточнённая граница восстановления способна дать разные рабочие результаты.
Пропускная способность и безопасность движутся по-разному
Переход на rsync может повысить доступность и ослабить транспортную границу. RRDP использует HTTPS и распространяет неизменяемые, кэшируемые дельты и снимки. Rsync требует больше серверной работы на соединение и сам не обеспечивает конфиденциальность и целостность канала. Модель угроз Routinator допускает, что атакующий на пути ухудшит RRDP и добьётся перехода на rsync. После этого подписи и manifest несут большую часть защиты.
В 2020 году NLnet Labs показала риск ёмкости на перспективной модели: 150 тысяч валидаторов при опросе раз в десять минут дают около 250 запросов в секунду, тогда как резервный rsync-сервис привык примерно к трём. Это не телеметрия 2026 года. Это объяснение, почему мгновенный массовый fallback был плохой идеей и почему ожидание распределяют случайно.
Чувствительность можно показать без выдуманного глобального итога. Пусть есть 10 тысяч валидаторов, обычная дельта 1 МБ и сжатый snapshot 100 МБ. Полностью инкрементальный цикл — 10 ГБ. Если лишь 20% клиентов переходят на снимок, выходит около 208 ГБ: 8000 МБ дельт плюс 200 000 МБ снимков. Повторные попытки и серверная работа rsync идут сверху. Пик определяет не только число клиентов, но и ширина временного окна восстановления.
Репозиторий может быть «доступен» и предоставлять неконсистентное восстановление. Балансировщик способен показать уведомление одного backend до появления указанных файлов на других. Старое keepalive-соединение может пережить переключение и вернуть предыдущую сессию. Проект SIDROPS требует одинакового состояния backend и отмечает, что RFC 8182 не задаёт единого ответа на уменьшение серийного номера; некоторые реализации загружают snapshot для ресинхронизации. Монитор видит код 200. Валидатор — сломанную временную шкалу.
Источники не дают глобальной частоты расхождений и не доказывают, что конкретный репозиторий вызвал сбой маршрутизации. Они подтверждают механизм, настраиваемые решения и перенос затрат. Этого достаточно для воспроизводимого испытания.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров