
Резюме
- OpenAI OpCo лучше всего оценивать по принимаемому действию, подкреплённому моделью: ответу с помощью модели, классификации, вызову инструмента или обновлению записи, которые можно проверить, воспроизвести, ограничить и откатить в реальном операционном процессе.
- Сильная сторона OpenAI — не одиночная демонстрация модели, а сочетание Responses API, функций и вызовов инструментов, структурированных выводов, управления состоянием, оценок, контроля данных, разрешений, админ-API и уровней обработки вокруг возможности модели.
- Слабое место — разрыв между правдоподобным ответом и принятой работой. Соблюдение формата, доступ к инструментам и поиск сами по себе не доказывают корректность для бизнеса, доверие людей, готовность к откату или экономию для клиента.
- Покупатели должны отделять возможности модели от надёжности продукта OpenAI и собственного живого результата. Реальный знаменатель включает усилия по интеграции, тестовые данные, проверку человеком, обработку исключений, контроль приватности, планирование мощностей, инженерную проработку отказоустойчивости и концентрацию риска на одном вендоре.
Принимаемое действие — правильный знаменатель
Полезная единица для оценки OpenAI в корпоративном ПО — не ответ. Ответ может быть беглым, быстрым и впечатляющим, но непригодным. Он может опираться на устаревший контекст. Он может запрашивать шаг, который система выполнять не вправе. Он может соответствовать JSON-структуре, но выбрать неверную бизнес-категорию. Он может сэкономить сотруднику тридцать секунд, а затем стоить инженеру часа, когда путь обработки исключения непонятен. Лучшая единица — принимаемое действие, подкреплённое моделью.
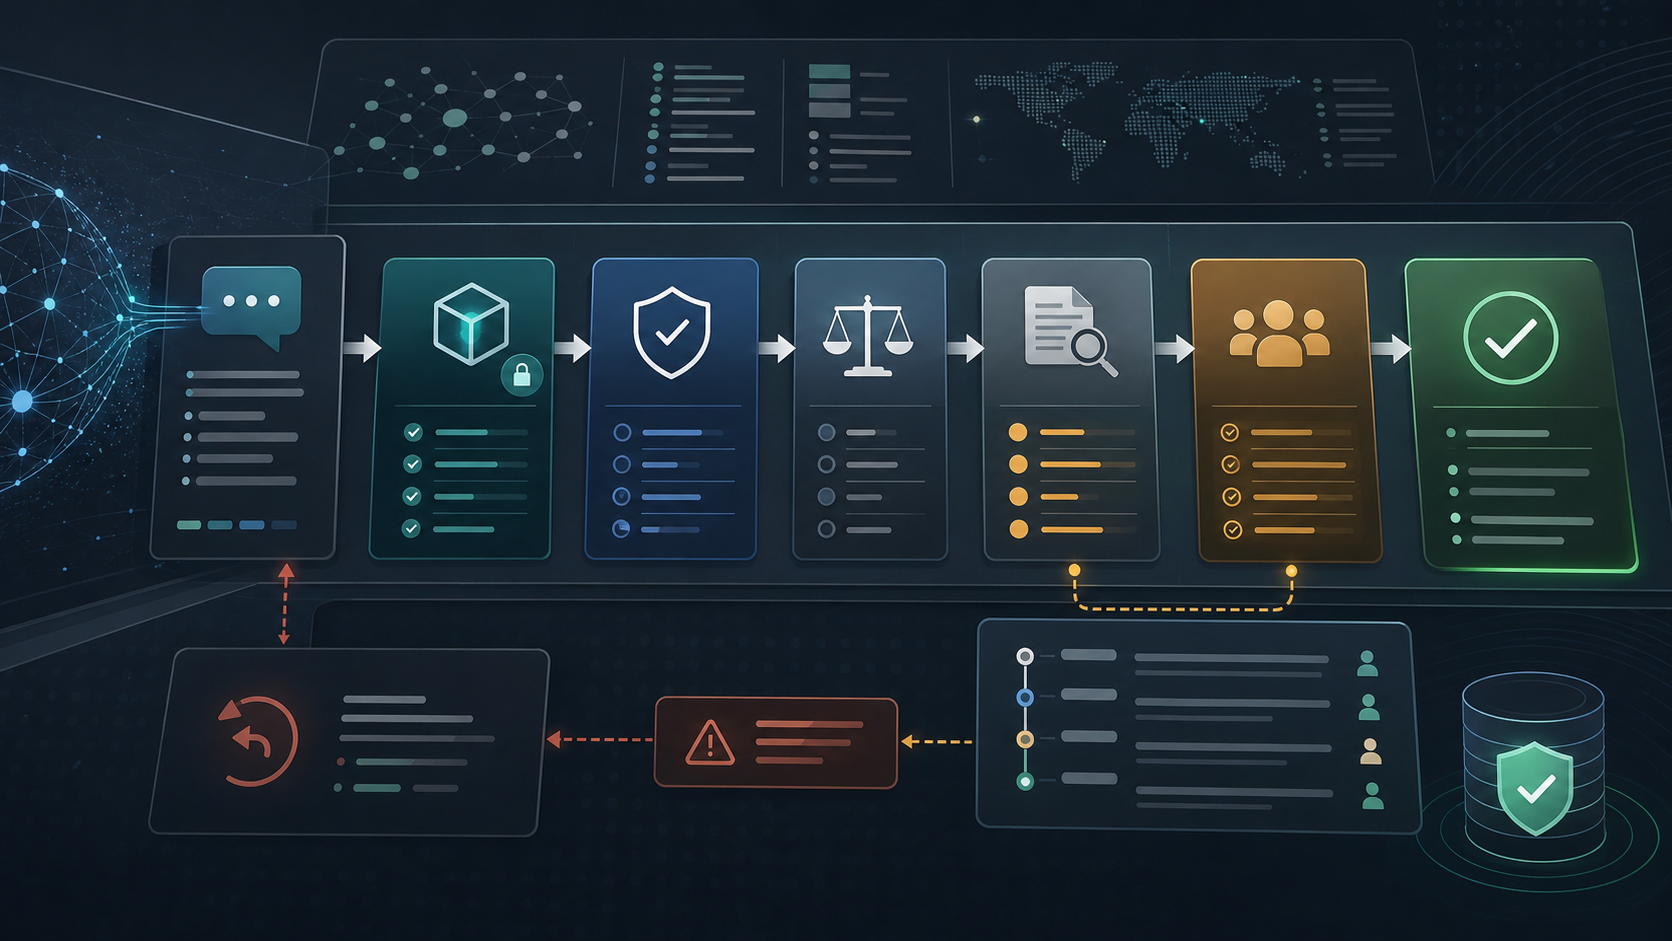
Принимаемое действие — это весь путь от запроса до полезного результата. Модель получает правильную инструкцию и контекст. Приложение ограничивает допустимый вывод. Соединение с инструментом или системой выполняется с надлежащими полномочиями. Результат проверяется по бизнес-правилу. Доказательства доступны для проверки. Сбои обрабатываются без тихого ущерба. Стоимость и задержка приемлемы для задачи. Человек или внешняя система может принять результат по стандарту, определённому до поступления запроса.
Такой подход строже, чем подсчёт вызовов API, объёма токенов или беглости вывода. Он также справедливее к OpenAI. Компания поставляет важную часть модельного и продуктового слоя, но ей не принадлежат все базы данных клиентов, правила согласования, очереди тикетов, процессы колл-центров, складские записи, финансовые политики или процедуры безопасности, в которые интегрируются её модели. Клиент может использовать мощную модель со слабыми инструментами, расплывчатыми политиками и без пути проверки. Клиент может также сделать более ограниченную модель полезной, окружив её тщательной валидацией и продуманной эскалацией.
Эта статья посвящена OpenAI OpCo — субъекту из справочника, связанному с API и корпоративными продуктовыми поверхностями, которыми управляет OpenAI. Она не охватывает некоммерческую структуру управления, исключительное покрытие судебных издержек, общие новости о моделях, стратегию Microsoft, заявления об инфраструктуре Azure или качество собственного приложения клиента. Эти границы важны, потому что производственная ценность создаётся совместно. OpenAI поставляет фундаментальные модели, API, интерфейсы инструментов, функции структурированного вывода, контроль данных и корпоративные админ-поверхности.
Клиенты приносят данные, разрешения, критерии приёмки, проверяющих, внешние системы и процедуры на случай сбоев.
Поэтому тест практичен. Может ли OpenAI помочь превратить повторяющийся запрос к модели в работу, которую бизнес может принять, с более низкой совокупной стоимостью, чем ручная обработка, готовая SaaS-автоматизация, альтернатива от облачного провайдера, стек с открытым исходным кодом, собственная разработка или просто сокращение объёма такой задачи? На этот вопрос нельзя ответить словами, что модель хорошо рассуждает в идеальном диалоге.
Ответ даётся подсчётом принятых результатов, отклонённых, переданных на эскалацию, ошибок инструментов, повторов, минут проверяющих, сбоев по задержке, работы по контролю данных, обслуживания, учений по восстановлению и стоимости перехода.
Продуктовая поверхность OpenAI смещается к операционной работе
Нынешняя разработчическая поверхность OpenAI — это уже не просто конечная точка генерации текста, обёрнутая в код клиента. Публичная документация позиционирует Responses API как центральный примитив для создания приложений, объединяющих вывод модели, конфигурацию инструментов, состояние ответа, учёт использования, варианты хранения и идентификаторы предыдущих ответов. Вокруг него располагаются вызовы функций, встроенные инструменты, структурированные выводы, управление состоянием диалога, оценки, лимиты частоты запросов, контроль данных, разрешения на основе ролей и админ-API.
Направление продукта ясно: OpenAI хочет быть ближе к точке, где вывод модели превращается в работу.
Это важно, потому что предприятия усвоили: модель сама по себе — не система. Модель может классифицировать обращение в поддержку, подготовить черновик ответа, резюмировать договор, предложить запрос к данным, подготовить корректировку заказа или выбрать системный инструмент. Но бизнес-задача не завершена, пока вывод не проверен по политике, не привязан к правильной записи, не назначен правильному владельцу, не зарегистрирован, не оценён по стоимости и не обратим. Продуктовый слой вокруг модели — это место, где вендор может снизить усилия клиента.
Преимущество OpenAI в том, что она контролирует и интерфейс модели, и многие ограничения для разработчиков вокруг него. Структурированные выводы могут ограничивать форму данных, возвращаемых приложению. Вызовы функций определяют инструменты, которые модель может запрашивать. Встроенные инструменты сокращают часть работ по кастомной интеграции. Рекомендации по состоянию диалога помогают разработчикам сохранять релевантный контекст между обращениями. Оценки дают командам место для проверки поведения по критериям. Контроль данных, RBAC и админ-API дают корпоративным командам поверхности управления, которых нет у голой конечной точки модели.
Ограничение в том, что этим продуктовым поверхностям всё равно нужен операционный контракт, определённый клиентом. Описание инструмента говорит, что модель может попросить сделать; оно не доказывает, что модель выбрала правильный инструмент для политики клиента. Структурированный вывод указывает, какие поля должны присутствовать; он не доказывает, что значения верны. Функция управления состоянием может сохранять контекст; она не доказывает, что контекст был актуальным, полным и разрешённым. Оценка может выявлять регрессии; она не доказывает, что тестовый набор отражает самые важные крайние случаи.
Это место, где бизнес-кейс OpenAI становится одновременно сильнее и требовательнее. Компания может уменьшить объём однотипной механики, которую разработчик должен построить до попытки автоматизации на основе модели. Она также может повысить ожидания, что клиенты быстрее перейдут от экспериментов к повторяемой работе. Как только это происходит, закупочным и инженерным командам нужен знаменатель лучше, чем «модель ответила». Им нужно знать, является ли принимаемое действие более дешёвым, безопасным и простым в сопровождении, чем альтернатива.
Структурированный вывод устраняет один класс сбоев, но не все
Структурированный вывод — одна из важнейших частей цепочки принимаемого действия, потому что корпоративные системы редко без проблем потребляют свободный текст. Очередь поддержки ожидает категорию, приоритет и владельца. Финансовый процесс ожидает код, сумму и причину. Комплаенс-проверка ожидает вывод, серьёзность, ссылку на доказательства и оговорку. Движок рабочего процесса ожидает поля, которые можно проверить. Если модель возвращает прозу туда, где приложению нужен ограниченный объект, интеграция становится хрупкой.
Документация OpenAI позиционирует Structured Outputs как способ заставить ответ модели соответствовать предоставленному JSON. Это существенное улучшение по сравнению с просьбой «верни JSON» и надеждой, что приложение сможет его разобрать. Это предотвращает пропуск обязательных ключей, недопустимые значения enum и другие ошибки формы, которые вынуждают повторять запросы или чинить вручную. Это особенно полезно, когда результат модели становится входом для другой системы, которой нужны предсказуемые поля.
Но соответствие формату — это не приёмка. Модель может заполнить все обязательные поля и при этом выбрать неверное значение. Она может классифицировать обращение как биллинговое, хотя это мошенничество. Она может взять дату продления из устаревшего пункта. Она может корректно отформатировать рекомендуемую сумму возврата, применив неверную политику. Она может пройти синтаксическую проверку и не пройти проверку бизнесом.
Это различие — источник излишнего оптимизма во многих бизнес-кейсах автоматизации. Ранняя экономия видна: меньше некорректно сформированных выводов, меньше ошибок разбора, меньше хрупких правил. Скрытые издержки остаются: проверяющие, валидаторы, тестовые наборы, категории исключений и пути эскалации всё равно должны ловить неверные, но правильно оформленные результаты. В низкорисковой задаче обогащения данных этого может быть достаточно. В кредитовании, здравоохранении, безопасности, регулируемом доступе или движении денег клиентов неверное, но идеально оформленное действие по-прежнему неприемлемо.
Более сильный дизайн клиента рассматривает структурированный вывод как границу контракта, а не границу доверия. Формат определяет, что приложение может получить. Отдельный валидатор проверяет бизнес-правила. Слой разрешений проверяет полномочия. Проверяющий или политический движок решает, разрешено ли исполнение. Журнал входа, вывода модели, результата проверки и финального решения остаётся для последующего анализа. В такой конструкции функция структурированного вывода OpenAI устраняет один класс сбоев, но принимаемое действие по-прежнему зависит от контрольного стека клиента.
Это не делает функцию незначительной. Это означает, что её ценность нужно правильно учитывать. Ценность не в том, что «теперь модель корректна». Ценность в меньшем трении интеграции, меньшем числе некорректных выводов, лучшей тестируемости и более чистом пути к дальнейшей проверке. Эти сбережения входят в знаменатель, как входят и оставшиеся затраты на валидацию.
Использование инструментов переносит риск со слов на последствия
Вопрос о принимаемом действии становится острее, когда модель может вызывать инструменты. Документация OpenAI по вызову функций и использованию инструментов даёт разработчикам способ описывать функции, задавать параметры и позволять модели запрашивать внешние данные или действия. Это момент, когда система на основе модели переходит от «расскажи» к «сделай это». Это также момент, когда неопределённость модели может создавать операционный риск.
Неверный абзац может запутать читателя. Неверный вызов инструмента может изменить запись, отправить сообщение, обновить тикет, запросить ограниченные данные, повлечь расходы, запустить внешний процесс или создать обязательство. Опасность не в том, что использование инструментов небезопасно по своей сути. Опасность в том, что команды иногда относятся к выбору инструмента так, будто это то же самое, что полномочия на инструмент. Это не так. Модель может решить, что инструмент релевантен; приложение всё равно должно решить, разрешено ли действие, безопасно ли оно, обратимо ли и подкреплено ли доказательствами.
Продуктовая поверхность OpenAI может помочь, делая инструменты явными. Определение функции может содержать имя, описание, параметры и строгость. Встроенный инструмент может сократить кастомную интеграцию для типовых задач. Поиск инструментов и удалённые подключения могут снизить нагрузку по загрузке всех возможностей в каждый запрос. Это полезные контрольные точки, потому что они делают исполняемую поверхность видимой для разработчиков.
Более тяжёлая работа клиента начинается после определения. Входы инструмента требуют валидации вне модели. Побочные эффекты требуют идемпотентности. Дорогие или разрушительные действия требуют согласования. Инструменты только для чтения не должны иметь те же полномочия, что инструменты записи. Система должна знать, что происходит, когда инструмент возвращает ошибку, неоднозначный результат, частичный успех или устаревшую запись. Проверяющему нужно достаточно доказательств, чтобы решить, можно ли принять действие. Путь отката должен существовать до первого сбоя.
Практичный дизайн — разделять предложение и исполнение. Модель может собирать контекст, выбирать вероятный следующий шаг и готовить структурированные аргументы. Код клиента проверяет аргументы, права и политику. Низкорисковые действия могут выполняться автоматически. Среднерисковые могут требовать проверки. Высокорисковые могут оставаться ручными. Каждая ветвь должна быть учтена. Система, которая завершает без проверки шестьдесят процентов случаев и эскалирует сорок, — не провал, если эти эскалации ожидаемы и дёшевы. Это провал, если бизнес-кейс предполагал стопроцентную автоматизацию.
Именно здесь ценность OpenAI должна сравниваться с альтернативами. Обычный SaaS-инструмент может автоматизировать меньше случаев, но применять известные правила более предсказуемо. Инструмент роботизированной автоматизации процессов может быть дорогим в сопровождении, но проще в аудите для ограниченной последовательности экранов. Стек моделей с открытым исходным кодом может снизить зависимость от вендора, но переносит больше интеграционной и безопасностной работы на клиента. Ручная обработка может выглядеть неэффективной, пока модельный путь не потребует слишком много проверок. Принимаемое действие делает эти сравнения честными.
Контекст и состояние — это издержки, а не фоновые детали
Действия на основе модели часто срываются, потому что системе не хватает нужного знания в нужный момент. У неё может не быть актуального статуса аккаунта, нужной политики, предыдущего решения проверяющего, правильного уровня клиента или точной границы прав. Документация OpenAI по состоянию диалога признаёт проблему: отдельные запросы на генерацию текста независимы, если состояние не передано или не сохранено через соответствующий продуктовый путь. Эта деталь — не просто забота разработчика. Это часть надёжности.
В повторяемой бизнес-задаче контекст нужно собирать, фильтровать, обновлять и делать неактуальным. Слишком мало контекста — догадки. Слишком много контекста — издержки, задержка и риск для приватности. Неверный контекст создаёт ложную уверенность. Устаревший контекст создаёт устаревшие решения. Контекст из ограниченной системы создаёт проблемы прав. Поэтому полезному приложению OpenAI нужен бюджет контекста, а не только бюджет токенов.
Рассмотрим действие в поддержке клиентов. Модели могут понадобиться план клиента, открытые тикеты, недавние сообщения, политика возвратов, сигналы мошенничества и региональные правила. Часть этих данных можно прочитать автоматически. Часть может быть недоступна конкретному пользователю. Часть может измениться, пока обрабатывается запрос. Часть вообще нельзя отправлять модели. Принимаемое действие зависит от получения достаточных доказательств с соблюдением границ данных и лимитов стоимости.
Та же проблема в инструментах разработчика, анализе данных, продажах и работе службы безопасности. Вывод может выглядеть уверенным, но проверяющему нужно знать, какие доказательства использовались, а что было недоступно. Если система не может это показать, человек должен вручную перепроверять источник или принять слепой риск. Оба исхода ухудшают экономику.
Продуктовые поверхности OpenAI могут снизить часть этой нагрузки. Управление состоянием, подсчёт входных токенов, инструменты поиска и метаданные ответа упрощают понимание того, что было отправлено и что вернулось. Они не снимают с клиента необходимость проектировать свежесть данных, фильтрацию прав, дисциплину цитирования, хранение и отображение доказательств. Стоимость такого проектирования входит в цену каждого принимаемого действия.
Вот почему автоматизация с большим объёмом контекста часто движется медленнее, чем кажется на демо. Первое демо использует чистый вход. Живая система встречает неполные записи, противоречивые документы, старые тикеты, отсутствующие вложения, ограничения приватности, пробелы в качестве данных и пользователей, просящих то, что им получать нельзя. OpenAI может сделать модели более способными работать с беспорядочной информацией. Бизнес всё равно должен решать, когда беспорядок должен остановить действие.
Оценка — это повторяющаяся операционная работа
Документация OpenAI по оценкам говорит, что команды должны проверять выходы моделей по собственным критериям, анализировать результаты и итерировать. Это правильный совет. Это также напоминание, что оценка — не ритуал запуска. Это повторяющаяся операционная работа.
Важнейший вопрос оценки не «хороша ли модель?», а «достаточно ли хороша эта система для этого принимаемого действия при этой политике?» Модель, отлично резюмирующая длинные документы, может быть ненадёжной при извлечении узкой договорной оговорки. Модель, полезная для черновиков ответов, может быть слишком рискованной для финального одобрения. Модель, проходящая внутренний тестовый набор, может провалиться, когда появляются новый продукт, регион, политика или формат входных данных.
Оценка имеет несколько слоёв. Поведение модели: следовала ли модель инструкциям, использовала ли доказательства, избегала ли необоснованных утверждений. Поведение продукта: вернул ли API ответ за нужное время, сохранил ли состояние, применил ли формат вывода и ясно ли показал ошибки. Поведение приложения: проверил ли код клиента поля, применил ли права, направил ли исключения. Поведение бизнеса: приняли ли проверяющие действие, отклонили его или потратили на исправление больше времени, чем потребовала бы ручная работа.
OpenAI может помочь инструментами оценки и документацией, но стандарт приёмки локальный. Логистическая компания, банк, поставщик ПО, оператор связи и больница не будут иметь одинаковый порог. Даже внутри одной компании задача черновика и задача исполнения не должны иметь одинаковый порог. Стоимость создания, поддержания и проверки этих порогов — часть бизнес-кейса.
Потребность в оценке возрастает, когда меняются модели, инструменты или функции продукта. Модель с более высоким баллом на публичном бенчмарке всё равно может изменить распределение выводов внутри системы клиента. Она может иначе использовать инструменты, выдавать более длинные ответы, стоить больше или меньше, чаще отклонять случаи или иначе показывать неуверенность. Более дешёвая модель может быть приемлема для классификации, но не для финальных рекомендаций. Более быстрый уровень обработки может помочь пользовательским задачам, но не сократить время проверяющего.
Без регрессионных тестов, привязанных к принимаемым действиям, командам остаётся узнавать об изменениях через жалобы пользователей или дефекты в нижестоящих системах.
Честный вопрос покупателя поэтому не в том, существует ли оценка. А в том, сколько тест-кейсов принимаемых действий нужно, кто их поддерживает, как часто они запускаются, что означает сбой, кто разбирает сбои и меняет ли результат решения о развёртывании. Именно здесь видна стоимость надзора.
Корпоративные средства контроля — часть надёжности
Приватность и права часто рассматриваются как требования закупок, отдельные от надёжности продукта. Для действий на основе модели они являются частью надёжности. Система, которая даёт правильный ответ на данных, которые она не должна была видеть, не может быть принята. Система, позволяющая широкому сервисному идентификатору запускать чувствительные инструменты, потому что так проще настроить, не надёжна. Система, которая не может показать, кто изменил настройку или какая политика хранения применялась, не готова к повторяемой корпоративной работе.
Документация OpenAI по контролю данных говорит, что данные API не используются для обучения или улучшения моделей OpenAI, если клиенты явно не согласились. Она также различает логи мониторинга злоупотреблений, состояние приложения, хранение в зависимости от конечной точки и право на нулевое хранение данных. Корпоративные страницы о приватности и данных описывают владение данными клиента, контроль хранения, SSO, контроль функций и обязательства по безопасности. Документация RBAC описывает права организации и проекта, пользовательские роли, группы и единые права в панели управления и API.
Документация админ-API охватывает автоматизацию администрирования, просмотр аудит-логов, управление проектами, ключами, алерты по расходам, хранение данных и операции с лимитами частоты.
Это важные продуктовые средства контроля. Они делают OpenAI более убедительной для корпоративных покупателей, чем потребительский интерфейс модели без админ-поверхности. Они также переносят работу на покупателя. Кто-то должен выбрать настройку хранения. Кто-то должен решить, какие данные могут попасть в запрос к модели. Кто-то должен управлять ключами, проектами, группами, ролями и разрешёнными IP-адресами. Кто-то должен просматривать аудит-логи и алерты по расходам. Кто-то должен согласовывать средства контроля OpenAI с корпоративным провайдером идентификации, правилами защиты данных, тикетной системой и комплаенс-доказательствами.
Эта работа не просто бюрократическая. Она меняет знаменатель принимаемого действия. Действие на основе модели, которое экономит две минуты, но требует несанкционированного потока данных, может быть непригодно. Интеграция инструмента, которая работает в песочнице, но не может получить ограниченные права в боевом аккаунте, может не масштабироваться. Дешёвый вызов модели, создающий требования к хранению или проверке, может оказаться дороже, чем кажется сначала.
Поэтому средства контроля OpenAI следует измерять как условия, позволяющие использовать продукт, а не как автоматическое доверие. Они могут сократить разрыв между экспериментом разработчика и корпоративным развёртыванием. Они могут облегчить due diligence. Они могут помочь командам безопасности ограничивать доступ и отслеживать администрирование. Но им всё равно нужна операционная модель клиента. Надёжный контроль вендора, который не используется, на практике контролем не является.
Пропускная способность, задержка и цена решают, жизнеспособно ли действие
Для повторяемой работы на основе модели пропускная способность — не абстрактный инфраструктурный показатель. Это часть пользовательского опыта. Поздний ответ может быть безвреден в ночном обогащении данных и неприемлем во взаимодействии с клиентом. Ошибка лимита частоты может быть нормальным сигналом обратного давления для пакетной работы и серьёзным сбоем для живого пути принятия решений. Более дешёвый уровень обработки может улучшить экономику задач с проверкой и ухудшить её, если его задержка заставляет людей ждать.
Документация OpenAI по лимитам частоты задаёт базовое ограничение: лимиты вводятся для борьбы со злоупотреблениями, справедливостью и нагрузкой на инфраструктуру; они определяются на уровне организации и проекта, зависят от модели и могут включать общие семейные лимиты, лимиты использования и лимиты приёма векторных хранилищ. Значит, покупатель не может рассчитать пропускную способность только по выбору модели. Операционный вопрос — сможет ли выбранный аккаунт, проект, модель, уровень и паттерн запросов поддержать целевой уровень принимаемых действий.
Страницы уровней обработки обостряют компромисс. Приоритетная обработка позиционируется для более низкой и стабильной задержки в привычных высокоценных пользовательских приложениях. Гибкая обработка обменивает более низкую цену на более медленные ответы и эпизодическую недоступность ресурсов, что делает её более подходящей для низкоприоритетной, асинхронной или оценочной работы. Масштабный уровень позволяет корпоративным клиентам покупать единицы токенов для конкретного снимка модели и добавлять купленную квоту к лимитам частоты. Каждый из этих выборов меняет экономику принимаемых действий.
Ключ в том, чтобы оценить весь путь. Стоимость токенов — лишь одна составляющая. Стоимость принимаемого действия также включает поиск, исполнение инструментов, валидацию, логирование, хранение, время проверяющих, неудачные попытки, буферы задержки, мониторинг, обращения в поддержку, эскалацию, действия на случай сбоев и периодическое тестирование. Дешёвый вызов модели, который удваивает время проверки, может быть дорогим. Более дорогая модель, снижающая число отказов и эскалаций, может быть дешевле в расчёте на принимаемое действие.
План с гарантированными мощностями может быть разумным для стабильного высокоценного трафика и расточительным для пиковых задач.
Задержка имеет похожую структуру. Производственные рекомендации OpenAI отмечают, что на задержку запроса сильно влияют выбор модели и длина генерируемых токенов. Это полезно, но задержка принимаемого действия включает больше, чем модель. Она включает получение данных, валидацию, вызовы инструментов, ожидание внешних API, проверку человеком и проверки отката. Пользовательский процесс может требовать быстрого первого ответа и более позднего финального действия. Административная задача может предпочесть более медленную и дешёвую обработку, если результат придёт до следующего окна проверки.
Правильное измерение — не среднее время ответа. Это время до приёмки. Сколько времени нужно, чтобы бизнес смог доверять результату? Если модель отвечает за две секунды, но проверяющий тратит четыре минуты на проверку доказательств, время принимаемого действия — не две секунды. Если автоматический путь мгновенно обрабатывает простые случаи и чётко направляет неопределённые, средневзвешенное значение всё равно может быть ценным. Метрика должна соответствовать работе.
Инциденты делают аварийные процедуры частью проекта
Страницы статуса OpenAI и история инцидентов полезны тем, что напоминают покупателям: даже у надёжных централизованных сервисов бывают события. Публичная страница статуса сообщает о совокупной доступности по группам продуктов, а страница истории фиксирует восстановление после инцидентов с ошибками API, задержками и конкретными поверхностями API. В отчёте об инциденте за март 2026 года говорилось о повышенном уровне ошибок API и задержках на нескольких моделях, вызванных тем, что внутренняя система планирования одновременно запустила большой пакет инфраструктурных действий.
Урок не в том, что OpenAI необычно хрупка. У любого облачного или модельного вендора могут быть сбои. Урок в том, что принимаемые действия требуют политики на случай сбоев. Система, зависящая от OpenAI, должна знать, что делать, когда запрос истекает по времени, возвращает ошибку, замедляется, меняет доступность модели, упирается в лимит частоты или выдаёт неполный результат. Ответ будет разным для разных задач.
Часть работы может подождать. Часть может переключиться на модель поменьше. Часть может уйти на ручную проверку. Часть может использовать кэшированный контекст. Часть должна немедленно остановиться, потому что частичное исполнение опасно. Часть может продолжаться только в режиме чтения. Часть должна направляться к другому вендору, но этот маршрут должен быть протестирован до инцидента. Процедура на случай сбоя, существующая только на архитектурных диаграммах, — не процедура.
Это ещё одно место, где знаменатель принимаемого действия защищает от иллюзий. Команда должна учитывать неудачные попытки, задержанные попытки, эскалированные попытки и попытки по запасному маршруту. Если модельный путь дёшево завершает большую часть работы, но отправляет предсказуемую долю на ручную обработку, бизнес может планировать персонал. Если сбои редки, но дороги, бизнесу нужны учения по восстановлению. Если запасной вендор использует другие форматы вывода, другое поведение безопасности, другую семантику инструментов или другие политики данных, переключение во время инцидента может создать новые риски.
Операционное решение — не «доверять OpenAI» или «не доверять OpenAI». Это вопрос о том, какие задачи могут напрямую зависеть от неё, какие требуют контрольной точки человека, какие требуют пути через другого вендора, а какие должны оставаться ручными. OpenAI может улучшать отчётность о статусе, документацию ошибок, уровни обработки и устойчивость продукта. Клиент всё равно должен переводить эти сигналы в правила непрерывности бизнеса.
Альтернатива тоже не бесплатна
Серьёзная оценка OpenAI должна сравнивать её с реалистичными альтернативами. Первая альтернатива — ручная работа. Ручная работа медленна и дорога, но может быть гибкой, подотчётной и её проще остановить. Для редких действий с высокими ставками ручная обработка может оставаться более дешёвым безопасным вариантом, потому что стоимость средств автоматизации превысит экономию.
Вторая альтернатива — готовая SaaS-автоматизация. Платформа поддержки, CRM, инструмент безопасности, финансовая система или ИТ-сервис могут автоматизировать ограниченные задачи с помощью детерминированных правил. Такие системы могут быть менее гибкими, чем приложения на основе OpenAI, но у них часто зрелые права, аудит-трассы и отраслевая обработка исключений. Преимущество OpenAI — широта и языковые способности. Преимущество зрелых систем — отраслевое управление и известное операционное поведение.
Третья альтернатива — другой модельный или облачный вендор. Покупатель может предпочесть вендора, который находится внутри его облачной инфраструктуры, предлагает предпочтительный региональный охват, поддерживает любимую модель, даёт более сильные условия закупки или снижает концентрацию риска. Преимущество OpenAI — динамика модели и продукта. Компромисс: концентрация высокоценных действий вокруг одного вендора может повысить риски переговоров, непрерывности и миграции.
Четвёртая альтернатива — открытый исходный код или собственная инфраструктура. Такой путь может улучшить контроль, локальность и кастомизацию, но переносит обслуживание моделей, безопасность, оценку, обновления, мониторинг и оркестрацию инструментов на клиента. Он может быть привлекателен для регулируемых данных, больших объёмов, особых требований к задержке или стратегической независимости. Он редко бывает бесплатным, если учесть персонал, оборудование, облачные мощности и сопровождение.
Пятая альтернатива — делать меньше. Некоторые ИИ-проекты предполагают, что автоматизировать нужно каждую задачу. Это не всегда так. Компания может решить автоматизировать триаж, но не исполнение; готовить черновики ответов, но не отправлять их; обогащать записи, но не перезаписывать их; резюмировать доказательства, но не решать дело; помогать проверяющим, а не заменять проверку. Решение делать меньше может дать лучшее соотношение принимаемых действий, потому что автоматизируемая часть уже и ею проще управлять.
Сильнейший аргумент OpenAI появляется, когда понимание языка, доступ к инструментам и структурированный вывод позволяют клиенту обрабатывать большой объём среднерисковой работы с понятной проверкой и аварийными процедурами. Слабейший аргумент — когда задача редкая, с высокими последствиями, плохо специфицирована, с бедными данными, критична к задержке, сильно регулируема или уже хорошо обслуживается детерминированным ПО. Большинство бизнес-задач находятся между этими полюсами. Поэтому измерения важнее лозунгов.
Что должны измерять покупатели
Первый показатель — доля принимаемых действий. Сколько из всех запросов становятся принятыми результатами без ручного исправления? Сколько отклонено? Сколько передано на эскалацию? Сколько требуют второго вызова модели, повтора инструмента, запроса человеку или отката? Это базовый показатель выхода. Без него команды могут отчитываться о впечатляющем использовании, скрывая стоимость отказов и исключений.
Второй показатель — минуты проверяющего на одно принимаемое действие. OpenAI может ускорить первый черновик или структурированный результат, но бизнес-кейс зависит от того, доверяет ли ему проверяющий. Если проверяющие перечитывают каждый источник, потому что отображение доказательств слабое, автоматизация переместила работу, а не убрала её. Если проверяющие просматривают только неопределённые случаи и быстро видят доказательства, экономия реальна.
Третий показатель — стоимость сбоя. Что происходит, когда модель возвращает неподтверждённый ответ, выбирает неверный инструмент, нарушает установленное ограничение, теряет состояние, истекает по времени, упирается в лимит частоты или выдаёт неоднозначный результат? Стоимость включает немедленное исправление, очистку в нижестоящих системах, влияние на клиента, аудиторскую работу и потерю доверия сотрудников. Низкая доля ошибок всё равно может быть дорогой, если каждая ошибка серьезна.
Четвёртый показатель — задержка до приёмки. Она должна включать время модели, поиск, исполнение инструментов, валидацию, ожидание человека и финальное подтверждение. Для разных задач нужны разные пороги. Полезное сравнение — не самый быстрый возможный ответ, а то, приходит ли принятый результат вовремя, чтобы изменить работу.
Пятый показатель — стоимость одного принимаемого действия. Расходы на токены видны, но недостаточны. Добавьте стоимость инструментов, хранения, логирования, оценки, инженерного сопровождения, проверки безопасности, закупок, проверяющих, поддержки и аварийных процедур. Затем сравните с ручной обработкой, готовым ПО и альтернативными вендорами. Только тогда покупатель может решить, дешевле ли OpenAI или просто интереснее.
Шестой показатель — стоимость перехода. Сколько работы требуется, когда меняются модель, функция API, источник данных, политика или нижестоящая система? Могут ли тесты обнаружить регрессию? Может ли команда откатиться? Можно ли подставить другую модель или вендора? Система, которую дёшево запустить и дорого менять, может оказаться не дешёвой.
Седьмой показатель — концентрационный риск. Если OpenAI становится центральным средством принятия решений в поддержке, анализе данных, инструментах разработчика и операциях, покупатель получает согласованность, но и зависимость. Риск может быть приемлемым. Его нужно явно оценивать в контрактных условиях, аварийных планах, путях экспорта, абстракции моделей, внутренних навыках и управлении.
Контрольные точки на следующий операционный цикл
Первая контрольная точка — изменчивость функций. Продуктовый слой OpenAI движется быстро, и быстрое движение продукта — обоюдоострое преимущество. Новые поверхности могут сократить интеграционную работу клиента и дать лучшие средства контроля. Они также могут изменить абстракции, на которых клиенту стоит строить. Если команда жёстко связывает приложение с функцией, которая позже меняет направление, издержки проявляются как миграция, повторное тестирование и переобучение сотрудников.
Покупателям стоит предпочитать проекты, которые изолируют выбор модели, контракты инструментов, схемы, журналы проверок и логику аварийных процедур от любого отдельного пути функции.
Вторая контрольная точка — переход в оценке. Публичная документация уже показывает, что у некоторых поверхностей оценки запланирован график перехода. Это не делает оценку менее важной; это делает владение более ясным. Клиенту следует относиться к данным оценки, порогам, проверяющим и журналам решений как к собственным операционным активам. Инструменты вендора могут запускать тесты и ускорять итерации, но организации нужно сохранять стандарт приёмки вне одной консоли. Если инструмент меняется, стандарт должен выжить.
Третья контрольная точка — скрытая человеческая работа. Системы на основе OpenAI могут делать работников быстрее, но также повышать когнитивную нагрузку. Проверяющий может обрабатывать больше случаев, но каждый случай может требовать проверки доказательств, поиска неподтверждённых выводов, выявления рисков приватности и решения, безопасно ли действие инструмента. Если этот надзор не измеряется, бизнес спутает пропускную способность с экономией.
Хорошее развёртывание логирует, почему люди переопределяли систему, какие случаи вызывали затруднения и тратят ли проверяющие меньше времени на ценность или просто больше времени на контроль неопределённости.
Четвёртая контрольная точка — дрейф политики. Системы на основе модели часто начинаются с чёткой задачи: триаж этих тикетов, черновики этих ответов, маршрутизация этих исключений. Со временем пользователи просят большего. Ассистент только для чтения становится рекомендателем. Рекомендатель становится исполнителем. Исполнитель получает более широкие полномочия, потому что исключения неудобны. Каждое расширение может быть рациональным по отдельности и рискованным в совокупности.
Чистый ответ — периодический пересмотр полномочий: что система может читать, что предлагать, что исполнять, что обязана эскалировать и что должно оставаться вне её рамок.
Пятая контрольная точка — отображение доказательств. Многие системы хранят логи, но не показывают доказательства в момент приёмки. Проверяющий, который не видит в одном месте источник, вывод модели, проверки валидации, ответ инструмента и оговорку политики, будет реконструировать случай вручную. Это уничтожает экономию и увеличивает несогласованность. Поэтому продуктовый стек нужно оценивать не только по данным, которые он может хранить, но и по представлению решения, которое он делает возможным.
Последняя контрольная точка — доверие сотрудников. Сотрудники не примут систему на основе модели только потому, что она технически доступна. Им нужно видеть, что она знает, когда остановиться, что она облегчает проверку, а не затрудняет её, и что ошибки исправляются без перекладывания вины. OpenAI может дать возможности модели и продуктовые средства контроля. Организация должна обеспечить дисциплину доверия, которая превращает эти средства контроля в принятую работу.
Реальная возможность OpenAI — скучная в лучшем смысле
Самая устойчивая возможность OpenAI — не эффектный ответ. А скучное принимаемое действие: правильно маршрутизированный случай, запись, обогащённая доказательствами, подготовленный и одобренный ответ поддержки, внутренний вопрос, отвеченный с источниками, исключение из политики, переданное на эскалацию, а не исполненное, ограниченная задача разработчика, проверенный результат аналитика, низкорисковый шаг, выполненный без того, чтобы заставить проверяющего начинать заново.
Именно здесь OpenAI может создать реальную корпоративную ценность. Её модели дают широту и способность к рассуждению. Её API дают программируемый интерфейс. Структурированные выводы сокращают число некорректных интеграций. Вызовы инструментов соединяют язык с системами. Управление состоянием и метаданные ответа помогают разработчикам сохранять контекст. Оценки поддерживают дисциплину регрессий. Контроль данных, RBAC и админ-API делают внедрение в предприятии более правдоподобным. Уровни обработки позволяют клиентам более осознанно выбирать между ценой, пропускной способностью и задержкой.
Тот же список объясняет, почему работа трудная. Каждая полезная поверхность создаёт проектный вопрос. Какой инструмент разрешён? Какие поля обязательны? Какие данные можно отправлять? Какой результат требует проверки? Какой сбой следует повторить? Какое действие нужно остановить? Какую модель использовать? За какой уровень стоит платить? Какие логи нужно хранить? Какая альтернатива достаточно хороша, когда основной путь не работает?
OpenAI проверяется тем, насколько хорошо на эти вопросы можно ответить в масштабе, а клиенты проверяются тем, задают ли они их до того, как объявить о победе. Действие на основе модели принимается только тогда, когда бизнес может ему доверять, объяснить его, восстановиться после него и позволить его себе. Это мера, которая отделяет полезную автоматизацию от убедительного демо.