
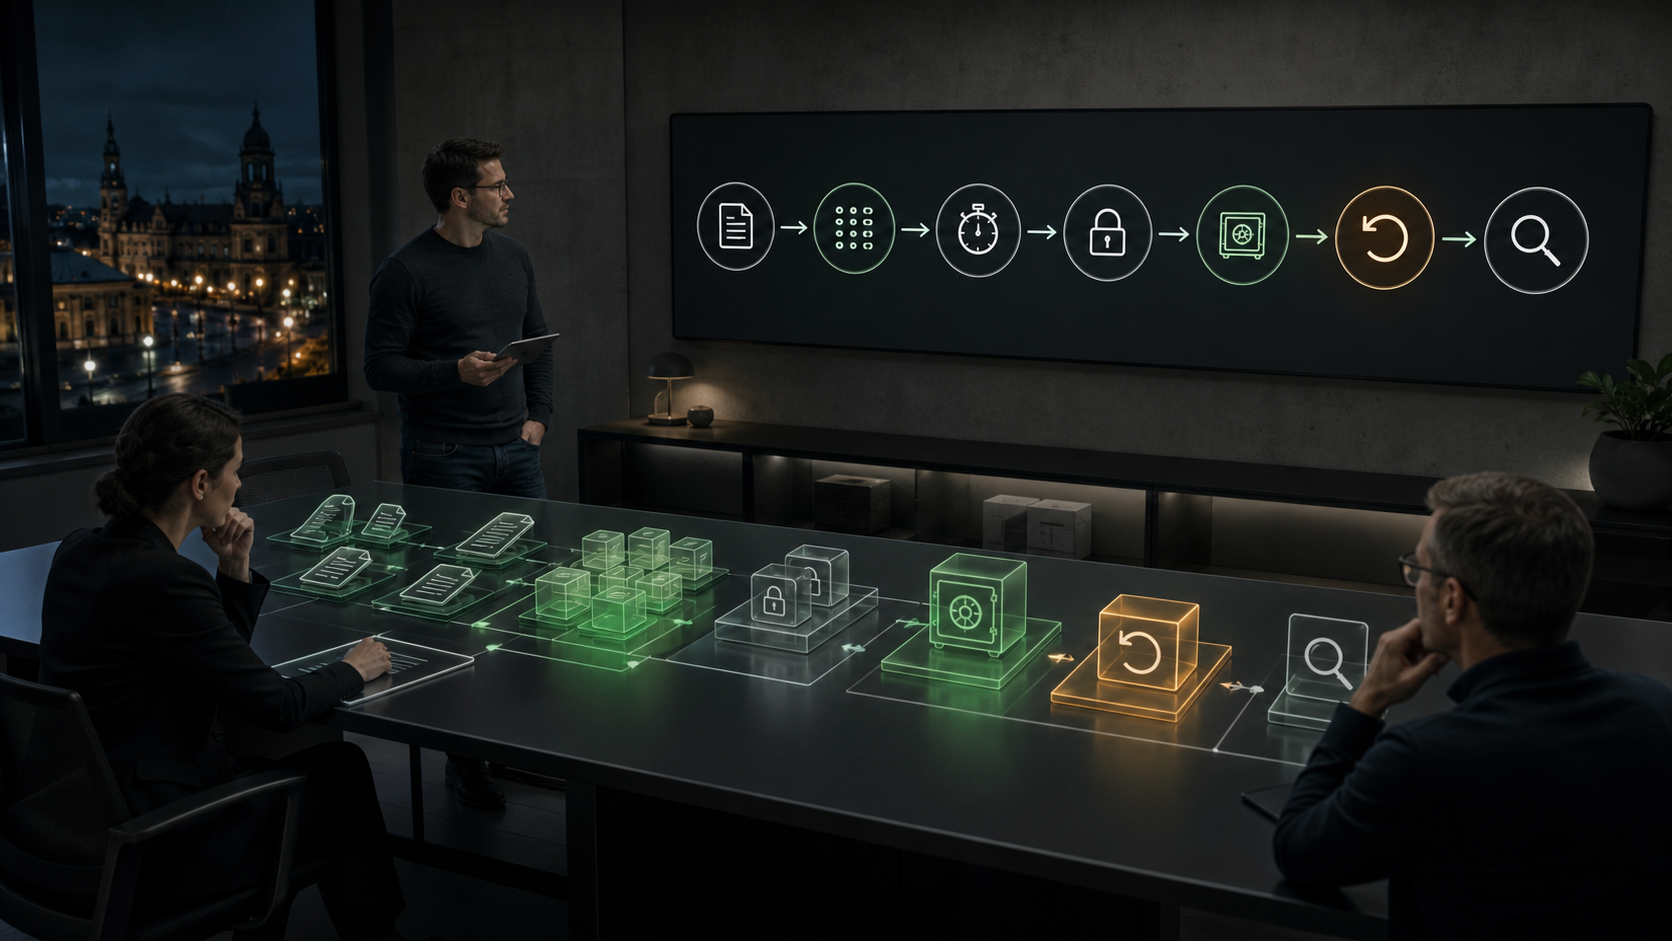
Краткое содержание
- MongoDB Atlas сильнее всего тогда, когда его оценивают как управляемую операционную поверхность для повторящихся изменений данных: создание кластеров, мониторинг, резервное копирование, управление доступом и индексирование поиска упрощаются, но принятое изменение по-прежнему зависит от суждения клиента о форме запроса, стоимости индекса, готовности восстановления, правах доступа и качестве выдачи.
- Граница между компанией и продуктом важна. В центре этой статьи — субъект справочника BTW MongoDB Limited, но доказательства по продукту — это документация Atlas, которую ведёт MongoDB, и финансовые данные группы MongoDB, Inc., а не отдельная выручка MongoDB Limited или клиентская база данных.
- Нерешённый коммерческий вопрос не в том, может ли Atlas ускорить работу с базой данных. Вопрос в том, остаётся ли стоимость облачных ресурсов, дополнительных индексов, хранения резервных копий, узлов поиска, вызовов эмбеддингов, работ по миграции и ручной проверки ниже стоимости той работы с базой данных, которую Atlas обещает устранить.
Изменение данных — настоящая единица ценности
Большинство платформ баз данных продаются в начале истории. Разработчик открывает аккаунт, выбирает облачный регион, создаёт кластер, подключает драйвер и видит, как приложение записывает первый документ. Это полезная церемония, но это не тот момент, когда MongoDB Atlas становится дорогим, заслуживающим доверия или операционно важным. Серьёзная единица — позже и меньше: принятое производственное изменение данных.
Принятое производственное изменение данных может быть новым полем документа, изменённым встроенным объектом, новым индексом, изменённым шаблоном запроса, новым правилом доступа, более длинным окном резервного копирования, перестроением поискового индекса, векторным индексом, миграцией на другой уровень или откатом после неудачного релиза. Оно считается принятым только тогда, когда приложение продолжает работать, производительность остаётся в пределах допуска, права доступа по-прежнему корректны, резервные копии действительно позволяют восстановить данные, а последующая выдача не возвращает незаметно устаревшие или нерелевантные результаты.
Это более сложный тест, чем создание кластера, потому что он повторяется каждую неделю в обычных продуктовых командах.
Обещание MongoDB всегда имело в основе скорость разработчика. Документная модель позволяет командам двигаться быстрее, чем с жёсткими табличными схемами во многих областях приложений. Atlas добавляет к этой модели управляемую инфраструктуру, мультиоблачное развёртывание, резервное копирование, мониторинг, управление ролями, Search и Vector Search. Собственная документация Atlas описывает Atlas как мультиоблачный сервис баз данных, созданный той же организацией, которая создаёт MongoDB, с возможностью развёртывания в AWS, Azure и Google Cloud.
На той же странице пользователям показывают, как выбирать тип кластера, облачного провайдера, регион, параметры безопасности, пользователей базы данных, оповещения, рекомендации по индексам и схемам, а также онлайн-архив. Это реальная операционная поверхность, а не просто загрузка базы данных.
Но чем больше Atlas берёт на себя инфраструктурную работу, тем больше оставшаяся работа становится работой суждения. Управляемый сервис может создать кластер. Он не может сам решить, заставит ли новая схема продуктовой команды биллинговый запрос сканировать слишком много документов. Он может предложить индексы. Он не может знать, оправдывает ли штраф за запись выигрыш в чтении для конкретного пути клиента. Он может предложить восстановление на момент времени. Он не может превратить непроверенный план восстановления в план восстановления бизнеса. Он может индексировать векторы.
Он не может гарантировать, что приложение с дополненной генерацией отвечает на правильный бизнес-вопрос.
Именно поэтому принятое изменение данных — правильный знаменатель для истории Atlas в MongoDB Limited. Покупатель платит не просто за базу данных. Покупатель платит за снижение стоимости многократного изменения программного обеспечения на основе данных без ущерба для производительности, надёжности, контроля доступа или доверия пользователей.
Граница компании уже, чем история бренда
Компания в этой статье — MongoDB Limited, запись в справочнике BTW, которая рассматривается. Однако публичные доказательства по продукту — это не отчёт о деятельности только MongoDB Limited. Публичные материалы компании и документация по продукту MongoDB — это доказательства на уровне группы для MongoDB и её семейства продуктов Atlas. Данные SEC по компаниям (SEC companyfacts) для MongoDB, Inc. показывают масштаб более широкого эмитента: выручка около 2,46 млрд долларов США за финансовый год, закончившийся 31 января 2026 года, и около 687,6 млн долларов США за квартал, закончившийся 30 апреля 2026 года.
Эти цифры полезны для оценки коммерческого масштаба. Это не выручка только Atlas и не отдельная выручка MongoDB Limited.
Эта граница важна, потому что доверие к базе данных часто смешивается между юридическим лицом, брендом продукта, облачным провайдером и нагрузкой клиента. База данных клиента, работающая на Atlas, — это не MongoDB Limited. Регион AWS, Azure или Google Cloud — это не MongoDB. Предыдущая публичная история об ответственности MongoDB, связанная с корпоративными системами и метаданными клиентов, — не эта история. Эта история о поверхности базы данных Atlas, которой управляет MongoDB, и о том, помогает ли она клиентам принимать повторяющиеся производственные изменения данных достаточно безопасно, чтобы оправдать стоимость и зависимость.
Это различие не педантизм. Это разница между оценкой корпоративного управления компании и оценкой операционной экономики продукта. MongoDB Atlas может быть продуктом, к которому прикасается разработчик, но риск покупателя распределён. MongoDB управляет плоскостью управления и функциями сервиса. Облачные провайдеры предоставляют вычисления, хранилище, сеть и региональную доступность. Клиент владеет логикой приложения, решениями о схеме, классификацией данных, секретами, политикой доступа, решениями об индексах, учениями по восстановлению и последствиями для пользователей.
Самая сильная интерпретация Atlas — это не «MongoDB делает всё» и не «клиент предоставлен сам себе». Это совместная операционная модель, в которой MongoDB устраняет часть повторяющейся работы по администрированию базы данных и делает другие решения более наглядными.
Собственная документация MongoDB по резервному копированию говорит об этом прямо через модель разделения ответственности: MongoDB управляет безопасностью и операционной целостностью базовой платформы, а клиенты остаются ответственными за конфигурацию, управление и политики данных своих развёртываний. Это практический контракт за каждым принятым изменением данных. Если изменение ломает запрос, слишком широко открывает коллекцию или не оправдывает ожиданий восстановления, ущерб ложится на продукт клиента, даже если управляемая платформа вела себя так, как задокументировано.
Что Atlas действительно заменяет
Работу, которую заменяет Atlas, проще всего описать, вспомнив, кто делал её раньше. В самоуправляемой среде базы данных инженеры платформы или администраторы баз данных выбирали серверы, устанавливали MongoDB, настраивали наборы реплик, строили задания резервного копирования, меняли учётные данные, отслеживали использование ресурсов, устанавливали обновления, планировали аварийное переключение, смотрели журналы и спорили с командами приложений о форме индексов.
В облачно-нативной команде без выделенных специалистов по базам данных большая часть этой работы ложилась на разработчиков приложений, часто в самый неподходящий момент: медленный запрос под нагрузкой, сломанная миграция, проблема с регионом или восстановление в проде.
Atlas заменяет значительную часть этого труда. Продуктовая документация начинается с развёртывания: выберите тип кластера, облачного провайдера и регион, настройте высокую доступность и изоляцию нагрузки, подключитесь через shell, драйверы, Compass или BI-коннектор. Настройка безопасности также выводится в поверхность продукта: добавьте записи в список IP-доступа, управляйте пользователями базы данных и при необходимости настройте доступ через частную сеть. Операции становятся видимыми через оповещения, Query Profiler, Performance Advisor и метрики.
Резервное копирование и восстановление становятся функциями продукта, а не набором скриптов, которые каждая команда должна писать с нуля.
Это важная работа. Но это не то же самое, что сделать изменение производственных данных безопасным. Atlas может сократить количество шагов для создания инфраструктуры. Он может стандартизировать общие средства контроля. Он может показывать медленные запросы. Он может дать командам функцию резервного копирования с настройками политик. Он может предоставить роли, разделяющие наблюдение, управление резервным копированием, редактирование поисковых индексов и владение проектом. Это реальные улучшения по сравнению с рыхлой самоуправляемой средой.
Шаги, которые остаются, — это те, которые решают, следует ли принять изменение. Кто-то всё ещё должен решить, должен ли существовать новый индекс. Кто-то всё ещё должен проверить, оправдан ли временный пользователь. Кто-то всё ещё должен проверить, не слишком ли широка новая запись в списке доступа. Кто-то всё ещё должен протестировать, что восстановление данных не столкнётся с предположениями приложения о версии. Кто-то всё ещё должен измерить, достаточно ли хорош результат Vector Search для обещания продукта. Atlas делает эти решения более инструментированными. Он не заставляет их исчезнуть.
Это центральное коммерческое напряжение. Atlas продаёт гибкость разработчика и управляемые операции. Покупатель должен учитывать работу, которая исчезает, но также и новую работу по проверке, которая появляется, потому что база данных теперь может меняться быстрее. Платформа, которая делает изменения дешёвыми на входе, всё равно может выставить счёт на выходе, если каждое принятое изменение требует настройки индексов, настройки поиска, пересмотра политики резервного копирования, очистки ролей и анализа облачных затрат.
Дрейф индексов — повседневный сценарий отказа
Самый обычный сбой в документной базе данных — не драматическая потеря данных. Это запрос, который раньше был приемлемым, а теперь стал дорогим. Команда добавляет поле. Документ растёт. Новый фильтр появляется на странице продукта. Агрегация получает$lookup. Сегмент клиентов становится достаточно большим, чтобы план запроса изменился на практике. Ничто не выглядит как взлом или простой. Приложение просто медленнее, и стоимость каждого принятого релиза растёт.
Документация Performance Advisor здесь показательна. Она доступна на кластерах M10+, отслеживает запросы, которые MongoDB считает медленными, и предлагает индексы для повышения производительности. Она группирует образцы запросов по форме запроса и перечисляет распространённые причины медленных запросов: текущие индексы не поддерживают запрос, некоторые документы содержат большие поля-массивы, которые дорого искать и индексировать, или запрос получает информацию из нескольких коллекций через$lookup. В ней также сформулирован ключевой компромисс: индексы улучшают производительность чтения, но многие индексы могут негативно влиять на производительность записи, поскольку их необходимо обновлять при записи.
Этот компромисс — именно та причина, по которой принятые изменения данных нельзя сводить к зелёной рекомендации. Предложенный индекс — это не принятый индекс. Это предлагаемый обмен: больше хранилища и работы по записи ради более быстрого чтения для определённой формы запроса. Atlas может ранжировать и показывать эту возможность. Клиент всё равно должен спросить, достаточно ли часто выполняется запрос, не дублирует ли индекс существующий, не ухудшает ли он коллекции с интенсивной записью, не влияет ли он на шардированное развёртывание и выдержит ли приложение поведение при построении индекса.
У Performance Advisor также есть окно. Он получает рекомендации за последние 24 часа и позволяет изучать до пяти дней. Это полезно для операций, но это не полная история изменений. Ежемесячный расчётный цикл, ежегодное налоговое событие, повторный прогон миграции, рабочий процесс конца квартала или редкий импорт клиентов могут не попасть в короткое окно наблюдения. Изменение данных, принятое только на основе недавних свидетельств о запросах, всё равно может провалиться, когда вернётся менее частый путь.
Query Profiler добавляет больше видимости, но у него есть свои ограничения. Он может показывать медленные запросы, время выполнения, количество просмотренных ключей, количество просмотренных документов и коэффициенты попадания. Он также предупреждает, что данные профилирования могут содержать чувствительное содержимое запросов, отображает около 100 000 выборочных журналов за раз, может отставать до пяти минут, исключает массовые операции из выборки и анализа и может временно перестать собирать новые журналы, если кластер генерирует очень большой объём сообщений журнала. Загружаемые файлы журналов полны, но это возвращает работу команде.
Практический урок не в том, что наблюдаемость Atlas слаба. В том, что у наблюдаемости есть границы. Принятое производственное изменение данных нуждается в процедуре проверки, которая понимает эти границы. Дрейф индексов — это повторяемая обычная задача, а не исключительный инцидент. Самый сильный клиент Atlas будет рассматривать Performance Advisor и Query Profiler как свидетельства для проверки, а не как систему автоматического одобрения.
Резервное копирование — это не восстановление, пока кто-то не восстановит данные
Резервное копирование — это область, в которой управляемым сервисам чаще всего доверяют слишком сильно. Галочка говорит, что резервное копирование включено. Политика говорит, что снимки хранятся. Значок соответствия говорит, что сервис поддерживает восстановление. Затем выходит неудачный релиз, или миграция повреждает часть записей, и вопрос меняется. Может ли команда восстановить правильные данные в правильной версии, не усугубив производственный сбой?
Документация MongoDB по резервному копированию полезна, потому что она избегает фантазии, что резервное копирование само по себе равно восстановлению. В ней резервные копии определяются как копии состояния данных на момент времени. В ней говорится, что резервные копии Atlas недоступны для бесплатных кластеров. Говорится, что во время восстановления резервной копии в кластер нельзя выполнять запись. Говорится, что совместимость восстановления ограничена версией MongoDB: резервную копию можно восстановить в ту же мажорную версию с той же или более высокой минорной версией либо в следующую более новую мажорную версию, но не произвольно назад.
Также говорится, что облачные резервные копии доступны на кластерах M10+ и по умолчанию неизменяемы, а политика соответствия резервного копирования может предотвратить удаление или изменение срока хранения.
Для принятого изменения данных острый вопрос не в том, «есть ли у Atlas резервное копирование?», а в том, «отработала ли эта команда путь восстановления для того типа изменения, которое она только что приняла?». Миграция схемы, которая неправильно записывает новое поле, может потребовать выборочного исправления, а не только полного отката кластера. Изменение поискового индекса может потребовать перестроения индекса, а не восстановления данных. Неудачное развёртывание приложения может потребовать отката кода и исправления данных одновременно. Восстановление между проектами может потребовать прав в исходном и целевом проектах.
В каждом случае — свой ответственный.
Восстановление на момент времени заостряет ту же мысль. Документация по непрерывному облачному резервному копированию говорит, что функция воспроизводит oplog, чтобы восстановить кластер из конкретной точки времени в пределах настроенного окна. Также говорится, что включение непрерывного облачного резервного копирования увеличивает ежемесячную стоимость, отключение удаляет историю непрерывного резервного копирования, гранулярность в одну секунду доступна через временную метку oplog, а недавние записи, которые не полностью сохранились в oplog до начала восстановления, могут оказаться за пределами окна восстановления.
Это сильный набор функций, но это не магия. У принятого производственного изменения данных должно быть привязано требование к восстановлению: каково окно восстановления, какая роль может инициировать восстановление, какие ограничения по версиям применяются, какие данные могут оказаться за пределами окна, какой системе разрешена запись во время восстановления и как нижестоящие сервисы обработают восстановленное состояние. Без этого «у нас есть резервные копии» — просто успокаивающая фраза.
Вопрос стоимости тоже виден. Непрерывное резервное копирование увеличивает ежемесячную стоимость кластера, но в публичной документации нет универсальной цены за принятое изменение данных. Эта цена зависит от уровня, провайдера, хранилища, срока хранения, учений по восстановлению и труда, необходимого, чтобы сделать восстановление пригодным к использованию. Atlas может сделать управление резервным копированием функцией продукта. Он не заставляет экономику восстановления исчезнуть.
Права доступа — это производственная функция
Скорость базы данных легко оценить. Проектирование прав доступа легко отложить. Atlas делает эту отсрочку менее оправданной, потому что контроль доступа — явные поверхности продукта. Документация по списку IP-доступа говорит, что Atlas разрешает клиентские подключения только с записей в списке IP-доступа проекта. Также говорится, что список применяется ко всем кластерам проекта, поддерживает временные записи сроком до семи дней, имеет лимит в 200 записей в обычных случаях, регистрирует изменения в ленте активности и предупреждает, что широкие записи, такие как0.0.0.0/0, могут открыть развёртывания и вызвать поведение защиты сети или поэтапные перезапуски на подходящих кластерах.
Это делает контроль доступа частью принятого изменения данных. Новый рабочий процесс приложения, облачная миграция, экстренное подключение аналитика или временная интеграция с вендором могут быть производственным изменением данных, даже если схема не сдвинулась. Вопрос в том, разрешён ли новый путь, ограничен ли он, регистрируется ли и будет ли удалён позже. Atlas предоставляет средства контроля продукта. Клиент обеспечивает дисциплину.
Пользователи базы данных создают второй уровень разрешений. Документация по пользователям базы данных говорит, что пользователи базы данных отличаются от пользователей Atlas, роли определяют их доступ к базе данных, временные пользователи могут истечь в течение до семи дней, создание/удаление/обновления регистрируются в ленте активности, а Atlas поддерживает аутентификацию SCRAM, X.509, OIDC и AWS IAM.
Также указан максимум 100 пользователей базы данных на проект, и рекомендуется использовать более сильные методы идентификации для производственных сценариев, включая OIDC для людей и идентификацию рабочей нагрузки или роли IAM для приложений в поддерживаемых облаках.
И здесь Atlas заменяет некоторые операционные шаги, но не задачу управления. Он может показывать варианты ролей. Он может поддерживать временных пользователей. Он может регистрировать изменения. Но команда всё равно должна решить, ограничены ли пользователи приложений по сервисам, должны ли люди напрямую обращаться к производственным данным, меняются ли учётные данные, истекает ли временный доступ до того, как станет обычным, и достаточно ли хорошо настроена федерация идентификации, чтобы сократить распространение секретов.
Модель ролей Atlas также показывает, как накапливаются затраты на надзор. Документация по ролям различает Project Owner с широким контролем, Project Observability Viewer, который может видеть Performance Advisor и Query Profiler без более широких полномочий по управлению данными, Project Backup Manager, который может управлять резервным копированием и восстановлением без Data Explorer и создания кластеров, и Project Search Index Editor, который может создавать, просматривать, редактировать и удалять поисковые индексы. Такое разделение хорошо. Оно также означает, что принятое изменение данных может потребовать координации нескольких ролей.
Человек, который видит медленный запрос, может не иметь права создавать индекс. Менеджер резервного копирования может не иметь права просматривать данные приложения. Редактор поисковых индексов может не владеть политикой ранжирования продукта.
Так на практике выглядит зрелость управляемой базы данных. Трудная работа не исчезает. Она становится более формальной, более поддающейся аудиту и более распределённой.
Search и Vector Search меняют смысл корректности
Принятое изменение данных становится более тонким, когда Atlas не только хранит записи приложения, но и обслуживает поиск и выдачу. Обычный запрос часто оценивается по точности и производительности: вернул ли он правильные записи достаточно быстро? Поиск и векторная выдача добавляют ранжирование, свежесть, выбор анализатора, форму эмбеддингов и релевантность. Изменение данных может быть принято базой данных и отвергнуто продуктом, если качество выдачи падает.
Документация по производительности поисковых индексов формулирует это на операционном языке. Динамические сопоставления могут приводить к большим индексам, особенно при множестве полей или длинных строковых значениях, поэтому MongoDB рекомендует статические сопоставления для уменьшения объёма. Поисковые индексы объёмом более 2,1 млрд объектов индекса на партицию могут перестать реплицировать изменения и создавать устаревшие результаты запросов.
MongoDB Search использует кэш файловой системы и кучу JVM; mongot может конкурировать с mongod за память, CPU и дисковый ввод-вывод при совместном размещении; большие индексы и низкий объём памяти могут ухудшить производительность или привести к нехватке памяти у mongot. Записи усиливаются количеством поисковых индексов на коллекцию.
В той же документации говорится, что MongoDB Search поддерживает индексацию без простоя, сохраняя старый индекс актуальным, пока строится новый, но перестроение всё равно потребляет ресурсы и может повлиять на производительность базы данных. Также говорится, что MongoDB Search в конечном счёте согласован и не даёт более сильных гарантий согласованности: вставленные данные не сразу доступны для запросов$search, потому что Search читает потоки изменений и индексирует асинхронно. Задержка репликации, доступность ресурсов, сложность индекса и количество индексов — всё это может влиять на отставание.
Это и есть проблема принятого изменения. Продуктовая команда может добавить поле в документы и обновить интерфейс в том же релизе. Запись в базе данных может быть долговечной. Запрос приложения может выполниться. Но поиск может отставать, ранжироваться плохо или пропускать новые поля, потому что определение индекса, анализатор или сопоставление неверны. В коммерческой, поддерживающей, комплаенс- или базе знаний это не мелочь. Это корректность, видимая пользователю.
Vector Search поднимает планку ещё выше. Документация Vector Search позиционирует его для семантического поиска, гибридного поиска и дополненной генерации. Документация по типу индекса говорит, что для каждой запрашиваемой коллекции нужен индекс типаvectorSearch. В ней сказано, что векторные индексы в конечном счёте согласованы и что mongot следит за потоками изменений и обновляет хранимые копии данных. Также сказано, что Automated Embeddings — функция предварительной версии, которую не следует использовать в производстве, и что вывод эмбеддингов может выполняться в инфраструктуре MongoDB в регионе Google Cloud в США, с оплатой на основе токенов и зависимостями от API-ключей Voyage AI в некоторых конфигурациях.
Эти детали важны, потому что они выносят стоимость изменения данных за пределы движка базы данных. Команда, которая добавляет новое текстовое поле в поисковое приложение, должна думать о генерации эмбеддингов, стоимости токенов, выборе модели, размерности, полях фильтров, согласованности индекса, локальности данных и о том, достаточно ли результат хорош для задачи пользователя. Векторный индекс может работать именно так, как настроен, и всё равно быть коммерчески слабым, если извлекаемые фрагменты устарели, плохо разбиты, неверно отфильтрованы или дороги в поддержании актуальности.
Журнал изменений Search и Vector Search усиливает эту мысль. В 2026 году MongoDB добавила предварительную поддержку$vectorSearchпо массивам эмбеддингов и встроенных документов, представила storedSource для индексов Vector Search, добавила многоселектное фасетирование, предварительные плоские индексы, а также оповещения и метрики Search для лимитов полей индекса. Это активная разработка продукта. Это также предупреждение против того, чтобы считать новейшую поверхность выдачи устоявшейся инфраструктурой. Статус предварительной версии, лимиты индексов, потребности в ресурсах и скорость журнала изменений — часть теста на приём.
Потоки изменений переносят работу с опроса к интеграции
Потоки изменений — один из самых важных механизмов изменения данных в MongoDB, потому что они позволяют приложениям реагировать на изменения базы данных без ручного отслеживания oplog. Руководство MongoDB говорит, что приложения могут подписываться на изменения в коллекции, базе данных или развёртывании и фильтровать или преобразовывать уведомления через агрегационный фреймворк. Также говорится, что потоки изменений доступны для наборов реплик и шардированных кластеров с движком хранения WiredTiger, коллекции временных рядов их не поддерживают, а уведомления привязаны к долговечным изменениям, подтверждённым большинством.
Это ценно. Это может заменить опрос, пакетную сверку и класс собственного кода захвата изменений. Это может позволить нижестоящим системам быстрее и согласованнее реагировать на принятые изменения данных. Это может поддерживать событийно-ориентированные архитектуры, синхронизацию, уведомления и аналитические потоки.
Но потоки изменений не снимают ответственность за интеграцию. Документация предупреждает, что если активные потоки изменений превышают размер пула соединений, может появиться задержка уведомлений, потому что каждый поток изменений удерживает соединение открытым в ожидании следующего события. На шардированных кластерах mongos создаёт отдельные потоки изменений на каждом шарде, затем сортирует и фильтрует результаты и может выполнять поиск полного документа. MongoDB рекомендует ограничивать$lookupв потоках изменений для лучшей производительности. В руководстве также обсуждаются случаи, когда поиск fullDocument может вернуть документ, отличающийся от документа на момент исходного обновления, если более поздние операции, подтверждённые большинством, изменили его до поиска.
Таким образом, принятое изменение данных включает значение для нижестоящих систем. Недостаточно спросить, удалась ли запись. Дошло ли событие до систем, которым оно было нужно? Хватало ли ёмкости пула соединений? Изменила ли шардированная топология задержку? Вернул ли поиск правильную версию документа для бизнес-события? Обработал ли потребитель удаление, переименование или условия токена возобновления? Atlas и MongoDB могут предоставить механизм. Архитектура клиента решает, действительно ли изменение принято во всём рабочем процессе.
Это более широкий паттерн во всём Atlas. Управляемый сервис снижает примитивную рутинную работу. Он не устраняет необходимость определять, что бизнес считает завершённым.
Ценообразование — это стоимость за принятое изменение, даже если никто так не считает
Ценообразование баз данных обычно представляется как уровень кластера, хранилище, резервное копирование, передача данных, поддержка или потребление. Это понятно для закупок. Но продуктовые команды воспринимают стоимость иначе. Они воспринимают её как стоимость принятых изменений: может ли команда выпустить новую функцию, перенести данные, добавить выдачу, расширить регион, изменить доступ и оправиться от ошибок, не потратив больше человеческого и облачного бюджета, чем стоит функция?
Зафиксированные открытые данные не подтверждают точную стоимость одного принятого изменения в MongoDB Atlas. Они подтверждают категории затрат. Уровень кластера важен, потому что несколько операционных функций привязаны к кластерам M10+, включая Performance Advisor, Query Profiler, облачные резервные копии и связанные с Search возможности в исторической документации. Хранилище важно, потому что документы, индексы, резервные копии, поисковые индексы, векторные эмбеддинги и хранимые снимки потребляют ёмкость.
Вычислительные ресурсы и память важны, потому что mongod и mongot могут конкурировать за ресурсы, и для изоляции нагрузок могут потребоваться выделенные узлы поиска. Политика резервного копирования важна, потому что непрерывное облачное резервное копирование увеличивает ежемесячную стоимость кластера. Векторная выдача может добавить стоимость эмбеддингов на основе токенов и зависимости от API-ключей модели.
Человеческие затраты не менее реальны. Предложенный индекс нужно проверить. Медленный запрос нужно интерпретировать. Восстановление нужно отрепетировать. Временная запись в списке доступа должна истечь. Пользователь базы данных должен быть ограничен. Поисковое сопоставление должно оставаться достаточно статичным, чтобы избежать расползания индексов, но достаточно гибким для поддержки изменений продукта. Векторный индекс нужно оценивать на релевантность и свежесть, а не только на успешное построение.
Это не делает Atlas непривлекательным. Это делает вопрос о покупке более дисциплинированным. Для команды, которая в противном случае строила бы и эксплуатировала MongoDB сама, Atlas может устранить значительную недифференцированную работу. Для команды, которой нужно мультирегиональное развёртывание, управляемое резервное копирование, интегрированный поиск, векторная выдача и разделение ролей, управляемая поверхность может быть дешевле, чем сборка этих частей внутри.
Для небольшого приложения с умеренной сложностью запросов и низкой эксплуатационной нагрузкой премию может быть труднее оправдать, если учесть резервное копирование, поиск и затраты на проверку.
Поэтому коммерческий ответ зависит от частоты и последствий изменений. SaaS-продукт с высокой частотой изменений и множеством разработчиков может ценить Atlas, потому что каждое принятое изменение позволяет избежать индивидуальной операционной работы. Стабильная внутренняя система может больше заботиться о предсказуемой стоимости. Регулируемое приложение может платить за контроль, журналы, политику резервного копирования и выбор региона, но ему всё равно понадобится отдельный процесс утверждения.
Продукт с сильной зависимостью от ИИ может ценить совместное размещение данных и векторный поиск, но только если тестирование релевантности, стоимость эмбеддингов и локальность данных управляются.
Стоимость за принятое изменение не напечатана в счёте. Она рассчитывается в операционном обзоре.
Реальные альтернативы по-прежнему существуют
MongoDB Atlas конкурирует не только с другими управляемыми документными базами данных. Первая альтернатива — ручная работа: самоуправляемый MongoDB с внутренним владением платформой. Это может быть рационально для команд с глубокой экспертизой в базах данных, строгим контролем инфраструктуры, особыми требованиями соответствия или желанием избежать зависимости от управляемого сервиса. Стоимость в том, что команда владеет резервным копированием, мониторингом, аварийным переключением, обновлениями, настройкой безопасности и значительной частью операционного инструментария, который упаковывает Atlas.
Вторая альтернатива — реляционная платформа, включая управляемый PostgreSQL или традиционную коммерческую базу данных. Это может быть лучше, когда модель данных реляционная, транзакции охватывают множество сущностей, доминируют требования к отчётности или у команд есть десятилетия опыта работы с SQL и эксплуатацией. Стоимость — более медленное развитие схемы в некоторых областях приложений и больше трения, когда данные приложения в документной форме вынужденно помещаются в таблицы.
AWS Prescriptive Guidance по миграции на MongoDB Atlas в AWS называет исходные системы, такие как Oracle, SQL Server, MySQL, PostgreSQL, Sybase, IBM Db2, Azure Cosmos DB, Cassandra, Couchbase и Redis. Этот список полезен, потому что показывает рынок, который Atlas хочет занять, а не потому, что миграция автоматически правильна.
Третья альтернатива — другая облачно-нативная база данных, более тесно связанная с одним облачным провайдером. Это может уменьшить разнообразие вендоров и упростить идентификацию, сеть и выставление счетов внутри одного облака. Это также может усилить привязку к семантике базы данных этого облака и усложнить мультиоблачную позицию. Atlas позиционирует себя как мультиоблачный, что ценно, когда клиенты хотят общий слой базы данных у разных провайдеров, но мультиоблачность сама добавляет проектные и стоимостные решения.
Четвёртая альтернатива — построить слой поиска и векторной выдачи отдельно: Elasticsearch или OpenSearch для поиска, специализированная векторная база данных, слой выдачи в хранилище/озере данных или стек выдачи от провайдера моделей. Это может иметь смысл, когда выдача — главный дифференциатор продукта. Преимущество Atlas — интеграция с операционными данными. Его слабость в том, что интегрированность не означает автоматически лучший в своём классе результат для каждой потребности в поиске, ранжировании, векторах или оценке.
Пятая альтернатива — делать меньше. Многим командам не нужен Vector Search. Многим командам не нужно динамическое сопоставление поиска. Многим командам не нужно непрерывное восстановление на момент времени для каждого окружения. Хороший покупатель Atlas должен сопротивляться покупке каждой функции только потому, что она находится рядом с данными. Принятое производственное изменение данных должно определять функцию, а не наоборот.
Что могло бы изменить оценку
Самым сильным публичным аргументом в пользу MongoDB Atlas были бы доказательства, измеренные на уровне принятого изменения. Как часто предложенные индексы принимаются? Как часто они снижают стоимость чтения, не нанося вреда записи? Каково медианное время восстановления для проверенного клиентами восстановления на момент времени в зависимости от размера кластера? Как часто перестроение поисковых индексов влияет на задержку приложения? Какой процент развёртываний Vector Search использует безопасные для производства пути эмбеддингов вместо предварительных функций?
Как часто средства контроля списков доступа и временных пользователей предотвращают остаточную уязвимость? Сколько стоит каждое принятое изменение данных с учётом хранилища, резервного копирования, поиска, эмбеддингов и труда?
Этих цифр нет в зафиксированных открытых данных. Их отсутствие не опровергает Atlas. Оно ограничивает определённость. Публичная документация необычно ясна в отношении многих эксплуатационных оговорок: границы функций M10+, выборка журналов, чувствительность содержимого запросов, ограничения версий резервного копирования, ограничения записи при восстановлении, область действия списка доступа, поведение временных пользователей, конечная согласованность Search, согласованность векторных индексов, локальность эмбеддингов, оплата токенов и предупреждения о предварительных версиях. Эта ясность помогает серьёзным покупателям.
Она также не позволяет сделать упрощённый вывод, что управляемая база данных означает управляемый результат.
Текущий публичный статус добавляет лишь узкий пункт. API статуса MongoDB Cloud вернул «Все системы работают» на момент проверки. Это полезный публичный операционный сигнал. Он ничего не говорит о конкретном кластере клиента, плане восстановления, форме запроса, векторном индексе, правиле доступа или миграции данных. Страница статуса — это не проверка принятого изменения.
Та же осторожность относится к историям клиентов. История Bendigo and Adelaide Bank описывает банк с примерно 7 000 сотрудников и более чем 2,2 млн клиентов, использующий Atlas в многолетней трансформации, с заявленной вендором событийно-ориентированной средой, сэкономившей более 1 100 человеко-дней разработчиков. Это значимый сигнал спроса. Это не аудированный знаменатель для всех клиентов Atlas.
Что изменило бы оценку — не более громкое заявление о запуске. Это доказательства того, что Atlas последовательно снижает общую стоимость принятых изменений с учётом сбоев, исключений, восстановлений, свежести поиска и ручной проверки.
Вывод
MongoDB Atlas не следует оценивать по первому кластеру. Его следует оценивать по десятому производственному изменению данных после того, как схема изменилась, смесь запросов поменялась, набор индексов вырос, окно резервного копирования было проверено, права доступа пересмотрены, а путь поиска или векторной выдачи проверен на свежесть и релевантность.
По этому стандарту продукт убедителен, но не доказывает себя сам. Atlas явно устраняет инфраструктурную работу, которую многие команды приложений не должны делать вручную. Он даёт разработчикам и платформенным командам управляемую поверхность базы данных с развёртыванием, мониторингом, резервным копированием, контролем доступа и поиском. Он показывает многие правильные средства контроля и предупреждения. За ним стоит коммерческий масштаб многомиллиардной группы MongoDB.
Сложность в том, что оставшаяся работа — это именно та работа, которая определяет бизнес-последствия. Отсутствующий индекс становится задержкой. Слишком много индексов становятся стоимостью записи. Резервная копия без отработанного восстановления становится ложным спокойствием. Широкая запись в списке доступа становится уязвимостью. Отстающий поисковый индекс становится устаревшим пользовательским опытом. Векторный конвейер, который эмбеддит не то поле, использует предварительную функцию или отправляет данные через неожиданный регион, становится проблемой продукта и управления.
Это не провал Atlas. Это природа управляемой инфраструктуры данных. Чем лучше платформа устраняет трение при настройке, тем больше покупатели должны измерять оставшуюся работу. История Atlas в MongoDB Limited сильнее всего, когда покупатель считает не созданные кластеры, а принятые изменения данных с сохранением производительности, надёжности, контроля доступа, восстановления и качества выдачи.