
Кратко
- ISC публикует BIND 9 и Kea, документацию, релизы, каналы поддержки, рекомендации по безопасности и несколько путей распространения программного обеспечения.
- Эти материалы доказывают наличие механизмов и средств исправления, но сами по себе не доказывают, что конкретный оператор установил исправление, восстановил зависимые службы или проверил результат в рабочей среде.
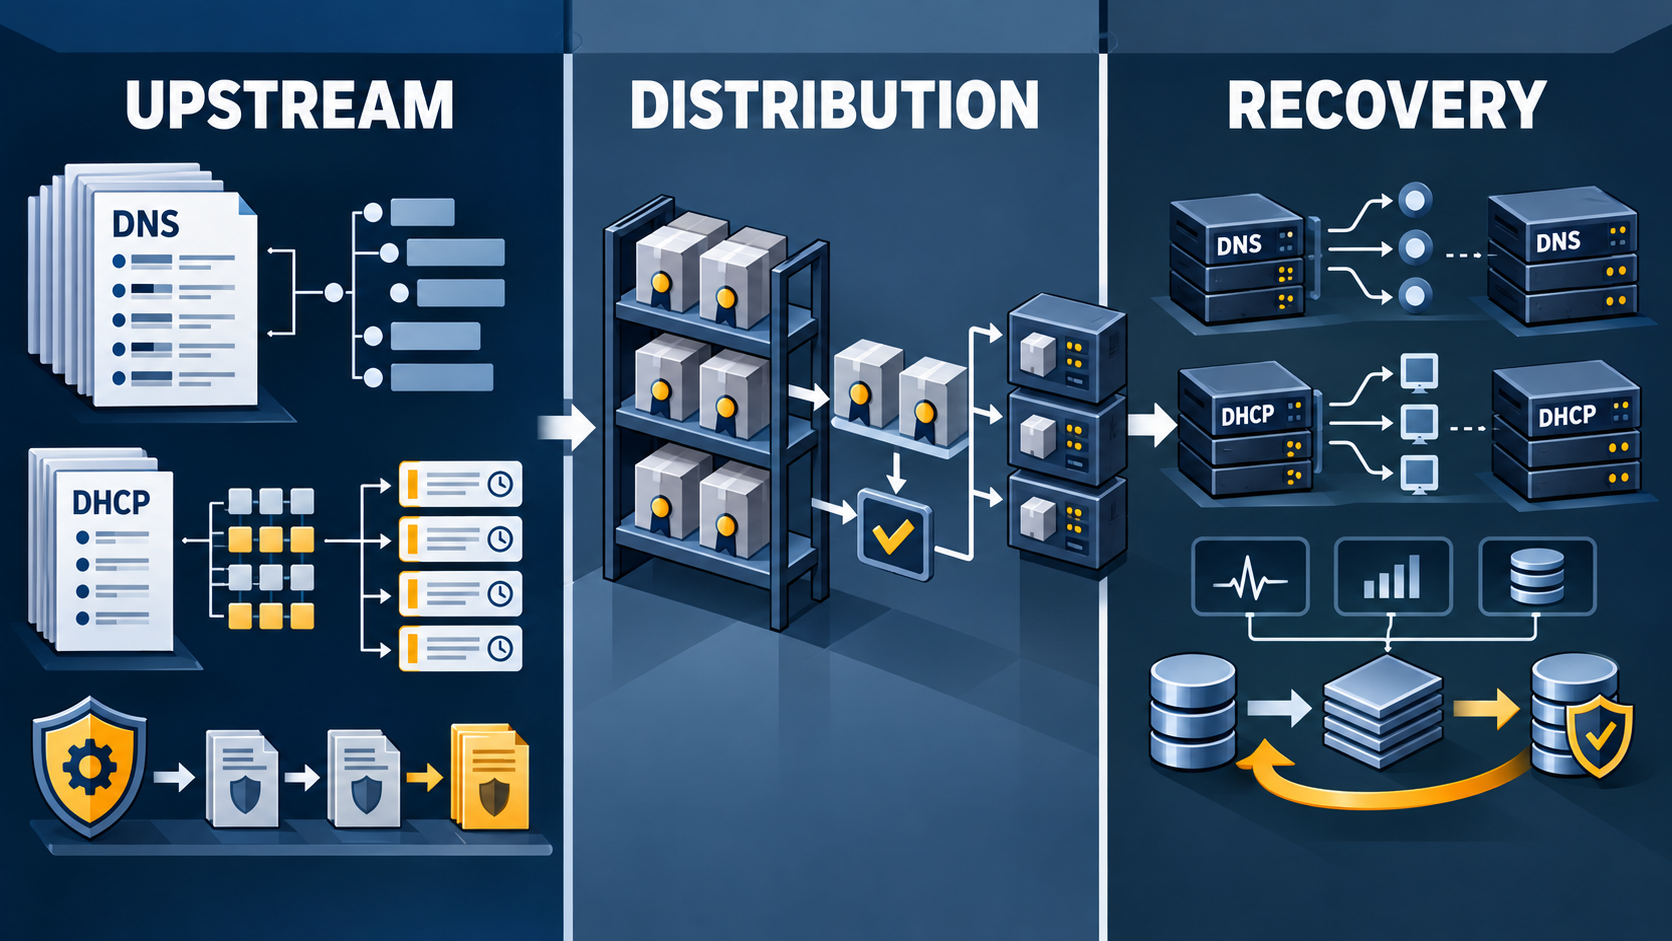
DNS и DHCP редко зависят только от одного демона. Для BIND непрерывность может включать конфигурацию, данные зон, динамические обновления, ключи DNSSEC, журналы, мониторинг и проверенные процедуры восстановления. Для Kea к этому добавляются Control Agent, hook-библиотеки, DHCP-DDNS, хранилище аренд, базы данных, связь между узлами высокой доступности и защита API. Поэтому вопрос о том, «исправлена ли уязвимость», и вопрос о том, «восстановлена ли услуга», относятся к разным уровням доказательств.
Что именно контролирует ISC
ISC представляет BIND 9 как открытое DNS-программное обеспечение и поддерживает каналы продукта, загрузок, документации, поддержки и безопасности (описание BIND 9, загрузки ISC, поддержка). Для Kea ISC описывает платформу DHCPv4 и DHCPv6 с модульными компонентами и операционными интерфейсами (страница Kea, введение в руководство Kea). Это реальная зона ответственности: поддерживать код, публиковать документацию, выпускать версии и сообщать об исправлениях.
Однако из неё не следует прямой контроль над каждым сервером, пакетом или контейнером. Оператор может получать программное обеспечение из исходных релизов, репозиториев пакетов, контейнеров или downstream-дистрибутивов. ISC отдельно показывает репозитории Cloudsmith и контейнер BIND 9 (репозитории Cloudsmith, образ BIND 9, организация Docker). Наличие этих каналов создаёт путь к внедрению, но не показывает, какой из них использован конкретной организацией.
Где возникает разрыв между релизом и эксплуатацией
Теги BIND и Kea в исходных репозиториях дают запись о публикации версий (теги BIND, теги Kea). Но существование тега не доказывает ни статус поддержки, ни установку версии оператором. Пакет downstream может появиться позже, иметь другой номер или содержать backport исправления. Поэтому upstream-номер нельзя механически приравнивать к версии, реально работающей в Debian или другой системе.
Пакетные записи Debian и security tracker помогают разделить эти уровни (пакет BIND в Debian, security tracker BIND, пакет ISC Kea, security tracker Kea). Они показывают состояние упаковки и исправлений в downstream-контексте, но не подтверждают, что конкретный оператор установил пакет, перезапустил службу, обновил все связанные компоненты или проверил отсутствие регрессий.
Исправление уязвимости — не то же самое, что восстановление
ISC публикует рекомендации и матрицы уязвимостей, где указываются затронутые и исправленные линии программного обеспечения (рекомендации по безопасности, служебное уведомление, матрица BIND, матрица Kea). Национальные и отраслевые базы также могут отражать записи по BIND и Kea (поиск уязвимостей BIND, поиск уязвимостей Kea). Это позволяет установить, что исправление опубликовано или что определённая ветка требует внимания.
Но upstream-коррекция не устанавливает downstream-развёртывание и восстановление. Для доказательства результата нужны как минимум: идентификация фактически используемой версии, получение и проверка подлинности исправления, его установка по всей цепочке зависимостей, перезапуск или иная активация изменения, а затем проверка поведения сервиса. Если инфраструктура использует резервный узел, базу данных, внешнюю систему мониторинга или DNSSEC-ключи, проверка только основного процесса будет недостаточной.
Почему архитектура зависимостей важнее рекламного описания функции
Документация BIND описывает эксплуатационные и конфигурационные аспекты DNS-сервера (документация BIND, заметки о версиях BIND). В реальной системе непрерывность зависит от того, как организованы authoritative- и recursive-роли, где хранятся зоны, как выполняются динамические обновления, где находятся ключи DNSSEC и как подтверждается восстановление после сбоя. RFC по эксплуатации DNS подчёркивают значение резервирования, управления изменениями и процедур восстановления (RFC 2182, RFC 6781).
У Kea набор зависимостей ещё более явно вынесен в интерфейсы. Руководство описывает Control Agent, динамический DNS, hook-библиотеки, высокую доступность и базы данных аренд (быстрый старт Kea, hook высокой доступности, база данных аренд). DHCP-сервис может продолжать работу только при согласованности между демонами, хранилищем аренд, peer-коммуникацией, API и внешним мониторингом. RFC 2131 задаёт базовый протокол DHCP, но не доказывает, что конкретная реализация или организация выдерживает отказ и последующее восстановление (RFC 2131).
Что означает цепочка распространения
Цепочку можно описать так: ISC поддерживает исходный проект и публикует информацию; дистрибьютор формирует пакет, контейнер или backport; оператор выбирает канал, внедряет его в собственную конфигурацию и проверяет результат. Каждый переход добавляет собственную неопределённость.
На первом переходе важны полнота advisory, доступность исправленной ветки и понятность документации. На втором — время упаковки, политика поддержки, различия версий и наличие backport. На третьем — инвентаризация, локальные изменения, расписание обслуживания, доступ к резервным компонентам и процедура отката. Только последний переход может показать, восстановилась ли конкретная услуга. Публичные страницы ISC, репозитории и записи трекеров позволяют наблюдать первые два уровня, но не дают публичного знаменателя внедрений или универсального показателя времени переключения.
Это не доказательство неудачи ISC. Отсутствие публичных данных об инциденте, масштабе внедрения или времени восстановления остаётся неопределённостью. Но именно поэтому нельзя превращать наличие механизма высокой доступности или опубликованного исправления в утверждение о достигнутом результате.
Как выглядело бы достаточное доказательство
Для отдельной организации убедительная запись должна связать четыре элемента. Во-первых, инвентарь: какие версии BIND, Kea, пакетов, контейнеров, hook-библиотек, баз данных и конфигураций действительно работали. Во-вторых, цепочку исправления: какой advisory или релиз применён, откуда он получен и как проверена его подлинность. В-третьих, изменение: какие процессы, узлы и зависимости обновлены, перезапущены или переведены в новый режим. В-четвёртых, проверку: какие тесты подтвердили DNS-ответы, выдачу DHCP-адресов, синхронизацию, переключение, возврат к штатному режиму и сохранность данных.
Для BIND это может включать проверку authoritative-ответов, рекурсии, динамических обновлений, DNSSEC и восстановления зон. Для Kea — выдачу аренд, состояние peer-узлов, lease database, работу Control Agent, DHCP-DDNS и поведение при отказе. Без этих наблюдений можно доказать, что исправление доступно, но нельзя доказать, что организация восстановила сервис.
Граница ответственности
Роль ISC — сделать исправление, документацию и каналы получения доступными и проверяемыми. Роль дистрибьютора — корректно упаковать, сопровождать и обозначить downstream-состояние. Роль оператора — знать собственную конфигурацию, выбрать применимый артефакт, развернуть его по цепочке зависимостей и проверить восстановление.
Эта граница важна и для оценки риска. Чем больше операторов получают программное обеспечение через разные каналы, тем меньше одного публичного upstream-релиза достаточно для оценки фактической экспозиции. А чем больше эксплуатационных функций вынесено в API, базы, hooks и peer-связи, тем меньше тест одного процесса говорит о состоянии всей услуги.
Источники и границы доказательств
Использованные материалы включают официальные страницы BIND и Kea, документы ISC по загрузкам, поддержке и безопасности, upstream-теги, руководства Kea (руководство Kea), репозитории контейнеров и Cloudsmith, записи Debian и security tracker, базы уязвимостей и RFC. Дополнительный контекст по сетевой эксплуатации предоставлен материалами NIST (NIST SP 800-81). Эти источники подтверждают опубликованные механизмы, каналы распространения и различия между upstream и downstream. Они не подтверждают масштаб развёртываний, универсальное принятие исправлений, конкретную конфигурацию оператора, измеренное время failover или устойчивое восстановление после неназванного инцидента.
Обзор для участников
Подробный контекст профиля
Войдите с подходящим уровнем подписки, чтобы открыть полный обзор и примечания к источникам.
Только для Стратегического сообщества
Стратегическое сообщество
Открыто всем читателям. Вступите и войдите, чтобы открыть обзоры профилей.
Вступить в Стратегическое сообществоТолько для Альянса лидеров
Альянс лидеров
Для проверенных владельцев IP-активов и руководителей. Войдите, чтобы открыть обзоры Альянса.
Вступить в Альянс лидеров