
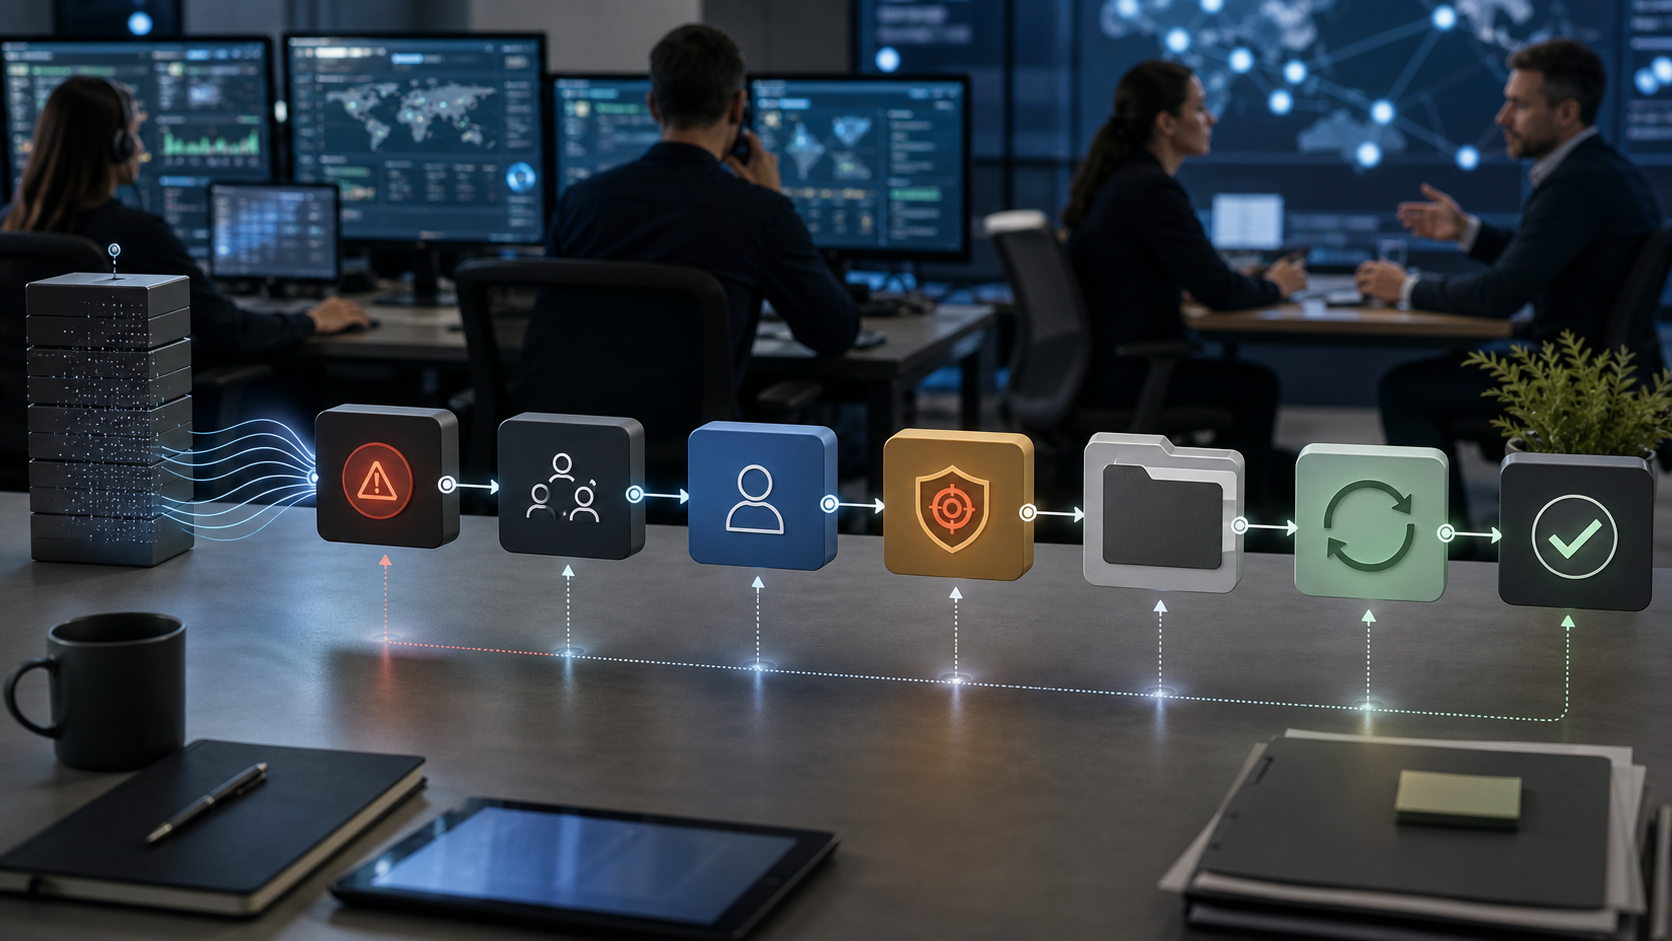
Резюме
- Arctic Wolf наиболее силён, когда его управляемые операции превращают телеметрию, триаж аналитиков, контекст экспозиции и знания о конкретном заказчике в действия по безопасности, которые ИТ-команда или команда безопасности заказчика действительно может принять, назначить, выполнить и впоследствии отстоять.
- Публичные материалы подтверждают широкую модель управляемых операций безопасности — от MDR и управления экспозицией до облачного обнаружения, реагирования на инциденты, защиты конечных точек и сервисов повышения осведомлённости, — но не доказывают независимо универсальное время реакции, точность обнаружения, полноту устранения или экономику для заказчика.
Полезная единица — не оповещение, а принятое действие
Самый полезный способ оценить Arctic Wolf — не спрашивать, может ли он сформировать оповещение управляемого обнаружения и реагирования. Так умеют многие вендоры безопасности. Более сложный вопрос — может ли Arctic Wolf провести заказчика от сигнала к принятому действию: изолировать этот хост, сбросить эту учётную запись, установить заплатку на эту систему, отключить эту учётную запись, заблокировать этот маршрут, позвонить этому владельцу, сохранить эти улики, переоткрыть этот тикет, проверить, что экспозиция закрыта, или эскалировать инцидент, потому что заказчик действовал недостаточно быстро.
Это различие важно, потому что управляемую безопасность часто покупают, чтобы закрыть операционный разрыв, а не только технологический. Компания может уже владеть инструментами для конечных точек, облачными журналами, оповещениями об учётных записях, сканерами уязвимостей и защитой почты — и всё равно провалиться в тот момент, когда кто-то должен решить, что делать. Оповещение может быть неоднозначным. Владелец актива может быть неясен. У команды безопасности может не быть полномочий менять производственные системы. Служба поддержки может видеть тикет, но не понимать риск.
Вендор может эскалировать, но заказчик может воспринять эскалацию как очередную рекомендательную записку. Страница, полная обнаружений, не снижает риск, если никто не принимает следующий шаг.
Нынешняя публичная история Arctic Wolf строится вокруг именно этого операционного разрыва. В ней описывается управляемая модель, в которой телеметрия безопасности собирается из внутренних сетей, внешних сетей, конечных точек и облачных сред; обогащается данными об угрозах, данными из открытых источников, сведениями об уязвимостях и контекстом захвата учётных записей; а затем расследуется выделенной командой Concierge Security Team и более широкой организацией операций безопасности. На страницах продуктов сервис также позиционируется как партнёрская модель, а не просто развёртывание инструментов. Это правильная рамка для данного сегмента.
Покупатели управляемого обнаружения обычно не просят вендора добавить ещё одну панель мониторинга. Они просят помощи, чтобы превратить разрозненные сигналы в повторяемую работу.
Сложность в том, что «повторяемая работа» — именно то место, где управляемая безопасность может разочаровать. Если у Arctic Wolf есть видимость, но недостаточно контекста, он может присылать шумные или шаблонные тикеты. Если есть контекст, но нет полномочий, он может знать правильное действие, но всё равно ждать заказчика. Если есть полномочия, но слабый контроль отката или согласования, он может создать операционный риск. Если тикеты закрываются без доказательств, что экспозиция устранена, у заказчика может возникнуть ощущение активности без снижения риска. Поэтому принятое действие — более строгий тест, чем обнаружение.
У принятого действия есть несколько свойств. Оно называет затронутый актив, учётную запись, пользователя, уязвимость или бизнес-процесс. Оно объясняет, почему действие нужно сейчас, а не позже. Оно отделяет подтверждённые факты от суждений об уверенности. Оно называет владельца следующего шага. Оно фиксирует, может ли Arctic Wolf выполнить действие, рекомендовать его, координировать его или только наблюдать за ним. Оно фиксирует подтверждение заказчика. Оно оставляет доказательства, которые позже может проверить рецензент. Оно содержит путь для исключения, отката или эскалации, если действие оспаривается.
Именно через эту призму следует оценивать Arctic Wolf. Компания построила достаточно широкий публичный портфель, чтобы покрыть триаж оповещений, приоритизацию экспозиций, мониторинг облака, синхронизацию тикетов, реагирование на инциденты, обучение по повышению осведомлённости и защиту конечных точек. Вопрос не в том, существуют ли эти ярлыки. Вопрос в том, воспринимает ли заказчик в ежедневной работе их как единый согласованный процесс действий.
Управляемый SOC проваливается, когда ответственность исчезает между обнаружением и устранением
У управляемого обнаружения и реагирования есть встроенная проблема владения. Вендор может мониторить и расследовать, но заказчик обычно владеет средой, бизнес-риском, учётными данными, решениями о простое и финальным устранением. Эту границу не обойти. Именно здесь многие программы MDR теряют ценность.
Возьмём сигнал о краже учётных данных. Arctic Wolf может увидеть аномальную аутентификацию, облачную активность, поведение конечной точки, подозрительную почту или связанный паттерн в аналитике угроз. Платформа и аналитики могут обогатить сигнал, назначить срочность и открыть кейс. Но действие может потребовать от заказчика сбросить пароли, отключить учётные записи, отозвать сеансы, проверить правила почтового ящика, изучить облачную активность, уведомить владельца бизнес-процесса или скоординироваться с юридическим отделом и отделом коммуникаций.
Если заказчик заранее не договорился, кто может санкционировать какие действия, обнаружение может быть корректным и всё равно прийти слишком поздно, чтобы иметь значение.
Та же проблема появляется в работе с уязвимостями и экспозицией. Материалы Arctic Wolf по управлению экспозицией подчёркивают видимость активов, управление уязвимостями, управление поверхностью атак, приоритизацию, рекомендации по устранению, интеграцию с системами управления ИТ-услугами, настраиваемые целевые показатели устранения и валидацию. Это именно то, к чему должно идти управление экспозицией. Сам по себе список уязвимостей — не действие по безопасности.
Принятое действие — это сочетание приоритета, владельца, срока, пути установки заплатки или компенсирующих мер, обработки исключений и доказательств того, что экспозиция действительно изменилась.
Это делает готовность заказчика частью уравнения ценности продукта. Заказчик со зрелым владением активами, контролем конечных точек, управлением идентификацией, дисциплиной установки заплаток и чёткими правилами эскалации извлечёт из Arctic Wolf больше пользы, чем заказчик с неполным реестром активов и группами ИТ, которые оспаривают каждый срочный тикет. Arctic Wolf может снизить нагрузку по координации, но не может заставить организацию принимать действия, которые она структурно неспособна выполнить.
Модель Concierge призвана решить эту задачу: за заказчиком закрепляются персональные консультанты по безопасности, которые понимают его среду и обеспечивают стратегию, оценку состояния защищённости, отчётность, поддержку комплаенса и поддержку устранения. В публичных материалах FAQ говорится, что Concierge Security Team занимается триажом оповещений, приоритизацией рисков и заплаток, поддержкой устранения, отчётностью, комплаенс-активностями, рекомендациями и стратегическим руководством. Это важно, потому что принятое действие часто не является разовым решением аналитика.
Оно зависит от накопленных знаний о системах заказчика, терпимости к сбоям, бизнес-календаря и предыдущих исключений.
Но персональные консультанты ценны только в том случае, если их используют, чтобы делать действия более точными. Покупатель должен спросить, как Arctic Wolf фиксирует специфичный для заказчика контекст, как этот контекст попадает в триаж, как часто пересматриваются плейбуки и как удаляются устаревшие допущения. Персональная команда становится преимуществом, когда она знает, что конкретный сервер критичен для бизнеса, что домен определённого поставщика легитимен, что один завод не может перезагружаться в производственное окно или что у конкретной системы учётных записей есть известный путь миграции.
Она превращается в театр, если тикет по-прежнему выглядит как общая рекомендация.
Ответственность должна быть видна и в отчётности. Полезный отчёт управляемого SOC не должен просто подсчитывать оповещения или инциденты. Он должен показывать, какие действия были рекомендованы, какие приняты, какие выполнены, какие сорвали сроки, какие были осознанно приняты бизнесом как риск и какие повторились, потому что первопричина не была устранена. Без такого учёта действий и вендор, и заказчик могут выглядеть занятыми, пока одни и те же риски циркулируют в очереди.
Качество телеметрии — первое ограничение для всех последующих решений
В документации Arctic Wolf по MDR описывается телеметрия безопасности из сетей, конечных точек и облачных сред, обогащённая потоками данных об угрозах, данными OSINT, информацией о CVE, данными о захвате учётных записей и другим контекстом. В документации по облачному обнаружению перечислен широкий круг поддерживаемых интеграций: SaaS, идентификация, инфраструктура, почта, сети и средства безопасности, включая облачные платформы, поставщиков удостоверений, инструменты SASE и источники почтовой безопасности. В открытых материалах также подчёркнут открытый XDR-подход, актуальные интеграции и обработка событий в больших масштабах.
Эта широта важна, но широта телеметрии — не то же самое, что её качество. В управляемых операциях первая точка отказа часто — неполная или плохо нормализованная видимость. Если охват конечных точек частичный, журналы идентификации задерживаются, облачные сенсоры настроены неверно, сетевые сенсоры пропускают ключевые пути или в данных тикетов не сохраняются нужные поля, аналитик видит искажённую картину. Слабый сигнал может уйти в триаж с низким приоритетом, потому что недостающий элемент так и не был собран. Тикет высокой серьёзности может быть излишне эскалирован, потому что системе не хватает бизнес-контекста.
Экспозиция может выглядеть закрытой, потому что сканер больше её не видит, хотя актив переместился или контроль сломался.
Именно поэтому подключение и техническая готовность значат больше, чем обычно признаёт маркетинг. На страницах продуктов Arctic Wolf упоминаются настройка сервиса, техническая готовность и настройка необходимых журналов как часть поставки MDR. Это не административные формальности; это часть контроля. Первоначальное решение о том, какие журналы собираются, как сопоставляются учётные записи, как называются активы, как группируются конечные точки, как ограничиваются облачные аккаунты и как маршрутизируются оповещения, определяет качество каждого последующего действия.
Покупатель должен относиться к настройке телеметрии как к совместному проектированию безопасности, а не как к контрольному списку закупки. Какие сигналы обязательны, а какие нет? Какие интеграции дают поток событий в реальном времени, а какие — отложенные пакетные данные? Какие источники могут запускать локализацию или реагирование на учётные записи, а какие дают только контекст? Как обнаруживаются вышедшие из строя коллекторы? Кто отвечает за починку сломанного приёма данных? Видны ли пробелы в источниках журналов в ежемесячных обзорах?
Как команда Arctic Wolf узнаёт, что сенсор не работает, срок действия учётных данных API истекает или заказчик добавил новый облачный тенант вне контролируемого периметра?
Публичные обновления продукта показывают, что Arctic Wolf продолжает добавлять поверхности данных и действий, включая поддержку дополнительных источников мониторинга облака и учётных записей, сервисы уведомлений об утечках учётных данных, API для стоп-листов и отчётов, а также функции Data Explorer. Эти обновления — хороший знак активно развиваемой платформы, но они также показывают, почему сопровождение интеграций — постоянная задача. Каждый новый источник, API, право доступа или функция отчётности добавляет потенциальную ценность только в том случае, если среда заказчика поддерживается в актуальном состоянии.
Телеметрия связана и с качеством доказательств. Когда аналитик рекомендует локализацию или устранение уязвимости, заказчику нужно видеть основания для этого действия. Расплывчатое «наблюдалось подозрительное поведение» менее полезно, чем кейс, в котором видно, какая учётная запись изменилась, какой хост общался, какой облачный сервис зафиксировал действие, какая уязвимость эксплуатируется в реальных атаках, какой актив подвержен риску и какой бизнес-сервис может пострадать. Чем конкретнее доказательства, тем проще заказчику принять рекомендацию и быстро её выполнить.
Поэтому центральный вопрос статьи начинается до оповещения. Arctic Wolf может превратить сигнал в принятое действие, только если сигнал приходит с достаточным охватом, свежестью, сопоставлением учётных записей и контекстом активов, чтобы действие можно было защитить.
Триаж должен снижать шум, не скрывая неопределённость
На странице MDR сказано, что сервис призван давать результаты, а не больше оповещений. В открытых материалах описаны триаж, расследования, действия по реагированию, превентивные обзоры состояния защищённости, специфичный для заказчика контекст и модель, в которой автоматизированный анализ сочетается с проверкой человеком. Это правильная цель, потому что пересылка оповещений — одна из наименее ценных форм управляемой безопасности. Если провайдер просто отправляет заказчику всё, он передаёт ему шум, а не снижает риск.
Триаж создаёт ценность, когда превращает сырые события в небольшое число объяснимых кейсов. Он должен связывать связанные сигналы, отсекать известное безвредное поведение, выявлять наиболее правдоподобный путь атаки, сохранять альтернативные объяснения и назначать срочность. Он также должен делать неопределённость явной. Кейс редко бывает либо полностью подтверждённым, либо бессмысленным. Хорошая запись триажа говорит, что известно, что подозревается, чего не хватает, какое действие рекомендуется и что изменило бы рекомендацию.
Публичные примеры Arctic Wolf здесь полезны — особенно таймлайны реагирования на инциденты. Они показывают форму процесса, в котором сигнал обнаруживается, сопоставляется с другой активностью, эскалируется в триаж, локализуется или устраняется, а затем продолжается дополнительной работой по усилению защиты. Эти таймлайны не следует читать как универсальное обещание времени реакции. Это отобранные примеры. Их более важный урок процедурный: действие становится заслуживающим доверия, когда кейс связывает источник, доказательства, эскалацию, устранение и последующее укрепление.
Риск в том, что язык ИИ и автоматизации может сделать триаж более определённым, чем он есть. Arctic Wolf описывает платформу Aurora со специализированной автоматизацией, контекстом заказчика, графом операций безопасности (Security Operations Graph), ограничителями, журналированием, откатом и согласованием человеком для действий с высоким влиянием. Компания также говорит, что человек остаётся в контуре для суждений, надзора и критических решений. Эта оговорка — не слабость; она в центре доверия. В операциях безопасности скорость без суждения может приводить к дорогим ошибкам.
Ложная локализация, ошибочное отключение учётной записи или плохо выбранный момент установки заплатки могут нарушить бизнес.
Тест принятого действия спрашивает, улучшает ли автоматизация способность аналитика действовать, а не заменяет ли она подотчётность. Собирает ли автоматизация доказательства быстрее? Сокращает ли дублирующую работу? Находит ли похожие кейсы? Готовит ли тикет, который человек может проверить? Предлагает ли устранение с указанием уверенности и оговорок? Фиксирует ли, почему действие было выполнено или отложено? Предотвращает ли выполнение низкодоверенных или необратимых действий без проверки?
Заказчикам следует искать качество триажа в повседневных артефактах, а не только в описаниях платформы. Качественный кейс Arctic Wolf должен быть читаемым и для руководителя безопасности заказчика, и для ИТ-владельца, и для аудитора. Он должен рассказывать связную историю. В нём должны быть названы затронутые системы. Должно быть видно, почему рекомендуемое действие соразмерно. Следует отличать подтверждённую компрометацию от подозрительной активности. Нужно сохранять достаточно метаданных для последующего поиска.
Нельзя закрывать цикл фразой «мониторинг продолжается», когда у заказчика по-прежнему непропатченная система, открытый сервис или нерешённая проблема с учётными записями.
Снижение шума нужно измерять локально. Если Arctic Wolf обещает снизить нагрузку оповещений, заказчик должен сравнить рабочую нагрузку до сервиса с очередью действий после него. Сколько оповещений стало тикетами? Сколько тикетов потребовало работы заказчика? Сколько было ложными срабатываниями? Сколько было переоткрыто? Сколько стало кейсами реагирования на инциденты? Сколько привело к документированному изменению контроля? Полезное измерение — не абсолютное число обработанных вендором событий. Это число валидных действий, которые заказчик может выполнить, не утонув в исключениях.
Полномочия на реагирование — ключевой момент между рекомендацией и снижением риска
В FAQ Arctic Wolf сказано, что адресованные заказчику эскалации и действия с высоким влиянием включают надзор и согласование человека, а действия по реагированию выполняются в определённых границах. В документации также упоминаются Active Response и аналитика конечных точек в составе лицензии MDR, а в обновлениях продукта перечислены конкретные интеграции для действий с учётными записями в поддерживаемых сервисах. Именно здесь управляемый сервис переходит от рекомендаций к вмешательству.
Полномочия на реагирование нужно согласовывать с осторожностью. Слишком мало полномочий — и вендор присылает рекомендации, которые лежат в очереди заказчика. Слишком много — и появляется операционный и юридический риск. Управляемый провайдер безопасности может знать, что отключение учётной записи — самое безопасное кибердействие, но заказчик может знать, что на этой учётной записи работает критический процесс. Вендор может рекомендовать изолировать хост, но хост может находиться в производственной цепочке, где простой дороже, чем краткосрочный мониторинг.
Вендор может настаивать на экстренной установке заплаток, но у заказчика может быть заморозка изменений с регуляторными или связанными с безопасностью последствиями.
Правильная модель не просто «больше автоматизации». Это уровневые полномочия. Низкорисковые действия могут быть предварительно санкционированы. Среднерисковые могут требовать подтверждения заказчика в определённом окне. Действия с высоким влиянием могут требовать явного согласования, эскалации на именованные роли и плана отката. Во всех случаях система должна фиксировать, кто санкционировал действие, какие доказательства его поддержали, что было сделано и как результат был проверен.
Публичный акцент Arctic Wolf на ограничителях, минимальных привилегиях, разрешениях, мониторинге, журналировании, объяснимости, откате и человеческом согласовании для действий с высоким влиянием соответствует этой модели. Покупателю всё равно нужно проверить, как эти контроли работают в реально приобретаемом пакете услуг. Страница продукта может описывать философию дизайна, но контракт, интеграции и операционные регламенты заказчика определяют реальную границу полномочий.
Частая точка отказа — неясная ответственность за локализацию. Если Arctic Wolf обнаруживает подозрительную активность на конечной точке, может ли он изолировать хост? Доступна ли эта функция в лицензии заказчика? Зависит ли она от ПО Arctic Wolf для конечных точек, от стороннего инструмента конечных точек или от обоих? Кто одобряет изоляцию? Как обрабатывается исключение для бизнес-критичного хоста? Как восстанавливается хост? Что происходит, если изоляция не срабатывает? Как о сбое сообщают команде заказчика?
Реагирование на учётные записи вызывает аналогичные вопросы. Если подозрительная активность связана с поставщиком удостоверений или облачным аккаунтом, может ли Arctic Wolf отключить пользователя, удалить группы, сбросить учётные данные или принудительно провести повторную аутентификацию? Публичные обновления продукта показывают движение в этом направлении для конкретных интеграций, но доступность интеграции — не то же самое, что операционная готовность. Команда заказчика по учётным записям должна знать, какие действия разрешены, какие требуют согласования и как экстренные изменения сверяются с обычным управлением учётными записями.
Реагирование на инциденты добавляет ещё одну границу. Arctic Wolf предлагает сервисы реагирования на инциденты и готовности к ним, включая восстановление, устранение последствий серьёзных инцидентов и компьютерную криминалистику. В крупном событии принятое действие может быть уже не отдельным тикетом. Оно может включать восстановление бизнеса, сохранение улик, взаимодействие с юристами, коммуникации, страховку, переговорную стратегию и план укрепления после инцидента. Вендор может направлять или выполнять части этой работы, но бизнес-решения остаются за заказчиком.
Самые ценные управляемые отношения — те, в которых эти роли прояснены до инцидента.
Полномочия на реагирование — ключевой момент коммерческого обещания. Обнаружение находит риск. Триаж объясняет его. Полномочия определяют, может ли сервис его снизить.
Управление экспозицией ценно, только когда находки доводятся до закрытия
Материалы Arctic Wolf по управлению экспозицией представляют расширенный охват: видимость активов, управление уязвимостями, управление поверхностью атак, приоритизацию, устранение, валидацию, управление заплатками через Resolve, интеграции с ITSM, рекомендации на базе ИИ, настраиваемые целевые показатели устранения и отчётность по запросу. Направление коммерчески разумное. Многие организации терпят неудачу не потому, что им не хватает находок об уязвимостях. Они терпят неудачу, потому что не могут понять, какие находки важны, какие активы реальны, кто ими владеет и было ли выполнено исправление.
Принятое действие в управлении экспозицией отличается от принятого действия в MDR. Кейс обнаружения обычно просит заказчика отреагировать на предполагаемую или подтверждённую угрозу. Кейс экспозиции просит заказчика снизить вероятность или радиус поражения будущей угрозы. Поэтому его легче откладывать. Критическая уязвимость на сервисе, доступном из интернета, может получить действие. Неправильная конфигурация в менее заметной системе может лежать неделями. Устаревший актив может оспариваться. Заплатка может сломать приложение. Сканер может продолжать сообщать о находке, даже когда обходное решение уже внедрено.
Лучший путь Arctic Wolf — связать работу с экспозицией с операционным контекстом. В открытых страницах сказано, что Aurora Vulnerability Management обогащает находки контекстом активов, данными об угрозах и вероятностью эксплуатации, а Attack Surface Management сопоставляет данные об угрозах, бизнес-контекст, критичность активов, серьёзность и эксплуатируемость, а также проверяет устранение. Это правильные входные данные. Универсального балла CVSS недостаточно.
Уязвимость на неуправляемом активе, доступном из интернета и используемом привилегированной системой, имеет другой приоритет действия, чем та же уязвимость на лабораторном хосте за компенсирующими контролями.
Но именно в управлении экспозицией наиболее видна работа на стороне заказчика. Вендор может приоритизировать. Заказчик ставит заплатки, меняет конфигурацию, заменяет активы, принимает риск или финансирует устранение. Дополнительный модуль управления заплатками Resolve может снизить часть этой нагрузки для поддерживаемых конечных точек и операционных систем, а публичные обновления показывают, что поддержка macOS и Linux в Resolve добавлена в июне 2026 года. Но даже тогда у управления заплатками есть предпосылки: охват, планирование, терпимость к откату, окна обслуживания, тестирование приложений и обработка исключений.
Покупатель должен попросить Arctic Wolf продемонстрировать весь процесс от риска до устранения. Появляется находка. Платформа дедуплицирует её. Сопоставляет с активом. Приоритизирует на основе угрозы и бизнес-контекста. Открывает или синхронизирует тикет. Назначает владельца. Устанавливает целевую дату. Даёт рекомендации по устранению. Отслеживает статус. Повторно сканирует или иным способом валидирует. Отчитывается, снижен ли риск. Эскалирует сорванные сроки. Сохраняет исключения и осознанно принятые риски.
Самая опасная версия управления экспозицией — та, что улучшает дашборды, не меняя реальность. Если тот же открытый сервис остаётся доступным, та же непропатченная уязвимость повторяется или тот же неуправляемый актив снова появляется, риск не снизился. Отчётность Arctic Wolf должна делать повторные случаи видимыми, а не прятать их в агрегированном улучшении. Разница между «мы обнаружили 5000 рисков» и «мы закрыли 40 рисков, которые с наибольшей вероятностью имеют значение» — это разница между активностью и результатом.
Коммерческий вопрос статьи находится и здесь. Управление экспозицией может сделать MDR более ценным, потому что сокращает число предотвратимых инцидентов. Оно также может увеличить нагрузку на заказчика, если каждая приоритизированная находка становится оспариваемым тикетом. Ценность Arctic Wolf зависит от того, доверяют ли его приоритизации настолько, чтобы команды заказчика действовали по ней.
Тикеты, API и отчётность решают, сохранится ли действие при передаче заказчику
Действия по безопасности часто проваливаются после того, как аналитик сделал хорошую работу. Кейс ясен, но рабочая система заказчика находится в другом месте. При синхронизации тикет теряет поля. Команда-владелец не видит срочности. Комментарии разбросаны между порталами. Дубликаты тикетов путают статус. Шаг устранения выполнен в ITSM-инструменте, но не отражён в портале безопасности. Дашборд говорит, что риск ниже, а владелец актива считает, что работа ещё в работе.
Документация Arctic Wolf закрывает часть этой поверхности. Она поддерживает синхронизацию тикетов между Arctic Wolf Unified Portal и ITSM-системами заказчика — вебхуки для ConnectWise и ServiceNow и общую двустороннюю модель вытягивания через Arctic Wolf Ticket API. В документации отмечено, что кастомные интеграции требуют технических сотрудников заказчика, потому что заказчик лучше знает свои инструменты. Это важное ограничение. Доступность интеграции не устраняет работу по внедрению.
Процесс принятого действия зависит от этой передачи. Если заказчик работает в ServiceNow, ConnectWise или другой ITSM-системе, кейс Arctic Wolf должен приходить как пригодный рабочий элемент. В нём должны сохраняться серьёзность, доказательства, срок, рекомендованное действие, владелец, затронутый сервис, идентификаторы активов, комментарии, вложения, история эскалаций и критерии закрытия. Если аналитику по безопасности приходится вручную перепечатывать детали или сверять статусы, управляемый сервис теряет ценность на границе.
Arctic Wolf Ticket API и Reports API актуальны и потому, что зрелые заказчики часто хотят измерять операции безопасности в собственной среде отчётности. Им может понадобиться связывать действия Arctic Wolf с управлением изменениями, реестром активов, устранением уязвимостей, реестром инцидентов, комплаенс-контролями, требованиями страховщиков и дашбордами для руководства. API могут это поддержать, но только если поля стабильны и документированы, лимиты запросов понятны, аутентификация безопасна и семантика статусов ясна.
Покупатель должен проверять отчётность по завершению действий, а не только по количеству оповещений. Может ли заказчик выгрузить все кейсы высокой серьёзности за квартал? Может ли он определить, какие рекомендованные действия были приняты, отклонены, выполнены или просрочены? Видит ли он, какие бизнес-подразделения систематически срывают сроки устранения? Может ли он привязать закрытый тикет к доказательству валидации? Различает ли отчёт «рекомендовал Arctic Wolf», «выполнил заказчик» и «риск принят»? Может ли заказчик показать аудитору последовательность событий без ручной сборки скриншотов?
Публичные обновления продукта показывают постоянные улучшения отчётности и анализа данных, включая синхронизацию отчётов и функции, связанные с поиском. Это полезно, но отчётность сильна настолько, насколько силён лежащий в основе процесс. Если тикет можно закрыть без подтверждённого устранения, отчёт может создавать ложный комфорт. Если комментарии заказчика не синхронизируются обратно, команда Arctic Wolf может работать с устаревшим статусом. Если защита от дубликатов слабая, две команды могут по-разному работать с одним и тем же риском.
Вот почему действие — правильная единица оценки. Действие не завершено, когда кейс создан. Оно завершено, когда правильный владелец принял его, согласованный шаг выполнен, результат проверен или явно принят как риск, а доказательства доступны для последующего пересмотра. Тикеты, API и отчётность — это рельсы, которые делают это возможным в масштабе.
Экономика на стороне заказчика решает, дешевле ли управляемая безопасность, чем создание собственной экспертизы
Коммерческая привлекательность Arctic Wolf очевиднее всего для организаций, которые не могут или не хотят строить полный внутренний центр управления безопасностью. Компания заявляет, что обслуживает тысячи заказчиков в разных отраслях и регионах, с круглосуточным мониторингом, экспертами по операциям безопасности и направляемым снижением рисков. Компания также позиционирует свой сервис как ответ на дефицит талантов, разрозненность инструментов и рост расходов на безопасность.
Это реальные проблемы покупателей. Нанять, обучить и удержать опытных аналитиков дорого. Обеспечить круглосуточное покрытие сложно. Поддержка детекций, интеграций, эскалаций, охоты за угрозами и плейбуков инцидентов требует специализированной операционной модели. Для многих команд среднего и крупного рынка управляемый сервис может дать лучший базовый уровень, чем небольшая внутренняя команда, наблюдающая за набором инструментов.
Но управляемая безопасность не бесплатна после покупки. Заказчик по-прежнему платит за сервис, интегрирует телеметрию, участвует в подключении, посещает обзоры, выполняет устранение, обрабатывает исключения, обновляет контакты, управляет охватом учётных записей и конечных точек, участвует в реагировании на инциденты и финансирует улучшение контролей. Если среда заказчика неорганизованна, управляемый сервис может вскрыть больше работы, чем ожидала команда. Это не обязательно плохо: ранее скрытый риск — всё равно риск. Но это меняет экономику.
Покупатель должен считать стоимость принятого действия, а не только стоимость мониторинга. Предположим, Arctic Wolf снижает шум оповещений, но создаёт меньший поток качественных действий. Кто выполняет эти действия? Сколько часов занимает установка заплаток? Сколько бизнес-простоя вызывают экстренные изменения? Сколько внутреннего времени требуют ежемесячные обзоры? Сколько усилий уходит на сопровождение коннекторов? Как часто заказчику требуется поддержка реагирования на инциденты вне основного сервиса? Каковы выгоды для страховки, комплаенса или отчётности совету директоров?
Какой работы можно избежать, потому что команда Arctic Wolf выполняет триаж, исследования, обогащение и рекомендации?
То, что Chubb выбрал Arctic Wolf предпочтительным поставщиком MDR для соответствующих условиям держателей киберполисов, — значимый рыночный сигнал, потому что страховщики заботятся об операционных контролях, снижающих вероятность и серьёзность убытков. Это не доказывает, что каждый заказчик Arctic Wolf снизит убытки, но показывает, что страховая сторона видит ценность в модели контроля: широкую видимость, непрерывный мониторинг, обнаружение угроз и направляемое внедрение критических контролей. Связь со страховщиком может повлиять на экономику, если улучшает страхуемость, тарифы, доказательства контролей или позицию при пролонгации полиса.
Материалы Gartner Peer Insights и собственные ссылки Arctic Wolf на высокие показатели рекомендаций и оценки заказчиков добавляют контекст рыночных сигналов. Они полезны, но не решающие. Аудитория отзывов формируется самоотбором, а среды покупателей различаются. Небольшая ИТ-команда может ценить фильтрацию оповещений и консультационную модель Arctic Wolf, потому что у неё нет внутренних аналитиков. Зрелый корпоративный SOC может больше заботиться о глубине интеграций, контроле над плейбуками, точности API и о том, как Arctic Wolf сосуществует с существующими инвестициями в SIEM, SOAR, защиту конечных точек и облачную безопасность.
Самый сильный экономический аргумент появляется, когда Arctic Wolf помогает заказчику делать работу, которую тот иначе делал бы плохо: поддерживать непрерывный мониторинг, связывать сигналы учётных записей и облака, триажировать подозрительную активность, приоритизировать работу с экспозицией, координировать реагирование на инциденты, готовить отчётность, пригодную для совета директоров, и поддерживать давление на устранение. Самый слабый аргумент — когда у заказчика уже сильные внутренние операции, и Arctic Wolf становится ещё одним слоем оповещений, порталов и встреч.
Вывод прагматичен. Arctic Wolf не следует покупать как способ уйти от ответственности. Его следует покупать, когда заказчик готов использовать сервис как операционного партнёра и измерять, выполняются ли принятые действия быстрее, с лучшими доказательствами и меньшим внутренним напряжением, чем заказчик мог бы достичь в одиночку.
Примеры инцидентов показывают форму процесса, а не универсальную эффективность
Страницы Arctic Wolf с таймлайнами реагирования на инциденты — одни из самых ясных публичных артефактов для понимания предпочтительной операционной модели компании. Таймлайн программы-вымогателя показывает обнаружение активности в Active Directory и через сенсор Arctic Wolf, сопоставление трафика управления и контроля с активностью PowerShell Empire, эскалацию в триаж и последующее устранение.
Таймлайн уязвимости Microsoft Exchange показывает подключение, обнаружение, расследование, эскалацию, локализацию, шаги устранения, звонок заказчику и последующую работу в рамках Security Journey — оценку заплаток, сбросы учётных записей, правила блокировки в межсетевом экране и дополнительное укрепление.
К этим примерам нужно относиться с осторожностью. Это отобранные публичные истории, а не рандомизированные тесты эффективности. Они не доказывают, что каждый заказчик получит ту же скорость, что каждый сигнал будет обнаружен, что каждая локализация удастся или что каждое устранение будет завершено. Статья не использует их таким образом.
Их ценность в том, что они показывают процесс, который Arctic Wolf хочет, чтобы покупатели ожидали. Сервис — это не просто «мы увидели оповещение». Это последовательность: исходный сигнал, сопоставление на платформе, эскалация в триаж, проверка аналитиком, контакт с заказчиком, локализация, устранение, последующие действия и улучшение состояния защищённости. Это правильная форма управляемых операций безопасности. Она также показывает места, где возможен сбой.
На этапе источника может не хватать телеметрии. На этапе сопоставления сигналы могут быть не связаны. На этапе триажа срочность может быть неверной. На этапе контакта с заказчиком правильный владелец может быть недостижим. На этапе локализации полномочий может не хватать. На этапе устранения у заказчика может не быть возможностей для установки заплаток. На этапе последующих действий организация может закрыть непосредственный инцидент, но игнорировать системную слабость.
Хорошая управляемая безопасность превращает эти точки отказа в явные контроли. Списки контактов поддерживаются. Маршруты эскалации тестируются. Плейбуки определяют полномочия. Тикеты сохраняют доказательства. Контекст заказчика обновляется. Сканы уязвимостей и обзоры состояния защищённости возвращаются в будущие приоритеты. Уроки инцидентов меняют планы обнаружения и устранения. Таймлайн становится операционным циклом, а не историей об одном событии.
Покупатель должен попросить Arctic Wolf пройтись по недавним анонимизированным примерам, похожим на среду самого заказчика. У больницы, производителя, местного органа власти, ритейлера, программной компании и финансовой фирмы не будут одинаковые ограничения. Бизнес-критичные простои, требования приватности, обязательства по киберстрахованию, взаимодействие с юристами и зависимости от третьих сторон различаются. Релевантный пример — тот, где передача действий, полномочия и ограничения устранения ощущаются знакомыми.
Более важное упражнение в рамках должной проверки — отрепетировать инцидент до того, как он произойдёт. Кто у заказчика получает эскалацию Arctic Wolf в 2 часа ночи? Кто может санкционировать изоляцию хоста? Кто может отключить привилегированную учётную запись? Кто может одобрить экстренные изменения в межсетевом экране? Кто может связаться с руководством? Кто отвечает за сохранение улик? Кто общается со страховщиками? Кто решает, когда восстановление бизнеса важнее криминалистической полноты? Arctic Wolf может дать экспертизу, но карта решений заказчика должна существовать.
Примеры инцидентов укрепляют уверенность в направлении модели. Они не отменяют необходимость локальной репетиции.
ИИ полезен, только если сохраняет надзор и проверяемость
В текущем языке платформы Arctic Wolf — продвинутые AI-процессы, специализированная автоматизация, архитектура Swarm of Experts, граф операций безопасности, обработка событий в больших масштабах, специфичный для заказчика контекст и AI Trust Engine с контролем тестирования, разрешений, мониторинга, журналирования, объяснимости, отката и согласования человеком. Компания также говорит, что текущая генеративная функциональность ИИ не обучается на данных заказчиков, тогда как релевантные данные заказчиков и данные безопасности могут использоваться в момент вызова для улучшения контекста.
Для угла этой статьи ИИ не является центром. Центр — принятое действие. ИИ полезен постольку, поскольку помогает вырабатывать лучшие принятые действия. Если он обогащает доказательства, группирует сигналы, ищет связанные события, составляет более ясные тикеты, находит похожие прошлые кейсы, обобщает большие массивы данных или подсвечивает недостающий контекст, он может сократить время цикла и усталость аналитиков. Если он даёт уверенные, но поверхностные рекомендации, скрывает неопределённость или размывает то, кто одобрил действие, он становится риском.
У операций безопасности более высокая нагрузка подотчётности, чем у большинства программных процессов. Ошибочная рекомендация может отключить критическую учётную запись, изолировать производственный сервер, пропустить активное вторжение, раскрыть приватные данные или создать запись аудита, которая позже окажется вводящей в заблуждение. Поэтому публичный акцент Arctic Wolf на границах, минимальных привилегиях и согласовании человеком важен. Покупатель должен относиться к этим контролям как к точкам проверки, а не как к лозунгам.
Вопросы конкретны. Какие действия могут инициировать AI-процессы? Какие они могут только рекомендовать? Какие требуют проверки аналитиком? Какие — согласования заказчика? Как журналируются входные данные модели, извлечённые доказательства, системные рекомендации и правки человека? Как система предотвращает утечку контекста между заказчиками? Как ложные рекомендации обнаруживаются и возвращаются в процесс? Какой откат существует для автоматических или полуавтоматических действий? Как заказчик может проверить доказательства, стоящие за предложенной локализацией или устранением?
Самое убедительное применение ИИ здесь — ограниченная помощь. Кейс начинается с сигнала. Автоматизированные процессы собирают связанные события, применяют данные об угрозах, проверяют контекст заказчика и готовят пакет доказательств. Аналитик-человек проверяет вывод и либо закрывает кейс, либо эскалирует, либо рекомендует действие. Заказчик получает тикет с достаточным объяснением, чтобы действовать. Шаги с высоким влиянием требуют согласования. Система фиксирует решение и результат. Будущие кейсы используют результат.
Эта модель поддерживает процесс принятого действия. Она повышает скорость, не притворяясь, что кибербезопасность стала полностью автономной задачей. Она также уважает сохранённую ответственность заказчика. Даже если Arctic Wolf выполняет больше анализа автоматически, заказчик по-прежнему владеет системами, бизнес-риском и многими решениями об устранении.
Покупатель должен с осторожностью относиться к любому заявлению об ИИ, которое нельзя проследить до повседневного операционного артефакта. «Больше автоматизации» — не бизнес-результат. «Этот кейс дошёл до правильного владельца с ясными доказательствами, действие одобрено, исправление проверено, а цепочка аудита полна» — бизнес-результат. Историю платформы Arctic Wolf следует оценивать по второму стандарту.
Опыт заказчика зависит от того, становится ли рекомендация общим операционным ритмом
Модель Concierge в Arctic Wolf создана, чтобы формировать ритм: обзоры, оценки состояния защищённости, стратегическое руководство, мониторинг, отчётность, поддержка устранения и планирование дальнейшего укрепления защиты (Security Journey). Лучшая версия этой модели даёт заказчику ритм операционной безопасности, который он не мог бы поддерживать в одиночку. Худшая версия превращается в ежемесячную встречу, где открытые пункты обсуждаются без достаточных полномочий, чтобы менять бэклог.
Разница — в дисциплине повестки. Полезный обзор должен начинаться со статуса действий: критические инциденты, нерешённые находки высокого приоритета, просроченное устранение, повторяющиеся экспозиции, пробелы интеграций, шумные детекции, ложные срабатывания, пропущенные эскалации и исключения. Затем эти пункты следует связывать с бизнес-решениями. Нужно ли заказчику финансировать охват конечных точек? Заменить сломанный инструмент установки заплаток? Обновить регламенты реагирования на инциденты с учётными записями? Изменить политику резервного копирования? Ужесточить контроли VPN?
Вывести из эксплуатации устаревшие активы, доступные из интернета? Добавить облачную интеграцию? Обучить бизнес-подразделение, которое систематически кликает по фишинговым симуляциям?
Arctic Wolf может дать данные и рекомендации, но заказчик должен превратить их в решения. Вот почему призма принятого действия — это также призма менеджмента. Компания, которая покупает MDR и затем игнорирует повторяющиеся рекомендации по устранению, получает низкую ценность не потому, что вендору не хватает оповещений. Она получает низкую ценность, потому что операционный цикл сломан.
Повышение осведомлённости тоже вписывается в этот ритм. В публичной навигации по решениям Arctic Wolf повышение осведомлённости и обучение формулируются как вовлечение сотрудников, чтобы они распознавали атаки социальной инженерии и нейтрализовывали их, с фишинговыми симуляциями и релевантным микрообучением. Осведомлённость часто оценивают по проценту завершения или кликов. Для целей этой статьи вопрос о действии острее: когда появляется паттерн, меняет ли обучение поведение, сообщения о происшествиях, политику или дизайн контролей?
Если подразделение систематически ошибается на симуляциях или в реальных угрозах, помогает ли команда Concierge заказчику скорректировать защиту и обучение? Если обучение приводит к сообщениям сотрудников, попадают ли эти сообщения в триаж и в процессы обнаружения?
Облачное обнаружение и реагирование тоже зависят от ритма. Список поддерживаемых интеграций широк: крупные облачные, SaaS-, идентификационные, почтовые и сетевые источники. Но облачные среды меняются быстро. Новые тенанты, неуправляемые SaaS-инструменты, временные учётные данные, эксперименты разработчиков и расползание разрешений могут создавать пробелы. Управляемый сервис должен помогать заказчику поддерживать видимость по мере изменения среды. Иначе некогда хорошая карта интеграций устаревает.
То же верно для готовности к инцидентам. Ретейнер или сервис реагирования на инциденты наиболее ценны, когда подготовка предшествует событию. Списки контактов, матрицы полномочий, ожидания по доказательствам, требования страховщиков и приоритеты восстановления должны быть известны до кризиса. Публичные материалы Arctic Wolf об инцидентах и описания сервисов поддерживают эту ориентацию, но заказчикам всё равно нужно репетировать.
Общий ритм должен давать меньше сюрпризов. Не ноль инцидентов, ноль ложных срабатываний и ноль срочных тикетов: такие обещания были бы нереалистичны. Скорее, меньше моментов, когда заказчик спрашивает: «Кто этим владеет?», «Почему вы не сказали нам, что это важно?», «Почему этот тикет закрыли?» Сильный партнёр по управляемым операциям делает такие вопросы более редкими.
Где публичные доказательства Arctic Wolf сильны, а где они ограничены
Публичные материалы подтверждают несколько выводов с умеренной уверенностью. У Arctic Wolf широкий и актуальный портфель управляемых операций безопасности. Документация MDR охватывает непрерывный мониторинг, обогащение телеметрии, аналитику конечных точек, активное реагирование и выделенную команду Concierge. Страницы управления экспозицией касаются видимости активов, приоритизации уязвимостей, рекомендаций по устранению, интеграции с ITSM, валидации и поддержки управления заплатками. Документация по облачному обнаружению показывает широкую поверхность интеграций: SaaS, идентификация, IaaS, почта, SASE и средства безопасности.
Документация по ITSM и API показывает, что передача действий и отчётность — часть операционной модели. Примеры инцидентов показывают предполагаемую последовательность от сигнала до устранения и последующих действий. Сигналы от страховщиков и рынка обзоров говорят о рыночном признании подхода к управляемым операциям.
Публичные материалы не доказывают несколько вещей, которые могут больше всего волновать покупателей. Они не подтверждают независимо точность обнаружения в средах разных заказчиков. Они не доказывают долю ложных срабатываний, долю пропущенных угроз, успешность локализации, полноту устранения, задержку от оповещения до действия, согласованность аналитиков, экономию для конкретного заказчика или качество каждой интеграции. Они не показывают, как часто заказчики не выполняют рекомендованные действия. Они не показывают, сколько работы заказчик сохраняет после подписки.
Они не показывают, ощущаются ли все поверхности продукта едиными в ежедневной работе.
Это различие не следует читать как пренебрежение. Управляемую безопасность трудно оценивать по публичным источникам, потому что работа происходит внутри сред заказчиков. Провайдер может публиковать документацию, кейсы и примеры, но окончательный ответ зависит от качества данных, полномочий, плейбуков, отзывчивости заказчика и бизнес-ограничений. Публичных материалов Arctic Wolf достаточно, чтобы оправдать серьёзное рассмотрение заказчиками, которые ищут управляемые операции безопасности. Их недостаточно, чтобы пропустить локальную проверку.
Покупатель должен провести структурированную оценку вокруг принятых действий. Во время пилотного проекта или раннего подключения выберите несколько репрезентативных сценариев: подозрительная активность учётной записи, сигнал вредоносного ПО на конечной точке, неправильная облачная конфигурация, уязвимость высокого риска, сообщение о фишинге, открытый актив и эскалация инцидента. Для каждого измерьте, может ли Arctic Wolf собрать доказательства, назначить приоритет, рекомендовать действие, маршрутизировать тикет, сохранить контекст, скоординироваться с заказчиком, проверить завершение и отчитаться о результате.
Та же оценка должна включать обработку сбоев. Что происходит, когда телеметрия отсутствует? Что происходит, когда тикет оспаривается? Что происходит, когда рекомендованная заплатка не срабатывает? Что происходит, когда владелец актива пропускает срок? Что происходит, когда локализация нарушает работу? Что происходит, когда уверенность Arctic Wolf низкая? Что происходит, когда заказчик хочет исключение? Эти случаи раскрывают зрелость операционной модели лучше, чем чистый демо-прогон.
Тезис Arctic Wolf убедителен, потому что он совпадает с реальной слабостью многих программ безопасности: разрывом между знанием о риске и правильным действием, выполненным достаточно быстро. Компанию следует оценивать по тому, как часто она закрывает этот разрыв, а не по тому, сколько сигналов она может обработать.
Оценочный лист покупателя должен прослеживать действие от сигнала до доказательства
Практический оценочный лист для Arctic Wolf начинается с видимости. Подключены ли требуемые источники? Сопоставлены ли сигналы конечных точек, учётных записей, сети, облака и SaaS с реальными активами и владельцами? Обнаруживаются ли сбои коллекторов? Добавляются ли новые среды в мониторинг? Поддерживаются ли учётные данные интеграций? Знает ли заказчик, чего Arctic Wolf не видит?
Следующий показатель — качество триажа. Понятны ли кейсы? Включают ли они доказательства и рекомендованные действия? Ясны ли уверенность и неопределённость? Управляемы ли ложные срабатывания? Связаны ли связанные события? Распознаются ли повторяющиеся проблемы? Знает ли команда Concierge контекст заказчика, или кейсы ощущаются шаблонными?
Третий показатель — полномочия. Какие действия Arctic Wolf может выполнять напрямую? Какие требуют согласования? Какие требуют ИТ-команды заказчика? Проверены ли экстренные согласования? Контролируются ли необратимые действия? Спланирован ли откат? Полны ли записи после действий?
Четвёртый показатель — закрытие устранения. Доходят ли тикеты до правильного владельца? Знает ли заказчик срок? Отслеживает ли Arctic Wolf завершение? Проверяется ли снижение риска? Документируются ли исключения? Эскалируются ли сорванные сроки? Честно ли отчёты показывают открытый риск?
Пятый показатель — экономика. Снизился ли шум оповещений? Изменилась ли нагрузка аналитиков? Обнаруживаются ли инциденты раньше? Быстрее ли закрываются экспозиции высокого приоритета? Снижает ли сервис потребность во внутреннем найме или круглосуточном покрытии? Создаёт ли он управляемую работу или вскрывает бэклог устранения, который заказчик не может профинансировать? Достаточно ли реальны выгоды для страховки, аудита и отчётности совету директоров?
Последний показатель — обучение. Каждый ли инцидент, ложное срабатывание, пропущенный сигнал и просроченная экспозиция улучшают следующий процесс? Настраивает ли Arctic Wolf детекции, обновляет ли плейбуки, уточняет ли контекст заказчика и корректирует ли рекомендации по состоянию защищённости? Меняет ли заказчик контроли, владельцев и процессы в ответ? Отношения управляемой безопасности, которые не обучаются, постепенно станут ещё одним каналом оповещений.
По этому оценочному листу ценность Arctic Wolf не автоматическая и не загадочная. Компания приносит масштаб, экспертизу операций безопасности, широкую платформу, управляемый триаж, приоритизацию экспозиций, реагирование на инциденты и ориентированные на заказчика рекомендации. Заказчик приносит доступ к среде, бизнес-контекст, полномочия на устранение и готовность действовать. Совместный продукт — принятое действие.
Это правильный вопрос для покупки. Не «есть ли у Arctic Wolf MDR?» Есть. Не «обрабатывает ли Arctic Wolf много событий?» Он говорит, что да, и публичные материалы подтверждают операцию большого масштаба. Более важный вопрос — может ли заказчик указать на сигнал безопасности, который стал документированным действием, затем проверенным исправлением, затем измеримым снижением риска. Если Arctic Wolf может сделать эту последовательность рутинной, у управляемого сервиса есть ценность. Если последовательность рвётся на передаче, на полномочиях, на устранении или на доказательствах, заказчик купил мониторинг без достаточного операционного закрытия.