
Резюме
- AMD сегодня оценивают меньше по тому, способны ли ускорители Instinct показывать сильные публичные цифры, и больше по тому, может ли обычная ИИ-команда провести конкретную рабочую нагрузку через приёмку дважды: один раз при валидации и ещё раз после того, как очередной драйвер, фреймворк, модель, ядро, облачный образ или событие восстановления изменит окружение.
- ROCm превратился в реальную производственную поверхность: публичные матрицы совместимости, контейнерные пути для vLLM и PyTorch, проверки работоспособности, рекомендации по переносу с HIP, заявки MLPerf и маршруты развёртывания в Azure и OCI. Эта зрелость вскрывает и скрытую работу: фиксацию версий, покрытие ядер, тесты коллективных операций, тонкую настройку под модель, управление квотами, откат и экспертизу.
- Коммерческий расчёт не сводится к более дешёвой памяти или большему числу токенов на доллар. В отчётности AMD за I квартал 2026 видна динамика Дата-центр и спрос на Instinct MI350, но покупателям всё равно приходится сравнивать полную стоимость одного принятого прогона ускорителя с CUDA, управляемыми облачными модельными сервисами, действующим SaaS, компромиссами открытого ПО и CPU/GPU, собственным переносом кода и сокращением объёма задачи.
- Полезные точки контроля — дрейф совместимости, лимиты облачных мощностей, разрыв между бенчмарком и продакшеном, отсутствующие ядра, регрессии фреймворков, задержки отладки, зона ответственности OEM-интеграции и откат к CUDA. Возможность AMD велика: ускорители с большим объёмом памяти и открытый стек способны снизить зависимость от одного вендора. Бремя в том, что производственная надёжность решается в самых неприглядных частях стека.
Единица ценности — принятый прогон, а не заголовок о чипе
Живой вопрос для AMD не в том, способен ли ускоритель Instinct один раз прогнать впечатляющую модель. Способен. У AMD есть публичные данные о железе, ПО и бенчмарках, которые ещё несколько лет назад казались далёкими: ускорители MI300X и серии MI350, релизы ROCm с актуальной поддержкой фреймворков, контейнерные пути для vLLM и обучения, публичные заявки MLPerf, образы в Azure и Oracle Cloud, растущий корпоративный слой ИИ-ПО. Компания не стоит в стороне от рынка ИИ-инфраструктуры в ожидании, что её заметят.
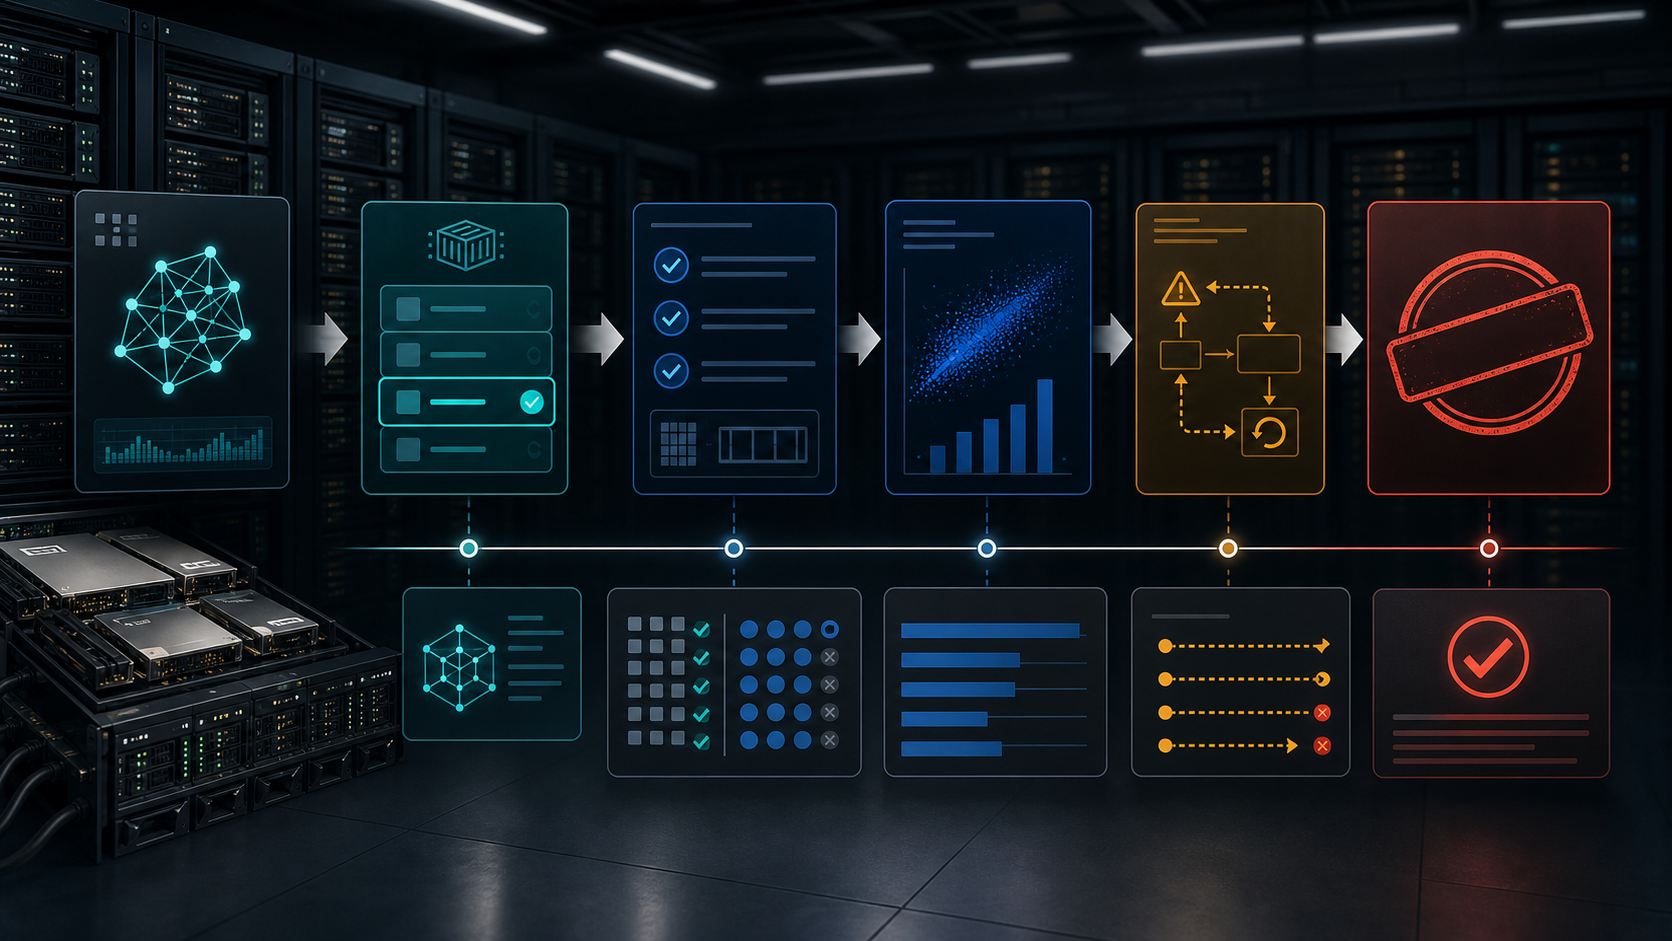
Вопрос сложнее: сможет ли инфраструктурная команда превратить реальную рабочую нагрузку в принятый прогон ускорителя. Этот знаменатель строже, чем балл в бенчмарке. У принятого прогона есть именованная модель или задача обучения, зафиксированный контейнер или окружение, поддерживаемая комбинация GPU и операционной системы, измеренная производительность, известная стоимость, воспроизводимость при повторных запусках, способ диагностировать сбой и путь восстановления на случай, когда меняются драйвер, библиотека ядер, архитектура модели или облачный образ.
Если задача — инференс, приёмка включает успешную обработку запросов, задержку под нагрузкой, поведение памяти, стратегию батчинга, проверки корректности, наблюдаемость и откат. Если задача — обучение, приёмка включает сходимость или достижение целевого качества, стабильность пути данных, поведение чекпоинтов, коллективные коммуникации, поведение при перезапуске и время оператора.
Такая постановка полезна, потому что разделяет три вещи, которые часто смешивают. Возможности модели — что модель умеет, когда работает. Надёжность продукта — позволяют ли железо AMD, ROCm, контейнеры, библиотеки, партнёрские образы и документация выполнять нагрузку предсказуемо. Производственный результат клиента — улучшилась ли реальная бизнес-задача покупателя после учёта затрат на интеграцию, валидацию, контроль и откат. Модель может быть capable при хрупком развёртывании. Продукт может улучшаться, пока клиент всё ещё тратит слишком много инженерного времени на перенос.
Бенчмарк может быть валидным, пока модель клиента, форма данных или целевой уровень сервиса ведут себя иначе.
Сильнейший рыночный аргумент AMD в том, что многие покупатели ИИ хотят большего выбора ускорителей. Они хотят запаса памяти, давления на цены, альтернатив поставок, меньшей привязки к вендору и программных путей, которые не заставляют каждую серьёзную нагрузку зависеть от одного проприетарного стека. Настранице ROCmAMD описывает открытый программный стек с драйверами, инструментами разработки и API для GPU-программирования — от низкоуровневых ядер до приложений конечного пользователя. Настранице серии MI350представлено семейство ускорителей с большим объёмом памяти: MI350X и MI355X предлагают до 288 ГБ памяти HBM3E и до 8 ТБ/с пиковой теоретической пропускной способности, а MI350P ориентирован на развёртывание через PCIe в более привычной корпоративной инфраструктуре.
Это значимые вводные. Но не результат. Результат — принятый прогон со всем неудобным: поддерживаемые операционные системы, версии ядер, прошивка, релиз ROCm, версия фреймворка, поддержка модели, путь квантизации, поведение планировщика, проверки работоспособности, регион облака, квота, сопровождение образов, видимость логов, время экспертов, неудачные попытки и откат. Именно здесь AMD проверяется по-настоящему.
Граница AMD — ускоритель и программный стек, а не каждый облачный результат
Субъектом этой статьи выступает AMD — компания, стоящая за ускорителями Instinct, ROCm и смежным ПО для ИИ-инфраструктуры. Эта граница важна, потому что продукты AMD доходят до клиентов через несколько поверхностей. Одни команды покупают OEM-серверы. Другие арендуют виртуальные машины Azure ND MI300X v5. Третьи используют bare-metal GPU-образы Oracle Cloud Infrastructure. Кто-то оценивает AMD Developer Cloud или партнёрские облака. Кто-то получает оборудование AMD через управляемую платформу или провайдера модельного сервиса. В каждом случае принятая нагрузка зависит одновременно и от компонентов AMD, и от компонентов других поставщиков.
Такая граница предотвращает две ошибки. Первая — приписывать AMD все операции облачного провайдера. Если драйверы чисто ставятся в образе Azure VM, часть результата — упаковка и поддержка Microsoft. Если кластер OCI разгоняет бенчмарк на 64 узлах, часть результата — сеть, хранилище, bare-metal-операции и планировщик Oracle. Если OEM-система даёт нужные прошивку и охлаждение, часть результата — интеграция вендора сервера. AMD поставляет центральные чип и ПО, но клиент принимает систему.
Вторая ошибка — обвинять AMD в каждом сбое нагрузки, не локализовав слой. Модель может падать из-за незрелой функции фреймворка, недоехавшего стороннего ядра, устаревшего облачного образа, допущений приложения о поведении CUDA, неподходящей библиотеки в контейнере, неверной изоляции устройств планировщиком или того, что клиент не прогнал коллективные тесты до обучения. Часть этого — зона ответственности AMD, часть — общая, часть — чужая. Для закупки важнее не моральная вина, а то, кто может быстро диагностировать проблему и кто несёт издержки, пока нагрузка заблокирована.
Публичная отчётность AMD показывает, почему компания так активно осваивает эту поверхность. Врезультатах за I квартал 2026 годаAMD отчиталась о выручке в $10,3 млрд и сообщила, что выручка сегмента Дата-центр составила $5,8 млрд, увеличившись на 57% год к году, благодаря процессорам EPYC и продолжающемуся росту поставок ускорителей Instinct. Вформе 10-Q за I квартал 2026 годарост Дата-центр объясняется прежде всего процессорами EPYC 5-го поколения и GPU серии Instinct MI350. Это коммерческая динамика, а не только лабораторные заявления.
Но динамика выручки не отвечает на операционный вопрос покупателя. Команда облачной платформы, рассматривающая AMD, должна понять, достаточно ли привычен путь ПО и поддержки для её собственных сотрудников. Оператор модельного сервиса должен знать, сможет ли нужная модель использовать правильный attention-бэкенд, путь квантизации и стратегию батчинга. Обучающая команда должна знать, работают ли коллективные коммуникации, чекпоинтинг и перезапуск на требуемом масштабе. Финансовая команда должна понять, переживает ли более низкая цена ускорителя или больший объём памяти дополнительные часы инженеров на перенос и сопровождение второго стека.
Юридическая и брендовая граница поэтому практична. AMD — субъект, потому что контролирует стратегию Instinct и ROCm. Но принятая нагрузка — это цепочка. Это не чип AMD в изоляции и не глянцевые ИИ-заявления облачного провайдера в изоляции.
Зрелость ROCm видна в документации
Один из признаков зрелого стека ускорителей — скучная документация. У ROCm её теперь полезный объём.Матрица совместимостиAMD, обновлённая в конце мая 2026 года в версии, рассмотренной для этой статьи, не блестящая. Это ровно тот артефакт, который нужен производственным командам: совместимость по релизам между операционными системами, GPU и компонентами фреймворков. Страницасистемных требований для Linuxидёт дальше: перечисляет поддерживаемые и неподдерживаемые комбинации железа и ОС и предупреждает, что на неподдерживаемых GPU могут выполняться отдельные пути HIP runtime, но официальной поддержки предварительно собранных библиотек ROCm нет и они могут вызывать ошибки во время выполнения.
Эта документация меняет то, как следует оценивать AMD. Пять лет назад покупатель мог спрашивать, существует ли ROCm в осмысленном виде для ИИ-работ. В 2026 году вопрос лучше ставить иначе: находится ли точная комбинация команды внутри поддерживаемого контура и сможет ли она оставаться там со временем. MI300X, MI325X, MI350X и MI355X — не взаимозаменяемые ярлыки. Поддержка Ubuntu, RHEL, Debian, Oracle Linux, Rocky Linux и SLES может различаться по релизам и GPU. TensorFlow, PyTorch, JAX, Triton, RCCL, hipBLASLt и другие компоненты движутся в собственном темпе. Для принятого прогона нужно превратить эту матрицу в контракт развёртывания.
Именно здесь открытость AMD одновременно и преимущество, и обязательство. Открытый стек может снизить страх перед закрытой экосистемой. Разработчики могут инспектировать, патчить, собирать и интегрировать большую часть пути. Через HIP и библиотеки ROCm возможны стратегии переносимости. Но «открыто» не значит «без усилий». Часто это значит, что у покупателя больше доступных комбинаций, а значит, больше комбинаций для тестирования. Производственной команде всё равно нужно решать, использовать ли образ вендора, релиз вышестоящего фреймворка, контейнер AMD, образ из облачного маркетплейса, собственную Docker-сборку или внутренний базовый образ.
Нужно решать, как быстро брать обновления ROCm и как долго держать зафиксированный рабочий стек.
Впримечаниях к релизу ROCm 7.2.4AMD описывает качественный релиз, сфокусированный на исправлениях производительности и стабильности для ИИ-инференса на ускорителях AMD Instinct. Это обнадёживает, но также напоминает, что ПО ускорителей — живой механизм. Релиз, улучшающий один путь инференса, может изменить допущения в другом месте. Новое ядро или attention-бэкенд может повысить пропускную способность для одного семейства моделей и никак не повлиять на другое. Обновление контейнера может решить баг, изменив поведение памяти. Приёмку нужно повторять при каждом изменении стека.
Для многих покупателей это и есть настоящая строка затрат. Первый успешный перенос на ROCm важен, но повторяющаяся работа — поддерживать прогон принятым, пока движутся ROCm, PyTorch, vLLM, архитектуры моделей, методы квантизации и облачные образы. Команда, которая относится к AMD как к одноразовой замене железа, недооценит эту работу. Команда, которая относится к ROCm как ко второй производственной платформе со своим релизным шлюзом и регрессионным контуром, имеет больше шансов сделать экономику реальной.
Контейнеры снижают трение, но не отменяют приёмку
Самый практичный ответ AMD на обычную тревогу операторов — контейнерный процесс.Документация ROCm по инференсу vLLMуказывает на Docker-образ vLLM с поддержкой ROCm для инференса больших языковых моделей на GPU MI355X, MI350X, MI325X и MI300X. Там описан контейнер, объединяющий ROCm, PyTorch и vLLM с оптимизациями для датацентровых GPU AMD Instinct.Документация по обучению PyTorchперечисляет предварительно оптимизированные семейства моделей: Llama, OpenAI, DeepSeek, Qwen, Stable Diffusion, Flux, NCF и DLRM.Документация Megatron-LMдаёт версионированный контейнерный путь с компонентами ROCm, PyTorch, Transformer Engine, Flash Attention, hipBLASLt, Triton и RCCL.
Это важно, потому что рабочий контейнер часто — самый короткий путь от закупочного любопытства к первому принятому результату. Он сужает пространство поиска. Даёт оператору известный набор версий компонентов. Позволяет облачной или платформенной команде создать повторяемый базовый образ, а не просить каждую прикладную группу собирать ROCm с нуля. Даёт службам поддержки общий словарь: такой-то контейнер, такая-то версия ROCm, такой-то GPU, такое-то семейство моделей, такая-то команда, такой-то результат.
Но контейнер — не сертификат приёмки. Контейнер может быть оптимизирован под документированную модель и всё равно не подойти для модели клиента: другая архитектура, длина последовательности, метод квантизации, токенизатор, мультимодальный путь, стратегия KV-кэша или кастомное расширение. Контейнер может работать на одном узле и всё равно показать узкое место, когда несколько узлов обмениваются градиентами или обслуживают пульсирующий трафик. Контейнер может давать хорошую пропускную способность и проваливать бизнес-цель из-за хвостов задержек, холодных стартов, длины контекста, фрагментации памяти или задержек планировщика.
Он также может устаревать по мере развития вышестоящих версий vLLM или PyTorch.
Знаменатель принятого результата дисциплинирует этот процесс. Для инференса результат — не «vLLM запустился». Это управляемое действие или ответ на основе модели, доставленное под заданной целью сервиса, с достаточной наблюдаемостью и откатом для продакшена. Для обучения или дообучения результат — не «скрипт отработал». Это единица обучающих или оценочных данных, обработанная до целевого качества или состояния чекпоинта, с повторяемой производительностью и восстановлением. Знаменателем могут быть обслуженные токены, успешные запросы, завершённые батчи, обучающие сэмплы, задачи дообучения, оценочные прогоны или принятые артефакты модели.
Важно, чтобы знаменатель был виден до покупки платформы.
Контейнерная работа AMD может сократить время настройки и оптимизации, но не отменяет ревью. Инженерам всё равно нужно считать время на выбор образа, валидацию модели, исправление несовместимостей, написание шаблонов развёртывания, настройку переменных окружения, мониторинг памяти GPU, разбор ошибок ROCm, сравнение пропускной способности с альтернативами и решение, кто виноват в регрессии: AMD, вышестоящая версия vLLM, изменение модели, облачный образ или приложение. Эти задачи — не дефект стратегии. Это цена принятия второго серьёзного стека ускорителей.
Вопрос покупателя в том, ниже ли эта цена выгоды. Если объём памяти AMD позволяет команде обслуживать более крупную модель на узел, консолидировать реплики, сокращать межсерверные коммуникации или избегать более дорогого ускорителя, ответ может быть «да». Если нагрузка остаётся внутри документированных контейнеров и использует распространённые семейства моделей, ответ становится проще. Если нагрузка зависит от кастомных CUDA-расширений, необычных ядер, строгих хвостов задержек или региона провайдера, где мощностей AMD мало, ответ усложняется.
Бенчмарки полезны, когда их воспринимают как доказательство приёмки, а не как приговор
Публичные бенчмарки уже достаточно убедительны, чтобы их нельзя было сбрасывать со счетов. MLCommons сообщил, что в раундеMLPerf Training v6.0участвовали 24 организации, включая AMD, Azure, Dell, HPE, NVIDIA, Oracle, Supermicro и других. Эта широта важна. MLPerf — не частный слайд с неназванными условиями. Это регламентируемое бенчмарк-доказательство, и обучающие бенчмарки измеряют полные системы, которые доводят модели до целевого показателя качества.
Собственныйразбор MLPerf Training v6.0 от AMDконкретнее. AMD сообщает, что платформа MI355X показала 3,5-кратное поколенческое улучшение на дообучении Llama 2-70B — от первой заявки на MI300X до заявки на MI355X, — и что MI355X в цитируемых сравнениях MLPerf Training 6.0 отстала от NVIDIA B200 на 5% на дообучении Llama 2-70B и на 6% на предобучении Llama 3.1-8B. AMD также сообщила, что в раунд вошла её первая многоузловая заявка на обучение и 10 экосистемных партнёров, подавших заявки на платформах AMD Instinct.
Публичный разбор Oracle собственной заявки FLUX.1 в MLPerf Training v6.0 добавляет ещё один тип доказательства. Oracle сообщила о подтверждённом времени обучения 74,44 минуты на 512 GPU AMD Instinct MI300X на 64 узлах OCI BM.GPU.MI300X.8, при этом все десять прогонов достигли целевого качества. Это не обычное корпоративное развёртывание и не общее утверждение о каждом клиенте. Но это значимо, потому что проверяет больше, чем арифметику одного GPU. Это затрагивает распределённое обучение, кластерные сети, ядра ROCm, размещение данных, координацию узлов и повторные прогоны.
Ошибка — читать это как приговор для собственной нагрузки покупателя. Бенчмарк может быть принят по правилам и всё равно далеко отстоять от нагрузки клиента. Модели, наборы данных, настройки точности, версии ПО и правила подачи MLPerf известны; нагрузки клиентов могут быть грязнее. В модели может быть кастомный оператор. Сервисный путь может включать поиск, фильтры безопасности, логирование, структурированный вывод, вызовы инструментов, адаптеры, длинный контекст или мультимодальную предобработку. Обучение может включать очистку данных, политики чекпоинтов, отслеживание экспериментов, спотовые мощности или комплаенс-контроль.
Ничто из этого не отменяет MLPerf. Это лишь говорит, что бенчмарк — источник доказательств, а не полный ответ для закупки.
Правильное использование этих результатов — сравнительная дисциплина. AMD показала, что её стек может участвовать в требовательных публичных регламентируемых тестах. Это снижает риск того, что покупатель рассматривает чисто теоретическую альтернативу. Это также даёт командам набор вопросов для копирования: какой именно программный стек дал результат? Какое семейство моделей тестировалось? Сколько прогонов достигли целевого качества? Каков был масштаб? Что сломалось при подготовке? Какие партнёрские системы воспроизвели похожие результаты? Что происходит при смене модели? Какие проверки работоспособности выполнялись перед нагрузкой?
Иными словами, MLPerf должен делать покупателей строже, а не расслабленнее. Он доказывает, что AMD уместна в серьёзных оценках. Он не доказывает, что покупатель может пропустить оценку.
Облачный доступ превращает вопрос о железе в вопрос о мощностях и ответственности
Облачная доступность — самый быстрый путь для многих команд оценить AMD, но она меняет форму риска. В 2024 году AMD объявила, чтовиртуальные машины Azure ND MI300X v5стали общедоступными и что Microsoft использует VM на MI300X и ROCm для GPT-нагрузок. Microsoft отдельно публикуетруководство по драйверам Linux для Azure ND MI300X v5, охватывающее установку из рекомендуемого marketplace-образа и сценарии установки и обновления Ubuntu. В документации Oracle перечисленыBM.GPU.MI300X.8с восемью GPU MI300X по 192 ГБ и BM.GPU.MI355X.8 с восемью GPU MI355X по 288 ГБ. В анонсе AMD об OCI говорилось, что OCI Supercluster с MI300X поддерживает до 16 384 GPU в одном кластере.
Это существенные сигналы доступности. Они также показывают, почему AMD не стоит оценивать так, будто клиент покупает отдельный чип. Облачный провайдер даёт форму инстанса, базовый образ, процесс квот, сеть, хранилище, процесс поддержки, региональную доступность, график обслуживания и реагирование на инциденты. AMD даёт ускоритель и стек ROCm, которые должны работать внутри этого окружения. Клиент даёт нагрузку, данные, доступ к моделям, развёртывание, тесты и критерии приёмки.
Для покупателя облачный путь снимает часть капитальных и интеграционных затрат. Можно избежать закупки серверов, вопросов питания и охлаждения дата-центра и длинных сроков поставки железа. Это даёт короткий путь к пилоту. Но появляются и новые неопределённости. Документированная форма облака не значит, что в каждом регионе есть мгновенная мощность для нового клиента. Квота может быть ограничена. Управляемый образ может отставать от релиза AMD или расходиться с вышестоящим контейнером. Топология сети может подходить одним распределённым нагрузкам лучше, чем другим. Цены и скидки могут отличаться от парадного нарратива об ускорителях.
Эскалация поддержки может идти через облачного провайдера, прежде чем дойдёт до AMD.
Поэтому принятая нагрузка должна включать доказательство мощностей. Может ли команда получить форму инстанса в регионе, где данные и требования комплаенса позволяют ей работать? Может ли она зарезервировать достаточно мощностей для продакшена, а не только для пиковых тестов? Может ли она воспроизвести прогон в другом регионе или у другого провайдера, если квота исчезнет? Нужна ли нагрузке bare-metal, VM-изоляция, Kubernetes, Slurm или управляемая платформа модельного сервиса? Каков откат, если мощности AMD недоступны во время инцидента или окна запуска?
Это особенно важно для организаций, использующих AMD, чтобы снизить зависимость от доминирующего поставщика ускорителей. Второй путь на кремнии повышает устойчивость, только если он реально доступен, когда нужен. Если путь AMD существует лишь как маленький оценочный кластер, а производственный путь полностью остаётся на CUDA, это учебное упражнение. Если путь AMD может выполнять именованную долю инференса, дообучения, оценки или пакетной обработки по определённому плану аварийного переключения, это стратегический рычаг. Разница не в чипе; разница в мощностях, операционной готовности и политике маршрутизации.
Стоимость переноса — часть цены, которой нет в счёте
Самый прямой вызов AMD устоявшемуся ПО ускорителей — переносимость через HIP и ROCm.Руководство по переносу HIPописывает HIP как C++ runtime API и язык ядер для GPU AMD, позволяющий разработчикам переводить CUDA-код для работы на GPU AMD, и рекомендует такие инструменты, как HIPIFY, плюс поэтапный перенос и тестирование. Это полезный путь для приложений с GPU-кодом, который не может опираться только на поддержку на уровне фреймворков.
Но практические советы руководства — одновременно и предупреждение. Перенос — это работа. Он начинается с рабочей CUDA-кодовой базы, затем идут конвертация, компиляция, тестирование и оптимизация по этапам. Простые случаи могут быть почти механическими. Сложные случаи включают CUDA-специфичные библиотеки, кастомные ядра, допущения о поведении памяти, системы сборки, инлайн-ассемблер, инструменты профилирования, коллективные операции, attention-ядра, процедуры квантизации, кастомные PyTorch-расширения или сторонние пакеты, которые не приоритизировали ROCm.
Даже когда код работает, переносимость производительности — отдельный вопрос от корректности.
Именно здесь экономику AMD можно прочитать неправильно. Закупочная команда может увидеть более низкую цену ускорителя, больше памяти на устройство или лучшую доступность и решить, что бизнес-кейс очевиден. Затем платформенная команда обнаруживает, что нужное приложение — не просто PyTorch из чистого контейнера. Оно включает кастомное расширение, обёртку сервиса, зависимость, существующую только для CUDA, компонент мониторинга, плагин планировщика и скрипты развёртывания, написанные вокруг допущений NVIDIA. Каждая адаптация может быть разумной. Вместе они становятся статьёй расходов на миграцию, которой не было в сравнении железа.
Возможно и обратное. Команда может переоценить проблему переноса, потому что помнит старые пробелы ROCm или боль потребительских GPU. Если нагрузка — мейнстримовый инференс Llama или Qwen через документированный ROCm-контейнер vLLM или поддерживаемый рецепт обучения на Instinct, добавочная работа может быть скромной. Если приложение использует стандартные пути фреймворка и команда может зафиксировать рабочий образ, AMD можно оценить быстро. Если главное узкое место — объём памяти, а не экзотический CUDA-код, профиль памяти Instinct может дать реальное операционное преимущество.
Правильное сравнение — не «AMD против NVIDIA» в абстракции. Это стоимость одного принятого прогона для названной задачи. Сравните путь AMD с тем, чтобы остаться на CUDA, использовать управляемого облачного или модельного провайдера, уменьшить модель, использовать открытую модель на существующих мощностях, купить привычный SaaS-процесс, построить собственную оркестрацию или делать меньше задачи. Включите время инженеров, контракты поддержки, облачные обязательства, неудачные прогоны, подготовку тестовых данных, наблюдаемость, ревью моделей, откат, покрытие инцидентов и стоимость выхода.
Для одних нагрузок AMD выиграет, потому что нагрузка документирована, прожорлива до памяти, переносима и дорога на привычном пути. Для других выиграет устоявшаяся экосистема ПО, потому что скрытые издержки переноса и поддержки больше экономии на ускорителях. Плоха только та оценка, которая считает доллары за железо и игнорирует недели инженеров.
Работа над надёжностью начинается до модели
Принятые нагрузки на ускорителях требуют предполётных проверок.Руководство по проверке работоспособности системыAMD говорит, что команды должны убедиться, что оборудование AMD настроено корректно и работает оптимально, прежде чем запускать ИИ-нагрузки, и указывает на ROCm Validation Suite, тесты RCCL, BabelStream и TransferBench. Это не бумажная формальность. Это способ не перепутать проблему модели со сломанным узлом, неверно настроенным IOMMU, слабой пропускной способностью памяти, плохим интерконнектом или проблемой коллективных коммуникаций.
В продакшене этот слой становится ещё важнее, потому что режимы отказов неоднозначны. Если обучающая задача замедлилась, причина — ROCm, отказавший GPU, деградировавший линк, скачки хранилища, узкое место загрузчика данных, тепловое поведение, эффект шумных соседей в облаке, изменение модели или новое ядро фреймворка? Если выросли задержки инференса, причина — батчинг, давление KV-кэша, форма запросов, токенизация, фрагментация памяти, размещение планировщиком, поведение тактовой частоты, логирование, сеть или регрессия в сервисном стеке? Без проверок здоровья и базовых тестов команда спорит мнениями.
Именно здесь AMD приходится конкурировать не только с кремнием, но и с операционной мышечной памятью. У многих ИИ-команд годы привычек отладки CUDA. Они знают, какие инструменты NVIDIA использовать, какие ошибки типичны, каким форумам верить, какие теги контейнеров безопасны и какие счётчики производительности важны. ROCm требует аналогичных привычек. AMD может публиковать инструменты и документацию, но покупателям всё равно нужны люди, умеющие пользоваться ими под давлением. Прогон принят не потому, что один раз прошёл тихим днём. Он принят, когда команда может его объяснить, мониторить и восстановить.
Операционный тест приёмки должен включать как минимум пять слоёв. Первый — здоровье железа: RVS, пропускная способность памяти, видимость GPU и здравомыслие температуры и энергии. Второй — коммуникации: корректность и производительность коллективных операций RCCL для размера узла или кластера. Третий — фреймворк: PyTorch, vLLM, Megatron-LM или выбранный стек на зафиксированных версиях. Четвёртый — нагрузка: реальная модель и паттерн данных, а не вендорский сэмпл.
Пятый — восстановление: перезапуск с чекпоинта, откат к рабочему образу, вывод узла из эксплуатации, воспроизведение упавшего запроса и документирование того, кто действует при появлении ошибки.
Это может звучать дорого. Так и есть. Но это также единственный справедливый способ сравнивать платформы. Если привычный путь CUDA — это годы скрытых операционных инвестиций, AMD не следует просить побить только маржинальную цену железа. Её стоит сравнивать с полной стоимостью поддержания здоровья привычного пути. И наоборот: если у покупателя нет сильной привычной практики и он строит ИИ-инфраструктуру с нуля, AMD может войти раньше и избежать части издержек переключения.
Производственная задача — повторная приёмка. Платформа, которая может один раз провести прогон, интересна. Платформа, которая может проводить через приёмку тот же класс прогонов после обновлений, сбоев и смены персонала, ценна.
Корпоративное ИИ-ПО меняет обещание продажи, но не знаменатель
AMD пытается подняться выше по стеку.AMD Enterprise AI Suiteпозиционируется как связка открытых ИИ-фреймворков и генеративных ИИ-моделей с корпоративной Kubernetes-платформой. AMD Inference Microservices и референсные стеки призваны сократить дистанцию между голым железом и работающим ИИ-сервисом. Это стратегически необходимо. По мере того как ИИ-инфраструктура переходит от элитных модельных лабораторий к обычным предприятиям, покупатели хотят меньше сырых деталей и больше разворачиваемых систем.
Этот шаг — также ответ на конкурентный паттерн, заданный устоявшимися экосистемами ускорителей. Вендоры железа всё чаще продают ПО, референсные контейнеры, модельные серверы, оркестрацию, хуки наблюдаемости, микросервисы и корпоративную поддержку. Покупатель не хочет коробку теоретических FLOPS. Он хочет управляемый процесс: развернуть эту модель, маршрутизировать эти запросы, применять эти политики, собирать эти логи, обновить этот контейнер, безопасно откатиться, выставить счёт этой команде и доказать, что сервис остался в рамках.
Возможность AMD — предложить этот процесс на открытых основаниях и с меньшей привязкой. Если Enterprise AI Suite, AIMs, контейнеры ROCm и интеграция Kubernetes сделают инфраструктуру AMD проще для приёмки, компания сможет конкурировать по операционному знаменателю, а не по сырому сравнению компонентов. Платформенной команде может быть всё равно, какое ядро ускорило работу, если сервис можно развернуть, наблюдать, обновлять и восстанавливать с меньшим трением, чем ожидалось.
Риск в том, что более высокоуровневый набор создаёт новый слой для валидации. Референсный стек Kubernetes всё равно включает жизненный цикл кластера, происхождение образов, сетевые политики, хранилище, секреты, реестр моделей, автомасштабирование, выводы узлов, темп обновлений и реагирование на инциденты. Инференсные микросервисы всё равно требуют приёмки под конкретную модель, валидации входных данных, мониторинга выходов, SLO по задержке, ревью безопасности и учёта затрат. Референсный blueprint может сократить путь; он не может превратить модель в управляемое бизнес-действие без политик и данных клиента.
Это различие важно для регулируемых и высокоответственных применений. Если модель на базе AMD отвечает на вопросы поддержки, маршрутизирует клинические записи, резюмирует юридические материалы, запускает действие безопасности или генерирует код, принятый результат — не токен. Это проверенное действие внутри процесса. Инфраструктурный стек должен давать надёжность, но клиенту всё равно нужны правила человеческого ревью, аудит, обработка исключений и откат. AMD может сделать прогон ускорителя дешевле или переносимее. Она не владеет качеством решений клиента.
Лучшая роль корпоративного слоя AMD поэтому прагматична: сократить время на сантехнику, чтобы команды могли больше времени тратить на приёмку нагрузок. Если он лишь переносит сложность из установки ROCm в другую плоскость управления, покупатели будут дисконтировать его. Если он превращает распространённые паттерны инференса и обучения в повторяемые поддерживаемые развёртывания, он напрямую бьёт по исторической слабости AMD — страху, что не-CUDA-пути стоят слишком много инженерного внимания.
Экономический расчёт должен включать откат
Откат — не пессимизм о провале. Это часть цены. Команда, принимающая AMD для ИИ-инфраструктуры, должна решить, что происходит, когда нагрузка не проходит приёмку. Возврат к CUDA? Запуск модели поменьше? Переход на управляемый API? Оставить CPU-путь для пакетной работы? Использовать AMD для оценки, а NVIDIA — для критичного к задержке сервиса? Разделить трафик по семействам моделей? Отложить продакшен до выхода недостающего ядра?
У каждого отката есть стоимость. Поддержание двух стеков ускорителей может улучшить переговорную позицию и устойчивость, но может удвоить матрицы тестирования. Оставление CUDA как страховочного пути снижает риск миграции, но может сохранить зависимость от действующего вендора, которую AMD должна была снизить. Использование AMD только для избыточного трафика может оставить инженеров незнакомыми с ней, когда придёт производственное давление. Использование AMD для всех новых нагрузок может сконцентрировать риск, если команда не накопила достаточно экспертизы в ROCm.
Покупка облачных мощностей для обоих путей может улучшить непрерывность и ослабить скидки.
Поэтому коммерческий вопрос следует ставить в единицах принятого результата. Для инференса считайте стоимость на миллион принятых запросов, стоимость на успешное действие инструмента, стоимость на сгенерированное изменение кода, прошедшее ревью, или стоимость на управляемый ответ, доставленный при ограничениях задержки и безопасности. Для обучения считайте стоимость на принятое дообучение, на обучающий прогон до целевого качества, на результат оценки или на цикл переобучения. В числитель входят расходы на железо или облако, поддержку ПО, время сотрудников, неудачные прогоны, валидацию, мониторинг, миграцию и откат.
Знаменатель исключает результаты, не прошедшие приёмку.
Объём памяти AMD может много значить в этом уравнении. Больше HBM на ускоритель может сократить необходимость шардировать определённые модели, поддержать более длинные контексты, дать запас для батчинга или упростить развёртывание. Но памяти одной недостаточно. Если модель помещается, а её attention-бэкенд слаб, принятая стоимость всё равно может быть плохой. Если пропускная способность хороша, а откат неясен, регулируемый покупатель может отклонить развёртывание. Если облачная мощность дешёва, но недоступна в нужном регионе, теоретическая стоимость не имеет значения.
Реалистичные альтернативы разнообразны. Остаться с NVIDIA может быть дорого, но операционно привычно. Управляемый модельный сервис облачного провайдера может избавить от управления ускорителями, но уменьшить контроль и переносимость. Привычный SaaS-продукт может дать бизнес-процесс без раскрытия деталей GPU, ценой кастомизации. Открытого кода на существующем железе может хватить, если задача терпит задержки или модели поменьше. Делать меньше задачи может быть рационально, если бремя ревью превышает выигрыш от автоматизации.
AMD выигрывает, только когда её путь бьёт эти альтернативы после учёта скрытой работы. Это более строгий стандарт, чем «дешевле действующего ускорителя». Это также лучший стандарт для самой AMD, потому что он показывает, где компании можно улучшаться: матрицы поддержки, контейнеры, покрытие моделей, инструменты отладки, облачная доступность, корпоративные референсные стеки, воспроизводимость у партнёров и доказательства под конкретную нагрузку.
За чем следить дальше
Первая точка контроля — дрейф совместимости. Релизы ROCm улучшаются, но каждое улучшение создаёт новое версионное решение. Покупателям стоит фиксировать, какой релиз ROCm, версия фреймворка, тег контейнера и прошивка GPU приняты для каждой нагрузки. Стоит записывать, почему взято обновление, какие регрессионные тесты прошли и как откатиться.
Вторая — покрытие ядер и моделей. Публичные документы перечисляют распространённые семейства моделей, и у AMD сильные бенчмарк-доказательства, но микс ИИ-моделей быстро меняется. Модели типа mixture-of-experts в стиле DeepSeek, нагрузки с длинным контекстом, мультимодальные модели, генерация видео, модельные сервисы с вызовом инструментов и специализированные поисковые системы могут нагружать разные ядра и пути памяти. Покупателю стоит спрашивать, поддерживается ли и оптимизирована ли именно его архитектура модели, а не значится ли в блоге общее название семейства.
Третья — облачные мощности. Поверхности Azure и OCI реальны, но квота, регионы, сопровождение образов и маршруты поддержки — операционные факты. Конкурентная ценность AMD растёт, если клиенты могут получить мощности там, где нужно, и если провайдеры обновляют образы, не ломая проверенные нагрузки.
Четвёртая — воспроизводимость у партнёров. Разбор MLPerf у AMD с упоминанием экосистемных партнёров важен, потому что выходит за пределы одной референс-лаборатории. Чем больше Dell, HPE, Supermicro, Cisco, Oracle, Azure и другие партнёры воспроизводят принятые результаты на документированных условиях, тем меньше принятие AMD выглядит работой узких специалистов. Верно и обратное: если результаты зависят от одной тщательно настроенной конфигурации, обычные покупатели заложат в цену зависимость от экспертов.
Пятая — человеческий контроль. Даже если AMD делает нагрузку быстрее или дешевле, ИИ-инфраструктурным командам всё равно нужны ревью, обработка исключений, учёт затрат и восстановление. Действия на основе моделей ценны, когда они управляемы, а не просто ускорены. AMD может помочь снизить инфраструктурную стоимость этих действий, но не может убрать необходимость решать, какие результаты приемлемы.
Шестая — стоимость отката. Если у команды нет чёткого ответа, что происходит при сбое пути ROCm, оценка не завершена. План отката должен быть явным до продакшена, а не импровизацией во время инцидента с клиентом.
Вывод не в том, что AMD не готова. Вывод в том, что AMD достаточно готова, чтобы её серьёзно и операционно оценивали. Это более высокая планка, чем заголовочный бенчмарк, и лучший знак для компании. Instinct и ROCm больше не нуждаются в том, чтобы рынок верил в теоретический второй источник. Им нужно, чтобы клиенты доказывали, нагрузка за нагрузкой, что второй источник можно принимать, сопровождать и оплачивать.
Для AMD производственная задача — повторное доверие. У компании есть оборудование ускорителей, видимый программный стек, публичные бенчмарк-доказательства и облачные маршруты. Следующее доказательство менее кинематографично: команда после обновления повторяет ту же нагрузку, видит тот же принятый результат, знает, почему он прошёл, знает, что делать при сбое, и может показать, что полная стоимость всё ещё бьёт альтернативу.