
Resumo
- Quando o RRDP falha, um validador pode manter um cache anterior, baixar um snapshot muito maior ou recorrer ao rsync; não existe um cronômetro universal que imponha a mesma escolha.
- Retenção de deltas, validade de manifests e limites do validador distribuem custo, tempo de recuperação e exposição a replay entre participantes diferentes.
- Operadores precisam de um recibo de recuperação por repositório e da comparação entre resultados validados independentes, não apenas de um monitor HTTP verde.
Às nove da manhã, um validador pede o próximo delta pequeno a um repositório RPKI. A notificação contém a referência, mas o arquivo não chega. Um validador mantém o cache da última coleta bem-sucedida. Outro busca o snapshot completo. Um terceiro espera um intervalo aleatório antes de tentar rsync. As três decisões podem ser defensáveis; elas não garantem a mesma versão do presente no mesmo minuto.
É por isso que o caminho de recuperação está se tornando um ponto de controle do roteamento. O RPKI costuma ser explicado a partir do objeto assinado: o detentor de recursos autoriza uma origem, uma parte confiante valida essa autorização e o roteador aplica a política de validação de origem.
Na operação, a intenção assinada precisa sair da autoridade certificadora, ser publicada, atravessar o transporte do repositório, passar pelas verificações de manifest, certificado e revogação e, só então, virar um conjunto de dados validado. Uma assinatura intacta não impede uma falha de distribuição de mudar a evidência disponível para a etapa seguinte.
Do delta ao snapshot e ao caminho de contingência
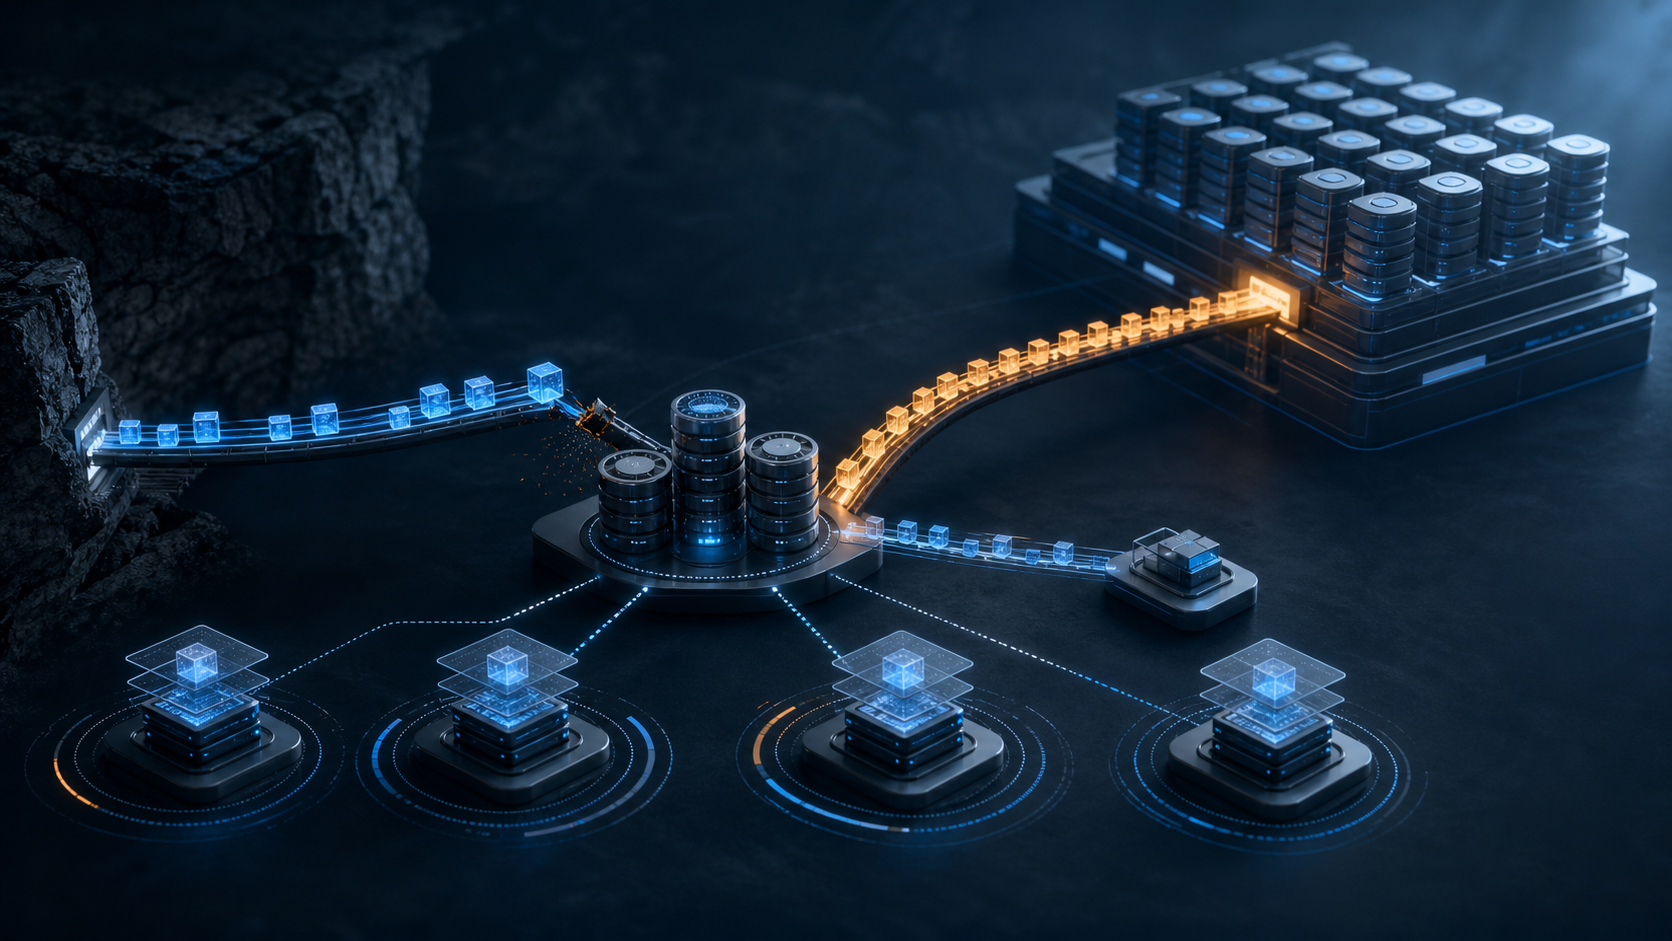
O RFC 8182 define três componentes do RRDP. O arquivo de notificação identifica a sessão e o número de série do repositório. Deltas carregam mudanças incrementais. Um snapshot contém a visão atual completa. Se houver uma cadeia contínua entre o serial local e o remoto, o validador usa o caminho leve. Se um delta estiver ausente ou for rejeitado, ele parte para o snapshot.
Os custos são assimétricos. Um delta pode ser pequeno; um snapshot pode ter dezenas ou centenas de megabytes. A versão de maio de 2026 do rascunho SIDROPS sobre serviços de publicação descreve a cascata: depois de falhar em um ou mais deltas, a parte confiante costuma tentar o snapshot, que é maior; se ele também falhar, pode recorrer ao rsync; na tentativa RRDP seguinte, normalmente volta a começar pelo snapshot. Assim, a sobrecarga pode produzir uma recuperação que aumenta ainda mais a demanda. O pacote de emergência pesa mais justamente quando a doca suporta menos carga.
O documento ainda é um Internet-Draft de grupo de trabalho, não um RFC. Seus números têm escopo claro. Em um repositório grande, em janeiro de 2024, uma notificação com 144 deltas cobrindo 14 horas respondeu por 251 GB de um total de 55,5 TB, menos de 0,5%. Reter mais deltas ajuda um validador atrasado a se recuperar de forma incremental, mas aumenta a notificação lida por todos.
Reter menos reduz bytes no regime normal e empurra mais clientes para snapshots. O rascunho recomenda pelo menos quatro horas de deltas porque, em 2024, foram observadas instâncias sincronizando apenas a cada uma ou duas horas. A configuração não elimina o gasto; escolhe quando e onde ele aparece.
O validador adiciona outra camada de política. A documentação atual do Routinator oferece never, stale e new para o fallback ao rsync após falha de RRDP. O padrão documentado é stale: usar a cópia RRDP local enquanto ela for considerada atual e, depois, tentar rsync em um momento aleatório por repositório. O limite máximo padrão é 3.600 segundos. A dispersão evita que todos os validadores cheguem à porta lateral de uma vez.
Há outros limites documentados: snapshot se forem necessários mais de 100 deltas; lista tratada como vazia acima de 500; 600 segundos para obter um recurso RRDP; 10 segundos para leitura; 300 segundos para um comando rsync. São padrões de um produto, não constantes do RPKI. Mudá-los transforma a mesma falha em outra sequência de requisições e decisões de cache.
O cache também faz parte da evidência
O RFC 9286 orienta a usar dados da última coleta bem-sucedida depois de uma falha, até que uma nova coleta tenha sucesso. Isso evita que uma visão incompleta seja lida como uma nova intenção de roteamento. Também significa que a disponibilidade instantânea de um endpoint não informa a idade da evidência que acabará chegando ao roteador.
Manifests limitam essa continuidade. Eles enumeram os objetos que o emissor pretende publicar e ajudam a detectar remoção, substituição ou supressão de uma versão nova. Conseguem apontar a diferença, mas não consertar o objeto ausente. thisUpdate, nextUpdate, CRLs e a validade dos objetos definem uma janela finita para reutilizar o cache.
O rascunho de 2026 explicita a troca. Validades mais longas compram mais tempo para restaurar o serviço, mas ampliam a janela de replay. Validades menores reduzem essa exposição e aumentam reemissões. Em um repositório grande, mudar a reemissão de 24 para 48 horas reduziu o uso de dados em cerca de 50%, pois a maioria das mudanças vinha de manifests e CRLs reemitidos, e não de novas ROAs ou ASPAs. Não é uma taxa global. Ainda assim, mostra quem controla a alavanca: a CA escolhe o ritmo; o repositório e todas as partes confiantes processam a carga.
As normas continuam detalhando a recuperação. O RFC 9981, publicado em maio de 2026, trata do caso excepcional em que o número do manifest chega ao máximo. Antes da nova regra, algumas implementações poderiam aceitar um substituto apenas depois da expiração, enquanto outras rejeitariam novos manifests indefinidamente. A contagem normal praticamente nunca atinge o teto; erro ou configuração incorreta é a hipótese realista. A importância está em provar que uma borda de recuperação mal especificada pode gerar resultados operacionais diferentes.
Capacidade e segurança não melhoram na mesma direção
Recorrer ao rsync pode aumentar a acessibilidade e enfraquecer o limite de transporte. RRDP usa HTTPS e distribui deltas e snapshots imutáveis, adequados para cache. Rsync exige mais trabalho do servidor por conexão e não oferece por si só confidencialidade e integridade de canal. O modelo de ameaças do Routinator diz que um adversário no caminho pode degradar RRDP e provocar downgrade para rsync. Assinaturas e manifests passam a sustentar uma parcela maior da defesa.
Em 2020, a NLnet Labs mostrou o risco de capacidade com uma projeção: 150 mil validadores consultando a cada dez minutos representariam cerca de 250 requisições por segundo, diante de um serviço rsync de contingência acostumado a aproximadamente três. Esses não são dados de tráfego de 2026. Eles explicam por que um fallback simultâneo seria uma má política e por que o intervalo atual é aleatório.
Uma análise de sensibilidade dispensa um total global inventado. Considere 10 mil validadores, atualização comum de 1 MB e snapshot comprimido de 100 MB. Se todos ficarem no incremental, uma rodada transfere 10 GB. Se apenas 20% forem para snapshots, o total chega a cerca de 208 GB: 8.000 MB de deltas mais 200.000 MB de snapshots. Retentativas e processamento rsync vêm por fora. O pico depende tanto do intervalo em que as recuperações se concentram quanto do número de validadores.
Um repositório pode estar “no ar” e entregar um produto de recuperação incoerente. Um balanceador pode expor a notificação de um backend antes que o delta ou snapshot referenciado chegue aos demais. Uma conexão persistente antiga pode atravessar um failover e devolver uma sessão anterior. O rascunho SIDROPS exige visões coerentes e observa que o RFC 8182 não define uma resposta universal para regressão de serial; algumas implementações buscam um snapshot para sincronizar. O monitor recebe 200. O validador recebe uma linha do tempo quebrada.
As fontes não medem a divergência global nem provam que um repositório específico tenha causado uma queda de rotas. Elas estabelecem o mecanismo, as escolhas configuráveis e a transferência de custos. Isso basta para um teste controlado.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance