
Resumo
- RFC 5198 define Net-Unicode como um perfil composto, não como sinônimo de UTF-8: a atribuição dos pontos, NFC, CRLF, BOM e caracteres de controle fazem parte do resultado.
- Bibliotecas do sistema e da linguagem podem trocar suas tabelas sem alterar o código. O corpus e o recibo precisam revelar qual fronteira de versão foi realmente executada.
O caso que o teste feliz não encontra
É fácil montar uma regressão com palavras usuais, acentos precompostos e suas formas decompostas. Esses casos são úteis, mas vivem na área mais estável do Unicode. RFC 5198 aponta outra região: aplicações normalmente dependem das funções de conversão e normalização do sistema operacional ou da linguagem, que podem mudar sem uma alteração no código da aplicação.
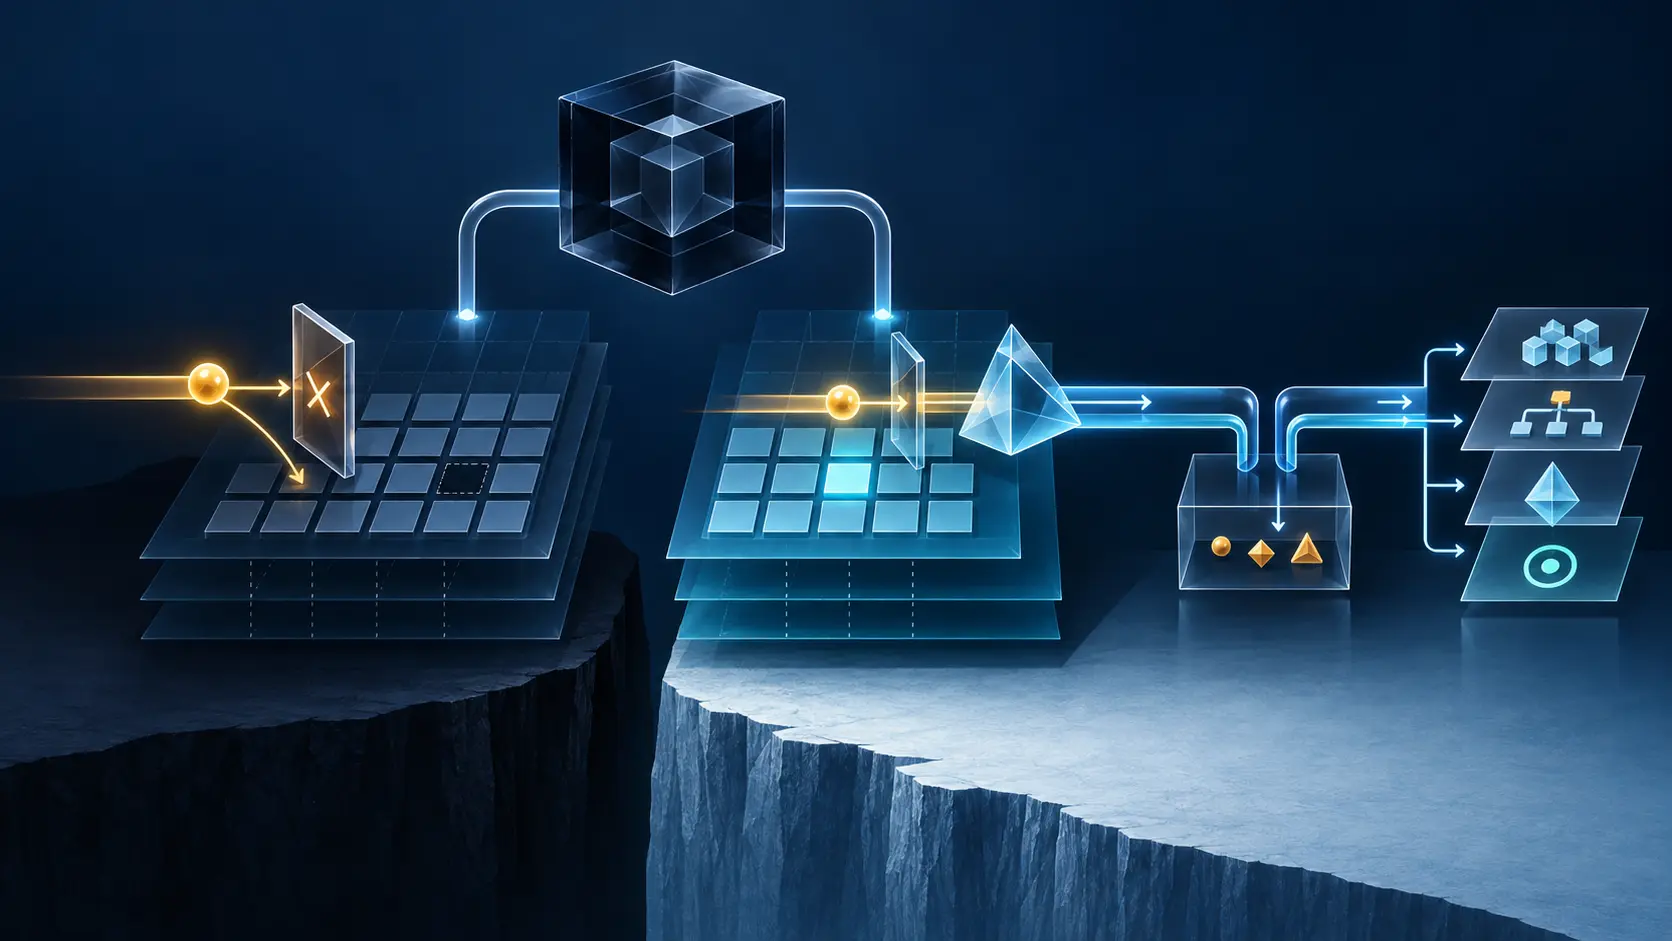
Um ponto ainda não atribuído normaliza para si mesmo. Uma versão futura pode atribuí-lo a um caractere que participa de outro mapeamento. O emissor conforme com Net-Unicode não pode transmitir o ponto enquanto ele estiver sem atribuição na versão da qual depende. Por isso uma atualização da base pode mover a fronteira de admissão, mesmo quando o executável continua idêntico.
Isso não elimina a estabilidade de NFC. Para uma cadeia sem pontos não atribuídos e já normalizada, a política citada pelo RFC garante que ela permaneça NFC em versões futuras. O problema operacional é confundir essa garantia condicionada com a ideia de que qualquer entrada, qualquer tabela e qualquer combinação de versões produzirá sempre a mesma decisão.
As etapas que unicode_ok esconde
RFC 3629 responde se os octetos formam UTF-8 válido. RFC 5198 acrescenta as regras de uma forma comum de texto de rede. Se há linhas, elas terminam em CRLF. CR NUL sobrevive como herança desaconselhada e pode acionar terminadores em linguagens baseadas em C. Os controles C1 não podem aparecer. IND, NEL, U+2028 e U+2029 não são finais alternativos. BOM no início também é proibido.
Antes de transmitir, as sequências devem preferencialmente estar em NFC. O sistema não pode enviar pontos sem atribuição em sua versão, e as versões de Unicode e NFC precisam ser coerentes.
O resultado correto é uma sequência de recibos: decodificação, classificação do repertório, normalização, linha/controle e decisão de negócio. A errata 7531, ainda Reported, corrige a descrição dos C1 como se fizessem parte da faixa ASCII; ela não remove a proibição explícita. A errata verificada 1402 só corrige uma referência editorial. Até a leitura da especificação exige preservar estado e autoridade.
O filtro e o serviço precisam comparar o mesmo estado
O RFC recomenda não confiar que a entrada esteja normalizada. Formas deliberadamente não normalizadas podem escapar de uma busca ingênua em firewalls. Se o filtro usa uma versão de dados e o serviço usa outra, “a regra passou” não informa qual sequência cada componente observou.
A ordem também altera a evidência. Normalizar antes de verificar uma assinatura não equivale a verificar os octetos recebidos e normalizar depois. Converter fim de linha pode mudar deslocamentos. Remover BOM pode ser uma transformação, não uma simples validação. Net-Unicode não substitui protocolos que já definiram precisamente seu próprio uso de UTF-8; o recibo deve nomear o perfil e a ordem efetivamente empregados.
Um corpus voltado à fronteira
Além do digest da aplicação, registre a imagem base, o runtime, a versão do Unicode Character Database, a implementação NFC e os dados carregados. Para cada entrada, ligue o hash dos octetos ao resultado UTF-8, à sequência de pontos e ao veredito de atribuição. Separe BOM, uso privado, C0, C1, CR, LF, CR NUL, U+2028 e U+2029. Guarde os hashes antes e depois de NFC e diga se a entrada já estava normalizada.
O corpus precisa conter um ponto ainda não atribuído em todas as versões em escopo e outro atribuído entre a versão mais antiga e a mais nova implantadas. Deve rodar depois de atualização do host, runtime, ICU, imagem ou gateway, não apenas depois de commit de produto.
Por fim, compare a decisão textual com a ação posterior sem misturá-las. Conformidade Net-Unicode não prova identidade, autorização nem resultado. Ela prova, quando o recibo é completo, quais regras de intercâmbio foram aplicadas por qual runtime.
Fontes
- RFC 5198 em HTML
- RFC 5198 em texto
- Página informativa do RFC 5198
- IETF Datatracker: RFC 5198
- Histórico do RFC 5198
- Referências do RFC 5198
- Erratas do RFC 5198
- RFC 3629 — UTF-8
- RFC 2277 — conjuntos de caracteres e idiomas
- RFC 4690 — análise de nomes internacionalizados
- RFC 3454 — Stringprep
- RFC 8264 — estrutura PRECIS
- RFC 6365 — terminologia de internacionalização
- RFC 854 — Telnet
- RFC 698 — ASCII estendido no Telnet
- Unicode Standard Annex #15 — normalização
- Política de estabilidade do Unicode
- Heng Lu — camadas de realidade e poder simbólico
- Heng Lu — especificação inicial mínima
- Heng Lu — primazia do código em execução
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance