
Resumo
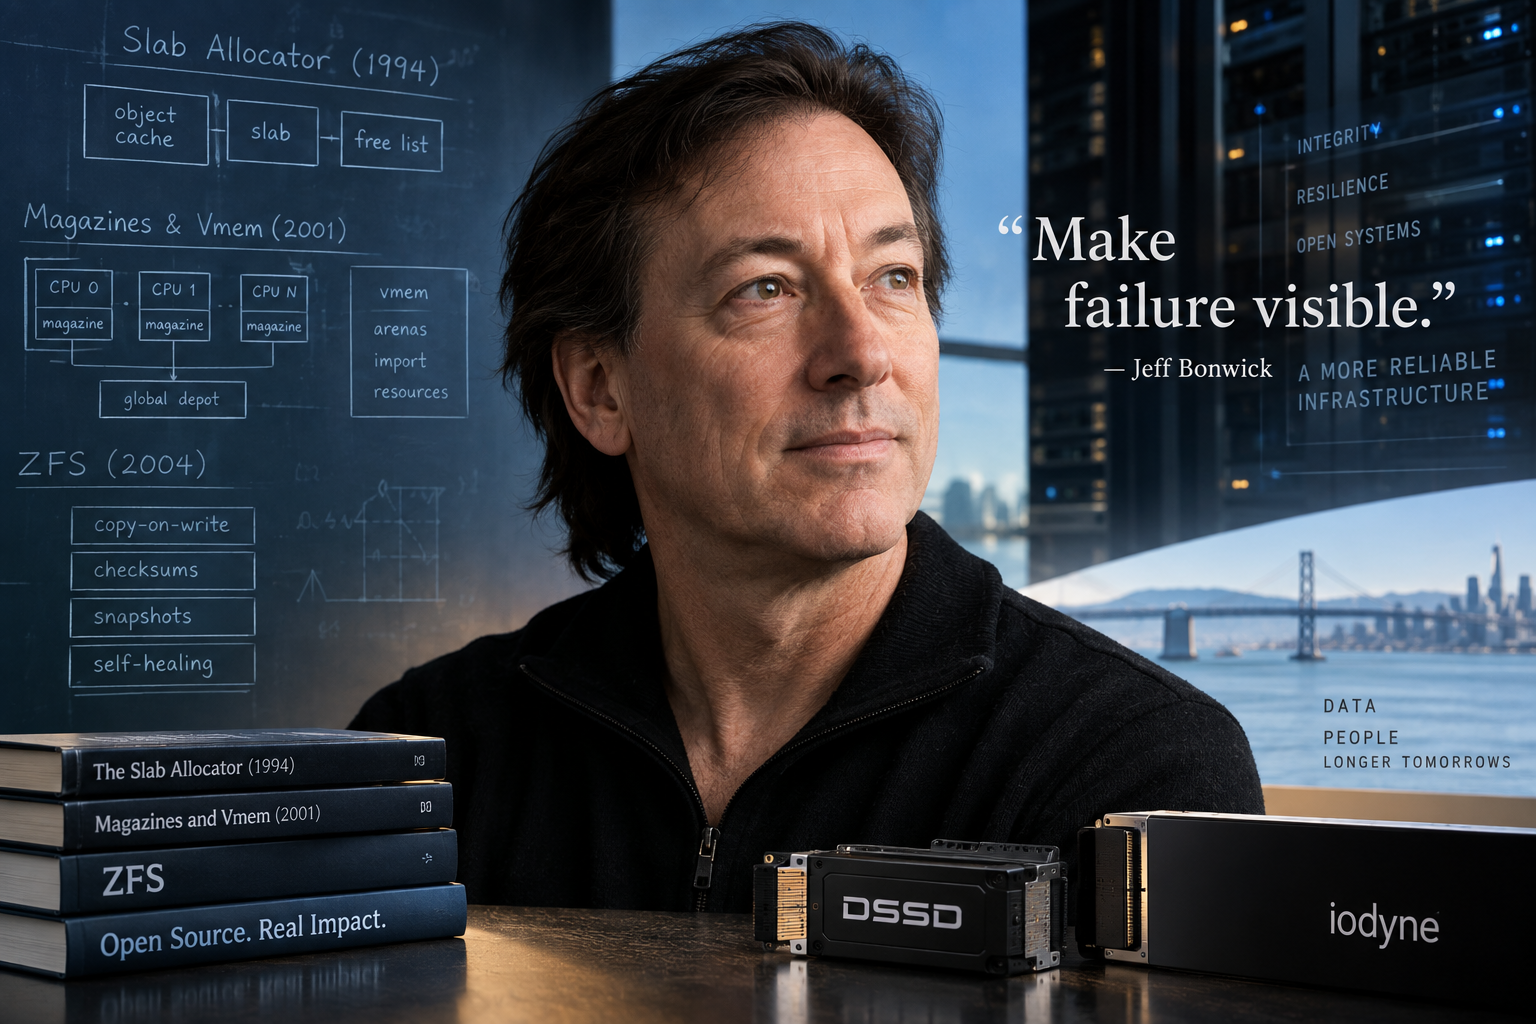
- O artigo de Bonwick de 1994 sobre o alocador slab tratou os objetos do kernel como estruturas tipadas e reutilizáveis, não como blocos anônimos de memória, e influenciou implementações posteriores em vários sistemas operacionais.
- Seu trabalho de 2001 com Jonathan Adams, sobre magazines por processador e o alocador vmem, estendeu a ideia a sistemas multiprocessados e a recursos além da memória convencional.
- Bonwick iniciou o ZFS com Matt Ahrens e liderou uma equipe mais ampla na Sun que reuniu pools de armazenamento, copy-on-write, verificação de ponta a ponta, snapshots e reparo; não é correto descrevê-lo como o único inventor.
- A aquisição da DSSD pela EMC, seguida do encerramento de seu produto independente, e o papel atual de Bonwick como copresidente da iodyne mostram que qualidade de projeto, valor de uma transação e permanência de um produto no mercado são coisas distintas.
Um sistema de armazenamento pode devolver o bloco errado sem informar um erro
A promessa básica do armazenamento é simples: quando o programa solicitar os dados mais tarde, deverá receber o que foi gravado. Na arquitetura tradicional, a responsabilidade se distribui entre o sistema de arquivos, o gerenciador de volumes, a controladora e o disco. Cada camada pode informar sucesso enquanto a cadeia completa devolve dados antigos, direcionados ao local errado ou corrompidos.
O ZFS armazena a soma de verificação do bloco filho no bloco pai, de modo que a identidade esperada se propague pela árvore de ponteiros separadamente do conteúdo que ela verifica. Na leitura, o sistema compara o resultado com o valor esperado mesmo que o dispositivo tenha informado sucesso. Se houver uma cópia correta em um espelho ou no RAID-Z, ele poderá ler a alternativa, verificá-la, devolver os dados corretos e reparar a cópia corrompida. Já o scrub percorre os dados alocados em busca de corrupção latente antes que o aplicativo precise deles.
Esse mecanismo explica a reputação de integridade do ZFS e também define seus limites. A soma de verificação detecta a divergência, mas não recria dados se todas as cópias estiverem erradas. A redundância tampouco substitui uma cópia de segurança independente, uma restauração testada ou uma boa distribuição física. Erros administrativos, ransomware com permissões legítimas, desastres e falhas correlacionadas podem ultrapassar os limites do projeto.
A contribuição de Bonwick foi tornar a falha silenciosa observável e inserir verificação e reparo no caminho normal. Ele não eliminou o risco de perda. O valor de uma boa arquitetura está em deixar claro onde terminam as garantias.
Antes do ZFS, ele reduziu o custo de criar objetos do kernel
O kernel cria continuamente estruturas para arquivos, conexões, processos e memória virtual. Esses objetos têm tipo, tamanho, invariantes e custo de inicialização. Solicitar memória bruta e depois construir e destruir o objeto a cada uso multiplica uma pequena quantidade de trabalho por todo o sistema.
O alocador slab descrito por Bonwick em 1994 organizava a memória em slabs e mantinha caches por classe de objeto. Os construtores inicializavam o estado necessário, os destrutores cuidavam da liberação e os objetos livres permaneciam disponíveis para reutilização. Assim, o kernel preservava informações sobre tipo e ciclo de vida e podia gerenciar melhor a localidade e a fragmentação, além de aprimorar a depuração e a contabilização.
A implementação original era específica do SunOS e do Solaris. Linux, FreeBSD e outros sistemas desenvolveram suas próprias implementações e decisões de projeto, portanto não se pode atribuir todo alocador moderno a Bonwick. Os caches consomem memória, podem reter estado residual e precisam ser reequilibrados sob pressão. O impacto duradouro foi reunir o custo de criação, a disputa por bloqueios, a localidade e o ciclo de vida em um único projeto.
Magazines por CPU tornaram o alocador adequado ao multiprocessamento
Um cache global se torna um gargalo quando muitos processadores disputam o mesmo bloqueio. EmMagazines and Vmem, de 2001, Bonwick e Jonathan Adams propuseram pequenos conjuntos locais para cada CPU. As operações comuns são executadas localmente, e as trocas com um depósito compartilhado ocorrem em lotes.
O vmem ampliou a abordagem em camadas para espaços de endereçamento, identificadores e outros recursos. As arenas importam recursos de um alocador inferior, permitindo que o sistema gerencie conjuntos e relações de propriedade em vez de sincronizar centralmente cada objeto.
A localidade tem um preço: objetos podem se acumular em uma CPU enquanto outra precisa deles, e o balanceamento e a pressão de memória continuam exigindo atenção. Os resultados das medições estavam ligados ao hardware e às cargas de trabalho da época. A ideia duradoura é preservar a informação que uma interface genérica perderia.
O ZFS começou com a decisão de uma equipe de reconstruir a camada de armazenamento
Bonwick e Matt Ahrens iniciaram o ZFS na Sun em 2001; depois, Bill Moore e muitos outros engenheiros participaram. Bonwick liderou o projeto e foi a figura mais proeminente em sua explicação pública, mas um sistema de arquivos de produção inclui formato em disco, caches, ferramentas, drivers, testes e anos de correções coletivas.
A abordagem tradicional exigia criar um RAID ou volume, particioná-lo antecipadamente e depois construir sistemas de arquivos com expectativas rígidas de crescimento. O ZFS reuniu o sistema de arquivos e o gerenciamento de volumes em torno de um pool. Os vdevs acrescentam capacidade, e os datasets a consomem dinamicamente, com cotas, reservas, snapshots e propriedades em um único modelo.
A simplicidade da operação cotidiana torna mais delicada a escolha inicial da topologia. A composição de um vdev define redundância, desempenho, expansão e comportamento diante de falhas, e nem tudo pode ser reconfigurado livremente depois. A Sun anunciou o sistema em 2004; ele entrou no OpenSolaris em 2005 e foi distribuído com o Solaris 10 em 2006.
A importância histórica não está em um único recurso, mas na união de pool, copy-on-write, somas de verificação, snapshots, RAID-Z, cache e administração em um modelo coerente de integridade.
O copy-on-write transformou a árvore inteira na unidade de confirmação
Gravar no mesmo local pode deixar os metadados entre dois estados quando há uma queda de energia. O ZFS grava novos blocos em novos locais, atualiza os blocos pais e depois muda atomicamente para uma nova raiz de um grupo de transações. A versão anterior permanece coerente até a conclusão da nova.
Os snapshots mantêm referências aos blocos antigos, enquanto os clones compartilham dados e depois divergem conforme recebem gravações. O preço está em gravações adicionais, fragmentação e espaço retido. As garantias também dependem de dispositivos e controladoras respeitarem a ordenação e a persistência.
O sistema investe em estrutura adicional para obter conhecimento: qual versão está completa, qual bloco é esperado e qual estado pode ser aceito. Esse conhecimento não elimina a camada física.
Somas de verificação e reparo mudaram o significado de uma leitura bem-sucedida
O ZFS verifica até mesmo uma operação que o dispositivo informou como bem-sucedida. Se a soma divergir, ele tenta outra cópia e pode reparar a versão corrompida ao encontrar uma correta. Os scrubs transformam isso em manutenção periódica que detecta corrupção enquanto houver redundância.
Detecção, reparo e recuperação completa são capacidades distintas. Um ransomware pode gravar dados criptografados com uma soma válida. Várias cópias podem falhar ao mesmo tempo. Uma cópia de segurança no mesmo domínio de falha não é independente. O operador precisa saber onde estão as cópias e qual recurso resta depois que a redundância planejada se esgota.
RAID-Z, ARC e scrub incorporaram a integridade à operação diária
O RAID-Z usa copy-on-write e faixas de paridade para evitar o write hole tradicional, mas os custos de pequenas gravações, reconstruções e falhas correlacionadas permanecem. Quanto maiores os discos, maior o período de exposição a uma segunda falha durante o reparo.
O ARC equilibra dados recentes e dados acessados com frequência, e caches secundários podem ampliar a hierarquia. Nenhum cache transforma uma mídia lenta em rápida para toda carga de trabalho, e é preciso medir a pressão sobre a memória e o peso dos metadados.
Scrubs, resilvering, exclusão de snapshots e replicação consomem recursos de I/O, CPU e rede. A folga para manutenção faz parte da capacidade; não é desperdício. Um pool que sempre opera no limite pode ser o mais frágil quando a recuperação se torna necessária.
Bonwick também ajudou a disseminar uma linguagem operacional compreensível: pool, vdev, grupo de transações e scrub. Essa linguagem facilitou a adoção, mas pode se transformar em slogans separados das condições que lhes dão validade.
O OpenSolaris terminou, mas o projeto ultrapassou a empresa que o criou
A Oracle adquiriu a Sun em 2010, e o caminho fechado do ZFS no Solaris se separou do código aberto. O OpenZFS foi criado em 2013 para coordenar illumos, FreeBSD, Linux e outras plataformas. O projeto atual descende do trabalho da Sun, mas mudou muito e não está sob o controle de Bonwick.
A continuidade mostra que um projeto pode ultrapassar uma instituição, mas isso não ocorreu sem atrito. A CDDL não se combina de forma simples com a GPL no kernel do Linux, as plataformas adotam recursos em momentos diferentes e as feature flags afetam a transferência de pools.
Um repositório aberto, por si só, não basta. São necessários mantenedores, testes, financiamento e lançamentos. A própria governança se torna um domínio institucional de falha. O OpenZFS faz parte do legado de Bonwick, mas é responsabilidade de quem o mantém hoje.
A DSSD mostrou que uma arquitetura ambiciosa pode perder a disputa de produto
Bonwick fundou a DSSD com Mike Shapiro e Bill Moore para criar um sistema flash em escala de rack destinado a bancos de dados e análises. A EMC adquiriu a empresa em 2014 e descontinuou o D5 como produto independente em 2017.
Isso encerra a narrativa de sucesso inevitável. Velocidade, originalidade e financiamento não garantem um lugar permanente. Migração, custo, certificações, suporte, canais de vendas, prioridades do comprador e a economia do NVMe ou da nuvem podem determinar o resultado tanto quanto um teste de desempenho.
As evidências não permitem apontar uma causa única nem estimar o patrimônio dos fundadores. Elas documentam a aquisição e o encerramento do produto. A DSSD separa valor técnico, valor da transação e continuidade comercial.
A iodyne aplica as mesmas questões à mídia profissional, sem recriar o ZFS
Bonwick e Shapiro fundaram a iodyne em 2018 e atuam como copresidentes. A empresa desenvolve armazenamento NVMe rápido, criptografado e replicado para equipes de vídeo e áudio.
A continuidade é intelectual: desempenho, proteção e reparo dentro de um fluxo de trabalho real. A iodyne não é “ZFS em uma caixa” nem uma extensão direta da DSSD; as escalas, interfaces, mercado e mecanismos são diferentes.
As páginas de produto comprovam os recursos anunciados, não a confiabilidade auditada, a receita ou a participação de mercado. Na produção de mídia, uma falha interrompe a edição e a entrega, a criptografia protege os ativos e a velocidade não tem valor se o trabalho dos usuários não puder continuar. A integração simplifica o suporte e concentra a dependência em um fornecedor proprietário.
A gestão passou a fazer parte do modelo de confiabilidade
O pool do ZFS reduz fronteiras administrativas que antes geravam erros. Datasets, cotas, reservas, snapshots e replicação compartilham uma única política, em vez de depender de uma sequência de ferramentas separadas.
Mas a responsabilidade permanece. Um dataset pode consumir o espaço do pool, snapshots podem reter blocos, e a replicação só é útil se o destino e a restauração funcionarem. Duas cópias lógicas podem compartilhar uma controladora, uma fonte de energia ou um defeito de firmware. É preciso vincular o modelo lógico aos domínios reais de falha.
Uma saída organizada dezfs listnão comprova que a organização consiga restaurar o aplicativo, preservar a consistência de seu banco de dados ou encontrar as credenciais necessárias para descriptografar os dados. A visão lógica simplifica a administração, mas não substitui testes de restauração nem o entendimento das dependências físicas e do aplicativo.
O alocador e o sistema de arquivos transformaram a manutenção em uma carga de trabalho de primeira classe
Os caches precisam ser preenchidos e equilibrados, enquanto os pools precisam ser inspecionados, reconstruídos e copiados. Essas tarefas competem com os usuários, mas determinam a continuidade da confiança. Recursos não utilizados podem ser a margem que permite concluir um reparo antes da próxima falha.
Isso também vale para o software. O OpenZFS precisa de testes, compatibilidade e lançamentos, enquanto a iodyne precisa manter o firmware, o software do host e o hardware após a venda. A invenção cria o sistema; a manutenção o transforma em infraestrutura.
A liderança técnica passou a significar definir limites nos quais outros pudessem trabalhar
A liderança de Bonwick foi importante e coletiva. Ahrens, Moore, Adams, a equipe da Sun e os mantenedores posteriores precisam permanecer visíveis. Abstrações como caches, arenas, pools, datasets e grupos de transações permitiram dividir o trabalho sem perder um modelo comum.
A autoridade histórica não substitui a responsabilidade atual. Os mantenedores do OpenZFS decidem sobre o código de hoje, e a liderança da iodyne é compartilhada com Shapiro. Nomear os colaboradores esclarece onde agora estão as decisões, a manutenção e os compromissos.
Licença e governança tornaram-se outra forma de isolamento de falhas
Uma empresa pode mudar de estratégia. O código aberto permitiu que outros grupos dessem continuidade ao ZFS depois da Sun, mas a redundância institucional só funcionou porque eles tinham os direitos, o conhecimento e a capacidade real de lançar versões.
Duas ramificações sem mantenedores não são mais robustas do que dois discos atrás da mesma controladora. Empresas e voluntários fornecem recursos e também criam dependência. O OpenZFS sobreviveu técnica e institucionalmente.
O método recorrente é preservar a informação que as camadas finas descartam
O alocador genérico enxerga um tamanho, enquanto o slab vê o tipo e o ciclo de vida. Uma camada enxerga uma leitura bem-sucedida, enquanto o ZFS vê um bloco com uma identidade esperada. Um produto anuncia taxa de transferência, enquanto a operação precisa lidar com reparo, criptografia e continuidade.
A informação adicional tem um custo e pode ampliar o domínio de falha comum. Um bom projeto não oculta o maior número possível de componentes; ele torna visíveis os limites que a instituição consegue compreender e reparar.
O ZFS mudou a unidade de comparação no mercado de armazenamento
Ao integrar volumes, sistema de arquivos, somas de verificação, snapshots e reparo, o ZFS impôs a comparação do caminho completo. Diante de XFS, Btrfs, APFS, ReFS, Ceph ou uma matriz comercial, o que importa é o modelo de integridade, a topologia, o suporte e o caminho de saída, não apenas a lista de recursos.
Não há um vencedor universal. O produto comercial oferece hardware validado e um contrato; o código aberto oferece transparência e portabilidade; o sistema distribuído acrescenta escala e dependência de rede; e o equipamento especializado melhora o fluxo de trabalho, com o possível aumento da dependência de fornecedor.
A ideia de domínio de falha conecta memória, armazenamento e sobrevivência das empresas
Um domínio de falha pode ser um disco, um rack, um bloqueio global, uma empresa ou um fornecedor. As magazines reduzem a concentração em um único bloqueio, as somas de verificação reduzem a confiança cega no dispositivo e o OpenZFS reduz a dependência de uma única empresa.
A redundância precisa existir na camada do risco. Discos atrás de uma só controladora, cópias protegidas por uma única chave perdida ou ramificações sem mantenedores oferecem apenas uma aparência de robustez. A simplicidade pode esconder um destino compartilhado; é preciso mapear as correlações e testar uma recuperação independente.
O legado honesto está em perguntas melhores, não em uma garantia absoluta
O alocador slab influenciou os objetos do kernel, magazines e vmem ampliaram a alocação, o ZFS reuniu operação e integridade, o OpenZFS atravessou uma transformação institucional, a DSSD revelou o limite comercial e a iodyne continua tratando da mesma questão em outro mercado.
É correto descrever Bonwick como cocriador, líder de projeto e arquiteto, não como o único autor nem como a autoridade atual do OpenZFS. O ZFS detecta muitos casos de corrupção, mas precisa de uma cópia correta; o copy-on-write depende do hardware; o RAID-Z não substitui uma cópia de segurança; e um scrub não garante a próxima leitura.
O teste visível é saber se os sistemas atuais respondem às perguntas que o trabalho de Bonwick tornou inevitáveis: o que o alocador sabe sobre o objeto? Onde fica o valor esperado para verificar o bloco? Qual estado está completo? As cópias são realmente independentes? Quem restaura os dados depois que a redundância se esgota? As conclusões também devem respeitar a ausência de um levantamento completo, a falta de uma distribuição precisa das contribuições ao ZFS e a inexistência de dados auditados sobre a iodyne. Essa precisão faz parte da mesma disciplina.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance