
Em resumo
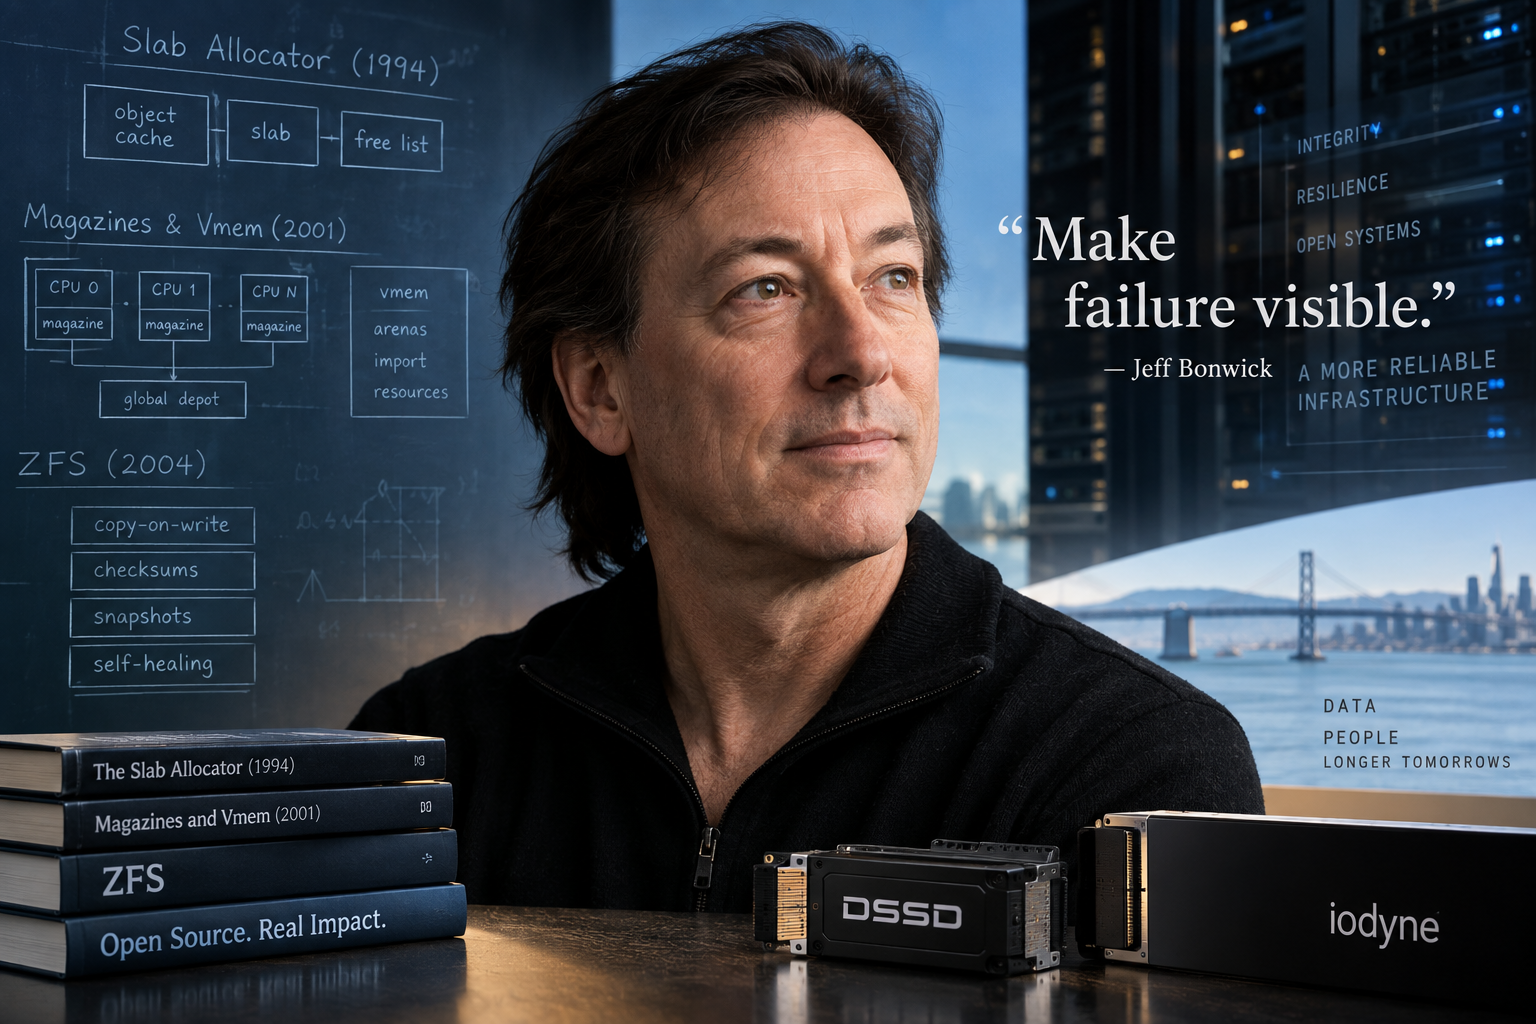
- Em um artigo de 1994, Бонвик descreveu o alocador slab, que trata os objetos do kernel como estruturas tipadas reutilizáveis, e não como blocos anônimos de memória; esse modelo influenciou outros sistemas operacionais.
- Em 2001, junto com Джонатан Адамс, ele desenvolveu a ideia com magazines locais de CPU e o alocador vmem, estendendo-a a sistemas multiprocessados e a recursos além da memória convencional.
- Бонвик iniciou o ZFS com Мэтт Аренс e liderou a equipe mais ampla da Sun que reuniu pools, copy-on-write, somas de verificação de ponta a ponta, snapshots e recuperação; chamá-lo de único inventor é incorreto.
- A compra da DSSD e a posterior descontinuação do produto independente, seguidas pelo atual cargo de copresidente da iodyne, mostram que uma arquitetura robusta, o valor de uma aquisição e um mercado de produto sustentável são coisas diferentes.
Um sistema de armazenamento pode devolver o bloco errado sem informar um erro
A promessa básica do armazenamento parece simples: ao ler, o aplicativo deve receber o que foi gravado. Em uma pilha tradicional, a responsabilidade fica distribuída entre o sistema de arquivos, o gerenciador de volumes, o controlador e a unidade. Cada parte pode indicar sucesso mesmo que a cadeia completa tenha devolvido dados desatualizados, redirecionados ou corrompidos.
O ZFS armazena a soma de verificação de um bloco filho no bloco pai. A identidade esperada percorre a árvore de ponteiros e permanece separada do conteúdo que está sendo verificado. Na leitura, o ZFS compara o bloco recebido com o que era esperado. Se houver uma cópia correta em espelho ou por paridade, o sistema poderá lê-la, verificá-la, devolver os dados corretos e reparar a réplica corrompida. O scrub aplica a mesma lógica aos dados alocados antes que o aplicativo detecte a corrupção.
O mecanismo explica a reputação do ZFS e seus limites. A soma de verificação detecta a divergência, mas não recria os dados se todas as cópias estiverem erradas. A redundância não substitui uma cópia de segurança independente, uma recuperação testada e uma topologia física sensata. Um erro administrativo, um ransomware com permissões legítimas, um incêndio ou uma falha correlacionada podem ultrapassar o modelo.
A contribuição de Бонвик foi tornar observável uma falha silenciosa e incorporar a verificação e a correção ao caminho normal de operação. O risco de perda não desapareceu. Uma boa arquitetura é valiosa porque mostra com mais precisão o limite das garantias.
Antes do ZFS, Бонвик tornou os objetos do kernel mais baratos e compreensíveis
O kernel aloca constantemente estruturas para arquivos, conexões, processos e memória virtual. Elas têm tipo, tamanho, invariantes e custo de inicialização. Solicitar memória bruta, criar o objeto e destruí-lo a cada vez significa multiplicar uma pequena quantidade de trabalho por todo o sistema.
O alocador slab do artigo de 1994 organiza a memória em slabs e mantém caches por classes de objetos. Construtores preparam o estado, destrutores liberam recursos e objetos livres permanecem disponíveis para reutilização. O kernel preserva o conhecimento do tipo e pode melhorar a localidade e o controle da fragmentação, da depuração e da contabilização.
A implementação original fazia parte do SunOS e do Solaris. Linux, FreeBSD e outros sistemas criaram seu próprio código e seus próprios compromissos de projeto. Não se pode atribuir a Бонвик todos os alocadores modernos. Os caches consomem memória, podem reter estado em excesso e precisam ser balanceados sob pressão. A principal conquista foi tornar explícito o modelo dos custos de criação, bloqueio, localidade e ciclo de vida.
Magazines locais transformaram o alocador em uma arquitetura multiprocessada
Um cache global se torna um gargalo quando muitas CPUs disputam o mesmo bloqueio. No trabalhoMagazines and Vmem, de 2001, Бонвик e Джонатан Адамс propuseram pequenos conjuntos locais de objetos para cada processador. As operações frequentes ocorrem localmente, e a troca com o depot compartilhado é feita em lotes.
O Vmem estendeu a abordagem em camadas a intervalos de endereços, identificadores e outros recursos. Arenas importam capacidade de um alocador subjacente. A unidade de coordenação muda: o sistema gerencia grupos e relações de propriedade, em vez de administrar cada objeto de forma centralizada.
A localidade tem um custo. Objetos podem se acumular em uma CPU enquanto faltam em outra; o balanceamento e a coordenação continuam necessários. Os resultados históricos se referem a hardware específico. A ideia duradoura é não descartar informações que uma interface genérica perderia.
O ZFS começou com a decisão de uma equipe de reconstruir a pilha de armazenamento
Бонвик e Мэтт Аренс começaram a trabalhar no ZFS na Sun em 2001. Mais tarde, Билл Мур e muitos engenheiros se juntaram a eles. Бонвик liderou o projeto e o explicou ao público, mas um sistema de arquivos maduro inclui o formato em disco, caches, ferramentas, drivers, testes e anos de depuração coletiva.
O modelo anterior exigia criar um RAID ou volume, particioná-lo e, sobre ele, construir sistemas de arquivos com previsões rígidas de crescimento. O ZFS reuniu o sistema de arquivos e o gerenciamento de volumes em torno de um pool. Os vdevs fornecem capacidade e os datasets a utilizam dinamicamente; cotas, reservas, snapshots e propriedades coexistem em um único modelo.
A simplicidade no uso diário aumenta a importância da topologia inicial. O esquema de vdev determina redundância, desempenho, expansão e tolerância a falhas. Um pool não pode ser reconstruído arbitrariamente depois. A Sun anunciou o ZFS em 2004, abriu o código no OpenSolaris em 2005 e o distribuiu com o Solaris 10 em 2006.
A importância histórica não está em um único recurso, mas no funcionamento conjunto de pool, copy-on-write, somas de verificação, snapshots, RAID-Z, cache e administração.
Copy-on-write tornou a árvore inteira a unidade de confirmação
Uma atualização no local pode deixar os metadados entre o estado antigo e o novo. O ZFS grava novos blocos, atualiza os pais e muda atomicamente para uma nova raiz do grupo de transações. Antes da confirmação, a versão anterior permanece consistente.
Snapshots mantêm referências a blocos antigos; clones compartilham dados e divergem à medida que novas gravações ocorrem. O custo está em gravações adicionais, fragmentação e retenção de espaço. As garantias ainda dependem de dispositivos e controladores respeitarem a ordem e a persistência das gravações.
O sistema investe em estrutura para saber mais: qual versão está completa, qual bloco era esperado e qual raiz pode ser confirmada. Esse conhecimento não elimina a máquina física.
Somas de verificação e autorreparo mudaram o significado de uma leitura bem-sucedida
O ZFS verifica até uma operação que a unidade considera bem-sucedida. Diante de uma incompatibilidade, o sistema tenta outra cópia e, ao encontrar uma correta, pode reparar a danificada. Scrubs transformam a reação em manutenção programada e detectam erros latentes enquanto ainda existe redundância.
Detecção, reparo e recuperação completa são capacidades diferentes. Um ransomware pode gravar dados criptografados com somas de verificação válidas. Várias cópias podem falhar juntas. Uma cópia de segurança no mesmo domínio de falha não é independente. O operador precisa saber quais cópias existem e o que permanecerá disponível quando a redundância planejada se esgotar.
RAID-Z, ARC e scrubs vincularam a integridade à operação cotidiana
O RAID-Z usa copy-on-write e faixas de paridade para evitar o write hole clássico. Permanecem o custo das pequenas gravações, da reconstrução e das falhas correlacionadas. Discos grandes ampliam o período de vulnerabilidade durante a recuperação.
O ARC equilibra dados lidos recentemente e com frequência; caches secundários ampliam a hierarquia. Nenhum cache torna um meio lento rápido para todas as cargas de trabalho. Memória, metadados e comportamento da carga precisam ser medidos.
Scrubs, resilvering, exclusão de snapshots e replicação consomem I/O, CPU e rede. A margem para manutenção faz parte da capacidade. Um pool que opera constantemente no limite pode ser o menos capaz de se recuperar.
Бонвик também ofereceu aos operadores um vocabulário claro: pool, vdev, transaction group, scrub. Isso ajudou na disseminação, mas fórmulas curtas não devem perder suas condições de aplicabilidade.
OpenSolaris terminou, mas o projeto sobreviveu à empresa que o criou
A Oracle adquiriu a Sun em 2010, e as linhas proprietária e aberta se separaram. O OpenZFS surgiu em 2013 para coordenar as comunidades de illumos, FreeBSD, Linux e outras. O projeto contemporâneo deriva do código da Sun, mas foi substancialmente modificado e não é controlado por Бонвик.
Essa continuidade demonstra que uma arquitetura pode sobreviver a uma instituição. O processo não foi sem atritos: a CDDL não se combina de modo simples com a GPL do kernel Linux, as plataformas adotam recursos em ritmos diferentes e os sinalizadores de recursos afetam a portabilidade dos pools.
Um repositório público não basta. São necessários mantenedores, testes, financiamento e lançamentos de versões. A governança se torna um domínio de falha institucional. O OpenZFS faz parte do legado de Бонвик, mas, operacionalmente, pertence aos responsáveis atuais.
DSSD mostrou que uma arquitetura ambiciosa pode perder a disputa de produto
Бонвик fundou a DSSD com Майк Шапиро e Билл Мур para criar um sistema flash em escala de rack. A EMC comprou a empresa em 2014 e, em 2017, o D5 deixou de ser um produto independente.
Esse episódio desmonta a narrativa do sucesso inevitável. Desempenho, originalidade e capital não garantem uma posição sustentável. Migração, custo, certificação, suporte, canais de vendas, prioridades do comprador e a economia do NVMe ou da nuvem podem importar mais do que um benchmark.
As fontes não permitem apontar uma única causa nem estimar o patrimônio pessoal dos fundadores. Elas confirmam a aquisição e a descontinuação do produto. A DSSD separa valor técnico, valor da transação e sobrevivência comercial.
Iodyne leva questões conhecidas à mídia profissional, não cria uma nova ZFS
Бонвик e Шапиро fundaram a iodyne em 2018 e são copresidentes. A empresa fabrica armazenamento NVMe rápido, criptografado e redundante para produção de vídeo e áudio.
A continuidade é conceitual: desempenho, proteção e reparo em um fluxo de trabalho real. A iodyne não é “ZFS em uma caixa” nem uma continuação direta da DSSD. Escala, interfaces, mercado e mecanismos são diferentes.
As páginas dos produtos confirmam os recursos declarados, mas não uma confiabilidade auditada, participação de mercado ou receita. Na produção de mídia, uma falha interrompe a edição e a entrega; a criptografia protege os ativos; a velocidade tem valor se vários usuários conseguem continuar trabalhando. A integração simplifica o suporte e concentra a dependência de um fornecedor privado.
A administração passou a integrar o modelo de confiabilidade
Um pool do ZFS reduz fronteiras administrativas que por si mesmas geravam erros. Datasets, cotas, reservas, snapshots e replicação vivem sob uma única política, em vez de uma cadeia de ferramentas desconectadas.
A responsabilidade não desaparece. Um único dataset pode encher o pool, snapshots retêm blocos e a replicação só ajuda quando há um destino funcional e uma recuperação testada. Duas cópias lógicas podem compartilhar controlador, alimentação elétrica ou um defeito de firmware. O modelo lógico deve ser comparado ao físico.
Uma saída impecável dezfs list, por si só, não prova que a organização recuperará um aplicativo, preservará a consistência do banco de dados ou encontrará as chaves de descriptografia. A representação lógica simplifica a administração, mas não substitui uma recuperação testada nem o conhecimento das dependências físicas e da aplicação.
O alocador e o sistema de arquivos tornaram a manutenção uma carga de trabalho de primeira classe
Os caches precisam ser reabastecidos e balanceados; os pools, verificados, reconstruídos e replicados. Esse trabalho compete com as cargas dos usuários, mas determina a durabilidade. Recursos livres podem ser a reserva que permite concluir um reparo antes da próxima falha.
O mesmo vale para o software. O OpenZFS precisa de testes, compatibilidade e lançamentos; a iodyne deve dar suporte a firmware, software do host e hardware após a venda. A invenção cria um sistema; a manutenção o transforma em infraestrutura.
Liderança técnica significou definir limites para o trabalho de outros engenheiros
A liderança de Бонвик foi importante e coletiva. Аренс, Мур, Адамс, a equipe da Sun e os mantenedores posteriores devem permanecer visíveis. Abstrações — caches, arenas, pools, datasets, transaction groups — permitiram dividir o trabalho dentro de um modelo comum.
A autoridade histórica não substitui a responsabilidade atual. As decisões sobre o código atual cabem aos mantenedores do OpenZFS. Na iodyne, a liderança é compartilhada com Шапиро. Nomear os participantes é mostrar onde estão a decisão, o suporte e o compromisso.
A licença e a governança se tornaram outra forma de isolamento de falhas
Uma empresa pode mudar de estratégia. O código aberto permitiu que outros grupos continuassem o ZFS depois da Sun. Essa redundância só funcionou porque havia direitos, conhecimento e capacidade real de lançar versões.
Duas ramificações sem mantenedores não são mais confiáveis do que dois discos atrás do mesmo controlador. Empresas e voluntários fornecem recursos e, ao mesmo tempo, criam dependências. O OpenZFS sobreviveu tanto institucional quanto tecnicamente.
O método recorrente preserva informações que camadas finas descartam
Um alocador genérico vê o tamanho; o slab vê o tipo e o ciclo de vida. A pilha vê uma leitura bem-sucedida; o ZFS vê um bloco com a identidade esperada. O produto promete vazão; a operação considera reparo, criptografia e continuidade.
As informações adicionais consomem recursos e podem ampliar o domínio de falha compartilhado. Um bom projeto não apenas oculta componentes; ele expõe os limites que a organização é capaz de compreender e recuperar.
ZFS mudou a unidade de comparação no armazenamento
Ao reunir volumes, sistema de arquivos, somas de verificação, snapshots e reparo, o ZFS obrigou a comparar o caminho completo. Em uma disputa com XFS, Btrfs, APFS, ReFS, Ceph ou um sistema comercial de armazenamento, importam o modelo de integridade, a topologia, o suporte e a estratégia de saída, não uma lista de recursos.
Não há vencedor universal. Um produto comercial oferece hardware validado e contrato; o código aberto, transparência e portabilidade; um sistema distribuído, escala com dependências de rede; um equipamento especializado, fluxo de trabalho otimizado e possível dependência de fornecedor.
O pensamento em domínios de falha conecta memória, armazenamento e sobrevivência de empresas
Um domínio de falha pode ser um disco, um rack, um bloqueio global, uma empresa ou um fornecedor. Magazines reduzem a concentração em um único bloqueio; somas de verificação reduzem a confiança cega no dispositivo; o OpenZFS reduz a dependência de uma única empresa.
A redundância precisa estar no nível da ameaça. Discos atrás do mesmo controlador, cópias protegidas pela mesma chave perdida ou ramificações sem mantenedores apenas imitam resiliência. A simplificação pode ocultar um destino comum; as correlações precisam ser mapeadas e a recuperação independente, testada.
Um legado honesto oferece perguntas melhores, não uma garantia absoluta
O alocador slab influenciou o trabalho com objetos; magazines e vmem ampliaram a escala da alocação; o ZFS reuniu operação e integridade; o OpenZFS sobreviveu a uma transição institucional; a DSSD mostrou o limite comercial; a iodyne continua o tema em outro mercado.
É correto chamar Бонвик de coautor, líder e arquiteto, mas não de único autor nem de atual gestor do OpenZFS. O ZFS detecta muitas formas de corrupção, mas precisa de uma cópia válida; copy-on-write depende do hardware; RAID-Z não substitui uma cópia de segurança; scrub não garante uma leitura futura.
O teste observável é saber se os sistemas continuam respondendo às perguntas que seu trabalho tornou inevitáveis: o que o alocador sabe sobre o objeto? Onde se armazena a expectativa usada para verificar o bloco? Qual estado está completo? As cópias são realmente independentes? Quem recupera o sistema quando a redundância se esgota? A ausência de um levantamento completo, de uma distribuição precisa das contribuições e de dados auditados da iodyne deve permanecer visível. Essa precisão faz parte da mesma disciplina.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance