
Resumo
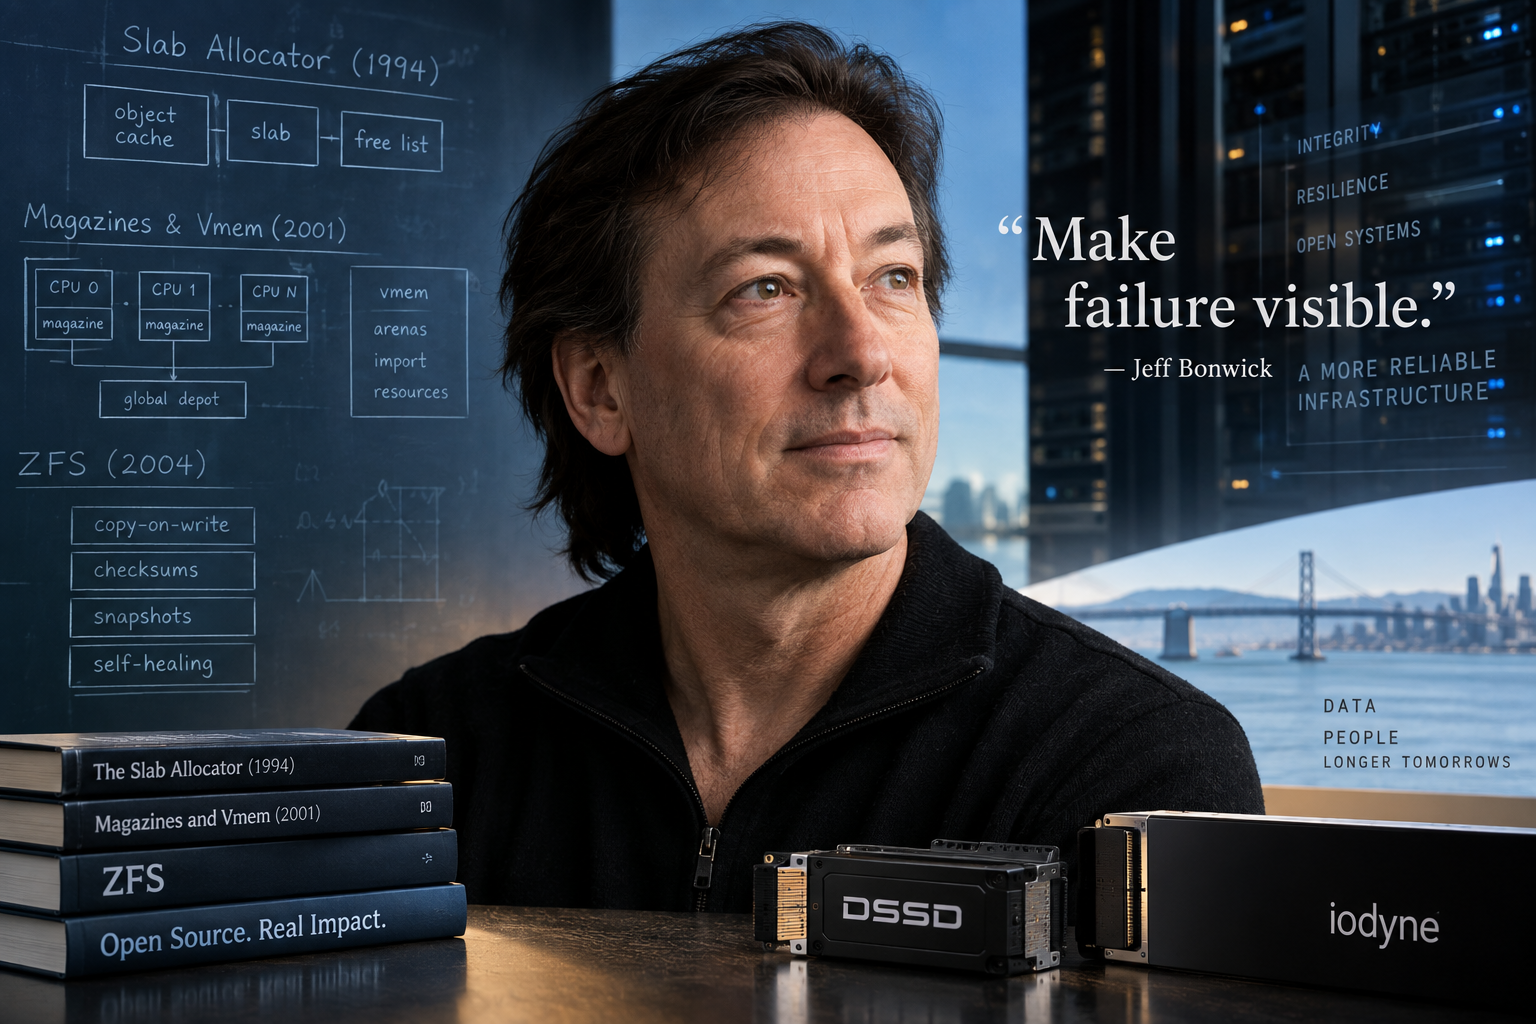
- O artigo de 1994 de Jeff Bonwick sobre o alocador slab tratava objetos do kernel como estruturas tipadas reutilizáveis, e não como blocos anônimos de memória, ajudando a estabelecer um modelo de alocação posteriormente adaptado em vários sistemas operacionais.
- Seu trabalho de 2001 com Jonathan Adams sobre magazines por CPU e o alocador vmem ampliou essa abordagem para a escala de multiprocessadores e para recursos além da memória comum.
- Bonwick iniciou o ZFS com Matt Ahrens e liderou uma equipe maior da Sun que combinou armazenamento em pool, transações de cópia na gravação, somas de verificação de ponta a ponta, snapshots e reparo; ele não deve ser apresentado como seu único inventor.
- A aquisição da DSSD e a posterior descontinuação do produto, seguidas pelo papel atual de Bonwick como copresidente da iodyne, mostram que força arquitetônica, sucesso comercial e adequação duradoura do produto são questões distintas.
Um sistema de armazenamento pode devolver o bloco errado sem admitir isso
A promessa mais importante do armazenamento é fácil de enunciar e difícil de cumprir: quando um software solicita dados, o sistema deve devolver os dados que foram gravados. As camadas tradicionais costumam dividir essa responsabilidade. Um sistema de arquivos gerencia nomes e blocos. Um gerenciador de volumes combina dispositivos. Um controlador movimenta solicitações. Uma unidade armazena setores. Cada camada pode verificar se sua própria operação foi concluída, mas a pilha completa ainda pode entregar dados obsoletos, direcionados ao local errado ou corrompidos sem que nenhum componente declare uma falha.
O trabalho mais visível de Jeff Bonwick atacou essa lacuna. O ZFS armazena a soma de verificação de um bloco filho em seu bloco pai, em vez de colocá-la ao lado dos dados que ela protege. Assim, a identidade esperada de um bloco percorre uma árvore de referências. Quando o ZFS lê um bloco, pode comparar o que chegou com o que o bloco pai diz que deveria ter chegado. Se houver uma cópia espelhada ou de paridade disponível, ele pode tentar outro local, verificar a alternativa e reparar a cópia danificada.
Uma varredura de integridade (scrub) aplica a mesma lógica a todos os dados alocados antes que uma aplicação descubra o problema no pior momento possível.
Esse mecanismo explica por que o ZFS adquiriu reputação de integridade. Também explica por que essa reputação é frequentemente exagerada. Uma soma de verificação pode detectar uma divergência; não pode recriar um bloco quando todas as cópias estão erradas ou ausentes. A redundância pode reparar algumas falhas; não pode substituir um backup independente, um procedimento de recuperação testado ou um projeto físico sólido.
Um pool pode sobreviver aos padrões de falha para os quais foi projetado e ainda assim perder dados por falhas correlacionadas de dispositivos, erro do operador, software destrutivo, incêndio, furto ou uma topologia que colocou cópias supostamente independentes no mesmo domínio de falha.
A contribuição de Bonwick, portanto, é mais precisa do que a mitologia ao redor dela. Ele ajudou a tornar observáveis as falhas silenciosas e fez da redundância verificada parte do caminho normal de leitura. Não aboliu o risco de armazenamento. A distinção importa porque os projetos de infraestrutura mais robustos muitas vezes são valiosos não por prometerem perfeição, mas por exporem mais claramente as condições em que podem falhar.
Antes do ZFS, Bonwick tornou os objetos do kernel mais baratos de criar e mais fáceis de compreender
O registro técnico público começa não com discos, mas com a memória do kernel. Os sistemas operacionais alocam continuamente estruturas para arquivos, conexões de rede, processos, mapeamentos de memória virtual e outros objetos internos. Eles não são recipientes intercambiáveis de bytes. Um objeto tem um tipo, um tamanho, invariantes, campos que exigem inicialização e, muitas vezes, um ciclo de vida previsível. Pedir repetidamente memória bruta a um alocador genérico, construir o objeto e depois desmontá-lo impõe trabalho justamente na camada em que pequenos custos se multiplicam por toda a máquina.
O artigo de Bonwick de 1994 sobre o alocador slab propôs caches de objetos pré-inicializados. A memória é organizada em slabs, e cada cache atende a uma classe de objeto. Construtores estabelecem o estado exigido pelo objeto; destruidores cuidam da desmontagem quando necessário; objetos livres permanecem disponíveis para reutilização. O alocador pode preservar inicializações úteis, reduzir a fragmentação e melhorar a localidade porque o kernel sabe que tipo de objeto está gerenciando, em vez de tratar cada solicitação como uma contagem de bytes sem relação com as demais.
O projeto também ofereceu um lugar mais claro para depuração e contabilização. Um alocador que compreende tipos de objeto pode detectar algumas formas de uso indevido e informar o comportamento no nível do cache. Técnicas de posicionamento nos slabs, incluindo a variação dos deslocamentos dos objetos, pretendiam reduzir conflitos prejudiciais de cache no hardware da época. Esses detalhes não eram meras micro-otimizações. Refletiam uma preferência de projeto que reapareceria mais tarde: preservar a estrutura em vez de descartá-la e explicitar as regras do ciclo de vida na camada que as controla.
A implementação original estava vinculada ao SunOS e ao Solaris. Alocadores posteriores do Linux e do FreeBSD recorreram a ideias relacionadas, mas desenvolveram código, terminologia e compromissos próprios. É seguro dizer que o modelo slab se tornou influente; não é seguro atribuir a Bonwick todos os alocadores posteriores nem tratar um benchmark de 1994 como garantia para processadores modernos. Caches de objetos consomem memória mesmo quando os objetos estão ociosos. Construtores podem preservar pressupostos obsoletos. Recursos de depuração custam tempo e espaço.
O alocador precisa equilibrar a reutilização com a pressão existente em outras partes do sistema.
Esses limites reforçam, em vez de enfraquecer, o ponto histórico. Bonwick não descobriu um atalho sem custos. Ele tornou visível o modelo de custos: construção, bloqueio, localidade de cache, fragmentação e depuração podiam ser projetados em conjunto, em vez de permanecerem como consequências acidentais de uma interface genérica de memória.
Magazines por CPU transformaram um bom alocador em um projeto multiprocessador
Um cache global de objetos funciona bem até que muitos processadores disputem o mesmo bloqueio. À medida que aumentava o número de CPUs nos servidores, a alocação se tornou um problema de concorrência. O artigo de 2001Magazines and Vmem, escrito por Bonwick com Jonathan Adams, tratou diretamente dessa escala. O artigo introduziu magazines por CPU: pequenas coleções de objetos que um processador pode alocar e liberar sem adquirir o bloqueio do cache compartilhado a cada operação.
O nome captava o ritmo operacional. Uma CPU utiliza objetos de um magazine local, devolve-os localmente e troca magazines com um depósito compartilhado em lotes. A maioria das operações do caminho rápido evita a contenção global. Quando um magazine local esvazia ou enche, o sistema movimenta um lote, em vez de coordenar cada objeto individualmente. O projeto melhora a concorrência porque altera a unidade de coordenação.
O mesmo artigo descreveu o vmem, um alocador geral de recursos baseado em arenas. Kernels alocam muito mais do que memória física. Eles gerenciam intervalos de endereços virtuais, identificadores e outros recursos que podem ser importados de um alocador subjacente e subdivididos para clientes. O vmem oferecia uma interface em camadas para esses recursos, em vez de exigir que cada subsistema inventasse seu próprio alocador de intervalos.
Mais uma vez, a ideia importante era o posicionamento arquitetônico. Os caches por CPU colocam a atividade comum perto do processador que a utiliza; as estruturas compartilhadas cuidam do balanceamento e da reposição. O vmem separa a política de uma arena da origem do recurso abaixo dela. O projeto torna explícitas as relações de propriedade e importação.
A localidade tem um preço. Objetos podem se acumular de maneira desigual entre CPUs. Um processador pouco utilizado pode manter objetos livres enquanto outro precisa de mais. A movimentação em lotes, a pressão de memória e as liberações entre CPUs ainda exigem coordenação. Os grandes ganhos de desempenho relatados em artigos históricos pertenciam a máquinas, cargas de trabalho e implementações específicas. Demonstram que o mecanismo funcionava nas condições medidas, não que todos os alocadores posteriores reproduzirão os mesmos números.
O trabalho inicial de Bonwick é relevante para sua carreira em armazenamento porque ambos começaram pela rejeição de uma abstração aparentemente simples. A memória bruta não era realmente anônima; continha objetos tipados com históricos. Um bloco de disco não era apenas um setor numerado; tinha uma identidade esperada, um contexto transacional e uma relação com outros blocos. Em cada caso, o sistema se tornou mais confiável quando a arquitetura reteve informações que uma camada mais fina teria descartado.
O ZFS começou com a decisão de uma equipe de redesenhar a pilha de armazenamento
Bonwick e Matt Ahrens começaram a trabalhar no ZFS na Sun em 2001. O projeto cresceu e se tornou um amplo esforço de engenharia que incluía Bill Moore e muitas outras pessoas. Bonwick liderou o projeto e se tornou seu defensor público mais destacado, mas as evidências não sustentam descrevê-lo como o único inventor do ZFS nem como o autor de todos os mecanismos que o compõem. A distinção não é meramente cerimonial. Sistemas de arquivos combinam algoritmos, formatos em disco, cache, administração, tratamento de dispositivos e anos de depuração em produção. Sua maturidade é coletiva.
A equipe partiu da insatisfação com o modelo de armazenamento em camadas da época. Administradores frequentemente criavam um conjunto RAID ou um volume, dividiam-no em volumes lógicos fixos, construíam sistemas de arquivos sobre eles e tentavam prever a capacidade futura. Ampliar uma carga de trabalho podia exigir reduzir ou reconstruir outra. Cada camada mantinha conhecimento parcial do sistema e oferecia suas próprias ferramentas, estados de falha e metadados.
O ZFS combinou funções de sistema de arquivos e gerenciamento de volumes em torno de um pool de armazenamento compartilhado. Os dispositivos são organizados em dispositivos virtuais, ou vdevs, e o pool aloca capacidade dinamicamente entre conjuntos de dados. Administradores podem criar sistemas de arquivos, volumes, snapshots, cotas e reservas sem pré-particionar todo o espaço disponível em segmentos rígidos. Essa integração reduziu uma classe de complexidade no planejamento e na linha de comando.
Ela também aumentou as consequências das decisões iniciais de projeto. A disposição dos vdevs determina a redundância, a capacidade, o desempenho e grande parte do comportamento do pool diante de falhas. Um pool não é um recipiente mágico ao qual dispositivos arbitrários podem ser adicionados e reorganizados sem restrições. Expansão, substituição e migração dependem da topologia e dos recursos compatíveis. Simplificar a alocação cotidiana não elimina a necessidade de projetar os domínios de falha subjacentes.
A Sun anunciou publicamente o ZFS em 2004. O código entrou no desenvolvimento do OpenSolaris em 2005 e foi lançado em uma atualização do Solaris 10 em 2006. Essa sequência levou o projeto da pesquisa e engenharia internas para um produto de sistema operacional e depois para um contexto de desenvolvimento aberto. Também criou as condições para que o ZFS sobrevivesse à estrutura corporativa que o produziu.
A importância histórica do projeto não se apoia em um único recurso. Armazenamento em pool, transações de cópia na gravação, somas de verificação, snapshots, redundância, cache e ferramentas administrativas se reforçam mutuamente. A afirmação central do sistema é que a gestão dos dados e sua integridade devem ser projetadas como um único mecanismo, em vez de montadas a partir de camadas que não conseguem verificar as premissas existentes entre elas.
A cópia na gravação fez de uma árvore completa, e não de um fragmento sobrescrito, a unidade de confirmação
Atualizações tradicionais feitas no próprio local podem deixar metadados presos entre estados antigos e novos quando falta energia ou um dispositivo não persiste as gravações conforme o esperado. Sistemas de arquivos com journaling reduzem esse perigo ao registrar as mudanças pretendidas e reproduzi-las ou revertê-las. O ZFS adotou uma abordagem mais ampla de cópia na gravação. Blocos modificados são gravados em novos locais; os blocos pais são atualizados para apontar para eles; o processo continua subindo pela árvore até que o sistema possa avançar de forma atômica para uma nova raiz de um grupo de transações.
O benefício prático é que a estrutura em disco não é transformada pela sobrescrita de cada bloco antigo em seu próprio local. Até que a nova árvore seja confirmada, a árvore anterior permanece uma versão coerente. Os snapshots exploram a mesma propriedade: um bloco antigo continua existindo enquanto um snapshot o referencia, e novas gravações alocam novos blocos. Clones podem compartilhar os dados existentes e divergir à medida que ocorrem mudanças.
A cópia na gravação também cria custos. Regravar caminhos pelas árvores de metadados aumenta a atividade de gravação. Pools antigos ou muito fragmentados podem apresentar desempenho diferente do observado em benchmarks limpos. Snapshots consomem pouco espaço ao serem criados, mas retêm blocos que, de outro modo, seriam liberados; assim, uma política descuidada de retenção pode transformar um recurso de recuperação aparentemente barato em pressão sobre a capacidade.
Cargas de trabalho com pequenas gravações aleatórias podem expor compromissos diferentes daqueles encontrados em grandes fluxos sequenciais de mídia ou no armazenamento de arquivos históricos.
Os grupos de transações tornam explícitas a ordenação e a confirmação, mas ainda dependem do hardware e das camadas inferiores. Dispositivos, controladores e firmware precisam respeitar comandos de flush e a semântica de persistência. Erros de memória podem afetar os dados antes que cheguem ao armazenamento estável. Proteção elétrica e redundância continuam sendo propriedades físicas, não abstrações do sistema de arquivos. A arquitetura reduz janelas específicas de falha; não torna a máquina subjacente irrelevante.
Essa é uma característica recorrente dos projetos de Bonwick. O sistema realiza mais trabalho para poder saber mais sobre o estado que está criando. Caches slab lembram o tipo e a construção do objeto. Árvores de cópia na gravação preservam versões anteriores até que um novo estado esteja completo. Somas de verificação nos blocos pais carregam a identidade esperada dos filhos. A estrutura adicional consome recursos, mas fornece ao sistema evidências para rejeitar ou reparar um resultado incorreto.
Somas de verificação e autorreparação mudaram o significado de uma leitura bem-sucedida
Uma unidade pode concluir uma solicitação e ainda devolver os dados errados. O erro pode surgir na mídia, em um controlador, cabo, memória, firmware ou software que direcionou a solicitação ao local incorreto. Uma soma de verificação armazenada com o mesmo bloco pode, às vezes, ser corrompida ou desviada junto com ele. O projeto de somas de verificação nos blocos pais do ZFS separa o valor esperado dos dados verificados e conecta a integridade à árvore de ponteiros de blocos.
Mesmo quando uma leitura é concluída com sucesso no nível do dispositivo, o ZFS verifica o resultado. Se a soma de verificação não corresponder, o sistema sabe que uma operação de entrada e saída nominalmente bem-sucedida não produziu o bloco esperado. Em um espelho, ele pode ler outra cópia. Em uma configuração RAID-Z adequada, pode reconstruir os dados a partir da paridade. Se encontrar um resultado válido, o ZFS pode devolver os dados corretos e reparar a réplica danificada. A pilha de armazenamento não apenas informa um erro à camada superior; utiliza a redundância para restaurar a consistência.
Os scrubs transformam esse mecanismo reativo em verificação programada. Ao percorrer os blocos alocados e conferir suas somas de verificação, um operador pode descobrir corrupção latente enquanto ainda existem cópias redundantes. Isso importa porque algumas falhas permanecem invisíveis até que dados raramente lidos sejam necessários durante outra falha. A verificação regular reduz a possibilidade de que a primeira leitura completa de um bloco antigo ocorra somente depois de o sistema perder a cópia necessária para repará-lo.
Nada disso torna um pool autossuficiente. Um scrub disputa recursos de entrada e saída e pode expor dispositivos frágeis sob carga. O reparo só é tão bom quanto os dados sobreviventes. Espelhos e paridade não protegem contra todas as falhas correlacionadas. Um processo de ransomware com acesso legítimo de gravação pode criar dados criptografados com somas de verificação perfeitamente válidas. Um administrador pode destruir um pool. Um incidente no prédio pode eliminar todas as cópias locais. Os backups precisam estar suficientemente separados para sobreviver às falhas contra as quais o pool principal não consegue se proteger.
A tentação editorial é transformar essas ressalvas em uma observação protocolar depois de celebrar o “armazenamento autorreparável”. A interpretação mais robusta é que as ressalvas fazem parte do projeto. O ZFS distingue entre detectar corrupção, localizar uma alternativa válida, reparar a cópia principal e recuperar os dados depois que todo o conjunto de redundância desaparece. São capacidades diferentes. Tratá-las como uma única promessa produz uma arquitetura ruim e confiança injustificada.
RAID-Z, ARC e scrubs ligaram a integridade às operações cotidianas
O RAID-Z tratou de um conhecido problema de paridade. No RAID convencional com paridade, as atualizações de dados e de paridade podem ser interrompidas em momentos diferentes, deixando-as inconsistentes — a lacuna de gravação, ou write hole. As transações de cópia na gravação e as faixas de paridade de largura variável do ZFS foram projetadas para que dados e paridade se tornassem parte de um único estado confirmado. O sistema evita a mesma sequência de atualizações no próprio local que cria a divergência clássica.
Os compromissos não desapareceram. Cálculos de paridade, reconstrução e pequenas gravações aleatórias têm custos. A substituição de um dispositivo com falha pode levar bastante tempo, e a reconstrução submete o pool a estresse adicional. Dispositivos maiores prolongam o período em que uma segunda falha é relevante. O formato da carga de trabalho, a largura do vdev, o tamanho do registro, a compressão e as condições do espaço livre influenciam os resultados. “RAID-Z” representa uma família de escolhas de implantação, não um único perfil de desempenho.
O recurso Adaptive Replacement Cache, ou ARC, do ZFS trata de outro problema operacional: as cargas de trabalho mudam. Alguns dados são valiosos porque foram lidos recentemente; outros, porque são lidos repetidamente. O ARC se ajusta entre esses padrões, em vez de exigir uma divisão fixa entre recenticidade e frequência. Dispositivos opcionais de cache secundário podem ampliar a hierarquia, enquanto dispositivos separados de log de intenção podem atender a projetos específicos de gravação síncrona.
Esses recursos são frequentemente apresentados como itens de uma lista de compras: adicione mais memória, um dispositivo de cache e um dispositivo de log. Na realidade, cada um interage com a carga de trabalho e o modelo de falhas. Mais cache pode ajudar, mas a memória também atende aos metadados e ao restante do sistema operacional. Um cache secundário não transforma um armazenamento de base lento em mídia de baixa latência para todas as cargas de trabalho. Um dispositivo de log mal escolhido pode se tornar um gargalo ou criar uma falsa sensação de segurança. A arquitetura oferece ferramentas; não escolhe corretamente pelo operador.
As explicações públicas de Bonwick ajudaram a tornar esses mecanismos compreensíveis. Essa comunicação fez parte do impacto sobre a infraestrutura. Sistemas complexos são adotados não apenas porque o código existe, mas porque os operadores conseguem formar um modelo mental de pools, vdevs, grupos de transações, snapshots, somas de verificação e recuperação. O perigo é que expressões memoráveis — armazenamento em pool, autorreparação, integridade de ponta a ponta — podem viajar mais longe do que as condições associadas a elas.
O OpenSolaris terminou, mas o projeto escapou da empresa que o criou
A Oracle adquiriu a Sun em 2010, e os caminhos do ZFS proprietário do Solaris e do código aberto divergiram. O OpenZFS surgiu em 2013 para coordenar o desenvolvimento entre illumos, FreeBSD, Linux e outras comunidades. O projeto atual deriva do trabalho realizado na Sun, mas o OpenZFS moderno contém anos de mudanças feitas depois da saída de Bonwick. Seus mantenedores, comunidades de plataformas e órgãos de governança — não Bonwick — controlam o projeto atual.
Essa separação é um dos testes mais fortes da arquitetura original. Um projeto que depende inteiramente da autoridade contínua de seu fundador é frágil. O ZFS sobreviveu a uma aquisição corporativa, ao fim do OpenSolaris como centro esperado de desenvolvimento, a diferentes integrações com sistemas operacionais e a longos debates sobre licenciamento. Isso foi possível porque o código, a documentação e o conhecimento de engenharia estavam disponíveis para uma comunidade mais ampla.
A sobrevivência não ocorreu sem atritos. A Common Development and Distribution License, sob a qual a Sun lançou o ZFS, criou questões de compatibilidade com o licenciamento GPL do kernel Linux. A adoção no Linux se desenvolveu por meio da distribuição de módulos separados e, mais tarde, de integrações mais maduras, em vez de uma simples incorporação à árvore principal. Diferentes plataformas adotaram recursos em momentos distintos. Pools podem enfrentar restrições de compatibilidade de sinalizadores de recursos quando são transferidos entre sistemas. “OpenZFS” descreve coordenação, não uniformidade perfeita.
Essa história posterior também posiciona a influência de Bonwick no enquadramento correto. Ele ajudou a estabelecer a arquitetura e liderou o projeto original. Não escreveu toda a base de código moderna nem decidiu todos os recursos posteriores. A continuidade do código aberto ampliou o valor do projeto ao mesmo tempo que reduziu o controle pessoal. Isso não é uma contradição. É o mecanismo pelo qual a infraestrutura se torna maior do que sua história de origem.
O mesmo ponto se aplica ao alocador slab. A ideia se difundiu por implementações e revisões independentes. A influência técnica muitas vezes se parece menos com um trecho de código executado sem alterações e mais com um conjunto de restrições e abstrações que outros engenheiros optam por preservar. A contribuição duradoura de Bonwick aparece nessas escolhas: preservar a identidade do objeto, tornar a alocação estratificada, confirmar estados completos, carregar somas de verificação pela árvore e tratar a recuperação como parte da operação normal.
A DSSD mostrou que uma arquitetura ambiciosa pode perder sua disputa de produto
Depois de deixar a Sun, Bonwick cofundou a DSSD com Mike Shapiro e Bill Moore. A empresa buscou desenvolver um sistema flash em escala de rack para cargas exigentes de bancos de dados e análise. A EMC adquiriu a DSSD em 2014. A aquisição deu recursos ao empreendimento e um lugar dentro de uma grande empresa de armazenamento, e o produto D5 incorporou um projeto de hardware e software fortemente integrado.
O produto independente da DSSD foi descontinuado em 2017. Esse resultado é essencial para um perfil rigoroso porque interrompe a narrativa fácil segundo a qual a engenharia fundamental conduz naturalmente a um sucesso comercial duradouro. Um sistema pode ser rápido, original e bem financiado, mas não conquistar um lugar sustentável em um mercado em transformação. Custo do produto, modelo de implantação, fluxo de trabalho dos clientes, canais de vendas, prioridades organizacionais e concorrência do NVMe de mercado e de arquiteturas de nuvem podem importar tanto quanto o desempenho em benchmarks.
As evidências públicas não estabelecem uma única razão simples para o fim da DSSD, nem justificam tratar a aquisição como prova dos ganhos pessoais ou da riqueza atual de Bonwick. Preço da aquisição, participação acionária dos fundadores e remuneração são fatos distintos, e as evidências disponíveis não sustentam estimativas. O que o episódio estabelece é que a EMC comprou a empresa e que o D5 não permaneceu como produto independente.
A DSSD, portanto, funciona como contraponto a um perfil heroico. O instinto arquitetônico de Bonwick não era infalível, e a adoção pelo mercado não é um julgamento exclusivo do mérito técnico. O episódio também mostra por que é difícil comercializar infraestrutura empresarial. Um novo sistema de armazenamento entra em um ambiente de certificação de bancos de dados, hábitos operacionais, ciclos de aquisição, expectativas de suporte e rápida mudança na economia do hardware. O produto precisa se adequar a essas instituições, não apenas superar uma alternativa em um teste controlado.
Essa distinção tem relevância mais ampla para a infraestrutura de IA, o armazenamento desagregado e as malhas de aceleradores. Sistemas técnicos costumam ser apresentados por meio de afirmações de desempenho, mas a adoção duradoura depende do custo de migração, do tratamento de falhas, do suporte e da capacidade de coexistir com o restante da pilha. O fim da DSSD não é uma nota de rodapé na carreira de Bonwick. É evidência de que o projeto do sistema completo precisa incluir o mercado e a organização operacional ao redor da máquina.
A iodyne aplica preocupações conhecidas à mídia profissional, não a um novo ZFS
Bonwick e Shapiro fundaram a iodyne em 2018. A página atual de liderança da empresa apresenta os dois como copresidentes. A iodyne desenvolve armazenamento de alto desempenho para fluxos de trabalho de mídia profissional, combinando dispositivos NVMe, criptografia, redundância e recursos multiusuário em produtos destinados a equipes de produção que movimentam grandes arquivos de vídeo e áudio.
A continuidade com o trabalho anterior de Bonwick é conceitual. O armazenamento de mídia precisa sustentar altas taxas de transferência, sobreviver a falhas de dispositivos, proteger trabalhos valiosos e se adequar a um fluxo colaborativo. A empresa enfatiza o armazenamento criptografado e o desempenho, e seus produtos integram hardware e software para gerenciar esses requisitos. Ainda assim, seria enganoso descrever a iodyne como “ZFS em uma caixa” ou como continuação direta da DSSD. Os produtos operam em escalas diferentes, usam interfaces distintas e atendem a outros tipos de usuário.
As evidências sobre uma empresa privada também exigem cautela. Páginas de produtos podem comprovar especificações e recursos anunciados. Não fornecem dados auditados sobre confiabilidade, participação de mercado, receita, concentração de clientes ou participação acionária dos fundadores. Avaliações e relatos de clientes podem esclarecer implantações específicas, mas não constituem um benchmark universal. O papel atual da empresa no perfil de Bonwick deve ser descrito como trabalho ativo em produtos cuja escala comercial permanece, em grande parte, privada.
O mercado de mídia profissional torna a arquitetura visível de maneira prática. A falha de um disco não é apenas um evento de componente; pode interromper a edição, a correção de cor ou a entrega. A criptografia não é um recurso abstrato de segurança; protege ativos portáteis ou compartilhados. O desempenho só é valioso se vários usuários conseguirem manter seus fluxos de trabalho sem corrupção ou interrupções imprevisíveis. O produto integrado precisa equilibrar taxa de transferência, condições térmicas, interfaces, reparo, suporte de software e o custo humano da indisponibilidade.
A iodyne também ilustra uma mudança de forma. O ZFS se tornou uma camada geral de armazenamento adotada em sistemas operacionais e appliances. A iodyne vende produtos com escopo definido para um fluxo de trabalho especializado. O primeiro depende fortemente da governança comunitária e da configuração dos operadores; o segundo pode integrar uma parcela maior da experiência sob um único fornecedor. Essa integração pode simplificar o suporte ao mesmo tempo que concentra a dependência do fornecedor. Os compradores trocam parte da liberdade por um caminho mais restrito de responsabilização.
Na data-limite da pesquisa, o título de Bonwick era copresidente, ao lado de Shapiro. Esse título compartilhado importa. Ele contraria a tendência de transformar a empresa em um veículo de um único fundador e reflete a colaboração que também moldou a DSSD. O capítulo atual do perfil não é o retorno solitário do inventor do ZFS. É mais uma equipe construindo um sistema de armazenamento em torno de um conjunto de preocupações recorrentes.
A administração passou a fazer parte do modelo de confiabilidade
O ZFS não foi projetado apenas para tornar um bloco individual mais seguro. Também procurou remover divisões administrativas que criavam seus próprios modos de falha. Em uma pilha convencional, um operador podia criar um conjunto RAID de hardware ou software, dividi-lo em volumes, formatar cada volume, montar sistemas de arquivos e depois descobrir que a capacidade estava presa de um lado de uma fronteira enquanto outra carga de trabalho ficava sem espaço. Cada camada tinha seus próprios nomes, ferramentas e procedimentos de recuperação. Um componente tecnicamente sólido ainda podia integrar um processo operacional inseguro.
O modelo de pool de armazenamento mudou esse fluxo de trabalho. A capacidade é fornecida por vdevs a um pool, e os conjuntos de dados utilizam o espaço compartilhado. Sistemas de arquivos e volumes podem ser criados com propriedades, cotas e reservas sem dividir antecipadamente todo o pool em partições permanentes. Snapshots capturam referências a um ponto no tempo por meio da cópia na gravação, enquanto clones podem fornecer descendentes graváveis. A replicação pode transmitir o estado alterado entre snapshots, em vez de exigir que cada processo de backup redescubra todo o conjunto de dados.
Isso é confiabilidade pela redução do ritual operacional. Menos fronteiras montadas manualmente significam menos oportunidades de alocar o tamanho errado, esquecer qual volume contém um serviço ou executar uma sequência arriscada de redimensionamentos. Comandos e propriedades consistentes tornam a política mais visível. Um administrador pode definir compressão, cotas, comportamento de montagem e práticas de snapshots no nível do conjunto de dados, em vez de distribuir essas decisões entre ferramentas sem relação entre si.
Mas o pool transfere a responsabilidade, em vez de eliminá-la. O espaço livre compartilhado pode permitir que um conjunto de dados consuma a capacidade necessária a outro, a menos que sejam usadas cotas ou reservas. Snapshots preservam blocos antigos e podem aumentar silenciosamente o volume de dados referenciados. A replicação depende dos sistemas receptores, da retenção e dos testes. Uma saída limpa dezfs listnão prova que a organização consegue recuperar uma aplicação, a consistência de seu banco de dados ou as credenciais necessárias para descriptografá-la.
A interface integrada também pode ocultar diferenças físicas. Dois dispositivos listados no mesmo pool podem compartilhar controlador, fonte de alimentação, chassi ou defeito de firmware. Um espelho entre dispositivos que parecem separados nos rótulos não é independente se o hardware por trás deles estiver correlacionado. O operador precisa traduzir o modelo lógico de volta para racks, cabos, domínios de falha e procedimentos de substituição. A integração melhora a possibilidade de uma política coerente; não garante que a política reflita o mundo físico.
É por isso que o trabalho de Bonwick pertence à análise de infraestrutura digital, e não apenas à história dos sistemas de arquivos. A administração faz parte da justificativa de segurança operacional do sistema. A arquitetura determina quais erros são fáceis, quais são difíceis e quais se tornam visíveis antes que os dados sejam perdidos. Um recurso tem valor operacional quando altera essas probabilidades, não apenas quando reduz o tamanho de um comando.
O alocador e o sistema de arquivos elevaram a manutenção a uma carga de trabalho de primeira classe
A infraestrutura costuma ser avaliada pelo caminho direto: a rapidez com que um objeto pode ser alocado, quantas gravações um pool consegue sustentar ou quanta taxa de transferência um appliance de armazenamento pode oferecer. Os projetos de Bonwick também direcionam a atenção para o trabalho em segundo plano. Caches de objetos precisam ser reabastecidos, esvaziados e inspecionados. Pools de armazenamento precisam passar por scrubs, ressincronização, balanceamento, replicação e monitoramento. Essas atividades disputam recursos com as cargas dos usuários, mas determinam se o sistema permanece confiável ao longo do tempo.
Os magazines por CPU são um exemplo. O caminho rápido de alocação é local, mas os depósitos compartilhados e a manutenção dos caches mantêm os pools locais abastecidos e evitam que fiquem totalmente desconectados. O projeto só é bem-sucedido se o caminho lento puder reequilibrar os recursos sem transformar uma manutenção ocasional em um gargalo global. Um operador que olhasse apenas para a latência média de alocação deixaria de perceber a memória mantida nos caches e o comportamento sob pressão.
O ZFS apresenta a mesma divisão. Leituras e gravações normais são apenas parte da carga de trabalho. Um scrub lê os dados alocados para verificá-los. Uma ressincronização reconstrói ou copia dados depois da troca de um dispositivo. A exclusão de snapshots pode liberar grandes árvores de blocos. A replicação transfere mudanças para outro sistema. Os metadados precisam ser mantidos em cache e atualizados. O desempenho observado durante esses eventos pode importar mais do que o pico de taxa de transferência em um pool vazio, porque o sistema já está operando com redundância reduzida ou sob pressão de recuperação.
Essa perspectiva de manutenção complica o planejamento de capacidade. Capacidade ociosa de entrada e saída, CPU, memória e rede não é desperdício se permite que a verificação e a recuperação terminem antes da próxima falha. Um pool mantido permanentemente em seu máximo aparente pode ser menos capaz justamente quando precisa ser reconstruído. Uma equipe de mídia profissional pode valorizar uma recuperação previsível e o desempenho compartilhado sustentado mais do que um pico curto de benchmark. Um operador de data center pode escolher domínios de falha mais amplos ou mais réplicas porque o tempo de reparo tem valor econômico.
O mesmo raciocínio se aplica aos mantenedores de software. O OpenZFS precisa realizar trabalhos de compatibilidade, testes e lançamento que permanecem invisíveis para os usuários quando são bem-sucedidos. O código de alocadores do kernel requer revisão em diferentes arquiteturas e cargas de trabalho. A iodyne precisa oferecer suporte a combinações de firmware, software de host e hardware depois do lançamento de um produto. A manutenção não é o resíduo deixado depois da invenção; é o processo que transforma uma arquitetura em infraestrutura.
A carreira de Bonwick costuma ser narrada por momentos de criação — o artigo, o quadro branco, o novo sistema de arquivos, a startup. A lição mais duradoura é que o sistema criado precisa reservar mecanismos e recursos para manter sua própria correção. Um projeto que funciona de forma brilhante apenas quando nada está sendo verificado, reparado ou atualizado adiou seu problema operacional em vez de resolvê-lo.
A liderança técnica significou definir limites dentro dos quais outros engenheiros podiam trabalhar
O registro sustenta a descrição de Bonwick como líder técnico, especialmente no projeto original do ZFS. Não sustenta uma narrativa de gênio solitário. Grandes sistemas exigem divisão do trabalho, uma linguagem compartilhada de projeto e uma forma de resolver conflitos entre desempenho, correção, compatibilidade e cronograma. A contribuição do líder pode ser decisiva sem corresponder a todas as linhas de código.
Matt Ahrens é central para a origem do ZFS e sua posterior continuidade no código aberto. Bill Moore foi um colaborador importante no ZFS e na DSSD. Jonathan Adams foi coautor do trabalho sobre magazines e vmem. A equipe de ZFS da Sun transformou conceitos em um sistema de arquivos operacional, gerenciador de volumes, ferramentas, testes e suporte à produção. Mantenedores posteriores do OpenZFS adaptaram o sistema a novas plataformas e substituíram ou ampliaram partes substanciais da implementação original. Remover esses nomes tornaria a história menos precisa e a engenharia menos compreensível.
Uma forma útil de compreender a liderança de Bonwick é observar os limites estabelecidos pelos projetos. O alocador slab ofereceu aos desenvolvedores de subsistemas uma interface de cache de objetos. O vmem ofereceu arenas capazes de importar recursos de outras arenas. O ZFS expôs pools, conjuntos de dados, grupos de transações e a semântica dos ponteiros de blocos. Essas abstrações permitiram que diferentes engenheiros trabalhassem em componentes enquanto preservavam um modelo comum de propriedade e confirmação.
Bons limites não eliminam divergências. Uma equipe de sistema de arquivos precisa decidir quais garantias pertencem ao disco, quais pertencem às ferramentas e quais continuam sendo responsabilidade do operador. Precisa decidir quantos metadados reter, como expor os erros e quais comportamentos do hardware pressupor. Essas decisões moldam a compatibilidade futura e podem ser difíceis de reverter. Liderança técnica é o ato de explicitá-las o suficiente para que uma equipe possa construir e testar de acordo com elas.
A vida posterior do ZFS no código aberto acrescenta outro teste. Fundadores frequentemente derivam sua autoridade da história, mas os mantenedores atuais a obtêm da responsabilidade pelo código e pelos usuários de hoje. O OpenZFS não precisou do controle contínuo de Bonwick para permanecer legítimo. Sua governança e engenharia passaram para as pessoas que assumiram as obrigações atuais. Essa sucessão é evidência de que os conceitos originais podiam ser comunicados, não de que o trabalho posterior pertence ao fundador.
Na iodyne, o modelo de liderança verificado é compartilhado: Bonwick e Mike Shapiro são copresidentes. A distribuição interna da autoridade sobre produto, engenharia e atividades comerciais não é totalmente pública, portanto o artigo não deve inventar uma hierarquia. A conclusão mais segura é que Bonwick continua atuando em um ambiente empresarial colaborativo, como fez nos projetos pelos quais é mais conhecido.
Essa disciplina de atribuição tem uma finalidade prática. Os usuários de infraestrutura precisam saber onde a autoridade está agora. O prestígio histórico não pode incorporar um patch, enviar uma substituição, divulgar uma vulnerabilidade nem honrar um compromisso de suporte. Um perfil que nomeia a equipe e o responsável atual é mais útil do que aquele que concentra todas as realizações em uma pessoa famosa.
Licenciamento e governança se tornaram outra forma de isolamento de falhas
A transição da Sun para a Oracle e depois para o OpenZFS pode ser interpretada como um problema de domínio de falha institucional. O código produzido dentro de uma empresa está exposto a aquisições, mudanças estratégicas e encerramentos de produtos. Uma licença aberta e uma comunidade externa não impedem esses eventos, mas podem permitir a continuidade técnica quando a instituição original deixa de oferecê-la.
O lançamento do ZFS pela Sun por meio do OpenSolaris disponibilizou o código-fonte e o projeto fora da empresa. Quando a Oracle adquiriu a Sun e o caminho de desenvolvimento aberto mudou, o illumos e outras comunidades preservaram uma ramificação a partir da qual o OpenZFS pôde coordenar o trabalho futuro. O resultado não foi um substituto único e perfeitamente unificado para a engenharia do Solaris. Foi um conjunto de comunidades com código e objetivos compartilhados suficientes para continuar lançamentos, adaptações e recursos.
O licenciamento também impôs restrições. A CDDL não se alinhava de forma simples ao licenciamento GPL do kernel Linux, contribuindo para um modelo de distribuição em que o ZFS no Linux se desenvolveu fora da árvore principal do kernel. Essa separação afetou o empacotamento, o suporte e as percepções de risco jurídico. Não impediu um uso substancial, mas mostra que abertura técnica e compatibilidade de licenças são propriedades distintas.
A governança funciona como redundância somente quando as cópias são realmente capazes de agir. Um repositório público não representa continuidade se ninguém consegue revisar mudanças complexas. Várias adaptações para plataformas não oferecem resiliência se todas dependem do mesmo grupo reduzido. Colaboradores empresariais podem financiar o trabalho e também moldar prioridades. Mantenedores voluntários podem proteger a independência enquanto enfrentam esgotamento e risco de sucessão. O projeto precisa de pessoas, infraestrutura de testes, disciplina de lançamentos e um processo para resolver demandas incompatíveis.
Essa camada institucional reflete os mecanismos de armazenamento de maneira instrutiva. Dados redundantes só são úteis se uma cópia válida puder ser identificada e lida. A redundância de responsáveis só é útil se outro grupo tiver os direitos, o conhecimento e a capacidade de continuar o trabalho. Em ambos os casos, uma duplicação nominal sem independência operacional cria falsa confiança.
A sobrevivência do OpenZFS, portanto, faz parte do legado de Bonwick, mas não é uma posse atual dele. O projeto atravessou uma fronteira corporativa porque o código e a comunidade tinham autonomia suficiente para reconstruir a autoridade em outro lugar. Esse resultado não deve ser romantizado: diferenças entre plataformas, necessidades de financiamento e questões de licenciamento permanecem. Deve ser reconhecido como uma forma real de resiliência de infraestrutura, operando no nível das instituições, e não dos blocos.
O método recorrente é reter informações que camadas finas descartam
Ao longo de quatro décadas, o trabalho de Bonwick pode ser interpretado como um combate a abstrações que perdem informação. Um alocador genérico vê um tamanho; um cache slab vê o tipo e o ciclo de vida de um objeto. Um alocador global vê demanda compartilhada; um magazine por CPU vê localidade e contenção. Uma pilha de armazenamento tradicional pode enxergar uma leitura de setor bem-sucedida; o ZFS vê um bloco com uma identidade esperada dentro de uma árvore transacional.
Uma especificação de produto pode anunciar taxa de transferência; um fluxo de produção precisa considerar criptografia, falha, reparo e o tempo das pessoas que esperam pelo sistema.
Isso não significa que mais integração seja sempre melhor. Sistemas integrados podem ampliar domínios de falha, dificultar a migração e concentrar o controle. O modelo de pool do ZFS simplifica muitas tarefas, mas aumenta a importância do projeto dos vdevs. A iodyne pode oferecer um produto coerente, mas vincula os usuários ao ciclo de vida de hardware e software de um fornecedor. Caches slab melhoram a reutilização, mas consomem memória e complicam o balanceamento sob pressão. A informação retida tem um custo.
O padrão é duradouro porque falhas de infraestrutura frequentemente surgem nas fronteiras. Uma camada não consegue verificar o que outra prometeu. Um controlador informa sucesso enquanto devolve o bloco errado. Um alocador fornece memória sem compreender os invariantes do objeto. Uma camada RAID e um sistema de arquivos atualizam estados relacionados separadamente. Os projetos de Bonwick tentam explicitar essas relações o suficiente para que o sistema consiga raciocinar sobre elas.
Outra característica recorrente é a explicação operacional. Artigos, palestras técnicas e documentação de projetos deram aos engenheiros um vocabulário para a arquitetura. “Cache de objetos”, “magazine”, “pool de armazenamento”, “grupo de transações”, “scrub” e “autorreparação” não são apenas termos de implementação. Tornam-se unidades em planos de capacidade, análises de incidentes e decisões de compra. Um bom vocabulário pode melhorar as operações; um slogan simplificado também pode ocultar condições e limites.
A importância de longo prazo da carreira de Bonwick não está, portanto, em ele ter solucionado as falhas nem em todos os sistemas posteriores terem copiado seu código. Está em ter mudado repetidamente o que o sistema sabia sobre o próprio trabalho. A alocação se tornou tipada e estratificada. As atualizações de armazenamento se tornaram árvores transacionais. Uma leitura passou a ser uma afirmação que podia ser verificada contra uma expectativa independente. São escolhas arquitetônicas com consequências que ultrapassam em muito uma geração de produtos.
O ZFS competiu mudando a unidade de comparação
O ZFS entrou em um campo no qual sistemas de arquivos, gerenciadores de volumes e arrays de armazenamento eram frequentemente avaliados como produtos separados. Seu projeto integrado mudou a unidade de comparação. A pergunta relevante deixou de ser apenas se um sistema de arquivos tratava diretórios rapidamente ou se um controlador RAID sobrevivia à falha de um disco. Compradores e operadores passaram a precisar comparar o caminho completo, desde o agrupamento e a alocação dos dispositivos até snapshots, somas de verificação, reparo e administração.
Essa comparação mais ampla ajuda a explicar tanto o entusiasmo quanto a controvérsia. Diante de um sistema de arquivos convencional como o XFS, o ZFS inclui funções de gerenciamento de volumes e integridade que, de outro modo, poderiam ocupar outras partes da pilha. Diante de sistemas pares baseados em cópia na gravação, como o Btrfs, ou de sistemas de arquivos proprietários de plataformas, ele difere no histórico de implementação, maturidade dos recursos, ferramentas e suporte.
Diante de um sistema distribuído como o Ceph, costuma operar em outra escala e com um modelo de coordenação diferente: o Ceph distribui objetos e serviços entre nós conectados em rede, enquanto um pool ZFS é organizado em torno de dispositivos diretamente conectados ou visíveis ao sistema. Diante de um array comercial, o ZFS pode oferecer transparência e portabilidade, mas transferir mais responsabilidade de integração para o operador ou fornecedor do appliance.
Nenhuma dessas diferenças estabelece um vencedor universal. Um host de banco de dados, um destino de backup, uma estação de trabalho de mídia e um armazenamento de objetos distribuído entre vários locais valorizam propriedades distintas. Arrays comerciais podem oferecer hardware validado, contratos de serviço e procedimentos previsíveis de substituição. Software aberto pode reduzir a dependência de um fornecedor e expor mais do mecanismo. O armazenamento distribuído pode crescer entre nós, mas acrescenta dependências de rede e consenso. Um appliance especializado pode otimizar um fluxo de trabalho enquanto restringe opções futuras.
A influência de Bonwick é visível nas perguntas que os concorrentes agora precisam responder. Onde as somas de verificação são calculadas e armazenadas? O sistema consegue detectar leituras direcionadas ao local errado? Qual estado é atômico depois de uma falha? Como os snapshots são representados? O que acontece durante o reparo? Qual camada controla a redundância? Quanto do sistema pode ser inspecionado ou transferido? Mesmo produtos que implementam respostas diferentes atuam em um mercado no qual essas perguntas são normais.
A lição competitiva não é que a arquitetura integrada elimina compromissos. Ela os reposiciona. Combinar camadas pode criar uma semântica mais robusta porque o sistema de arquivos conhece a redundância e a identidade dos blocos. Também pode tornar a pilha mais prescritiva e aumentar o custo de alterar um componente de forma independente. Operadores devem comparar em conjunto o modelo de integridade, o domínio de falha, o modelo de suporte e o caminho de saída, em vez de comprar o nome de um recurso.
Esse é outro motivo para evitar o uso do ZFS como substituto da figura pessoal de Bonwick. A posição competitiva do sistema hoje depende do código atual do OpenZFS, da integração com plataformas, da engenharia de appliances, dos administradores e do mercado de hardware ao redor. A arquitetura histórica molda o campo, mas os resultados atuais pertencem às instituições atuais.
O raciocínio sobre domínios de falha conecta alocação de memória, armazenamento e sobrevivência empresarial
Um domínio de falha costuma ser discutido como uma fronteira física: um disco, controlador, host, rack ou data center que pode falhar junto com outros componentes em seu interior. A carreira de Bonwick sugere uma definição mais ampla. A contenção pode ser um domínio de falha quando todas as CPUs dependem de um único bloqueio do alocador. Um proprietário corporativo pode ser um domínio de falha quando um projeto não tem caminho para sobreviver a uma mudança estratégica. Um produto especializado pode ser um domínio de falha quando os clientes não conseguem migrar seus dados ou fluxos de trabalho depois que o fornecedor o retira do mercado.
Os magazines por CPU reduziram um tipo de concentração ao manter local a alocação comum. Depósitos compartilhados continuaram necessários, mas o caminho rápido deixou de depender de um bloqueio único para cada objeto. O ZFS reduz outra concentração ao manter em sua árvore de blocos informações suficientes para verificar os dados de maneira independente do relatório de sucesso de uma unidade. Espelhos e paridade distribuem cópias, desde que a topologia do hardware as torne genuinamente independentes.
O OpenZFS reduziu a concentração institucional ao permitir que o desenvolvimento continuasse fora da Oracle. A DSSD, em contraste, demonstrou que um produto adquirido ainda pode desaparecer quando seu contexto corporativo e de mercado muda. Os compradores da iodyne precisam, portanto, avaliar não apenas a redundância dos dispositivos e a criptografia, mas também a continuidade do suporte, a portabilidade dos dados e as consequências da dependência de um fornecedor privado e especializado.
O princípio é fácil de enunciar: a redundância precisa existir na camada em que ocorre a falha temida. Dois discos atrás do mesmo controlador defeituoso podem não proteger contra o controlador. Duas ramificações de software sem mantenedores ativos podem não proteger um projeto. Duas cópias criptografadas pela mesma chave perdida podem não proteger os dados. Um backup acessível ao mesmo administrador comprometido pode não proteger contra acesso destrutivo.
Essa forma de pensar transforma a arquitetura em um mapa de pressupostos correlacionados. Pergunta o que pode falhar em conjunto, quais evidências revelariam a falha e qual recurso independente poderia restaurar o serviço. As respostas são específicas de cada implantação. O ZFS pode fornecer mecanismos, mas somente o operador pode distribuir dispositivos e backups por fronteiras reais. Uma licença de código aberto pode permitir uma bifurcação, mas somente uma comunidade pode fornecer engenharia sustentada. Uma empresa pode oferecer uma garantia, mas apenas suas finanças e operações podem tornar essa promessa duradoura.
A consequência de segunda ordem é que a simplificação precisa ser avaliada com cuidado. Uma interface em pool pode facilitar o trabalho diário enquanto oculta um destino compartilhado mais amplo. Um magazine local pode acelerar as alocações enquanto retém memória em uma CPU. Um appliance integrado pode tornar o suporte mais claro enquanto restringe as opções de saída. O projeto correto não é aquele com menos componentes visíveis; é aquele cujos limites correspondem à capacidade da organização de observar as falhas e se recuperar delas.
O trabalho de Bonwick importa porque expôs repetidamente esses limites. Não forneceu um único mapa universal. Forneceu mecanismos que tornam o mapa mais difícil de ignorar.
O legado honesto é um conjunto de perguntas melhores, não uma garantia absoluta
O histórico de Bonwick convida a superlativos porque os sistemas são fundamentais e os mecanismos são elegantes. Uma avaliação mais cautelosa é mais útil. O alocador slab influenciou a forma como kernels gerenciam objetos repetidos. Magazines e vmem mostraram como a alocação podia ganhar escala e se generalizar. O ZFS reuniu administração em pool e integridade de ponta a ponta em um único projeto. O OpenZFS provou que o trabalho podia continuar sob diferentes instituições. A DSSD expôs a distância entre ambição arquitetônica e durabilidade do produto.
A iodyne coloca a mesma preocupação com desempenho e falhas dentro de um fluxo comercial especializado.
Em todas as etapas, as evidências estabelecem um limite para a atribuição pessoal. Jonathan Adams foi coautor do trabalho sobre magazines e vmem. Matt Ahrens iniciou o ZFS com Bonwick. Bill Moore e uma grande equipe da Sun construíram partes cruciais do sistema. A DSSD e a iodyne foram empreendimentos cofundados. O OpenZFS é mantido por uma comunidade cujo trabalho atual não está sob o controle de Bonwick. Chamá-lo de líder de projeto, cocriador e arquiteto de sistemas é correto. Chamá-lo de único inventor da infraestrutura ao redor apagaria o mecanismo pelo qual ela se tornou realidade.
A mesma disciplina deve reger as afirmações técnicas. O ZFS pode detectar muitas formas de corrupção; não pode recuperar um bloco sem uma cópia válida. A cópia na gravação protege contra falhas específicas de atualização parcial; não impede todos os erros de dispositivos ou software. O RAID-Z trata da lacuna de gravação; não substitui backups nem elimina o risco de reconstrução. Scrubs encontram problemas latentes; consomem recursos e não podem garantir leituras futuras. Produtos integrados simplificam a responsabilidade; também podem aprofundar a dependência.
O teste observável do legado de Bonwick não é se seu nome permanece associado a todos os descendentes. É se os sistemas atuais ainda adotam as perguntas de projeto que seu trabalho tornou difíceis de ignorar. O que o alocador sabe sobre o objeto? Onde a soma de verificação esperada está armazenada? Qual estado está completo o suficiente para ser confirmado? Que domínio de falha uma réplica realmente ocupa? Quem pode reparar o sistema quando a redundância projetada se esgota? A infraestrutura melhora quando essas perguntas são respondidas antes do incidente, não depois.
O registro também muda a forma como carreiras técnicas devem ser avaliadas. Um arquiteto de sistemas pode exercer enorme influência posterior sem controlar um padrão atual, ocupar um cargo executivo em um fornecedor dominante ou vincular uma marca pessoal a todos os derivados. As evidências aparecem nas interfaces que outros engenheiros preservam, nos modos de falha que se espera que os produtos enfrentem e nas práticas operacionais que se tornam comuns. Essa influência é real, mas deve permanecer separada de afirmações sobre controle atual, riqueza pessoal ou adoção universal.
O trabalho mais forte de Bonwick é visível justamente porque equipes posteriores puderam usar, revisar e, algumas vezes, rejeitar partes dele.
Uma medida final é verificar se a arquitetura produz evidências melhores sob estresse. Quando um servidor tem pouca memória, os engenheiros conseguem ver onde os objetos estão armazenados em cache? Quando um pool relata um erro, conseguem identificar o bloco, a cópia e o dispositivo envolvidos? Quando um projeto muda de responsáveis, os mantenedores conseguem reproduzir a compilação e continuar o processo de lançamento? Quando um produto chega ao fim de sua vida comercial, os clientes conseguem recuperar seus dados e migrar? Essas perguntas conectam desempenho, integridade e continuidade institucional. São menos dramáticas do que uma promessa de armazenamento perfeito e muito mais úteis.
Elas também mantêm o perfil ancorado em evidências. Os fatos importantes não são que um engenheiro “mudou tudo”, mas que artigos, projetos e equipes identificáveis mudaram o que se esperava que kernels e sistemas de armazenamento soubessem sobre si mesmos. A incerteza restante faz parte da história: nenhum levantamento completo mede o alcance dos alocadores derivados do slab, nenhum relato público isola a contribuição pessoal de Bonwick para cada componente do ZFS e nenhum dado auditado estabelece a escala de mercado da iodyne. Ser preciso sobre essas lacunas faz parte da mesma disciplina intelectual de uma soma de verificação: não aceite uma resposta confiante apenas porque ela chegou sem um sinal de erro.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance