Resumo
- A ISC controla partes importantes da produção upstream: publica avisos, artefatos de lançamento, documentação e código-fonte para BIND e Kea.
- A existência de uma correção, de um pacote ou de uma instrução de monitoramento não demonstra que um operador específico atualizou, validou, observou ou recuperou seu serviço.
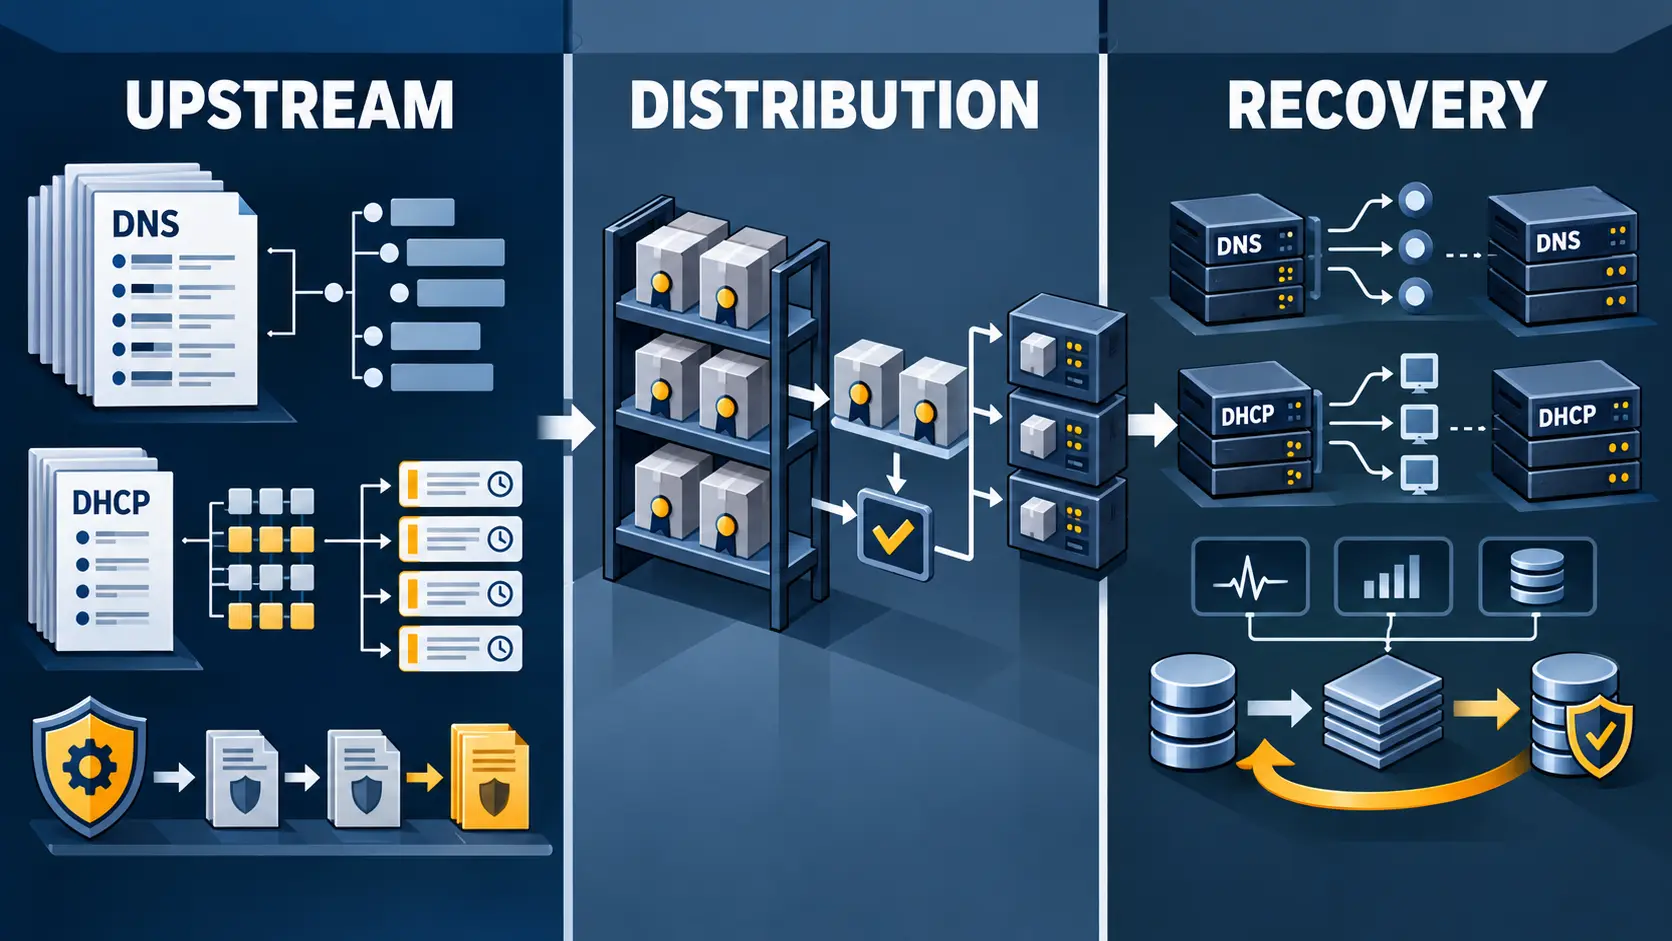
A ISC ocupa uma posição relevante na cadeia de dependência de serviços de nomes e endereçamento. A organização publica avisos de segurança com versões afetadas e orientações de correção em sua página de avisos de segurança, oferece artefatos por sua infraestrutura de downloads e mantém páginas de produto e repositórios para BIND e Kea. Isso é evidência de atividade e responsabilidade upstream. Não é, por si só, evidência de que uma instalação downstream esteja corrigida.
O ponto de controle decisivo está entre a publicação upstream e o estado real do serviço. Um operador pode obter BIND diretamente da ISC, por uma distribuição Linux ou por outro processo interno de empacotamento. O rastreador Debian do bind9 mostra uma camada de manutenção e versionamento própria da distribuição. A busca de pacotes da Ubuntu mostra outra. Esses registros tornam visível uma parte da cadeia, mas a disponibilidade de um pacote não prova que ele foi selecionado, instalado ou colocado em produção.
A diferença importa durante um incidente. Um aviso upstream pode identificar uma falha e recomendar uma versão corrigida. A distribuição pode publicar essa versão em um momento diferente. O operador ainda precisa confirmar qual versão está instalada, avaliar compatibilidade, testar a mudança, aprová-la, implantá-la e verificar se o serviço continua respondendo corretamente. Em ambientes críticos, a recuperação também requer registros de quando a mudança ocorreu, quais instâncias foram alcançadas e quais permaneceram expostas.
A documentação do BIND 9 descreve configuração, operação, controles, logs, estatísticas, solução de problemas e manutenção. A documentação do Kea descreve canais de controle, bancos de dados, alta disponibilidade, hooks, logging, monitoramento e procedimentos operacionais. Esses materiais identificam mecanismos que um operador pode usar para produzir evidência. Eles não demonstram que um ambiente específico ativou os logs, coletou as métricas ou testou a recuperação.
Essa fronteira deve limitar a atribuição de responsabilidade. A ISC pode ser cobrada pela qualidade e pontualidade de seus avisos, pelo processo de lançamento, pela clareza da documentação e pela rastreabilidade do código e dos artefatos. A implantação em uma rede concreta envolve outros controladores: mantenedores de distribuição, integradores, equipes de operações e proprietários do serviço. Sem registros do ambiente afetado, não é possível transformar a existência de uma correção em prova de falha ou negligência de uma dessas partes.
O repositório do BIND 9 e o repositório do Kea ajudam a rastrear desenvolvimento e mudanças upstream. Essa rastreabilidade melhora a investigação, mas não substitui a prova downstream. Um commit não demonstra que o pacote correspondente chegou a cada operador; um pacote publicado não demonstra que a configuração foi alterada; e uma reinicialização bem-sucedida não demonstra que o serviço voltou a cumprir sua função sob carga ou durante uma falha.
O teste de reparo durável deve acompanhar a cadeia inteira. Primeiro, deve existir uma identificação inequívoca do componente afetado, da versão instalada e da versão corrigida. Segundo, a implantação deve deixar um registro verificável, incluindo o escopo das instâncias alcançadas e as exceções. Terceiro, os controles de observabilidade devem mostrar o comportamento relevante: respostas, erros, disponibilidade, atrasos, falhas de replicação ou outros indicadores adequados ao serviço. Quarto, a organização deve demonstrar que consegue voltar a operar após uma falha, e não apenas que aplicou uma atualização.
O que está publicamente documentado pela ISC é suficiente para estabelecer a arquitetura desses controles, não para declarar o estado de uma implantação particular. A página de BIND da ISC apresenta a posição upstream do projeto. A página do Kea faz o mesmo para o servidor DHCP. A base de conhecimento da ISC acrescenta material técnico e orientações operacionais, mas seu conteúdo é mutável e pode exigir verificação por versão ou por artigo específico.
Para conselhos, reguladores e operadores, a pergunta útil não é apenas “a correção foi publicada?”. É: quem controlava cada transição e que registro prova que ela ocorreu? A resposta pode distribuir a responsabilidade entre a ISC, uma distribuição, um provedor gerenciado e o operador final. Essa distribuição não reduz a urgência; ela impede que uma investigação confunda anúncio com recuperação.
A dependência de software de infraestrutura também cria um risco de continuidade. Quando um serviço público, uma rede empresarial ou um provedor regional depende de BIND ou Kea, a interrupção pode afetar nomes, endereços, autenticação e acesso a sistemas que não têm relação visível com a origem do código. A documentação pública mostra caminhos de administração e recuperação, mas a resiliência real depende de testes, pessoal, registros e autoridade para agir quando a mudança precisa ser feita rapidamente.
O padrão mínimo de prestação de contas é, portanto, uma cadeia de evidências: aviso ou mudança upstream; versão e pacote efetivamente selecionados; aprovação e implantação; telemetria antes e depois; tratamento das exceções; e teste de restauração. Quando um desses elos falta, a conclusão deve permanecer limitada. Pode-se dizer que a ISC publicou uma orientação, que uma distribuição registrou um pacote ou que a documentação descreve um controle. Não se pode dizer, sem evidência adicional, que determinado operador corrigiu o problema ou restaurou o serviço.
A contribuição prática da ISC é tornar esses elos mais rastreáveis e operáveis: avisos claros, artefatos verificáveis, documentação versionada e orientação sobre diagnóstico. A contribuição dos operadores é registrar o estado real, testar as mudanças e preservar evidência de recuperação. O resultado que importa para usuários e comunidades não é a existência de uma promessa de correção, mas a capacidade demonstrada de manter o serviço e recuperar-se quando a primeira linha de defesa falha.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance