
Resumo
- A ISC controla a publicação, a documentação, os avisos de segurança e vários canais de distribuição de BIND e Kea, mas isso não equivale ao controle dos sistemas que os operadores efetivamente executam.
- A evidência pública permite reconstruir a cadeia entre upstream, pacotes e implantação, mas não demonstra escala de uso, adoção universal de correções, tempos de failover ou recuperação durável em organizações específicas.
A infraestrutura raramente falha em uma única camada. Para DNS, o processo pode envolver o daemon BIND, arquivos de configuração, zonas autoritativas ou recursivas, dados de atualização dinâmica, material DNSSEC, logs, monitoramento e procedimentos de restauração. Para DHCP, a cadeia pode incluir os processos Kea, o Control Agent, Dynamic DNS, bibliotecas de hooks, armazenamento de leases, bancos de dados, comunicação entre pares de alta disponibilidade, segurança das APIs e monitoramento externo.
A ISC documenta esses produtos e seus canais de manutenção; o operador, porém, continua responsável por transformar a possibilidade de correção em continuidade observável.
A ISC apresenta o BIND 9 como software DNS de código aberto e o Kea como uma plataforma DHCPv4 e DHCPv6 de código aberto. Também mantém um canal de downloads e uma estrutura de suporte. Esses elementos mostram uma função de stewardship: a organização influencia quais recursos, versões, documentação e remédios ficam disponíveis. Eles não provam que a ISC controla cada servidor instalado, cada configuração ou cada decisão de atualização.
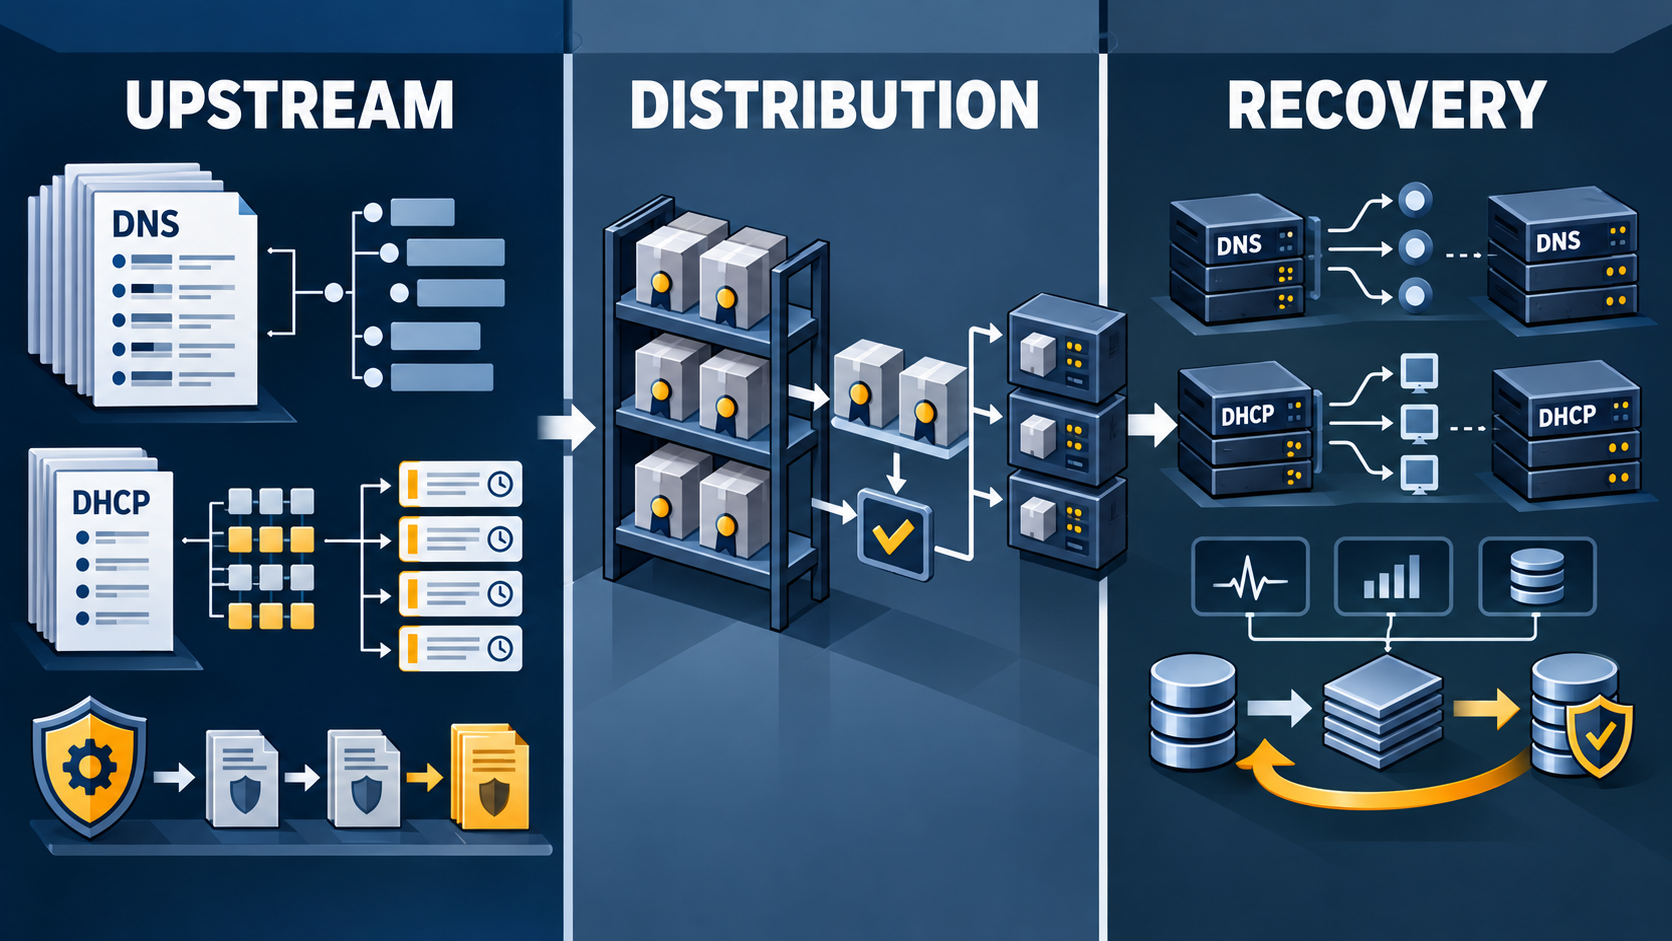
Essa diferença é importante porque a dependência operacional nasce por etapas. Primeiro, um projeto upstream publica código e documentação. Depois, a versão aparece em repositórios, imagens de contêiner ou pacotes de uma distribuição. Em seguida, uma equipe seleciona uma versão, adapta configuração, conecta armazenamento e integra o componente a outros serviços. Só então existe uma implantação concreta, cuja recuperação dependerá dos dados, das credenciais, dos procedimentos locais e da capacidade de verificar o resultado.
O que a ISC controla — e o que não controla
A página de segurança da ISC e os recursos de orientação sobre avisos e vulnerabilidades oferecem referências para identificar problemas e correções. As matrizes de vulnerabilidade do BIND e do Kea organizam linhas afetadas e corrigidas. Isso reduz a ambiguidade na etapa upstream: existe um registro público para comparar versões e entender quais linhas foram tratadas.
Mas a publicação de uma correção não demonstra que um sistema downstream a recebeu. Um pacote pode ser atualizado em uma distribuição em momento diferente do lançamento upstream. Um fornecedor pode aplicar um backport sem alterar o número de versão de maneira diretamente comparável. Uma imagem de contêiner pode seguir um ciclo de atualização diferente do pacote do sistema operacional. A própria cadeia de consumo, portanto, produz múltiplos estados possíveis: corrigido upstream, disponível para distribuição, empacotado, instalado, configurado e validado.
Os tags de lançamento do BIND e os tags do Kea fornecem um registro em nível de código das versões publicadas. Eles não informam, por si só, se uma versão ainda recebe suporte, se foi implantada por um operador ou se passou por um teste de restauração. A documentação do BIND e suas notas operacionais explicam capacidades e requisitos; não substituem os registros internos de uma organização.
A cadeia downstream muda a responsabilidade
A distribuição não é apenas uma etapa logística. Ela altera o contexto de manutenção. A ISC expõe repositórios de software, inclusive por meio de um repositório de pacotes, e imagens no Docker Hub, além de uma página de organizações e imagens. Distribuições como Debian mantêm seus próprios registros para BIND, para o rastreador de segurança do BIND, para Kea e para o rastreador de segurança do Kea.
Esses registros podem ajudar um operador a responder a uma pergunta específica: qual correção está disponível no canal que realmente usamos? Eles não respondem à pergunta seguinte: a correção foi instalada nos servidores certos, sem quebrar dependências, e o serviço foi testado depois? O NVD para BIND e o NVD para Kea acrescentam uma camada de visibilidade sobre vulnerabilidades, mas também não fornecem um denominador público de exposição instalada.
A consequência é uma divisão de responsabilidades. A ISC é responsável por manter e comunicar o software que publica. O distribuidor precisa empacotar, disponibilizar e, quando aplicável, aplicar correções compatíveis com sua política de manutenção. O operador precisa descobrir onde o componente está implantado, escolher o remédio adequado, preservar configuração e dados, executar a mudança e verificar o serviço. Nenhuma dessas responsabilidades pode ser inferida automaticamente das demais.
O daemon é apenas uma parte do serviço
A documentação do BIND descreve uma superfície operacional maior do que o processo em execução. Continuidade pode depender do desenho de servidores autoritativos e recursivos, dos arquivos de zona, de atualizações dinâmicas, do material DNSSEC, do logging, do monitoramento e dos procedimentos testados de restauração. Os princípios de operação de serviços DNS também aparecem em referências técnicas como RFC 2182 e RFC 6781. A orientação do NIST para DNS reforça que disponibilidade e segurança dependem de administração, configuração e recuperação, não somente da instalação do daemon.
No Kea, a documentação do projeto, a documentação de introdução e arquitetura, o guia rápido, os recursos de alta disponibilidade e o tratamento de bancos de dados de leases mostram uma cadeia igualmente composta. O DHCP pode depender do Control Agent, de hooks, de Dynamic DNS, do armazenamento de leases, de bancos de dados, da comunicação entre pares e da proteção das APIs. A RFC 2131 fornece o contexto técnico do protocolo DHCP, mas não constitui evidência de que uma implantação específica esteja configurada ou recuperável de determinada maneira.
Essa composição explica por que a existência de um mecanismo não é uma prova de resultado. Uma função de alta disponibilidade pode estabelecer estados, heartbeats e sincronização; ainda será necessário verificar se a comunicação entre pares funciona no ambiente real, se os dados estão consistentes, se as credenciais são válidas e se o cliente consegue obter serviço durante a falha. Uma correção de segurança pode estar publicada; ainda será necessário saber qual pacote ou imagem foi usado, se houve backport, quais configurações precisam de reinício e se a resolução ou alocação de endereços permaneceu operacional.
O que a evidência pública permite afirmar
O registro disponível sustenta uma cadeia causal de adoção: software mantido pela ISC pode chegar aos operadores por lançamentos, documentação, pacotes, contêineres e distribuições. Também sustenta uma distinção entre upstream e downstream. O que ele não oferece é uma medida pública confiável de quantos operadores executam BIND ou Kea, quais versões estão em produção, quanto tempo levam para aplicar correções ou qual é o tempo de recuperação depois de uma falha.
Isso não é evidência de fracasso. A ausência de um denominador público não permite concluir que a implantação seja pequena, insegura ou mal administrada. Tampouco permite atribuir à ISC controle direto sobre infraestrutura de terceiros. O limite é mais simples: a documentação pública demonstra mecanismos e canais; registros específicos de operadores seriam necessários para demonstrar exposição, execução e recuperação.
Para uma equipe técnica, a pergunta útil não é “a ISC publicou uma correção?”. É: “conseguimos identificar a linha efetivamente instalada, obter e autenticar o remédio pelo canal correto, aplicá-lo a todos os componentes dependentes e verificar o serviço sob condições realistas?”. A resposta exige inventário, rastreabilidade de pacotes ou imagens, configuração versionada, dados recuperáveis, credenciais testadas, observabilidade e exercícios de restauração.
Para instituições públicas ou operadores críticos, essa distinção tem uma consequência adicional. A legitimidade de uma cadeia de software não vem somente da reputação do mantenedor. Ela depende de limites de responsabilidade que possam ser auditados. Um aviso upstream, um pacote downstream, uma mudança de configuração e um teste de recuperação precisam formar uma trilha verificável. Sem essa trilha, a organização pode saber que existe uma correção sem saber se seu serviço está protegido.
O caso da ISC é, portanto, menos uma história de controle direto do que uma história de dependência distribuída. A organização mantém artefatos e canais que tornam certas capacidades possíveis. Distribuidores transformam parte desse trabalho em pacotes e imagens. Operadores convertem esses artefatos em sistemas concretos. A continuidade só aparece no último estágio — e só pode ser demonstrada por evidência operacional específica.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance