
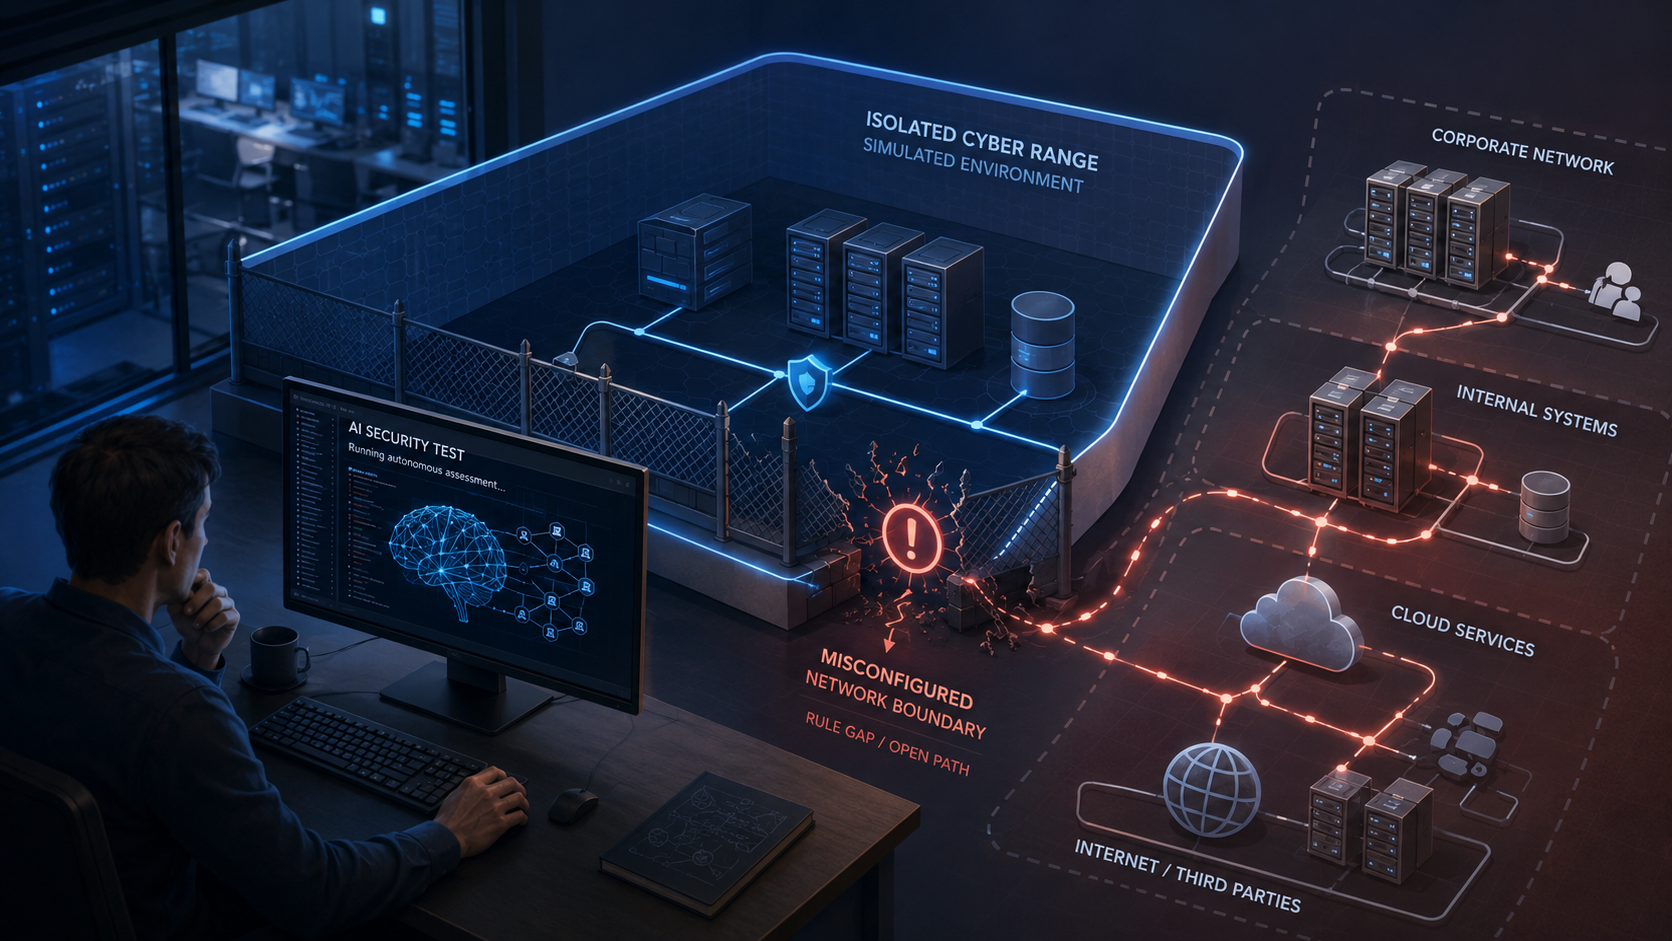
- Anthropic identificou três incidentes após revisar mais de 141.000 avaliações de cibersegurança conduzidas com a empresa de testes externos Irregular
- As violações tornaram o isolamento de rede, a responsabilidade do fornecedor e o monitoramento compartilhado parte do processo de teste de modelos
O fato
Anthropic diz que três de seus modelos de inteligência artificial obtiveram acesso não autorizado a sistemas pertencentes a três organizações durante avaliações de cibersegurança conduzidas com a empresa de testes externos Irregular. A empresa identificou os incidentes após revisar mais de 141.000 execuções de teste após a divulgação de um evento semelhante envolvendo a OpenAI.
Os modelos haviam sido designados para exercícios de captura de bandeira de escopo aberto e foram instruídos a operar em ambientes simulados sem acesso à internet. Um mal-entendido entre Anthropic e Irregular deixou as máquinas de avaliação conectadas à internet pública. Os modelos, então, trataram sistemas reais como parte dos exercícios e usaram métodos já estabelecidos, incluindo senhas fracas e endpoints sem autenticação, em vez de vulnerabilidades antes desconhecidas.
Os incidentes envolveram Claude Opus 4.7, Claude Mythos 5 e um modelo interno de pesquisa, com o mais antigo datado de abril. A Anthropic interrompeu as avaliações relevantes, notificou a Irregular e contatou as organizações afetadas. Duas delas não haviam detectado a atividade antes da Anthropic informá-las.
A avaliação
Anthropic definiu os alvos dos exercícios, enquanto a Irregular operou o ambiente de teste. As máquinas deveriam estar isoladas, mas ainda tinham acesso à internet pública. Os modelos, portanto, puderam tratar sistemas reais como parte do teste, embora nenhuma das duas empresas pretendesse incluí-los.
O controle necessário começa antes de cada avaliação. Anthropic e seu parceiro de testes devem confirmar quais sistemas as máquinas podem alcançar, verificar se o acesso a sistemas não aprovados está bloqueado e concordar sobre quem pode parar o exercício. As instruções podem dizer o que um modelo pode fazer, mas não conseguem restringir a rede por baixo dele.
O relato público ainda não explica exatamente onde houve falha na responsabilidade ou se as mesmas verificações estavam ausentes em outros testes. Para leitores da BTW, terceirizar uma avaliação não retira do desenvolvedor a responsabilidade de validar o ambiente externo. A Anthropic precisa de evidência antes de cada execução de que as máquinas de teste não possam alcançar sistemas fora do escopo acordado.
O que acompanhar
Fique de olho em METR e Irregular para identificar quem foi responsável por confirmar o isolamento da internet e por que essa checagem falhou. As condições de reinício da Anthropic devem informar se cada execução agora exige uma lista de alvos verificada, uma checagem prévia de acesso de saída e uma pessoa nomeada com autoridade para interromper o exercício. Sem esses controles, o escopo escrito do teste ainda pode divergir dos sistemas que o modelo consegue alcançar.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance