
Resumen
- Slurm asigna nodos, CPU, memoria, GPU y otros recursos, traduciendo particiones, prioridades, reglas de calidad de servicio, reparto equitativo y reservas en decisiones de cola.
- TRES, GRES, topología y cgroups permiten a los operadores programar aceleradores como recursos físicos restringidos; el número de GPU por sí solo no garantiza una ubicación útil ni una ejecución eficiente.
- Los desarrolladores de Slurm fundaron SchedMD en 2010 para ofrecer ingeniería, soporte y formación comerciales; NVIDIA adquirió la empresa el 15 de diciembre de 2025 y se comprometió a mantener un desarrollo de código abierto y neutral respecto a los proveedores.
- La credibilidad posterior a la adquisición dependerá de las pruebas multivendedor, el comportamiento de los lanzamientos y los patrones de contribución, mientras que cada operador de clúster sigue siendo responsable de la política que experimentan realmente sus usuarios.
Una GPU inactiva no es necesariamente una GPU disponible
En un clúster de Slurm, un acelerador físicamente inactivo no pasa automáticamente a la siguiente persona que lo solicita. Un trabajo debe ser primero elegible para una partición, ajustarse a la forma de recursos solicitada, cumplir las reglas de cuenta y calidad de servicio, evitar las reservas que bloquean los nodos necesarios y superar a los trabajos en competencia. Solo entonces el planificador asigna los recursos y permite que el trabajo comience.
Esa secuencia convierte a Slurm en algo más que una cola. Es un plano de control de admisión y asignación para una gran clase de sistemas de computación de altas prestaciones e IA. Los usuarios envían trabajos;slurmctldlos evalúa contra el estado y las políticas del clúster; los procesosslurmden los nodos de cálculo lanzan y supervisan el trabajo;slurmstepdgestiona los pasos individuales del trabajo. Un servicio opcionalslurmdbdregistra los trabajos, el uso de recursos y las relaciones de cuenta en una base de datos.
La consecuencia es tanto económica como técnica. Un clúster de IA puede tener suficientes GPU en conjunto y, aun así, no poder iniciar un gran trabajo de entrenamiento porque los dispositivos libres están fragmentados en los nodos equivocados, detrás de una topología inadecuada o reservados para otro proyecto. Un planificador puede reducir ese desperdicio representando las restricciones relevantes. No puede crear GPU que falten, arreglar una red congestionada ni hacer útil una aplicación ineficiente.
La importancia de Slurm proviene, por tanto, de las decisiones que toma antes de que la aplicación se ejecute. El proyecto ha dedicado más de dos décadas a convertir una pregunta sencilla —¿quién puede usar qué máquina ahora?— en un sistema configurable para asignar una infraestructura cada vez más heterogénea y cara.
Slurm convierte la política local en tiempo de máquina
Slurm comenzó en una colaboración liderada por Lawrence Livermore National Laboratory y apareció por primera vez en 2002. Su tarea inicial era coordinar trabajo paralelo presentado de forma independiente en grandes clústeres Linux sin exigir que cada aplicación comprendiera la máquina completa. La arquitectura original separaba la asignación de recursos de la ejecución de trabajos y exponía una capa de control común que podía adaptarse entre instituciones.
Esa separación básica sigue siendo visible. El controlador mantiene una vista central de nodos, trabajos y estado de planificación, mientras que los demonios de los nodos de cálculo ejecutan el trabajo ya autorizado. Un controlador de respaldo y el estado persistido pueden reducir el impacto de una caída del controlador, pero la alta disponibilidad sigue dependiendo de un estado coherente, una autenticación operativa, la alcanzabilidad de la red y procedimientos de recuperación probados. “Tolerante a fallos” es una capacidad de diseño, no una garantía de que cualquier fallo del plano de control sea inofensivo.
El cambio más profundo llegó a medida que Slurm acumulaba primitivas de política. Las particiones agrupan nodos en clases de servicio o grupos administrativos. Las asociaciones conectan usuarios y cuentas con participaciones, límites y uso histórico. Las reglas de calidad de servicio pueden cambiar la prioridad, los límites o el comportamiento de desalojo. Las reservas retienen recursos para mantenimiento, eventos o usuarios concretos. La prioridad multifactorial puede combinar antigüedad, reparto equitativo, tamaño del trabajo, partición, QOS y factores definidos por el sitio.
No existe una definición universal de equidad en Slurm. Una universidad puede favorecer a los proyectos que han usado menos de su asignación a largo plazo. Un laboratorio nacional puede reservar capacidad para una campaña. Un operador comercial de GPU puede crear niveles de servicio diferenciados. El mismo software puede expresar los tres casos porque el sitio define la política.
Esa flexibilidad es una de las fortalezas de Slurm y uno de sus riesgos operativos. Una cola puede volverse difícil de explicar cuando las particiones se solapan, se acumulan excepciones e interactúan varios sistemas de ponderación. Entonces los usuarios perciben el resultado como arbitrario incluso cuando el software está implementando la configuración exactamente. El planificador puede calcular la prioridad; la institución debe seguir justificando la política.
El reparto equitativo determina quién espera, no qué significa la equidad
El reparto equitativo se discute a menudo como si fuera una propiedad objetiva del planificador. En la práctica es un mecanismo para trasladar las decisiones de asignación de una institución a lo largo del tiempo. El uso histórico, la jerarquía de cuentas y las participaciones configuradas pueden influir en la prioridad futura para que un grupo que ha consumido menos de lo que le corresponde reciba una ventaja sobre otro que ha consumido más.
Eso convierte la contabilidad en parte de la gobernanza.slurmdbdpuede registrar trabajos, pasos, asociaciones y recursos rastreables en uno o más clústeres. Los administradores usan esos registros para informes, repercusión de costes, límites de uso y cálculos de reparto equitativo. Un campo de base de datos que parece administrativo puede, por tanto, afectar al momento en que un investigador o un equipo de ingeniería recibe la próxima asignación de computación escasa.
La calidad del registro importa. Si los usuarios se asignan a la cuenta equivocada, el uso de recursos no se registra de forma coherente o los datos históricos se conservan incorrectamente, la prioridad resultante puede ser técnicamente válida e institucionalmente errónea. Los cambios en la pertenencia a proyectos, las cuentas de servicio compartidas y los registros corregidos manualmente necesitan gobernanza porque el planificador puede tratarlos como evidencia sobre el derecho de acceso.
Esta es una de las razones por las que las disputas sobre la cola son difíciles de reducir a un error de software. Una espera larga puede deberse a la demanda, a solicitudes de tiempo de pared inexactas, a una reserva, a un factor de reparto equitativo bajo, a un requisito de topología, a una regla QOS o simplemente a un trabajo que no cabe en los recursos libres actuales. Slurm expone los mecanismos, pero el operador necesita suficiente observabilidad para reconstruir cuál importó.
Para los usuarios, la explicabilidad es, por tanto, parte de la calidad del servicio. Una cola es más fácil de aceptar cuando las personas pueden ver por qué un trabajo está pendiente, qué política se aplica y qué permitiría que comenzara. A medida que los clústeres se vuelven más caros e importantes comercialmente, esa transparencia se convierte en un problema de gestión más que en una comodidad para los investigadores.
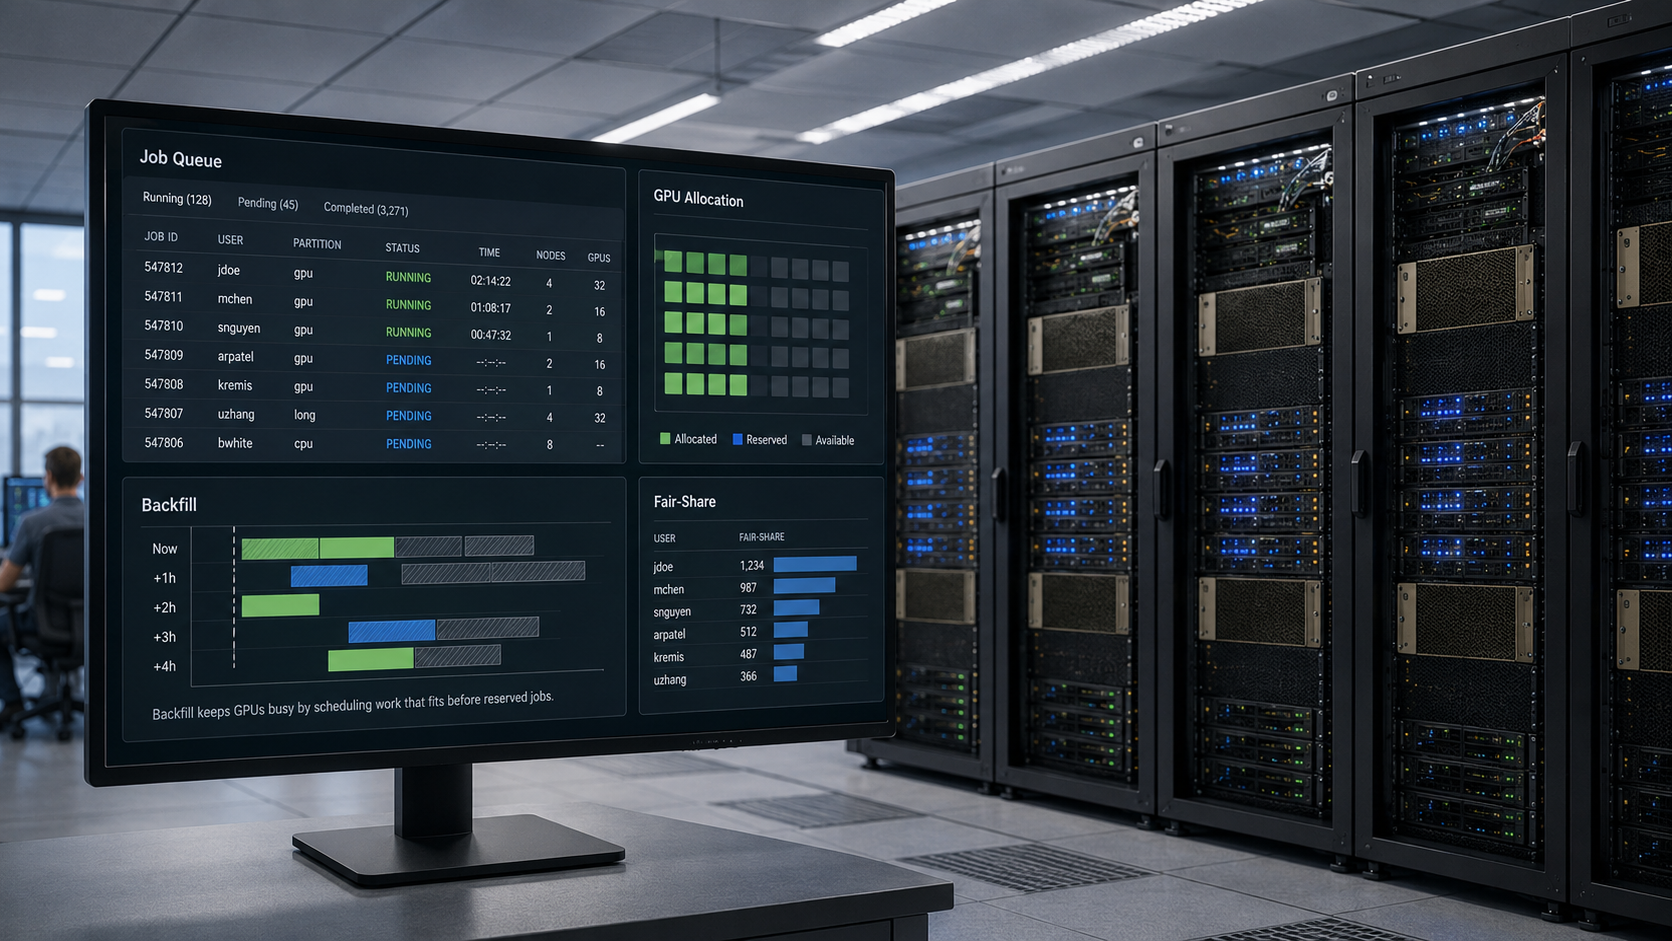
El backfill convierte los huecos vacíos en trabajo útil
Una cola de prioridad estricta puede desperdiciar capacidad. Un trabajo grande de alta prioridad puede ser el primero en la fila pero no poder comenzar hasta que se liberen suficientes nodos. Sin lógica adicional, los trabajos más pequeños que podrían terminar antes de esa reserva también podrían esperar, dejando recursos inactivos.
El planificador de backfill de Slurm aborda ese problema estimando cuándo pueden comenzar los trabajos de mayor prioridad y luego iniciando trabajo de menor prioridad que debería terminar sin retrasarlos. El planificador no solo pregunta qué trabajo sigue. Pregunta si un trabajo puede usar una apertura temporal preservando un inicio esperado para el trabajo que está delante.
El mecanismo es potente porque los grandes clústeres suelen estar fragmentados. Algunos nodos terminan antes; otros permanecen ocupados. Un trabajo corto puede caber en el hueco sin cambiar la hora de inicio del trabajo que la institución considera más importante. El backfill puede, por tanto, mejorar la utilización y reducir el tiempo de espera al mismo tiempo.
Su eficacia depende de la información que recibe. Si los usuarios solicitan mucho más tiempo de pared del que necesitan, el planificador puede concluir que un trabajo no cabe de forma segura. Si solicitan demasiado poco, el trabajo puede terminar antes de finalizar. Las restricciones de topología y acelerador pueden hacer inutilizable un hueco teóricamente disponible. Los fallos pueden invalidar el plan esperado.
El backfill ilustra el modelo operativo de Slurm en miniatura. El software puede tomar una decisión sofisticada a partir del estado declarado, pero no puede conocer perfectamente el futuro. Mejores resultados de cola dependen de solicitudes precisas, un estado de clúster fiable y políticas que den al planificador suficiente margen para hacer concesiones.
Las GPU hicieron que la forma de una asignación fuera tan importante como su tamaño
Los aceleradores cambiaron lo que significa «capacidad disponible». Una solicitud de ocho CPU suele ser más intercambiable que una solicitud de ocho GPU en un trabajo de entrenamiento distribuido. El modelo de acelerador, la capacidad de memoria, las relaciones PCIe o NVLink, la posición en la red y la composición del nodo pueden determinar si la asignación funciona como se espera.
Slurm representa los recursos heterogéneos mediante Trackable RESources, o TRES, y Generic RESources, o GRES. Las GPU pueden contarse, tipificarse y asociarse a nodos. La integración de dispositivos y cgroups puede restringir un trabajo a los aceleradores que se le asignaron. Los plugins y las restricciones de topología pueden ayudar al planificador a ubicar el trabajo con cierto conocimiento de la máquina física.
Eso convierte a la GPU de un periférico conectado en una unidad económica planificable. Los administradores pueden contabilizar el uso del acelerador, limitar el acceso, reservar tipos de dispositivo concretos y diseñar políticas en torno al hardware escaso. Para la infraestructura de IA, esto es importante porque la cola a menudo decide el acceso al componente más caro del clúster.
Un modelo de recursos, sin embargo, solo es tan útil como la topología que captura. Ocho GPU libres repartidas entre nodos con rutas de comunicación inadecuadas pueden no equivaler a ocho GPU dentro de dos servidores estrechamente conectados. Un planificador puede elegir según la topología configurada, pero no puede deducir automáticamente todas las dependencias de red, memoria o aplicación.
El mismo límite se aplica a la utilización. Un panel puede mostrar que las GPU están asignadas mientras el trabajo espera por almacenamiento, comunicación colectiva, carga de datos o fallos repetidos. Slurm puede decir al operador quién mantuvo el recurso y cuándo. No demuestra, por sí mismo, que el acelerador estuviera realizando trabajo productivo.
El planificador se sitúa por encima de la red, pero sigue dependiendo de ella
Slurm no está en la ruta de datos. Una vez que un trabajo comienza, el tráfico de la aplicación se mueve a través de procesadores, memoria, interconexiones y almacenamiento sin pasar por el planificador. Eso no hace que el planificador sea independiente de la infraestructura física.
Las decisiones de ubicación pueden concentrar o distribuir el trabajo entre conmutadores, bloques o dominios de aceleradores. Una asignación consciente de la topología puede reducir la distancia de comunicación de un trabajo paralelo. Una asignación ciega a la topología puede convertir suficiente capacidad bruta en un trabajo de bajo rendimiento porque el ancho de banda útil está en otro lugar.
El planificador también depende de un estado preciso de los nodos. Una GPU puede estar presente pero no ser saludable. Un nodo puede ser alcanzable para el controlador mientras su ruta de almacenamiento está degradada. Una partición de red puede hacer que un trabajo en ejecución se vea diferente desde la perspectiva del controlador. Los plugins, las comprobaciones de salud de los nodos y las operaciones locales deben traducir esas condiciones físicas en estados sobre los que el planificador pueda actuar.
Esto crea un límite que es fácil malinterpretar en los informes de rendimiento. Si un trabajo va lento, la causa raíz puede ser la asignación, el comportamiento de la aplicación, el almacenamiento, la contención de red, la salud del acelerador o una combinación. Si el clúster está inactivo, la causa puede ser la baja demanda, la fragmentación, las reservas o los fallos, más que un mal algoritmo de planificación.
Para los operadores, la medida útil es, por tanto, todo el camino desde la solicitud hasta el trabajo completado: retardo de cola, calidad de la asignación, éxito del lanzamiento, tiempo de ejecución, reintentos, trabajo perdido y finalización. La asignación agregada de GPU es informativa, pero no es lo mismo que la producción productiva.
SchedMD convirtió un proyecto abierto en un negocio de soporte
A medida que Slurm superó sus orígenes de laboratorio, las organizaciones necesitaron algo más que código fuente. Los clústeres de producción requerían lanzamientos predecibles, depuración, ayuda con las actualizaciones, formación e ingenieros que pudieran trabajar en configuraciones de sitio inusuales. Los desarrolladores de Slurm fundaron SchedMD en 2010 para proporcionar esa capa comercial.
El acuerdo creó un intercambio habitual en el código abierto. El código siguió disponible abiertamente bajo su licencia de proyecto, mientras los clientes pagaban por experiencia, soporte y desarrollo en torno a sistemas de producción difíciles. El trabajo comercial dio a los mantenedores una forma de financiar ingeniería sostenida y dio a los operadores una vía de escalado cuando la cola que controlaba un clúster importante se comportaba de forma inesperada.
SchedMD también se convirtió en un punto de concentración de conocimiento. Los grandes sistemas de planificación acumulan detalles operativos difíciles de aprender solo con la documentación: recuperación de fallos, orden de actualizaciones, interacciones de plugins, casos límite de contabilidad y efectos de políticas inusuales. Una empresa que emplea a mantenedores clave puede convertir esa experiencia en una ventaja de soporte sin ser dueña de cada contribución o de cada despliegue.
Esa distinción importa porque la política de Slurm siempre ha seguido siendo local. SchedMD podía enviar código, parches y orientación; no decidía las ponderaciones de reparto equitativo, las reservas ni los derechos de cuenta dentro de una universidad, un laboratorio nacional o un servicio comercial de IA. La experiencia de usuario de Slurm es en parte software ascendente y en parte la propia constitución de la institución.
Cuando la IA amplió el valor de la capacidad de GPU planificada, el papel de SchedMD era, por tanto, mayor que el de un proveedor de software convencional. Era el principal custodio comercial de un plano de control abierto que muchos operadores ya habían integrado en sus flujos de trabajo, scripts, sistemas contables y procedimientos operativos.
NVIDIA cambió los incentivos en torno a la custodia
NVIDIA anunció su adquisición de SchedMD el 15 de diciembre de 2025. Dijo que Slurm seguiría siendo de código abierto y neutral respecto a los proveedores, al tiempo que sostenía que los desarrolladores de SchedMD tendrían acceso a más sistemas acelerados y recursos de ingeniería. La licencia no se volvió repentinamente propietaria, y la adquisición no transfirió la política de planificación local de los operadores a NVIDIA.
Lo que cambió fue la estructura de incentivos en torno al principal custodio comercial del proyecto. NVIDIA no es solo una empresa de software que financia mantenedores. También es un proveedor líder de GPU, redes y sistemas cuyo rendimiento puede depender de cómo se descubren, ubican y lanzan las cargas de trabajo.
Eso crea un beneficio plausible y una preocupación plausible. Un acceso más temprano a sistemas de IA complejos puede mejorar las pruebas y acortar el camino desde los cambios de hardware hasta el soporte del planificador. Esa misma proximidad plantea una pregunta legítima sobre si los aceleradores, interconexiones y diseños de sistemas competidores siguen recibiendo atención de primera clase.
La evidencia disponible en los primeros meses tras la adquisición no justifica declarar ni captura ni neutralidad perfecta. El desarrollo público continuó. Slurm 26.05 y los parches posteriores mostraron un trabajo de lanzamiento activo, mientras que los parches de julio de 2026 abordaron fallos y otros problemas operativos. Slinky también siguió desarrollándose. Esos son indicadores de custodia más sólidos que una promesa del día de la adquisición, pero no resuelven la cuestión comparativa a largo plazo.
NVIDIA también describió Slurm como muy utilizado en los principales sistemas de supercomputación y dijo que SchedMD daba soporte a cientos de clientes en el momento de la adquisición. Esas afirmaciones indican escala, pero siguen siendo comunicadas por la empresa y fechadas. No son un censo completo de los clústeres privados de IA, los sistemas de investigación ni todos los despliegues de planificadores.
La cuestión de la neutralidad debería plantearse, por tanto, como una prueba de ingeniería observable. ¿Se mantienen genéricas las interfaces cuando pueden serlo? ¿Los problemas que afectan a hardware competidor se gestionan de forma abierta y rápida? ¿Los procesos de lanzamiento y los entornos de integración continua ejercitan una base de hardware genuinamente heterogénea? ¿Pueden los contribuyentes externos seguir influyendo en el código sin pasar por un producto propietario de NVIDIA?
El código abierto da a los operadores un derecho de salida, no un reemplazo gratuito
La licencia de código abierto de Slurm importa porque los operadores pueden inspeccionar, modificar y redistribuir el código según sus términos. Eso crea una barrera formal contra una simple conversión en software cerrado y da a la comunidad una vía legal para hacer un fork si la custodia se vuelve inaceptable.
Un fork viable, sin embargo, no se crea solo con una licencia. La planificación a gran escala necesita mantenedores que entiendan el estado del controlador, la contabilidad, los plugins, los lanzamientos, la seguridad y una amplia matriz de hardware. Necesita sistemas de prueba, confianza de los usuarios y personas dispuestas a portar correcciones a las versiones soportadas.
El coste práctico de cambio también es mucho mayor que reemplazar un ejecutable. Los entornos maduros de Slurm acumulan scripts de trabajos, estructuras de cuentas, uso histórico, plugins personalizados, monitorización, procedimientos operativos y hábitos de usuario. Otro planificador puede ser técnicamente capaz y aun así requerir una migración costosa de la política y la memoria institucional.
Por eso la propiedad de NVIDIA merece un escrutinio sin tratar la capacidad de fork como una respuesta completa. La forma más fuerte de neutralidad no es la capacidad teórica de irse después de un problema. Es un proyecto que sigue siendo útil en infraestructura heterogénea antes de que irse se vuelva necesario.
El mismo razonamiento se aplica al soporte comercial. Los operadores pueden depender de la experiencia de la empresa que emplea a los mantenedores clave incluso cuando el código es abierto. Si esa experiencia se reduce a un ecosistema de hardware, el código fuente puede seguir disponible mientras el límite práctico del soporte se vuelve menos neutral.
Slinky pone dos planos de control en el mismo entorno
La infraestructura moderna de IA combina cada vez más la planificación por lotes con Kubernetes. Los equipos de plataforma pueden querer Kubernetes para el aprovisionamiento, los operadores, los servicios y el ciclo de vida de los contenedores, conservando al mismo tiempo el modelo de trabajos de Slurm, el reparto equitativo, las reservas y la semántica de cargas de trabajo paralelas.
Slinky es el intento de SchedMD de unir esos mundos. Suslurm-operatorpuede desplegar y gestionar componentes de Slurm mediante mecanismos orientados a Kubernetes, mientras queslurm-bridgecoordina el trabajo entre Kubernetes y Slurm sobre recursos compartidos. La versión 1.2.0 se publicó el 2 de julio de 2026, después de que la primera línea estable apareciera a finales de 2025.
El atractivo es claro. Una organización puede conservar la política establecida de Slurm mientras usa herramientas nativas de la nube para gestionar la infraestructura circundante. Eso puede reducir la necesidad de construir un entorno operativo completamente separado para la computación por lotes.
La dificultad es la autoridad. Kubernetes y Slurm tienen modelos diferentes de estado deseado, propiedad de las cargas de trabajo y recuperación. Si ambos sistemas creen que controlan un nodo, un dispositivo o una carga de trabajo después de un fallo, la integración necesita una respuesta clara sobre qué estado es la autoridad y cómo se reconcilia el otro sistema.
Esta no es una razón para rechazar el enfoque. Es la razón por la que Slinky debería juzgarse por la evidencia operativa, no por la elegancia arquitectónica. Los despliegues de producción deben mostrar cómo se gestionan las actualizaciones, el fencing, el RBAC, los fallos del controlador y las particiones parciales de red cuando intervienen dos sistemas de orquestación.
La historia de Slurm ha ampliado repetidamente el límite de lo que el planificador coordina. La integración con Kubernetes continúa ese patrón, pero cada nueva superficie de control aumenta la importancia de saber dónde se mueve la responsabilidad cuando algo falla.
La cola puede mejorar la utilización y aun así producir un mal resultado
Slurm ofrece a los operadores muchas formas de hacer más útil la capacidad cara. El backfill puede reducir los huecos inactivos. El reparto equitativo puede distribuir el acceso a lo largo del tiempo. La ubicación consciente de la topología puede mejorar la localidad. Las reservas pueden proteger el trabajo crítico. El desalojo puede hacer espacio para trabajos urgentes o premium.
Cada mecanismo también tiene un coste. Una reserva puede dejar capacidad varada si el trabajo esperado no llega. El desalojo puede destruir trabajo útil cuando las aplicaciones no pueden hacer puntos de control. Una regla de topología puede preservar el rendimiento de un trabajo mientras aumenta la fragmentación de otros. El reparto equitativo puede recompensar una política que ya no coincide con las prioridades de la institución.
El riesgo crece cuando los operadores optimizan una sola métrica. Una alta asignación de GPU puede lograrse manteniendo dispositivos asignados a trabajo que está bloqueado en otro lugar. Un tiempo de cola bajo puede lograrse admitiendo trabajos en formas de recursos que alargan la ejecución. Un desalojo agresivo puede proteger un nivel de servicio mientras desperdicia la energía y la computación ya gastadas en trabajos interrumpidos.
Para la infraestructura de IA, la mejor medida es el trabajo útil completado por unidad de capacidad escasa y tiempo. Slurm contribuye a ese resultado, pero es solo una capa. Los marcos de entrenamiento, el almacenamiento, el diseño de red, los puntos de control, la salud de los aceleradores y la calidad de las solicitudes de los usuarios afectan a si la asignación crea valor.
Este es también el límite entre la responsabilidad ascendente y la local. Si un sitio elige una política que privilegia una cuenta, abusa de las reservas o establece reglas de desalojo poco realistas, el resultado no debería atribuirse automáticamente a SchedMD o NVIDIA. Si el planificador calcula mal el estado, gestiona mal un dispositivo o introduce una regresión, el comportamiento ascendente se convierte en la capa relevante.
Una operación creíble necesita suficiente auditabilidad para distinguir esos casos.
La superficie de control real está repartida entre varios actores
La custodia de Slurm puede parecer central porque un controlador planifica el clúster y una empresa emplea ahora a muchos de los expertos del proyecto. En la práctica, el control está dividido.
Los mantenedores ascendentes deciden qué código entra en los lanzamientos. NVIDIA es propietaria de SchedMD y puede asignar recursos de ingeniería. Los proveedores de hardware contribuyen con trabajo de integración y proporcionan sistemas para las pruebas. Los administradores de clústeres eligen versiones, plugins, modelos de topología, cuentas, QOS y límites. Los líderes institucionales deciden quién tiene derecho a la computación escasa. Los usuarios deciden qué recursos solicitar y con qué precisión describen el tiempo de ejecución. La aplicación determina entonces si la asignación se usa de forma eficiente.
Ese control en capas es el hecho central de Slurm. Ningún actor único es dueño del resultado completo.
También explica por qué la gobernanza de la cola se ha vuelto estratégicamente importante. Cuando los aceleradores eran menos escasos y menos valiosos, una regla subóptima podía ser irritante. En un gran entorno de IA, la misma regla puede cambiar los tiempos de espera, la fragmentación y la cantidad de capacidad cara que termina trabajo útil.
El logro de Slurm es que un sistema abierto común puede expresar modelos de asignación muy diferentes sin obligar a cada institución a una única definición de equidad. Su limitación es idéntica: el software no puede garantizar que un modelo elegido sea sensato, legible o legítimo.
La prueba a largo plazo no es, por tanto, si Slurm sigue planificando trabajos. Es si los operadores pueden seguir reconstruyendo por qué un trabajo recibió o perdió el acceso a la computación escasa, mientras el proyecto ascendente sigue siendo creíble en el hardware heterogéneo que esos operadores quieren ejecutar.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance