
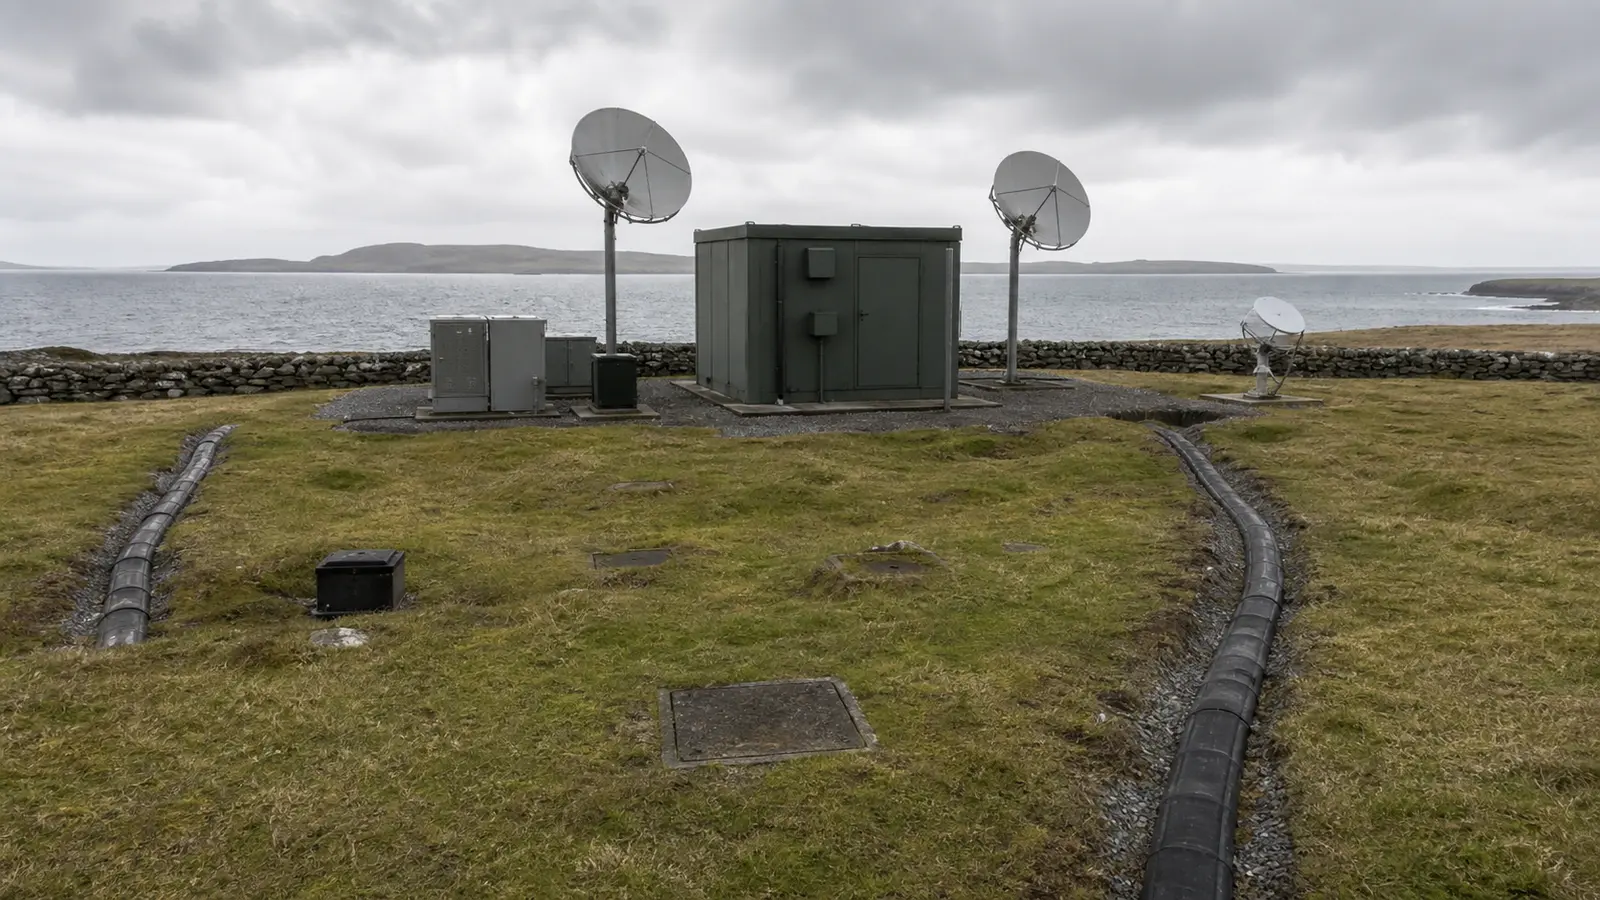
Resumen
- Ofcom informó que los residentes de Shetland perdieron los servicios móviles y de líneas fijas durante aproximadamente 16 horas en octubre de 2022, después de que el enlace de fibra submarina del sur se dañara mientras que un enlace secundario ya estaba fuera de servicio por daños sufridos la semana anterior. [10]
- Ofcom dijo que la microonda de baja capacidad heredada mantuvo en gran medida disponible la voz PSTN. También indicó que la recuperación temporal se logró al aumentar la potencia óptica en el origen y que las reparaciones en ambos enlaces, principal y secundario, duraron alrededor de diez días. [10]
- La correspondencia del Gobierno escocés describe problemas intermitentes en el enlace resistente desde el 14 de octubre y que Faroese Telecom había enviado personas a trabajar en él. El segundo suceso ocurrió poco después de la medianoche del 20 de octubre, cuando el cable principal se dañó. La correspondencia describe la causa como daño accidental por un buque pesquero registrado en el Reino Unido y afirma que el suceso afectó a casi todos los servicios transportados en ese cable. [4][5][11]
- Las declaraciones de Shetland News informaron que técnicos activaron capacidad de fibra de reserva o sin uso en el cable dañado y restauraron gran parte del servicio transportado por fibra BT. Esto muestra una acción específica de recuperación, no que cada servicio o proveedor se recuperara al mismo tiempo. [15][20]
- Shetland Islands Council dijo que algunos clientes permanecían sin conexión porque sus proveedores no tenían conexiones resilientes y no podían acceder a la fibra sin daños. El Consejo también informó de problemas que afectaban a algunos telecuidos y alarmas comunitarias. [13]
- Police Scotland desplegó agentes y vehículos para preservar el acceso a los servicios de emergencia mientras las comunicaciones normales estaban deterioradas. [12]
- La cuestión de rendición de cuentas no es si había o no dos cables físicos. Es quién controló la capacidad alternativa utilizable, el acceso de proveedores, el respaldo óptico y de microondas, la contingencia de emergencia, la secuencia de reparación y la evidencia usada para declarar servicios restaurados.
- Los contratos completos de proveedores, políticas de enrutamiento, presupuestos ópticos, poblaciones de clientes y registros de pérdida no son públicos. La evidencia respalda un análisis de control, no una acusación proveedor por proveedor.
- La comparación más cercana es la caída del cable en Tonga en 2022, pero los casos son distintos. Tonga centró una ruta internacional principal, daño volcánico del fondo marino y una logística de reparación prolongada. Shetland expuso la brecha entre rutas nominalmente diversas y acceso específico por servicio a la capacidad superviviente.
Una avería mayor puede existir dentro de un diagrama redundante
La redundancia es una de las palabras más tranquilizadoras en infraestructura.
Sugiere que el fallo de un componente no se convertirá en fallo de servicio. Se espera que un segundo cable, enrutador, alimentación eléctrica, centro de datos o plano de control soporte la carga. La palabra suele aparecer en diagramas de arquitectura, documentos de contratación, presentaciones regulatorias y registros ejecutivos de riesgo mucho antes de comprobar si funciona.
La interrupción de Shetland en octubre de 2022 muestra por qué la redundancia instalada y la redundancia utilizable deben tratarse como hechos distintos.
Las islas estaban conectadas a través de rutas de fibra submarina que seguían hacia el sur por Orkney rumbo a la Escocia continental y hacia el norte hacia las islas Feroe. El registro público describe una como ruta principal y la otra como resistente o secundaria. En la semana antes del 20 de octubre, el enlace norte ya estaba afectado. Poco después de la medianoche del 20 de octubre, el enlace sur se dañó. Ofcom resumió posteriormente el resultado como una pérdida aproximada de 16 horas de servicios móviles y de línea fija. [4][10]
A primera vista, el evento puede describirse como mala suerte: dos fallos físicos en pocos días. El daño fue reportado como accidental. Se identificó en el registro público a un buque pesquero. La reparación de cables requiere buques, ventanas meteorológicas, personal especializado y acceso físico a los puntos de fallo. Ninguno de esos hechos es trivial. [4][11][16]
Pero la mala suerte no responde a la pregunta operacional.
¿Por qué un sistema con dos rutas produjo una disrupción tan amplia? ¿Por qué algunos servicios volvieron rápido mientras algunos clientes permanecieron afectados durante buena parte de la semana siguiente? ¿Por qué la voz heredada permaneció más disponible que servicios dependientes de datos? ¿Por qué un conjunto de tráfico podía usar capacidad restaurada o alternativa mientras otro no?
Esas preguntas mueven el análisis fuera de la existencia de acero, vidrio y equipos de aterrizaje del cable. Lo mueven hacia los controles que convierten infraestructura en servicio:
- disponibilidad de ruta;
- potencia óptica y margen;
- pares de fibra utilizables;
- capacidad reservada y de reserva;
- configuración de conmutación y enrutamiento;
- acceso mayorista;
- acuerdos de proveedores minoristas;
- backhaul de respaldo;
- planes de emergencia;
- prioridad de reparación;
- monitorización de servicio;
- evidencia de restauración.
Una segunda ruta puede estar físicamente presente pero no disponible porque ya está dañada. Puede estar sana pero con capacidad insuficiente. Puede existir capacidad sin un camino contractual o técnico para un servicio concreto. Un proveedor puede tener una ruta sobre el papel pero no probar el estado de failover. Un backhaul de baja capacidad puede mantener voz mientras la banda ancha permanece inaccesible. Un operador puede restaurar luz por fibra sin probar que todos los servicios aguas abajo hayan recuperado.
El registro de Shetland contiene ejemplos de varias de esas condiciones. Eso lo convierte en un caso de rendición de cuentas de infraestructura de red, no en una historia genérica sobre un corte de cable.
Los dos fallos deben permanecer separados
El suceso necesita dos relojes.
La correspondencia del Gobierno escocés dice que el cable resistente presentó incidencias intermitentes desde el 14 de octubre y que Faroese Telecom había enviado personal para trabajar en él. El segundo evento ocurrió poco después de la medianoche del 20 de octubre, cuando el cable principal se dañó. La correspondencia describe la causa como daño accidental por un buque pesquero registrado en el Reino Unido y dice que el evento afectó casi todos los servicios transportados por ese cable. [4]
El informe posterior de Ofcom usa un lenguaje operativo ligeramente distinto. Indica que un enlace de fibra secundario ya estaba inaccesible por daño ocurrido la semana anterior. Indica que el cable de fibra sur sufrió entonces una pérdida de luz. [10]
Esas descripciones no deben fusionarse en una afirmación de que los dos cables se cortaron limpiamente al mismo momento.
El registro público distingue problema intermitente, indisponibilidad, efectos de fibra, pérdida de luz y reparación del cable. El director general de Faroese Telecom fue reportado diciendo que el fallo posterior afectó fibras pero no seccionó por completo el cable. Medios locales sitúan el fallo a pocos kilómetros de Shetland y describen un buque de reparación trabajando en más de una ubicación. [15][16][18]
Esa distinción importa por tres razones.
Primero, el mecanismo físico afecta las opciones de recuperación. Una rotura total, un par de fibra dañado, un problema de amplificador, un problema de alimentación eléctrica y un margen óptico reducido no son el mismo fallo. Pueden permitir medidas temporales diferentes.
Segundo, la descripción afecta a la responsabilidad. Un propietario de cable puede controlar reparación y restauración óptica. Un operador puede controlar la colocación del tráfico. Un proveedor minorista puede depender de una vía mayorista para ese tráfico. Una autoridad pública puede controlar la respuesta de emergencia. Asignar una sola etiqueta a todo el evento puede ocultar esos límites.
Tercero, la distinción evita exageraciones retrospectivas. El incidente fue grave sin llamar “cortado” por completo al cable o “totalmente indisponible” a todo servicio durante diez días. Ofcom dice que las unas 16 horas describen la pérdida principal de servicios móviles y de línea fija. El periodo de diez días describe trabajo en ambos enlaces de fibra antes de la restauración permanente. Entre esos hitos continuaron problemas residuales de servicio. [10][13][18]
Por tanto, una cronología responsable separa al menos cinco estados:
- La ruta norte o secundaria desarrolla problemas.
- La reparación inicia mientras la ruta sur aún soporta servicio.
- La ruta sur se daña y sigue la pérdida amplia del servicio.
- Medidas ópticas y de capacidad temporales restauran gran parte del tráfico.
- Persisten fallos específicos de proveedor hasta completar reparaciones permanentes.
Esa secuencia es más útil que una sola duración de caída porque cada estado expone diferentes controles y responsables de decisión.
La diversidad física no es diversidad de servicio
La resiliencia de red se mide a menudo en la capa incorrecta.
En la capa física, Shetland tenía más de una dirección de conectividad de fibra. Una ruta iba hacia Orkney y a la Escocia continental. Otra iba hacia las islas Feroe. La geografía parece diversa.
En la capa de servicio, sin embargo, un cliente no compra una dirección abstracta bajo el mar. El cliente compra un servicio de banda ancha, móvil, voz o institucional. Ese servicio pasa por una cadena de equipos de acceso, agregación local, transporte mayorista, enrutamiento del proveedor, autenticación, sistemas de núcleo y interconexión ascendente. Cada eslabón de esa cadena necesita un alternativo funcional para que el servicio sobreviva a un fallo de cable.
El aviso del 28 de octubre del Consejo es excepcionalmente importante porque declara el problema de la capa de servicio directamente. Dijo que los usuarios que seguían sin internet eran atendidos por empresas que no tenían conexiones resilientes. Esos proveedores no podían acceder a la fibra sin daños y dependían de las reparaciones. [13]
La declaración no publica cada contrato ni tabla de enrutamiento. No prueba por qué cada proveedor carecía de acceso. No muestra si la limitación era comercial, técnica, histórica o combinación de ambas. No debe convertirse en una afirmación amplia de que compañías nombradas rehusaron deliberadamente la resiliencia.
Lo que sí demuestra es que la capacidad física alternativa no se traduce automáticamente en continuidad alternativa para todos los clientes.
Este es un patrón recurrente de fallo de infraestructura.
Un centro de datos puede tener dos alimentaciones de energía que comparten una subestación aguas arriba. Una aplicación en la nube puede ejecutarse en dos zonas de disponibilidad mientras depende de un mismo plano de control de identidad. Un operador móvil puede tener transporte redundante mientras ambas rutas terminan en el mismo enrutador. Un registro puede tener múltiples servidores de nombre que reciben la misma zona mal formada. Una isla puede tener dos direcciones de cable mientras el servicio de un proveedor solo es alcanzable por una ruta operacional o comercial.
En cada caso, contar componentes sobrestima la resiliencia. La pregunta correcta es si los dominios de fallo son independientes hasta el servicio.
Para Shetland, eso significa probar:
- si las rutas norte y sur eran físicamente independientes en los puntos de fallo;
- si los segmentos de aterrizaje y terrestres evitaban puntos comunes;
- si había capacidad suficiente en la ruta alternativa;
- si los proveedores estaban autorizados y configurados para usarla;
- si la conmutación podía ocurrir automáticamente;
- si los procedimientos de reruteo manual estaban actualizados;
- si dependencias como DNS, autenticación y gestión permanecían alcanzables;
- si la emergencia y el tráfico público tenían prioridad;
- si los clientes podían medirse por servicio restaurado y no solo por luz restaurada.
El registro público responde algunas de esas preguntas y deja otras abiertas. Esas lagunas de evidencia son parte de la rendición de cuentas y deben permanecer explícitas.
La mayor potencia óptica fue un control de recuperación
El relato de Ofcom contiene un detalle técnico que cambia la lectura.
Indica que el cable de fibra sur sufrió una pérdida de luz y que la recuperación temporal se logró aumentando la potencia emitida en el origen. [10]
Los sistemas de fibra óptica dependen de un presupuesto de enlace. La señal lanzada en fibra pierde potencia al pasar por el cable, repetidores, conectores y otros componentes. Un receptor necesita señal suficiente para distinguir datos con fiabilidad. El daño puede aumentar la atenuación sin destruir cada fibra. Si la ruta restante tiene margen suficiente, cambiar condiciones de transmisión puede restaurar temporalmente una señal utilizable.
El informe público no publica el diseño óptico exacto, los niveles de potencia, los pares de fibra o los umbrales de ingeniería. Sería incorrecto reconstruir esos detalles solo con principios generales. Sigue siendo razonable identificar la superficie de control.
Alguien tuvo que:
- detectar que el problema era una condición de pérdida de luz;
- determinar qué fibras o servicios seguían recuperables;
- evaluar si la potencia adicional era segura y útil;
- autorizar el cambio;
- monitorizar errores y estabilidad;
- decidir qué tráfico podía volver;
- mantener el progreso de reparación permanente.
Eso no es lo mismo que tener una segunda ruta.
La restauración óptica también crea un requisito de evidencia. “Luz restaurada” es un hecho de red necesario, pero no lo mismo que “servicio al cliente restaurado”. Una fibra puede pasar señal mientras el enrutamiento, la autenticación, la capacidad o caminos de proveedor posteriores permanecen degradados. El registro de recuperación debe entonces vincular mediciones físicas con pruebas de servicio.
Un informe de restauración responsable debería separar:
- continuidad óptica;
- estabilidad de capa enlace;
- alcance encaminado;
- tránsito al proveedor;
- establecimiento de sesión de banda ancha;
- backhaul móvil y alcance al núcleo;
- servicio de voz;
- llamadas de emergencia;
- acceso a aplicaciones de servicio público;
- disponibilidad observada por clientes.
El incidente de Shetland muestra por qué esta aproximación por capas importa. Gran parte del servicio volvió el 20 de octubre, y aún así el Consejo seguía advirtiendo problemas de internet y telecuidado el 28 de octubre. [13]
El éxito técnico temporal y la recuperación completa del servicio no fueron el mismo hito.
La fibra de reserva importó porque pudo activarse
La información local contemporánea añade otro mecanismo de recuperación.
Shetland News informó que Faroese Telecom activó fibra de reserva y capacidad sin usar en el cable dañado. La nota decía que esa capacidad estaba reservada para uso posterior y que su activación ayudó a reconectar servicios transportados sobre fibra BT. El director general del operador dijo que el fallo afectó a fibras sin cortar por completo el cable y que técnicos restauraron los servicios en lo posible. [15]
El texto es de atribución noticiosa, no un anexo técnico de Ofcom. Debe usarse con ese nivel de confianza. Aun así, demuestra un principio importante: una infraestructura de reserva solo tiene valor si los equipos de respuesta pueden activarla durante el incidente.
La fibra de reserva puede existir de varias formas. Un cable puede contener fibras no iluminadas, capacidad no usada en pares activos o capacidad reservada para crecimiento. Convertir esa reserva en servicio puede requerir equipos, configuración, derechos de uso, interfaces compatibles y coordinación operativa.
Las preguntas de responsabilidad son prácticas:
- ¿La capacidad de reserva estaba inventariada?
- ¿Los operadores conocían su estado?
- ¿Estaba conectada a equipos utilizables durante un fallo?
- ¿Se probaron procedimientos de activación?
- ¿Quién tenía autoridad para asignarla?
- ¿Qué servicios tenían prioridad?
- ¿Podían los proveedores aguas abajo alcanzarla?
- ¿Había margen suficiente para operación sostenida?
- ¿Qué mostró la monitorización sobre la estabilidad del camino temporal?
El incidente sugiere que al menos parte de la capacidad reservada se pudo convertir en recuperación real. También sugiere que esa conversión no cubrió todos los servicios aguas abajo.
Esto es una lección más útil que afirmar “construir más cables”. Más activos físicos pueden reducir riesgo, pero un cable que no se puede alcanzar, conmutar, alimentar, contratar u operar durante una avería es un diagrama caro. La inversión en resiliencia requiere pruebas de aceptación operativa.
Para cada ruta alternativa, un proveedor debería mostrar:
- los servicios mapeados a la ruta;
- la capacidad disponible durante el fallo;
- el disparador de failover;
- los comandos o automatizaciones usados;
- las personas autorizadas para actuar;
- las dependencias que siguen fuera de la ruta;
- los resultados de pruebas;
- el objetivo de recuperación;
- el riesgo residual.
Sin esa evidencia, la capacidad de reserva es una posibilidad más que un control.
La microonda de baja capacidad preservó un tipo distinto de continuidad
Ofcom dice que la voz PSTN permaneció en gran medida disponible por el backhaul microondas de baja capacidad heredado. [10]
Esa frase no debe leerse como prueba de que todas las líneas fijas funcionaban o de que la comunicación de emergencia no se vio afectada. El informe de situación del Gobierno escocés describió una pérdida amplia de servicios fijos, internet y móviles, y Police Scotland siguió desplegando presencia física para preservar acceso de emergencia. [4][12]
Ambos registros pueden coexistir.
La microonda heredada pudo preservar un camino acotado de voz mientras fallaban servicios de alto ancho de banda. La disponibilidad puede variar por central, proveedor, servicio, ubicación y momento. Un enlace de baja capacidad insuficiente para tráfico normal de internet puede seguir transmitiendo algo de voz. De forma inversa, un cliente que depende de un servicio digital o específico de proveedor puede no beneficiarse del camino heredado.
Esto recuerda que el fallback debe diseñarse alrededor de funciones mínimas viables, no solo de capacidad ordinaria.
En una falla severa de comunicaciones, las prioridades pueden incluir:
- llamadas de emergencia;
- coordinación entre policía, bomberos, ambulancia y guardacostas;
- comunicaciones hospitalarias y del servicio de salud;
- alarmas de telecuidado;
- avisos públicos;
- contacto esencial del gobierno;
- funciones críticas de pago y logística;
- gestión de equipos de reparación.
Un camino de respaldo puede ser valioso aunque no reproduzca internet normal. La tarea de ingeniería y gobernanza es identificar qué servicios debe soportar y demostrar que pueden usarlo.
El incidente de Shetland también muestra el riesgo de tratar la infraestructura antigua como resiliencia accidental. Si un enlace microondas legado sostiene una función de seguridad, su papel debe documentarse, mantenerse y probarse. Si se espera su retirada, la arquitectura sustituta necesita un camino de fallo equivalente o mejor antes de retirarlo.
De otro modo, la modernización puede eliminar una capa oculta de continuidad.
Los sistemas heredados no deben idealizarse. Baja capacidad, cobertura limitada y equipos envejecidos generan sus propios riesgos. El punto de rendición de cuentas es más estrecho: el valor de un fallback se determina por el servicio que preserva, no por si es antiguo o nuevo.
El acceso de emergencia convirtió la recuperación de red en responsabilidad pública
Las interrupciones de comunicaciones se convierten en sucesos de seguridad pública cuando no se puede llegar con fiabilidad a las organizaciones de emergencia.
Police Scotland informó que agentes y vehículos fueron trasladados al área para asegurar que el público mantuviera acceso a servicios de emergencia. Tras el retorno de las comunicaciones a normalidad, esos recursos se retiraron. [12]
La cobertura local recomendó probar 999 desde línea fija o móvil y, si no funcionaba, detener un vehículo de emergencia o acudir a un centro de policía, hospital, bomberos o ambulancia. Se usaron patrullas adicionales y un centro físico de emergencia como sustitutos de la accesibilidad normal. [19]
Estas medidas de respaldo importan porque revelan el servicio real que se protegía.
Un número de emergencia no es solo un servicio telefónico. Depende de:
- disponibilidad de red de acceso;
- enrutamiento de llamadas;
- localización del llamante cuando técnicamente esté disponible;
- interconexión con organizaciones de emergencia;
- energía en sitios del cliente y de la red;
- conocimiento público de alternativas;
- dotación y accesibilidad física cuando fallan las comunicaciones.
Las Condiciones generales de Ofcom describen requisitos orientados a amplia disponibilidad, acceso ininterrumpido a organizaciones de emergencia y arreglos para provisión o rápida restauración durante un desastre. Los deberes regulatorios precisos aplicables a un proveedor y a un suceso concreto requieren análisis jurídico, y las guías consolidadas actuales no deben aplicarse retroactivamente sin cautela. Eso no obstante, explica por qué el acceso de emergencia se trata como más que una métrica ordinaria de experiencia del cliente. [8]
La respuesta de Shetland debe evaluarse en dos capas.
La primera es prevención y recuperación de red. ¿Las rutas de llamadas de emergencia eran diversas? ¿La voz de respaldo restante funcionaba? ¿Las llamadas móviles alcanzaban la red de emergencia? ¿Los proveedores tenían arreglos probados con organizaciones de emergencia?
La segunda es contingencia civil. Cuando la accesibilidad de red se volvió incierta, ¿las autoridades establecieron alternativas visibles, movieron recursos, comprobaron a personas vulnerables y comunicaron por canales que seguían operativos?
Police y autoridades locales controlaron la segunda capa. No controlaban la condición del cable ni el enrutamiento mayorista. Su respuesta redujo daños, pero no debe usarse para eximir debilidades de la capa de red.
Un buen reemplazo de emergencia es evidencia de resiliencia. No es evidencia de que el servicio original cumplió su objetivo de disponibilidad.
El telecuidado reveló la dependencia bajo la aplicación
Shetland Islands Council informó de problemas que afectaban a algunos telecuidos y alarmas comunitarias, incluidos servicios por líneas analógicas fijas. Personal del personal de atención contactó clientes y pidió a familiares y conocidos verificar personas mayores o vulnerables. [13]
El telecuidado suele tratarse como un dispositivo o una aplicación de asistencia social. Durante una caída, sus dependencias de red se hacen visibles.
Un colgante o alarma doméstica puede parecer simple para el usuario. Detrás hay una cadena:
- energía en la vivienda;
- la unidad de alarma;
- cableado local o radio;
- un acceso fijo, móvil o de internet;
- intercambio y backhaul;
- un centro de monitorización;
- un proceso de respuesta humana.
El dispositivo puede estar funcional mientras el camino esté inaccesible. Una red puede restaurarse en parte mientras una alarma concreta siga fallando. Un proveedor puede informar recuperación amplia mientras un usuario vulnerable permanece aislado.
Por eso, la restauración de servicio debe medirse por función crítica, no solo por tráfico agregado.
La actualización del Consejo no dice que todas las alarmas fallaron. Dice que algunos servicios estuvieron afectados y describe una respuesta de bienestar manual. Esa frontera importa porque una señal de riesgo no puede inflarse a una reclamación de daño no respaldada.
La conclusión razonable es que la continuidad de telecomunicaciones forma parte de la continuidad asistencial. Operadores y agencias públicas necesitan un mapa compartido de dependencias que identifique:
- qué tipos de alarma usan qué tecnologías de acceso;
- de qué rutas mayoristas y de qué proveedor dependen;
- qué supuestos de batería o alimentación se aplican;
- cómo se detecta la falla;
- quién recibe alerta cuando falla el camino de comunicación;
- qué proceso de bienestar manual comienza;
- cómo se verifica la restauración en el dispositivo.
La experiencia de Shetland convirtió una caída abstracta de red en una pregunta concreta: ¿podía una persona vulnerable seguir llamando por ayuda?
Esa pregunta debe pertenecer al diseño de infraestructura antes del corte del cable.
Las diferencias entre proveedores son evidencia, no una licencia para especular
Las diferencias residuales de servicio están entre las partes más reveladoras del suceso.
El Consejo dijo que algunos usuarios afectados eran atendidos por compañías sin conexiones resilientes y no podían acceder a la fibra sin daño. Informes locales describieron posteriormente algunos proveedores reenruteando mientras otros seguían sin acceso. [13][18]
Es tentador convertir ese registro en una tabla de responsabilidad entre proveedores. La evidencia no respalda esa conclusión simple.
Las fuentes públicas no revelan:
- cada contrato mayorista;
- cada ruta comprada por cada proveedor minorista;
- límites de capacidad en rutas alternativas;
- el estado exacto del equipo de cada proveedor;
- qué clientes estaban en qué infraestructura;
- si un intento de conmutación falló;
- si una ruta era técnicamente posible pero comercialmente indisponible;
- qué objetivos de nivel de servicio aplicaban;
- qué información recibieron los proveedores durante reparación.
Un proveedor puede carecer de alterna porque no la compró. Puede depender de un mayorista que tampoco la tiene. Puede existir alternativa pero con capacidad insuficiente. El servicio puede compartir un dominio de fallo local que no sobreviva en ninguna dirección. Un proceso manual puede ser demasiado lento. La información pública no resuelve todas esas posibilidades.
El enfoque de rendición de cuentas es pedir evidencia.
Cada proveedor que vendió servicio en un mercado geográficamente restringido debería poder declarar, con el nivel adecuado de seguridad:
- los dominios de fallo en su acceso y backhaul;
- la ruta alternativa disponible cuando falla un segmento submarino;
- la capacidad comprometida en esa ruta;
- las condiciones que disparan failover;
- la prueba extremo a extremo más reciente;
- los servicios que se degradan o permanecen indisponibles;
- el objetivo de recuperación;
- el plan de comunicación con clientes y autoridades públicas.
Eso no significa exigir publicación de topología sensible. Es exigir demostrar que “resiliente” está asociado a un control operacional.
La declaración del Consejo es valiosa justamente porque informa el comportamiento de servicio observado. Algunos usuarios no podían usar fibra sin daño. Ese hecho debe impulsar una investigación focalizada sobre el porqué, sin suponer la respuesta.
La secuencia de reparación asignó continuidad
La reparación física de cable es una operación con restricciones.
La avería debe localizarse. Debe haber un buque y personal especializado disponible. Las condiciones de mar y tiempo deben permitir el trabajo. El cable puede necesitar recuperarse, cortarse, empalmarse, probarse y volver al lecho. Si hay más de una sección dañada, el buque no necesariamente puede reparar ambas a la vez.
La cobertura local informó que el buque de reparación finalizó trabajo en otra sección al oeste de Shetland antes de pasar al fallo al este de las islas. La restauración completa de banda ancha se informó tras finalizar la reparación posterior el 30 de octubre. [18]
Esta secuencia significa que el orden de reparación también es una decisión de asignación.
Los operadores necesitan criterios para decidir:
- qué fallo crea mayor riesgo de servicio;
- qué reparación es físicamente posible primero;
- si un camino temporal es suficientemente estable para esperar;
- qué ruta restaura más servicios críticos;
- si otro fallo crearía aislamiento total;
- cuánto tiempo puede aguantar la capacidad de respaldo la carga;
- si hay equipos y repuestos disponibles;
- qué ventana meteorológica se espera.
El registro público no muestra el libro completo de decisión. Sí muestra que reparaciones en ambos enlaces principal y secundario duraron alrededor de diez días y que se usaron controles temporales durante el intervalo. [10]
La responsabilidad no exige fingir que la reparación submarina puede ser instantánea. Exige evidencia de que el operador entendió el riesgo cambiante y tomó las mejores decisiones controlables.
Esa evidencia podría incluir:
- confianza en localización de fallo;
- estimaciones de impacto de servicio;
- disponibilidad de buque y tripulación;
- estado de capacidad de ruta;
- restricciones meteorológicas;
- estabilidad de restauración temporal;
- requerimientos de emergencia;
- razonamiento del orden de reparación;
- estimaciones de finalización actualizadas;
- pruebas ópticas y de servicio tras reparación.
La incertidumbre debe ser visible. Una estimación basada en llegada de buque y clima no es una promesa. Una actualización pública debe distinguir estado de fallo conocido, workaround actual, tiempo estimado de reparación y riesgo restante.
El suceso de Shetland muestra por qué la preparación de reparación forma parte del diseño de red. Una ruta no es plenamente resiliente si el operador no puede localizar fallos, obtener buque, acceder a repuestos, coordinar puntos de aterrizaje y comunicar evidencia de recuperación realista.
El control práctico estaba dividido
El suceso involucró a varias organizaciones, pero el control no estaba distribuido de forma uniforme.
El propietario y operador de cable
Faroese Telecom y el sistema SHEFA estaban más cercanos al fallo físico, condición óptica, fibra de reserva y reparación permanente. Las declaraciones atribuibles al operador describen acciones técnicas temporales y trabajo de buque de reparación. Esto da al operador de cable un control notable sobre la recuperación física.
Eso no le da al operador control sobre el diseño de servicio de cada cliente minorista ni sobre cada contrato posterior.
Proveedores mayoristas y minoristas de comunicaciones
Los proveedores controlaban, o dependían de otros para controlar, la colocación del tráfico, acceso a ruta alternativa, capacidad, comunicación con clientes y restauración de servicio. La actualización del Consejo sobre continuidad específica por proveedor hace esta capa central.
El registro público no revela cuál parte de cada cadena de proveedor tomó la decisión decisiva. La responsabilidad debe seguir la capacidad verificada, no la visibilidad de marca.
Ofcom y gobierno
Ofcom controló la información regulatoria y el marco amplio de resiliencia, no la reparación del incidente. Su informe de Connected Nations ofrece una base técnica pública. Los equipos de resiliencia gubernamentales coordinaron información y respuesta de emergencia. La cuestión regulatoria y de política es si los proveedores debían identificar y reducir el efecto conjunto de fallos previsibles.
El marco reforzado de seguridad y resiliencia de telecomunicaciones entró en vigor en octubre de 2022. Ofcom describió deberes para identificar riesgos, reducir el efecto de compromisos de seguridad y tomar acciones correctivas. Un accidente físico de cable no es automáticamente un compromiso de seguridad bajo toda disposición legal, por lo que el marco debe usarse como contexto de resiliencia y no como hallazgo de cumplimiento sin base. [6][7]
Police, Consejo, salud y socios de emergencia
Las autoridades públicas controlaron la mitigación local: patrullas, puntos de acceso físicos, contacto de bienestar y coordinación de servicios. Absorbieron consecuencias generadas por la falla de comunicaciones y no controlaron el cable ni el enrutamiento de proveedores.
Su trabajo es evidencia de transferencia de costo público. Cuando las telecomunicaciones normales fallan, las organizaciones públicas aportan personal, vehículos y controles manuales para recrear parte del servicio.
Clientes y usuarios vulnerables
Los clientes mantuvieron evidencia de fallo de servicio y consecuencias personales. Generalmente no controlaban diversidad de rutas, reparación o capacidad alternativa. El consejo de usar otro dispositivo, cambiar ubicación o pedir apoyo a un vecino puede reducir daños, pero no transfiere la responsabilidad de infraestructura al usuario.
Este mapa de control evita dos errores.
El primero es culpar al actor más cercano al daño físico por todas las consecuencias aguas abajo. El segundo es tratar la responsabilidad distribuida como ausencia de responsabilidad. Distintas partes controlaron funciones distintas de prevención, continuidad, recuperación y evidencia.
La responsabilidad no requiere probar intención maliciosa
El registro público describe daño accidental por actividad de pesca. [4][11][16]
Ese hallazgo acota el suceso. La evidencia disponible no respalda encuadrarlo como sabotaje, ataque geopolítico o perturbación deliberada.
Eso no elimina la responsabilidad.
La infraestructura suele verse dañada por causas ordinarias: excavación, anclas, equipos de arrastre, climatología, mantenimiento fallido, pérdida de alimentación y errores de configuración. Un sistema de resiliencia existe porque esas causas son previsibles aunque su momento exacto no lo sea.
Por tanto, las preguntas de responsabilidad son:
- ¿la ruta estaba protegida y monitorizada adecuadamente?
- ¿la segunda ruta era verdaderamente independiente?
- ¿los servicios tenían acceso utilizable a ella?
- ¿se probó failover?
- ¿la capacidad de respaldo era suficiente?
- ¿los equipos de respuesta pudieron restaurar fibras degradadas?
- ¿los arreglos de emergencia estaban actualizados?
- ¿las reparaciones estaban listas?
- ¿se informó al público de lo que seguía indisponible?
- ¿el trabajo posterior al incidente redujo la recurrencia?
Ninguna de esas preguntas depende de la intención maliciosa.
La intención importa para atribución legal y de seguridad. El control importa para la rendición de cuentas operacional.
La misma distinción protege contra culpas injustas. Un operador de cable no puede impedir que cualquier embarcación pesquera toque un cable. Un proveedor minorista no puede reparar una fibra submarina que no posee. Un Consejo local no puede reconfigurar el backhaul de un proveedor.
La indagación justa pregunta qué podía hacer cada parte de forma realista antes, durante y después del evento.
Un operador puede rendir cuentas por señalización de ruta, monitorización, localización de fallo y preparación de reparación. Un operador puede rendir cuentas por capacidad alternativa y conmutación probada. Un regulador puede rendir cuentas por expectativas de resiliencia y evidencia. Las agencias públicas pueden rendir cuentas por planes de emergencia.
Esto es más sólido que un relato de culpas porque identifica controles que pueden cambiar.
Las cifras de impacto necesitan disciplina por capas
El incidente generó varias medidas temporales e impacto.
El “aproximadamente 16 horas” de Ofcom se refiere al periodo principal en el que los residentes quedaron sin servicios móviles y de línea fija. El regulador también describe diez días de reparación en ambos enlaces antes de la restauración permanente. [10]
Fuentes locales reportan que algunos clientes permanecieron afectados durante ese intervalo, especialmente donde proveedores no podían usar capacidad alternativa. [13][18]
Esas cifras no deberían combinarse en una sola afirmación de que todos los clientes estuvieron offline durante diez días.
Del mismo modo, los reportes de “caída total” deben leerse en contexto. El informe de situación gubernamental dijo que la mayoría de los servicios de línea fija, todas las conexiones de internet y todos los servicios móviles se vieron afectados en un punto dado. Ofcom luego dijo que la voz PSTN permaneció en gran medida disponible por microonda de baja capacidad. [4][10]
Esos registros pueden reflejar marcas temporales diferentes, definiciones de servicio y la información disponible en cada institución. El enfoque correcto es presentar ambos y evitar precisión falsa.
Una contabilidad útil distingue:
- periodo de pérdida amplia de servicio;
- tiempo de restauración temporal;
- disrupción residual por proveedor;
- reparación física permanente;
- tiempo de indisponibilidad por cliente;
- duración de workaround de emergencia.
Cualquier reporte de restauración debe separar también usuarios, suscripciones, ubicaciones y servicios. Un hogar puede tener banda ancha fija, varias suscripciones móviles y una línea fija. Un telecuidado puede fallar mientras otro servicio de voz funciona. Un proveedor puede restaurar tráfico agregado mientras un grupo concreto permanece desconectado.
Sin registros por proveedor, no puede producirse un conteo completo de usuarios afectados o pérdidas económicas.
Esta limitación no es una debilidad que se oculte. Es un hallazgo sobre calidad de evidencia pública.
Las reclamaciones de restauración necesitan una matriz, no una sola marca temporal
La frase “servicios restaurados” es necesaria para la comunicación pública, pero puede ocultar recuperación desigual.
Para Shetland, al menos cuatro afirmaciones de restauración fueron verdaderas en tiempos distintos:
- Una solución técnica temporal restauró gran parte del servicio amplio el 20 de octubre.
- La policía dijo luego que las comunicaciones normales regresaron lo suficiente para retirar recursos adicionales. [12]
- Algunos clientes y funciones de telecuidado seguían con problemas el 28 de octubre. [13]
- La restauración completa de banda ancha se informó tras reparación permanente el 30 de octubre. [18]
Una matriz de restauración haría explícitas esas diferencias.
Las filas deben representar funciones de servicio:
- voz PSTN;
- voz móvil;
- llamadas de emergencia;
- datos móviles;
- banda ancha fija;
- conectividad empresarial;
- servicios del Consejo;
- sistemas de salud;
- telecuidado;
- sistemas de pago;
- comunicaciones de aeropuerto y transporte.
Las columnas deben representar evidencia:
- estado de enlace óptico;
- alcance de ruta;
- establecimiento de sesión;
- transacciones exitosas;
- sondeos externos;
- telemetría del proveedor;
- confirmación de autoridades públicas;
- observación de clientes;
- conteo residual de incidentes.
Un servicio debe pasar de “degradado” a “restaurado” solo cuando exista la evidencia exigida. El estándar no tiene que ser idéntico para todo servicio. La llamada de emergencia puede requerir una prueba más fuerte que la navegación web ordinaria. Un proveedor puede decir que el servicio se restauró para la mayoría y, a la vez, mantener un cohorte conocida afectada.
Esto evita dos extremos dañinos.
Uno es esperar certeza perfecta antes de comunicar avance. El otro es declarar restauración total cuando solo retornó el camino central.
La recuperación escalonada de Shetland es exactamente el tipo de evento que se beneficia de una matriz.
La lección regulatoria es evidencia, no eslóganes
Ofcom incluyó el evento de Shetland en su debate de Connected Nations 2022 sobre resiliencia de red y servicio. Esa publicación le da al suceso significación regulatoria más allá de la cobertura local. [9][10]
La lección no debe reducirse a “más regulación” o “más inversión”.
Un marco de resiliencia efectivo necesita evidencia de que los proveedores:
- identifican dependencias críticas;
- comprenden modos de fallo geográficos y lógicos comunes;
- mantienen capacidad alternativa suficiente;
- prueban conmutación bajo carga realista;
- protegen acceso de emergencia;
- monitorizan degradación;
- comunican incidentes mayores;
- preservan capacidad de reparación;
- aprenden del fallo observado.
Ofcom también describe en sus Condiciones Generales una disponibilidad amplia y expectativas de planificación de emergencia. Su trabajo de seguridad de red describe un marco de reducción de riesgo y remediación. La aplicación jurídica exacta depende de proveedor, servicio y fecha, y la evidencia pública disponible no permite una conclusión de cumplimiento específica del evento. [6][7][8]
Lo que sí respalda el suceso es un principio de verificación.
Los reguladores no deberían aceptar que la existencia de una segunda ruta prueba resiliencia. Deben preguntar qué servicios pueden usarla, con qué capacidad, bajo qué disparador y con qué evidencia de prueba.
Esto también mejora decisiones de inversión. Si la falla provino de falta de diversidad física, conviene construir otra ruta. Si la capacidad alternativa existía pero proveedores no podían alcanzarla, se corrigen acceso e interconexión. Si la conmutación fue demasiado lenta, se mejora automatización y procedimientos. Si sistemas de emergencia dependían de una única tecnología de acceso, se diversifica el camino de servicio. Si la logística de reparación dominó la recuperación, se mejoran repuestos y acuerdos de buques.
Las distintas causas de fallo requieren remedios distintos.
Shetland no es Tonga
Una comparación útil es la de la rotura del cable de Tonga en 2022. Ambos eventos involucran islas, fibra submarina, capacidad de respaldo, buques de reparación y dependencia de servicios públicos.
El vocabulario común no los hace duplicados.
El cable internacional principal de Tonga se rompió tras la erupción del volcán Hunga Tonga-Hunga Ha'apai y tsunami. El suceso implicó procesos del lecho marino volcánico, una ruta internacional única, respaldo satelital limitado, logística internacional de reparación y una historia de restauración doméstica mucho más extensa.
El caso de Shetland en octubre de 2022 implicó dos direcciones nominalmente diversas dañadas en una semana. El registro muestra restauración óptica temporal, activación de fibra de reserva, microondas heredadas para voz y resultados distintos entre proveedores que podían o no usar capacidad alternativa.
Las preguntas de control son distintas.
Para Tonga:
- ¿Por qué solo había una ruta internacional de fibra?
- ¿Qué capacidad de respaldo existía?
- ¿Estaban listos repuestos y buques reparadores?
- ¿Cómo debería un país gestionar una reparación larga tras un evento natural extremo?
Para Shetland:
- ¿Eran realmente independientes dos rutas instaladas?
- ¿Qué servicios podían usar la capacidad restante o restaurada?
- ¿Sus proveedores tenían acceso alternativo suficiente?
- ¿Cómo funcionaron los controles ópticos, de fibra de reserva y de microondas?
- ¿Por qué los cortes residuales difirieron por proveedor?
La comparación es útil solo si afila esas fronteras.
Lo que el registro público no puede probar
Quedan varios hechos materiales importantes sin conocer.
El registro público no revela:
- la topología completa de fibra y equipos de SHEFA-2;
- los presupuestos ópticos exactos antes y después del daño;
- todas las configuraciones de ruta;
- volúmenes de tráfico por servicio;
- reservas de capacidad;
- todos los acuerdos mayoristas de cada proveedor;
- conteos exactos de clientes por proveedor;
- registros completos de failover;
- órdenes internas de incidente;
- registros de priorización de reparación;
- pérdidas financieras completas;
- todas las fallas de telecuidado;
- remediaciones probadas de forma independiente.
Tampoco establece que los incidentes norte y sur tuvieran una sola causa, que cualquiera fuera malicioso, o que toda institución nombrada incumplió un deber legal.
Esas lagunas importan porque limitan la asignación de responsabilidad.
También definen qué debería contener un registro público posterior más robusto:
- una topología acotada que muestre dominios de fallo sin exponer detalle sensible;
- una cronología de impacto por servicio;
- la capacidad alternativa disponible;
- resultados de failover por clase de servicio;
- evidencia de acceso de emergencia;
- acciones temporales de restauración;
- secuencia y restricciones de reparación;
- cohortes residuales de caída;
- confianza en la causa raíz;
- pruebas de remediación.
Un informe postincidente de alta calidad no necesita revelar detalle de red explotable. Necesita evidencia suficiente para que clientes, autoridades públicas y reguladores distingan daño físico inevitable de fallo de continuidad controlable.
Una prueba de rendición de cuentas de redundancia utilizable
El evento de Shetland apoya una prueba reutilizable para conectividad en islas y regiones remotas.
1. Mapear el servicio, no solo el activo
Identificar cada ruta desde el acceso del cliente a través de agregación local, transporte submarino, núcleo del proveedor, autenticación e interconexión externa. Marcar dependencias comunes en aterrizaje, alimentación, enrutamiento y gestión.
2. Probar independencia geográfica
Documentar separación física en zonas de daño probable, puntos de aterrizaje y segmentos terrestres. Una etiqueta norte y sur no prueba que todos los segmentos relevantes sean independientes.
3. Reservar capacidad utilizable
Definir cuánta capacidad alternativa está comprometida durante fallos. Incluir servicios críticos y modos operativos degradados.
4. Vincular a proveedores la alternativa
Mostrar que cada proveedor dependiente tiene capacidad técnica y comercial para usar la ruta. Una fibra sana que un servicio no puede alcanzar no es redundancia para ese servicio.
5. Probar conmutación extremo a extremo
Ejecutar ejercicios controlados que verifiquen enrutamiento, sesiones, DNS, autenticación, voz, llamadas de emergencia y aplicaciones de servicios públicos. Registrar el resultado y corregir brechas.
6. Definir continuidad mínima viable
Especificar qué funciones deben sobrevivir cuando no hay capacidad normal de banda ancha. Voz, coordinación de emergencia y telecuidado pueden requerir rutas de respaldo distintas.
7. Inventariar controles en reposo
Las fibras de reserva, enlaces microondas y terminales satelitales deben tener propietarios, procedimientos de activación, pruebas de compatibilidad y monitorización.
8. Preparar reparación física
Mantener capacidad de localización de fallo, repuestos, acuerdos de buques, acceso a aterrizajes y supuestos de clima y prioridades de reparación.
9. Medir restauración por servicio
Usar una matriz que separe restauración óptica, de ruta y de servicio al cliente. Mantener datos de cohortes residuales.
10. Publicar evidencia acotada
Explicar qué falló, qué funcionó, qué siguió sin confirmar y cómo se probó la remediación. No usar la palabra “resiliente” como sustituto de evidencia.
Conclusión
La interrupción de Shetland en 2022 se desencadenó por dos problemas físicos en un intervalo corto. Ese momento fue de mala suerte. La distribución y duración del daño a servicio se modeló por controles.
Ofcom registró una pérdida aproximada de 16 horas de servicio móvil y fijo, respaldo microondas heredado para gran parte de la voz PSTN, restauración temporal por aumento de potencia óptica y diez días de reparación en ambos enlaces de fibra. Los registros gubernamentales y atribuidos a operadores describen daño accidental por actividad pesquera, activación de fibra de reserva y soporte satelital preventivo. El Consejo documentó incidencias residuales por proveedor y problemas de telecuidado. Police Scotland aportó acceso de emergencia físico mientras las comunicaciones normales eran inciertas. [4][10][12][13][15]
En conjunto, esos hechos reemplazan la suposición simple.
Dos cables no equivalen a dos servicios utilizables.
La redundancia existe solo cuando el camino alterno tiene capacidad, los proveedores dependientes pueden alcanzarlo, la conmutación funciona, las funciones críticas sobreviven y la restauración puede verificarse. La línea de un diagrama de red es una afirmación de diseño. La evidencia es lo que la red hizo cuando una ruta ya estaba deteriorada y la otra se dañó.
Ese es el test duradero de Shetland: no si existía una segunda ruta instalada, sino quién pudo demostrar que era utilizable cuando la continuidad dependía de ella.
Fuentes
- https://news.sky.com/story/complete-outage-on-shetland-leaves-phones-internet-and-computers-unusable-12725347
- https://news.stv.tv/highlands-islands/internet-and-mobile-services-restored-in-shetland-after-power-outage-caused-by-damaged-subsea-cables
- https://news.stv.tv/highlands-islands/shetlands-damaged-subsea-cable-to-faroe-islands-now-repaired-confirms-operator
- https://www.gov.scot/binaries/content/documents/govscot/publications/foi-eir-release/2024/01-b/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/documents/202200331574---annex-a/202200331574---annex-a/govscot%3Adocument/202200331574%2B-%2BAnnex%2BA.pdf
- https://www.gov.scot/publications/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/
- https://www.ofcom.org.uk/internet-based-services/network-security
- https://www.ofcom.org.uk/internet-based-services/network-security/ofcom-begins-new-role-overseeing-security-of-telecoms-networks
- https://www.ofcom.org.uk/phones-and-broadband/accessibility/general-conditions-of-entitlement
- https://www.ofcom.org.uk/phones-and-broadband/coverage-and-speeds/connected-nations-2022
- https://www.ofcom.org.uk/siteassets/resources/documents/research-and-data/multi-sector/infrastructure-research/connected-nations-2022/connected-nations-uk-report.pdf?v=321647
- https://www.parliament.scot/chamber-and-committees/questions-and-answers?ref=S6W-12628
- https://www.scotland.police.uk/what-s-happening/news/2022/october/update-landline-and-mobile-phone-outage-shetland-resolved/
- https://www.shetland.gov.uk/news/article/2404/continuing-problems-affecting-connectivity-in-shetland-including-some-telecarecommunity-alarm-lines
- https://www.shetnews.co.uk/2022/10/21/cable-fault-the-third-reported-in-waters-around-shetland-since-mid-september/
- https://www.shetnews.co.uk/2022/10/24/perfect-storm-of-cable-failure-was-incredibly-bad-luck/
- https://www.shetnews.co.uk/2022/10/25/subsea-cable-fault-took-place-a-few-kilometres-off-shetland-telecoms-chief-says/
- https://www.shetnews.co.uk/2022/10/26/more-digital-disruptions-as-cable-repairs-get-under-way/
- https://www.shetnews.co.uk/2022/10/31/shetland-fully-connected-once-again/
- https://www.theguardian.com/uk-news/2022/oct/20/shetland-loses-telephone-internet-services-subsea-cable-damaged
- https://www.theguardian.com/uk-news/2022/oct/21/telephone-and-internet-restored-in-shetland-after-cable-damage
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance