
Resumen
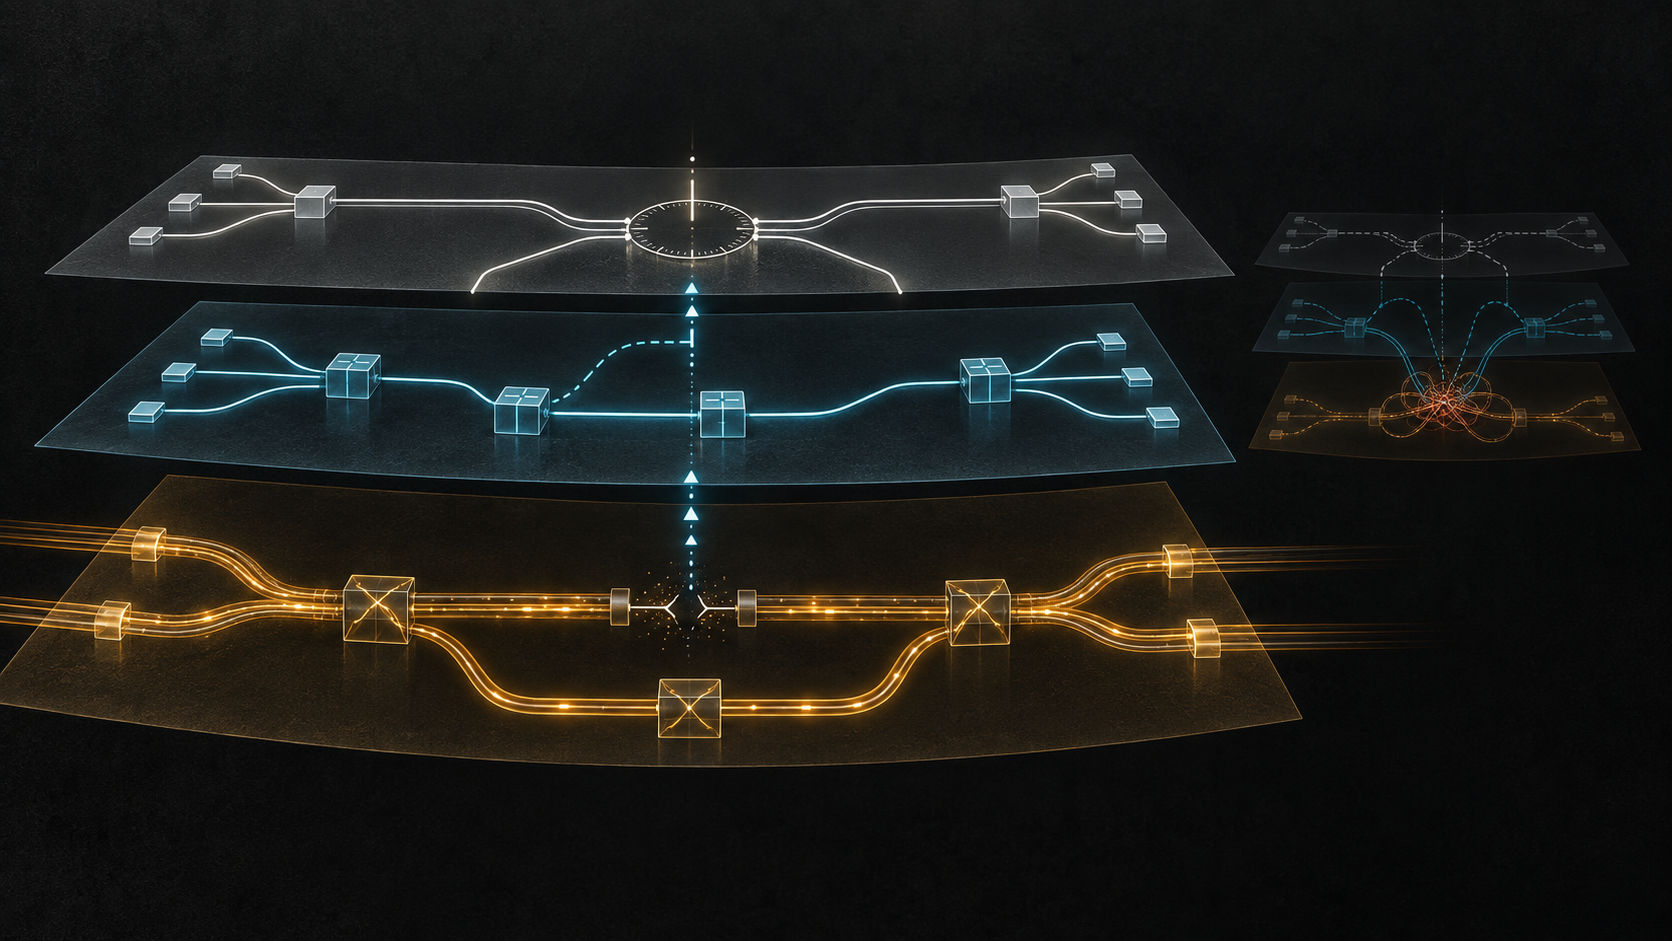
- RFC 3386 convirtió la coordinación de la recuperación en una decisión explícita: si SDH/SONET debía proteger primero, MPLS tenía que concederle una ventana limitada antes de rerutar.
- El vencimiento del temporizador no era un recibo de éxito. Hacían falta estado de configuración, señal de fallo, resultado por capa y una comprobación en el servicio final.
En una red multicapa, una sola avería produce varias verdades parciales. La fibra pierde luz. El transporte pierde continuidad. MPLS deja de recibir paquetes por un LSP. IP observa que una ruta ya no entrega. Todos esos hechos pueden ser correctos y, aun así, cada controlador puede tomar una decisión que perjudique al conjunto.
RFC 3386 apareció en noviembre de 2002 como documento Informational. Recogía el trabajo de un equipo del grupo de ingeniería de tráfico de la IETF sobre necesidades inmediatas de operadores. No especificaba un protocolo completo ni documentaba una implantación. Buscaba un conjunto pequeño de métodos interoperables de supervivencia para redes de paquetes y de transporte.
El texto separó la jerarquía vertical entre tecnologías de la jerarquía horizontal entre áreas de una misma tecnología. La vertical escondía una tensión: varias capas podían ofrecer protección o restauración, pero por diseño no solían ver los mecanismos internos de las demás.
Si la capa óptica o SDH/SONET conmutaba al mismo tiempo que MPLS calculaba un desvío, el tráfico podía moverse dos veces. Dos controladores podían reservar recursos de emergencia para el mismo fallo. El cálculo superior podía completarse sobre una topología que acababa de cambiar debajo. La velocidad local no garantizaba una recuperación global más rápida.
La propuesta práctica fue introducir tiempos anidados. La capa superior esperaba mientras la inferior, más lenta pero preparada para proteger, recibía la primera oportunidad. El ejemplo del RFC pedía que la recuperación MPLS dejara terminar la conmutación SDH/SONET.
Ese «esperar» era una cesión temporal de autoridad. Un valor muy corto abría la carrera entre capas. Uno demasiado largo mantenía caído un servicio que la capa superior podía haber recuperado. Configurar el temporizador suponía afirmar tres cosas: que la capa inferior tenía protección, que cubría ese recurso concreto y que debía terminar dentro de una ventana conocida.
Cuando la infraestructura inferior no estaba protegida, el mismo comportamiento resultaba incorrecto. RFC 3386 pedía ajustar el tiempo o permitir una indicación inmediata del fallo hacia arriba. La capa superior debía actuar sin aguardar una recuperación que no existía. Por el contrario, un fallo superior no debía ordenar automáticamente una protección inferior: perder una ruta IP no demostraba una rotura física.
El documento propuso intervalos: 100–500 ms para protección 1:1 con capacidad preestablecida, 100–750 ms con capacidad planificada, 50 ms para restauración local y uno a cinco segundos para restauración desde el origen. Excluían la propagación. Sus autores también dejaron constancia de que no avalaban científicamente que esas cifras satisficieran una aplicación particular.
Por eso no son medidas de campo ni promesas de servicio. Entre la aparición del defecto y la experiencia del usuario hay detección, espera, conmutación, señalización, convergencia, propagación y procesamiento de la aplicación. Una operación interna de 50 ms no certifica que una llamada o transacción haya sobrevivido.
La distinción entre protección y restauración afectaba a la capacidad. La protección prepara recursos antes del fallo. La restauración elige un nuevo camino después. La capacidad preestablecida ya estaba comprometida; la planificada podía compartirse. Compartir abarata la reserva, pero obliga a decidir quién se recupera primero y qué tráfico puede ser expulsado cuando varios servicios reclaman el mismo recurso.
Los grupos de riesgo compartido evitaban otra ilusión. Dos enlaces lógicamente distintos podían pasar por el mismo conducto, cable, derecho de vía, anillo óptico u oficina. Sin ese inventario físico, la capa superior podía escoger un «camino alternativo» que desaparecía con la misma excavadora.
La reparación local cerca del defecto podía ser rápida pero dejar un recorrido ineficiente que luego debía reorganizarse. El reruteo desde el origen podía usar mejor la red, aunque tardara más. Recuperar paquetes y alcanzar un estado operativo estable eran hitos distintos.
En los límites entre áreas, el documento exigía comunicar éxito o fracaso. No bastaba con solicitar una recuperación. La otra zona necesitaba saber si se había intentado y si había funcionado; de lo contrario podía repetir acciones o conservar la mitad sana de una conexión cuya otra mitad seguía caída.
RFC 4427 fijó después un vocabulario común; RFC 4428 profundizó en la recuperación multicapa; RFC 7347 mantuvo un tiempo de espera configurable para MPLS-TP; RFC 7926 explicó cómo la abstracción cliente-servidor puede ocultar riesgos compartidos. Esos documentos muestran continuidad del problema, no resultados universales de implantación.
La idea de especificación inicial mínima de Lu Heng ayuda a leer la decisión. Era necesario acordar quién actuaba primero, cómo se anunciaba el fallo y cuándo vencía la espera; no era necesario fusionar todos los planos de control. Su marco de capas de realidad añade el límite probatorio: configuración, alarma, orden, conmutación, ruta, entrega y experiencia son registros distintos.
La enseñanza de RFC 3386 no es que la capa inferior siempre tenga prioridad. Es que la prioridad debe corresponder a una capacidad real, estar limitada por tiempo y terminar con un resultado observable. Un temporizador bien elegido puede evitar una carrera. Nunca puede declarar por sí solo que Internet volvió a funcionar para quien lo estaba usando.
Fuentes
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance