
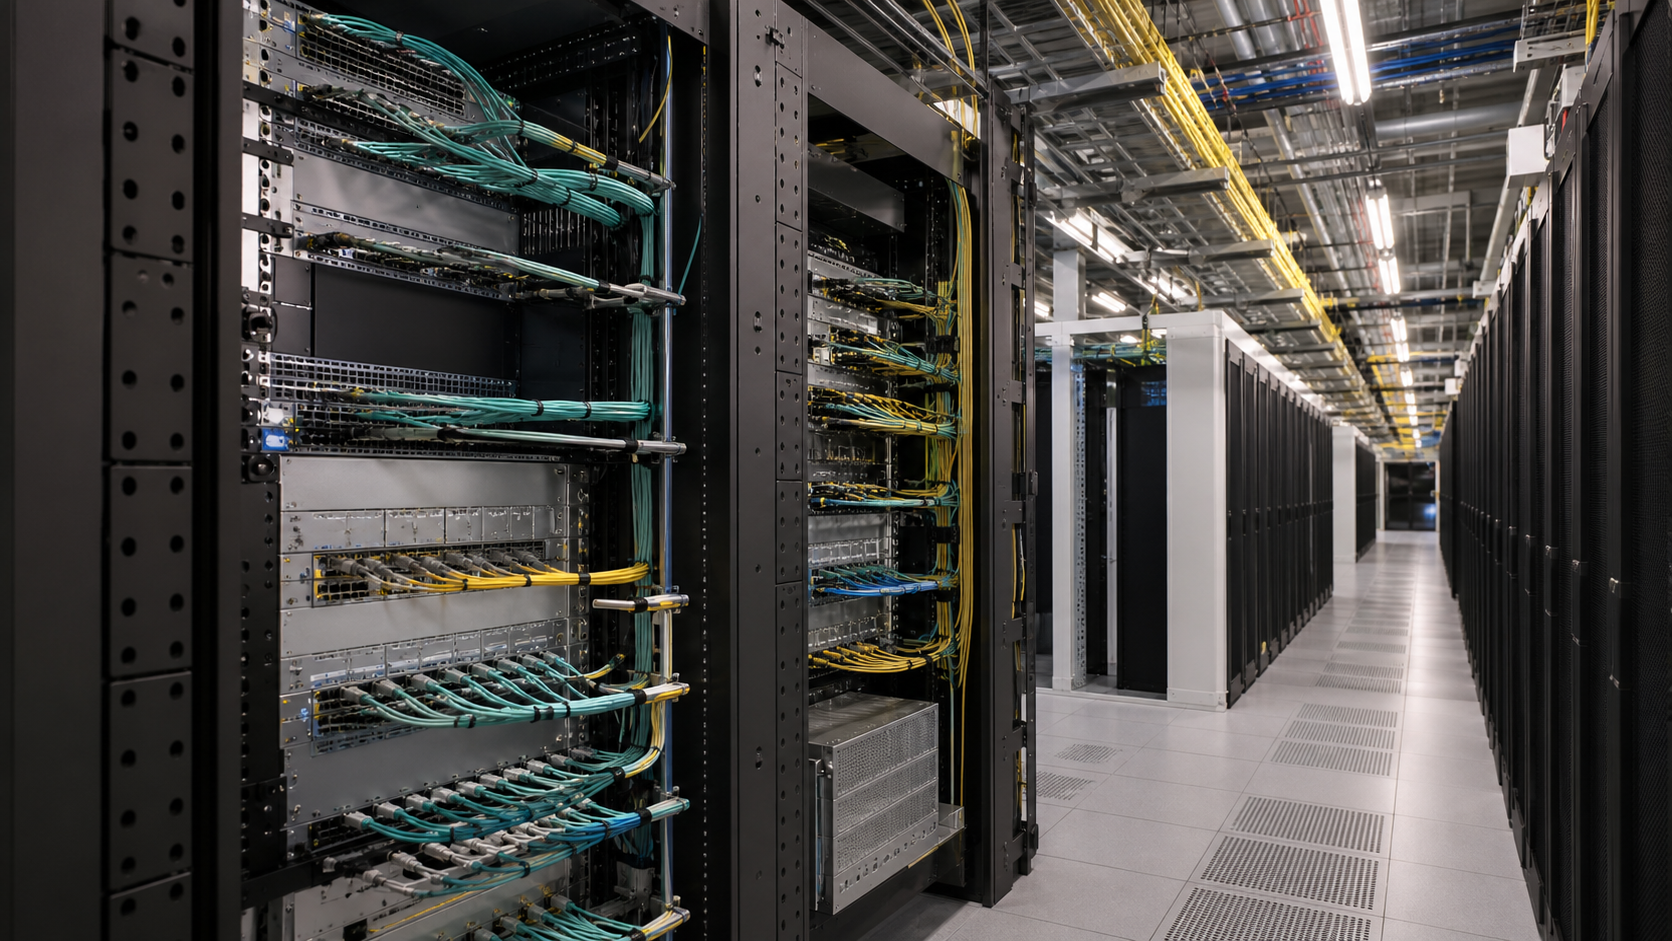
Resumen
- OVHcloud ha descrito públicamente un ataque de Mirai en septiembre de 2016 con un pico superior a un terabit por segundo. Se trata de una medición atribuida al operador, no de una auditoría independiente paquete por paquete ni de un recuento exacto de objetivos, dispositivos participantes o clientes afectados. [1][2]
- La investigación independiente presentada en USENIX Security reconstruyó el crecimiento y la actividad ofensiva de Mirai desde varios puntos de observación. Sitúa el comienzo de los ataques contra infraestructura de OVH el 18 de septiembre de 2016, dentro de una botnet que llegó a reunir aproximadamente 600.000 dispositivos infectados. [3][4]
- El episodio de OVH debe mantenerse separado de los ataques contra KrebsOnSecurity y Dyn. Que compartieran malware o contexto histórico no convierte objetivos, fechas, rutas de tráfico, efectos sobre el servicio y decisiones de mitigación diferentes en un único incidente.
- Mirai podía generar inundaciones directamente desde dispositivos comprometidos que utilizaban direcciones de origen normalmente encaminables. Ese mecanismo no equivale a la reflexión y amplificación basada en direcciones falsificadas. BCP 38, BCP 84 y otros controles contra la suplantación siguen siendo importantes, pero no habrían detenido por sí solos el tráfico directo de Mirai. [15][16][19][20]
- La capacidad DDoS útil de un proveedor de alojamiento no puede resumirse en una cifra de ancho de banda. También depende de la tasa de paquetes, la capacidad de reenvío de los routers, la estabilidad del plano de control, el rendimiento del sistema de limpieza, la capacidad del trayecto de retorno y la entrega comprobable de tráfico legítimo.
- La responsabilidad está distribuida. Los fabricantes determinan las credenciales, los servicios expuestos y el soporte de actualizaciones; los propietarios y las redes de acceso pueden observar conductas salientes anómalas; los operadores de tránsito y alojamiento controlan capacidad, filtrado, telemetría y recuperación; y las autoridades investigan a quienes operan la botnet. [5][9]–[12]
- Las fuentes públicas no revelan la topología completa de limpieza de OVH, sus umbrales de activación, el número exacto de clientes afectados, las obligaciones contractuales ni la distribución de pérdidas. Esas incógnitas no deben rellenarse con inferencias.
- La prueba decisiva es operativa: si el sistema de mitigación absorbió la combinación real de paquetes, mantuvo un trayecto viable para las solicitudes legítimas, limitó los daños colaterales y generó registros que clientes y operadores pudieran contrastar.
Más de un terabit fue una advertencia, no una auditoría de capacidad
En septiembre de 2016, OVHcloud comunicó que había observado un ataque superior a un terabit por segundo durante la primera gran oleada asociada a Mirai. Su explicación pública sobre DDoS sitúa el episodio entre los ataques de gran escala de aquel periodo, mientras que un artículo técnico posterior de la compañía describe Mirai como la primera botnet capaz de superar 1 Tbps. [1][2] La cifra marcó un cambio de escala: equipos de consumo comprometidos podían concentrar sobre una infraestructura de alojamiento un volumen que hasta entonces parecía reservado a atacantes con recursos mucho más especializados.
La formulación rigurosa termina, sin embargo, en lo que las fuentes permiten afirmar: OVH informó de un pico superior a un terabit por segundo. El registro público no precisa en qué punto exacto se efectuó toda la medición, cuánto duró el máximo, qué distribución de tamaños de paquete predominó, cuántos destinos participaron ni qué fracción del tráfico alcanzó las cargas de los clientes. Tampoco permite determinar si la cifra corresponde a una interfaz, a la agregación de varios emplazamientos o a una observación realizada antes o después de una fase concreta de filtrado.
Esas distinciones no son tecnicismos menores. Un ataque puede saturar un enlace físico sin agotar la capacidad de reenvío del router; puede dejar ancho de banda disponible y, aun así, superar el número de paquetes por segundo que una tarjeta o una plataforma de filtrado puede procesar. También puede consumir tablas de estado, colas, memoria, recursos del plano de control o capacidad de una aplicación después de atravesar correctamente todos los elementos de red. La cifra en bits por segundo identifica solo una dimensión del problema.
Dos inundaciones con idéntica tasa de bits pueden imponer cargas muy distintas. Los paquetes pequeños obligan a realizar más decisiones de análisis, clasificación y reenvío por unidad de tiempo. Los paquetes grandes ejercen una presión diferente sobre enlaces y tejidos internos. La combinación de protocolos, destinos y reglas activas modifica de nuevo el límite efectivo. Por eso la capacidad anunciada por un proveedor debe vincularse a condiciones concretas de prueba y observación, no presentarse como una reserva universal.
El análisis posterior de OVHcloud sobre ataques de alta tasa de paquetes resulta útil para entender ese plano de control. [2] No demuestra qué equipo, enlace o umbral condicionó la respuesta privada de 2016. Sí refuerza una conclusión general: una evaluación seria necesita conservar simultáneamente telemetría de bits, paquetes, descartes, colas, CPU o recursos equivalentes, estabilidad de rutas y éxito de servicios. Proyectar una explicación técnica posterior sobre una topología histórica no publicada convertiría una orientación válida en una afirmación que las fuentes no sostienen.
Una declaración de capacidad responsable debería contestar, como mínimo, dónde se observó el tráfico, qué recurso se estaba midiendo, durante cuánto tiempo se mantuvo el pico y qué estado de mitigación estaba activo. También debería explicar cuál fue el siguiente cuello de botella, cuánta capacidad quedó para tráfico legítimo y mediante qué pruebas se comprobó la recuperación. Sin esas respuestas, una cifra puede ser verdadera y relevante, pero sigue siendo insuficiente para valorar la continuidad.
El número tampoco permite concluir que OVH estuviera plenamente preparado, fuera negligente o hubiera incumplido una obligación concreta. Esos juicios requerirían datos sobre arquitectura, pruebas previas, decisiones operativas, contratos, afectación y recuperación que no forman parte del expediente público. La utilidad de la cifra es otra: obligó a revisar las hipótesis con las que operadores, clientes y órganos de gobierno calculaban el riesgo de una botnet formada por dispositivos cotidianos.
La rendición de cuentas empieza cuando el dato espectacular se convierte en una descripción verificable del sistema. No basta con saber cuánto tráfico llegó a algún punto. Hay que conocer qué componente continuó funcionando, qué control se activó, qué tráfico legítimo se perdió y cómo se estableció que el servicio había vuelto a una condición estable.
La investigación independiente demuestra la botnet, no el impacto privado de OVH
La reconstrucción técnica independiente más sólida procede del estudio presentado en USENIX Security sobre Mirai. Sus autores combinaron distintas fuentes y posiciones de observación para examinar la exploración de Internet, las infecciones, la infraestructura de mando y control y la actividad ofensiva. El trabajo sitúa el comienzo de los ataques contra infraestructura de OVH el 18 de septiembre de 2016, describe una población máxima aproximada de 600.000 infecciones y analiza más de 15.000 ataques durante el periodo estudiado. [3][4]
Esta investigación aporta algo que no puede obtenerse de una única gráfica del operador atacado: una cronología más amplia de cómo creció y actuó la botnet. Permite relacionar la inseguridad de numerosos dispositivos conectados con la aparición de una fuente de tráfico distribuida a escala mundial. También ayuda a separar la mecánica observada de relatos posteriores que tratan todos los grandes ataques DDoS como si utilizaran el mismo vector.
El estudio no es, en cambio, una revelación de la red privada de OVH. No ofrece el inventario completo de interfaces y routers, los umbrales de activación de mitigación, las reglas de filtrado, los contratos de clientes ni un registro individualizado de interrupciones. Tampoco demuestra que todos los dispositivos infectados participaran en cada ataque o que cada flujo observado contra OVH tuviera exactamente la misma composición.
La diferencia entre reconstruir una botnet y auditar la continuidad de su víctima es fundamental. Los investigadores podían observar partes importantes del ecosistema de Mirai. OVH poseía la información interna sobre rutas, capacidad, estado de sus plataformas, cambios de configuración y señales de clientes. Las redes de origen conservaban otra parte: asignaciones de direcciones, abonados, equipos y actuaciones sobre el tráfico saliente. Ningún actor disponía por sí solo de toda la cadena probatoria.
Por la misma razón, no deben fusionarse los episodios contra KrebsOnSecurity, OVH y Dyn. Mirai intervino en distintos ataques, pero los objetivos, las fechas, las dependencias técnicas y los efectos sobre el servicio no fueron idénticos. El caso de Dyn afectó a la continuidad de un proveedor de DNS autoritativo; el de OVH plantea una cuestión de alojamiento, absorción de tráfico y capacidad de mitigación. Mezclarlos produciría una narración más dramática, pero técnicamente menos precisa.
Los informes de Akamai sobre el tercer trimestre de 2016 aportan contexto contemporáneo sobre la evolución general de las amenazas DDoS. [7][8] No deben emplearse como sustituto de la telemetría privada de OVH ni como prueba de la composición exacta de este ataque. Su función es mostrar el entorno operativo del periodo, no resolver las incógnitas específicas del incidente.
El Departamento de Justicia de Estados Unidos anunció posteriormente declaraciones de culpabilidad relacionadas con los creadores de Mirai. [5] Esa fuente permite atribuir responsabilidad penal en los términos acotados del procedimiento comunicado. No permite identificar automáticamente a la persona que ordenó cada ataque observado por OVH, asignar intención a cada paquete ni extender una conclusión jurídica a fabricantes, propietarios o redes de acceso.
Una evaluación responsable combina niveles de evidencia sin confundirlos. Las fuentes del operador respaldan afirmaciones atribuidas sobre medición y experiencia operativa. La investigación académica respalda la cronología y la mecánica de la botnet. Los documentos judiciales sostienen hechos jurídicos limitados. Las normas y guías posteriores ayudan a evaluar controles. Ninguna de esas categorías debe utilizarse para inventar la información que solo podría proporcionar otra.
El tráfico directo y la reflexión exigen controles diferentes
En un ataque de reflexión y amplificación, el agresor envía una solicitud a un tercero utilizando como origen falsificado la dirección de la víctima. El servicio reflector responde a esa dirección y, cuando la respuesta es mayor que la solicitud, amplifica el volumen dirigido al objetivo. En ese modelo, la validación de direcciones de origen puede impedir que la petición falsificada abandone la red que la genera, mientras que la corrección o restricción del servicio reflector elimina la capacidad de amplificación.
Mirai no necesitaba ese mecanismo para su capacidad ofensiva principal. Cámaras, grabadores y otros equipos comprometidos podían emitir tráfico directamente hacia el objetivo con direcciones normalmente encaminables. La distribución procedía del número de dispositivos bajo control de la botnet, no de que cada paquete tuviera que rebotar en un servidor reflector. La investigación de USENIX describe esa arquitectura y la actividad ofensiva asociada. [3][4]
La consecuencia práctica es que BCP 38 resulta pertinente, pero insuficiente. RFC 2827 describe el filtrado de ingreso destinado a restringir paquetes con direcciones de origen falsificadas. RFC 3704 amplía el tratamiento para redes multihomed, donde la asimetría legítima de rutas exige evitar comprobaciones simplistas que también descartarían tráfico válido. [15][16] RFC 7039 y la guía de MANRS añaden mecanismos y prácticas para mejorar la validación del origen. [19][20]
Esos controles reducen ataques que dependen de suplantación, mejoran la calidad de la atribución técnica y limitan determinadas formas de abuso. No impiden que un dispositivo comprometido transmita una inundación desde la dirección que realmente tiene asignada. Tampoco corrigen credenciales débiles, cierran servicios de administración expuestos, aumentan la capacidad de reenvío del objetivo ni garantizan que una regla de filtrado conserve los paquetes legítimos.
Diagnosticar mal el mecanismo conduce a invertir en el control equivocado. Frente a una inundación directa, el operador necesita examinar la distribución de fuentes, el comportamiento temporal, los protocolos, la concentración de destinos y la relación entre tráfico y servicio. También necesita coordinarse con redes de origen y aplicar límites suficientemente precisos para no desconectar a usuarios legítimos que comparten proveedor, región o infraestructura de acceso.
Frente a una inundación reflejada, además de lo anterior, adquieren un peso particular la eliminación de reflectores abiertos, las firmas de los protocolos abusados y la validación de direcciones cerca del origen. Un ataque combinado puede exigir ambos conjuntos de medidas. La clasificación debe basarse en paquetes y flujos observables, no en la fama del malware ni en la suposición de que todo DDoS de gran escala tiene la misma arquitectura.
La guía del NIST sobre intercambio interdominio resiliente presenta la mitigación DDoS como una disciplina por capas que puede incluir seguridad de encaminamiento, validación de origen, filtrado, blackholing remoto, FlowSpec, limitación de tasa, detección y coordinación. [13][14] RFC 4732 advierte asimismo que las defensas frente a denegación de servicio pueden producir daños colaterales. [17] Estas fuentes describen categorías de control; no demuestran que OVH utilizara todas ellas en septiembre de 2016.
La precisión sobre el vector también delimita la responsabilidad. Una red que permite salir tráfico falsificado controla un problema distinto del que afronta una red cuyos abonados emiten tráfico directo desde dispositivos comprometidos. El operador víctima controla, a su vez, la capacidad y la clasificación en su extremo. Asignar a todos la misma solución oscurece qué podía observar y modificar cada participante.
Por tanto, la validación de origen debe conservarse dentro del análisis, pero sin presentarla como el interruptor ausente que habría detenido Mirai. La primera obligación de un informe técnico es describir correctamente el tráfico. Solo entonces puede pedir a cada actor la evidencia correspondiente a su control real.
La continuidad del alojamiento es una propiedad de todo el trayecto
La responsabilidad central de OVH se encontraba en la red que operaba para sus clientes. Ante una inundación distribuida, un proveedor de alojamiento debe detectar el cambio antes de que se convierta en un fallo total, decidir cuándo activar la mitigación, desviar o filtrar tráfico sin desestabilizar el encaminamiento y conservar una vía suficiente para los paquetes legítimos. Esa secuencia atraviesa el borde, el núcleo, las plataformas de limpieza, los enlaces entre emplazamientos, las redes de clientes y la dirección del incidente.
La detección no puede descansar en una única métrica. Los contadores de interfaz muestran bits y paquetes; los registros de flujo aportan protocolos, puertos, fuentes y destinos; los routers informan de descartes, colas y presión sobre el plano de control; la plataforma de mitigación registra clasificaciones y acciones; las sondas externas revelan si el usuario puede completar una transacción; y las observaciones BGP ayudan a confirmar qué trayecto estaba anunciado.
Cada fuente tiene límites. Un aumento de tráfico puede ser un ataque, un evento legítimo o un error de medición. Una distribución amplia de direcciones puede corresponder a una botnet o a una audiencia mundial. Una plataforma puede registrar millones de paquetes bloqueados y, al mismo tiempo, dejar a los clientes inaccesibles porque el enlace de tráfico limpio está congestionado. Un promedio global puede esconder pérdidas regionales.
Por eso la rendición de cuentas exige correlación. Los relojes deben estar suficientemente sincronizados para comparar la secuencia. La activación de una regla debe poder relacionarse con cambios de volumen, rutas, descartes y éxito de aplicaciones. Si la plataforma declara una recuperación mientras las sondas de cliente siguen fallando, la discrepancia no debe desaparecer dentro de una media: señala un límite de observación o un cuello de botella pendiente.
La decisión de activar la mitigación también introduce riesgo. Un modelo bajo demanda puede evitar que todo el tráfico atraviese permanentemente una infraestructura adicional, pero crea un intervalo de transición. Un modelo siempre activo elimina esa transición concreta, aunque conserva dependencias, posibles errores de clasificación y límites de capacidad. La elección responsable depende de la arquitectura, el historial de amenazas, la mezcla de servicios y las pruebas realizadas.
Una vez activado el sistema, la clasificación debe eliminar el tráfico hostil sin convertir el filtro en una segunda causa de interrupción. Una firma demasiado estrecha deja pasar la inundación; una regla demasiado amplia descarta usuarios válidos. Limitar por dirección puede perjudicar a personas que comparten traducción de direcciones. Bloquear una región o un ASN puede contener fuentes abusivas, pero también excluir clientes inocentes alojados en la misma red.
Después del filtrado, el tráfico limpio necesita un trayecto de entrega viable. Limpiar paquetes en un punto remoto no sirve si el enlace de retorno hacia el alojamiento es insuficiente, está mal encaminado o comparte el mismo fallo que la ruta atacada. Filtrar dentro de la red tampoco sirve si el enlace de acceso ya se encuentra saturado. La capacidad efectiva es la menor de las capacidades necesarias a lo largo de la cadena, no la suma promocional de todos los equipos.
La continuidad debe observarse desde fuera del dominio administrativo. Que un prefijo sea visible no significa que la aplicación responda. Que una conexión TCP se abra no demuestra que una compra, consulta o operación de cliente termine. Las sondas deben cubrir varios proveedores y regiones, y deben compararse con la salud del origen y con las métricas internas.
Las fuentes públicas no describen toda la topología que OVH utilizó en 2016. Por ello, el análisis no puede afirmar qué trayecto privado funcionó o falló. Sí puede establecer el estándar probatorio: la ruta que permaneció activa debía transportar trabajo legítimo, y el operador debía conservar evidencia suficiente para distinguir continuidad real de una mera caída en el volumen de ataque.
La tasa de bits y la tasa de paquetes revelan cuellos de botella distintos
Los titulares suelen expresar la escala de un DDoS en bits por segundo porque el ancho de banda es fácil de comparar con la capacidad nominal de un enlace. Sin embargo, cada paquete exige operaciones: recepción, análisis, búsqueda de ruta, aplicación de políticas, actualización de contadores, colocación en cola y reenvío o descarte. Cuando los paquetes son pequeños, la cantidad de decisiones por segundo puede convertirse en el límite antes de que se agote el ancho de banda anunciado.
Un router no posee una única cifra de capacidad. Las interfaces, los ASIC de reenvío, el tejido interno, los búferes, el procesador de rutas, las tablas de filtros y los sistemas de telemetría pueden alcanzar límites diferentes. Una regla económica para un protocolo puede ser costosa para otro. La exportación de datos detallados también consume recursos precisamente cuando más se necesita observar el sistema.
La capacidad de una plataforma de limpieza tampoco equivale necesariamente a la del enlace que la alimenta o a la del trayecto que devuelve el tráfico filtrado. Puede existir margen para ingerir un gran volumen y, aun así, faltar capacidad para clasificar la combinación concreta de paquetes. También puede sobrar capacidad de filtrado y fallar un router anterior, un túnel, un enlace interregional o el plano de control que instala las reglas.
La explicación técnica posterior de OVHcloud sobre ataques de alta tasa de paquetes ayuda a situar este problema. [2] No identifica el componente limitante del incidente de 2016. Su valor consiste en recordar que las pruebas deben construir una matriz: tamaños de paquete, protocolos, número de destinos, distribución de fuentes, cantidad de reglas, nivel de registro, cambios de ruta y proporción de tráfico legítimo.
Las pruebas deben incluir la transición, no solo un estado estable ideal. Un sistema puede procesar correctamente una inundación una vez activadas todas las reglas y fallar durante la instalación de filtros, la propagación de rutas o el aumento repentino de telemetría. También debe ensayarse la pérdida de un centro de limpieza, de un proveedor de tránsito o de una parte de la capacidad, porque una reserva que depende del mismo componente no constituye una reserva independiente.
El tráfico legítimo debe mezclarse con el ataque durante los ejercicios. Una prueba compuesta solo por paquetes hostiles demuestra capacidad de descarte, pero no sensibilidad a falsos positivos ni continuidad de servicio. El criterio de aprobación debe incluir transacciones válidas, latencia, pérdida, distribución regional y comportamiento de protocolos que no se parezcan al tráfico web convencional.
Cada cifra de prueba necesita contexto: distribución de paquetes, reglas activas, prefijos protegidos, configuración de registro, fecha y margen disponible. Si la capacidad se comparte entre varias regiones o clientes, debe explicarse cómo se evita que un incidente consuma la reserva de los demás. Si el dato procede de un laboratorio o proveedor, debe distinguirse de la observación en producción.
Los clientes y responsables de gobierno no necesitan conocer cada regla confidencial para comprender el riesgo. Necesitan saber qué recursos se probaron, con qué combinación de tráfico, qué fallos independientes se contemplaron y qué evidencia de servicio se conservó. Ninguna cifra aislada en terabits responde por sí sola a esas preguntas.
La limpieza se demuestra entregando tráfico legítimo
La mitigación DDoS tiene dos resultados inseparables: rechazar tráfico hostil y entregar tráfico válido. El primero produce cifras atractivas —volumen absorbido, paquetes descartados, fuentes bloqueadas—, pero los clientes experimentan el segundo. Si la plataforma elimina la inundación y las solicitudes legítimas no llegan a su destino, la mitigación no ha preservado el servicio.
La clasificación puede apoyarse en validez de protocolo, tasa, comportamiento de fuentes, reputación, forma de los paquetes, contexto del destino y conocimiento de la aplicación. Todas esas técnicas presentan falsos positivos y falsos negativos. Un bloqueo general de UDP puede reducir un vector y romper DNS, voz, juegos o monitorización. Un límite por origen puede castigar a muchos usuarios detrás de una misma dirección. Un desafío apto para navegadores puede dejar fuera a una API.
El conjunto de reglas aceptable depende de cada servicio. Un proveedor de alojamiento con numerosos clientes no conoce por anticipado todas las combinaciones legítimas. Necesita políticas por cliente, mecanismos de excepción y canales de escalado que no pongan en riesgo el núcleo de red. A cambio, los clientes deben mantener actualizados sus protocolos esperados, dependencias, contactos de emergencia y criterios mínimos de funcionamiento.
La recuperación debe validarse con sondas técnicas y con operaciones útiles. La visibilidad de una ruta no basta. Una respuesta ICMP o la apertura de una conexión tampoco prueban la aplicación completa. Conviene medir desde varias redes y regiones, comprobar transacciones representativas y relacionar los resultados con la telemetría del origen, el router y la plataforma de limpieza.
Los efectos colaterales deben conservarse en el registro final. ¿Qué protocolos o redes fueron limitados? ¿Qué clientes necesitaron excepciones? ¿Una regla protegió un destino a costa de desplazar la carga hacia otro? ¿Durante cuánto tiempo continuó degradado el tráfico limpio después de caer el volumen agregado? Esas preguntas permiten mejorar controles futuros y ofrecer a los afectados una explicación defendible.
No es necesario publicar firmas detalladas o umbrales que faciliten la evasión. Un informe público acotado puede describir el periodo, la escala atribuida, el vector principal, la clase de mitigación, la señal utilizada para declarar la recuperación y las incógnitas pendientes. Clientes, auditores o reguladores pueden revisar bajo confidencialidad los datos más sensibles.
El expediente público de OVH confirma la magnitud comunicada y la relevancia de la mitigación, pero no ofrece un balance cliente por cliente de la entrega de tráfico limpio. Esa ausencia debe permanecer como una incógnita. No demuestra que todos los clientes continuaran accesibles ni que todos sufrieran una interrupción.
La afirmación de éxito más sólida no es «se descartó todo el tráfico malo», sino «las transacciones legítimas siguieron completándose dentro de límites medidos mientras el tráfico hostil quedó contenido». Esa formulación obliga a conectar seguridad, capacidad y experiencia de servicio.
La responsabilidad empieza antes de que el tráfico alcance a la víctima
Mirai convirtió dispositivos comprometidos en infraestructura operativa para un atacante. La cadena de responsabilidad comienza, por tanto, antes de que los paquetes lleguen a OVH, aunque no puede reducirse a un único actor.
Los fabricantes de dispositivos y proveedores de software controlan las credenciales iniciales, los servicios de administración expuestos, el proceso de actualización y la duración del soporte. Credenciales únicas, interfaces restringidas y actualizaciones autenticadas pueden reducir el riesgo de incorporación a una botnet. ENISA advirtió que objetos cotidianos conectados podían convertirse en componentes de ataques. [9]
Los propietarios controlan la instalación y el mantenimiento dentro de los límites del producto. Pueden cambiar credenciales, restringir exposición, instalar actualizaciones o aislar equipos sin soporte. Algunos carecen de conocimientos, acceso administrativo o una ruta de actualización fiable. Esa limitación importa al diseñar incentivos y remedios, pero no elimina el riesgo generado por un dispositivo comprometido.
Las redes de acceso pueden observar exploración saliente, conexiones inusuales, gran dispersión de destinos o tráfico sostenido incompatible con el uso normal de un dispositivo. También pueden mantener contactos de abuso funcionales, notificar al abonado y aplicar medidas proporcionadas. Sin embargo, una dirección observada en el ataque no demuestra por sí sola que la red conociera la infección, que el abonado fuera el atacante o que no se adoptara ninguna medida.
Los proveedores de tránsito y mitigación pueden aportar capacidad, filtrado coordinado, blackholing o distribución de rutas. Su posición puede permitir contener tráfico antes de que sature el acceso de la víctima. Esas acciones también requieren límites: una ruta de descarte mal autorizada puede retirar el servicio que pretendía proteger, y una regla demasiado amplia puede trasladar el daño a usuarios no implicados.
OVH controlaba su borde de alojamiento, la capacidad interna, la activación de la mitigación, la coordinación con proveedores, la comunicación con clientes y la evidencia de recuperación. Por eso constituye el operador central del caso. No controlaba el firmware de los dispositivos ni todas las redes de origen. La responsabilidad debe seguir el control efectivo, no la visibilidad de la marca.
Las autoridades, por su parte, podían investigar e imputar a los operadores de la botnet, pero no realizar el filtrado en tiempo real del tráfico que alcanzaba a OVH. El anuncio del Departamento de Justicia documenta responsabilidad penal en casos relacionados con Mirai. [5] No sustituye las obligaciones técnicas de prevención y continuidad de fabricantes y operadores.
El informe conjunto de los departamentos estadounidenses de Comercio y Seguridad Nacional pidió posteriormente una respuesta coordinada frente a botnets y sistemas automatizados distribuidos. [10][11] El proyecto del NIST sobre mitigación de DDoS basados en IoT también relaciona la seguridad del dispositivo con la resiliencia de red. [12] Estas fuentes describen el carácter sistémico del problema; no prueban la conducta de una empresa concreta durante el ataque a OVH.
El informe del NSTAC sobre resiliencia de Internet y comunicaciones refuerza la necesidad de observar dependencias y coordinación entre operadores. [6] De nuevo, su publicación posterior sirve como guía de control, no como evidencia de una medida específica desplegada por OVH en 2016.
Una distribución justa de responsabilidades pregunta qué podía observar cada actor, qué podía cambiar, qué registros conservó y cómo afectó su actuación al siguiente participante. No exige que un proveedor de alojamiento corrija el firmware de una cámara ni que una red de acceso absorba el tráfico en el destino. Exige que cada uno demuestre el funcionamiento de los controles que sí administraba.
La evidencia de la red de origen debe ser útil y proporcionada
El tráfico directo plantea una dificultad de atribución. Una dirección de origen real puede corresponder a un dispositivo, una conexión de abonado, una pasarela de traducción de direcciones o el borde de una empresa. Identifica un punto técnico desde el que se observó tráfico, pero no necesariamente a la persona que controló la botnet ni la intención del propietario de la conexión.
Un aviso de abuso útil debería incluir marca temporal y zona horaria, origen y destino, protocolo, puertos, recuentos de paquetes y bytes, método de muestreo, nivel de confianza, acción de mitigación y evaluación sobre posible suplantación. Cuando sea legal y proporcionado, una muestra breve o una firma puede permitir a la red receptora distinguir la actividad hostil del uso legítimo.
Los registros de ASN y de recursos IP ayudan a identificar qué organización administra un bloque y qué contactos ha publicado. El origen de una ruta muestra qué sistema autónomo anunció alcanzabilidad en un momento determinado. Ninguno de esos registros demuestra quién manejaba el dispositivo, quién ordenó el ataque o si el operador que anunciaba la ruta observó la actividad.
Su valor aparece cuando la información está actualizada y conectada con operaciones reales. Un contacto de abuso que no recibe avisos, un registro desactualizado o una asignación que no puede reconciliarse con los datos internos aporta poca capacidad de respuesta. El registro orienta la coordinación; no detiene por sí mismo los paquetes.
El remitente debe acotar sus conclusiones y declarar las lagunas de medición. El receptor necesita información suficiente para localizar al abonado o equipo sin recibir una acusación infundada. Ambas partes deberían conservar el aviso, la investigación, la acción adoptada y el resultado. Una serie de episodios repetidos puede revelar un problema sistémico; una observación aislada puede deberse a una infección temporal o a un error.
MANRS convierte parte de estas expectativas en prácticas operativas de validación de origen y coordinación. [20] Su utilidad depende de que el operador pueda demostrar filtros, contactos y respuestas actuales. La adhesión nominal a una norma no sustituye la evidencia de lo que hizo la red durante el incidente.
Para OVH, datos de origen suficientemente precisos habrían servido para notificar redes, ajustar mitigaciones y estudiar reincidencias. Las fuentes públicas no revelan el conjunto completo de ASN participantes ni cómo respondió cada operador. Afirmar más supondría convertir una posibilidad operativa en una historia no documentada.
Activar la mitigación requiere autoridad, ensayo y reversión
El instante en que un operador cambia el tratamiento del tráfico durante un ataque es también un momento de peligro. Un filtro nuevo puede bloquear tráfico válido; un cambio de ruta puede afectar al prefijo equivocado; el trayecto de limpieza puede no estar disponible; y dos equipos de respuesta pueden ejecutar acciones incompatibles. La velocidad debe combinarse con una autoridad claramente limitada.
La política de activación debe identificar quién puede actuar, qué prefijos y servicios están autorizados, qué señales justifican el cambio y qué evidencia confirma el resultado. La automatización reduce retrasos, pero debe operar sobre objetos aprobados y trayectos ensayados. La intervención manual aporta flexibilidad ante vectores desconocidos, aunque necesita procedimientos practicados y un responsable único del incidente.
Antes de una crisis deben comprobarse las autorizaciones de ruta, las sesiones con proveedores, las listas de prefijos, las comunidades, los enlaces de retorno limpio y la monitorización. También conviene conocer si es posible desviar solo una parte del tráfico y cómo reaccionan los servicios con estado ante rutas asimétricas. Probar únicamente el caso ideal oculta fallos de integración.
Durante el ataque, cada cambio material necesita una anotación común con hora, propietario, objeto afectado, motivo, resultado y acción de reversión. No se trata de imponer una ceremonia lenta mientras el servicio cae. Se trata de impedir que los equipos pierdan la visión de qué regla sigue activa, quién decide el siguiente paso y qué debe retirarse más tarde.
La reversión merece el mismo diseño que la activación. Un filtro olvidado puede causar una degradación silenciosa durante días. Retirar la mitigación demasiado pronto puede exponer el servicio a una segunda oleada. El operador necesita un periodo estable de observación, una vuelta escalonada y criterios claros para reactivar la protección.
RFC 4732 señala que las defensas contra denegación de servicio pueden tener consecuencias perjudiciales, mientras que RFC 4948 sitúa estos problemas dentro de retos de seguridad de Internet con responsabilidades e incentivos distribuidos. [17][18] Ninguno de esos documentos describe el procedimiento privado de OVH; ambos respaldan la necesidad de evaluar una defensa por sus efectos operativos.
El ensayo es la diferencia entre un plan coherente y una capacidad demostrada. Una sesión puede no establecerse, un proveedor puede rechazar el anuncio, el enlace limpio puede ser insuficiente o una dependencia del cliente puede quedar fuera del trayecto protegido. La evidencia convincente procede de un ejercicio o incidente en el que la ruta prevista transportó servicio y el sistema volvió después a un estado controlado.
Un expediente defendible separa registros de resultados
El mejor cierre posterior a un incidente no promete que ningún ataque futuro tendrá éxito. Presenta un conjunto acotado de pruebas sobre qué ocurrió, qué controles cambiaron, cómo funcionaron y qué cuestiones siguen abiertas.
| Superficie de control | Evidencia que debe conservarse | Prueba operativa | Límite principal |
|---|---|---|---|
| Detección de tráfico | Telemetría sincronizada de interfaces, flujos, paquetes y servicio | Varias señales identifican la inundación antes del fallo total | El muestreo puede ocultar picos breves o locales |
| Límite de capacidad | Capacidad de enlaces, reenvío, filtros y trayecto limpio bajo mezclas declaradas | La carga representativa permanece dentro de recursos probados | Laboratorio y producción pueden comportarse de forma distinta |
| Autoridad de mitigación | Prefijos aprobados, propietarios, sesiones y política de activación | Solo cambian las rutas y reglas autorizadas | La aprobación interna no prueba la convergencia externa |
| Desvío de tráfico | Anuncios antes y después, aceptación del proveedor y observaciones externas | El tráfico previsto alcanza el sistema de mitigación | Ningún colector observa todas las rutas privadas |
| Clasificación del ataque | Protocolos, fuentes, muestras, distribución y nivel de confianza | Las reglas reducen el vector observado | El atacante puede cambiar de vector y provocar sobrebloqueo |
| Entrega limpia | Sondas regionales, transacciones, latencia y salud del origen | Las solicitudes legítimas terminan durante la mitigación | Las sondas sintéticas no representan a todos los clientes |
| Daños colaterales | Clases legítimas descartadas, excepciones e informes de usuarios | El impacto permanece dentro de límites explícitos | Algunos afectados nunca informan del fallo |
| Coordinación de origen | Avisos acotados, contactos, acciones y observaciones repetidas | La red de origen puede localizar y limitar el equipo | Una dirección no prueba identidad humana ni intención |
| Reversión | Registro de cambios, responsable, criterios y retorno escalonado | Se recupera el encaminamiento normal sin reaparición inmediata | Una nueva oleada puede exigir otra activación |
| Durabilidad | Ejercicios, excepciones, revisiones de capacidad y procedimientos vigentes | Los controles siguen superando pruebas posteriores | Un éxito aislado no demuestra resiliencia permanente |
La tabla distingue documentación de resultado. Un ticket registra una intención; un plan de capacidad conserva una hipótesis; un registro ASN identifica un dominio de encaminamiento; una configuración demuestra que existía una regla. Ninguno de esos elementos prueba, por separado, que el usuario completara una transacción mientras duraba la inundación.
El expediente debería separar material público y protegido. La divulgación pública puede incluir cronología, magnitud atribuida, vector, principales acciones, recuperación e incógnitas. Bajo confidencialidad, clientes, auditores o autoridades pueden revisar topología, umbrales, muestras, contratos y decisiones internas. La sensibilidad de esos datos justifica controlar su acceso, no dejar de conservarlos.
El principio rector es la conciliación. Los contadores de interfaces deberían ser compatibles con la telemetría de limpieza; los cambios BGP, con las observaciones externas; el filtrado, con la salud de aplicaciones; y los informes de clientes, con las sondas regionales. Una discrepancia no invalida automáticamente una fuente: obliga a estudiar dónde, cuándo y cómo estaba midiendo cada sistema.
La evidencia también necesita una línea temporal común. Sin marcas horarias comparables, el operador puede confundir una mejora natural del ataque con el efecto de una regla, o atribuir una interrupción a la mitigación cuando comenzó antes. La secuencia debe permitir responder qué se sabía en cada momento y por qué se tomó cada decisión.
Un informe maduro incluye los límites de sus propias mediciones. Si los flujos estaban muestreados, debe decirlo. Si una sonda cubría solo determinadas regiones, debe conservar esa restricción. Si la cifra agregaba varios puntos, debe definir la agregación. Declarar incertidumbre fortalece la utilidad del expediente porque evita que una precisión aparente se convierta en una conclusión errónea.
Lo que el registro público no demuestra
Las fuentes respaldan un ataque significativo de Mirai contra infraestructura de OVH y un pico superior a un terabit por segundo comunicado por el operador. [1]–[4] También respaldan la existencia de una botnet ampliamente distribuida y la capacidad de dispositivos comprometidos para generar tráfico directo. No resuelven todas las preguntas de responsabilidad.
No revelan los objetivos exactos dentro de OVH, el número de clientes afectados, la duración de cada impacto, la topología privada de limpieza, las reglas de filtrado, el umbral de activación, la reserva de capacidad ni la trayectoria completa del tráfico legítimo. Tampoco proporcionan una auditoría independiente paquete por paquete de la cifra máxima.
Las fuentes no establecen pérdidas financieras, créditos de servicio, incumplimiento contractual, negligencia ni un estándar jurídico de diligencia. Esos asuntos requerirían contratos, datos de servicio, decisiones internas y análisis legales que no están disponibles en el expediente congelado.
Tampoco identifican todos los dispositivos y sistemas autónomos que participaron en cada ataque contra OVH. Una dirección observada no demuestra que un proveedor permitiera conscientemente el abuso ni qué sabía el propietario del equipo. La atribución a personas exige evidencia distinta de la atribución técnica de una ruta o dirección.
Los materiales posteriores de OVH, NIST, NTIA, ENISA, MANRS e IETF explican riesgos y controles por capas. [2][9]–[20] No prueban que una medida concreta estuviera desplegada en la red privada de OVH en septiembre de 2016. El expediente del Departamento de Justicia acredita hechos jurídicos delimitados, no quién dirigió cada flujo contra OVH. [5]
Estas limitaciones no inutilizan el caso. Definen la conclusión que puede sostenerse: un proveedor de alojamiento debe poder demostrar medición, activación, entrega limpia, coordinación y recuperación. Lo que no puede hacerse es fabricar un informe forense privado a partir de resúmenes públicos.
Preguntas que deberían formular operadores, clientes y supervisores
Los operadores de alojamiento y tránsito deberían preguntar:
- ¿Las líneas base incluyen tasa de bits, tasa de paquetes, protocolos y éxito de servicio?
- ¿Qué componente limita primero el sistema con paquetes pequeños, grandes o mezclados?
- ¿Qué prefijos, emplazamientos y clientes pueden mitigarse de forma independiente?
- ¿Se ensayan las sesiones, autorizaciones de ruta y trayectos de retorno limpio?
- ¿Pueden los equipos ver la capacidad y el estado de filtrado durante el ataque?
- ¿Cómo se protegen las clases legítimas frente a reglas amplias?
- ¿Existe un responsable único para activación y reversión?
- ¿Pueden enviarse avisos de origen precisos y respetuosos con la privacidad?
- ¿Depende la recuperación de sistemas que también podrían estar saturados?
- ¿Se concilian las sondas externas y de clientes con la telemetría interna?
Los fabricantes y propietarios de dispositivos deberían preguntar:
- ¿Las credenciales son únicas y las interfaces de administración están restringidas por defecto?
- ¿Puede el dispositivo recibir actualizaciones autenticadas durante su vida útil?
- ¿Se comunica claramente el fin del soporte?
- ¿Puede el propietario detectar exploración o tráfico saliente anómalo?
- ¿Es posible aislar o reemplazar el equipo cuando no puede repararse?
Los clientes deberían preguntar:
- ¿Qué volúmenes y mezclas de paquetes se han probado en condiciones realistas?
- ¿La mitigación es permanente, bajo demanda o híbrida, y qué activa la transición?
- ¿Qué protocolos legítimos pueden verse limitados durante una emergencia?
- ¿Cómo demostrará el proveedor la entrega limpia y la recuperación regional?
- ¿Qué evidencia y comunicación estarán disponibles después del incidente?
- ¿Las rutas, orígenes o proveedores alternativos son realmente independientes y están ensayados?
Los auditores y supervisores deberían preguntar:
- ¿Las declaraciones de capacidad están vinculadas a interfaces, fechas, reglas y mezclas de paquetes?
- ¿La evidencia muestra servicio completado o solo volumen descartado?
- ¿La autoridad para cambiar rutas y filtros está limitada a recursos aprobados?
- ¿Puede revisarse evidencia sensible sin publicarla de manera insegura?
- ¿Las mejoras tienen ejercicios actuales, excepciones conocidas y responsables?
- ¿Los registros de recursos y contactos de abuso están conectados con una respuesta operativa?
Estas preguntas no exigen capacidad infinita ni prometen ausencia total de fallos. Comprueban si el operador puede detectar una amenaza conocida, actuar con autoridad controlada, conservar el servicio esencial y explicar de forma verificable el resultado.
Conclusión: la capacidad responde cuando sobrevive el tráfico limpio
El ataque de Mirai superior a un terabit por segundo comunicado por OVHcloud sigue siendo un hito en la evolución de los DDoS. La investigación independiente muestra cómo una gran población de dispositivos comprometidos podía producir tráfico directo y distribuido. Las normas, estudios y documentos públicos posteriores explican por qué la respuesta debe abarcar seguridad de dispositivos, redes de origen, tránsito, alojamiento, filtrado y actuación policial. [1]–[20]
La enseñanza no es que un proveedor deba comprar ancho de banda ilimitado. Ninguna red creíble puede prometer absorber cualquier volumen imaginable. La enseñanza es que una declaración de capacidad solo se vuelve responsable cuando está unida a evidencia de infraestructura en funcionamiento.
Esa evidencia comprende tasas de bits y paquetes en límites identificados, un criterio documentado de activación, autoridad controlada para cambiar rutas o filtros, capacidad suficiente en el trayecto limpio, sondas de servicio, registro de daños colaterales, coordinación con redes de origen y una reversión ensayada. También distingue el tráfico directo de la reflexión y aplica la validación de origen allí donde el mecanismo la hace efectiva.
La responsabilidad continúa distribuida. Los fabricantes pueden reducir configuraciones inseguras; los propietarios pueden actualizar o aislar equipos; las redes de acceso pueden detectar actividad saliente anómala; los proveedores de tránsito y mitigación pueden contener tráfico; OVH puede operar el trayecto de alojamiento y demostrar la recuperación; y las autoridades pueden perseguir a quienes controlan la botnet. Cada actor debe evaluarse por el control que realmente poseía y la evidencia que podía producir.
Los registros ASN, las asignaciones IP, las gráficas de tráfico, los planes de capacidad y los tickets de incidente son documentos importantes, pero no constituyen el servicio. La prueba final es que los paquetes con trabajo legítimo alcanzaron su destino mientras el tráfico hostil permanecía contenido. Bajo presión DDoS, la evidencia decisiva no es el mayor número del informe posterior: es el tráfico limpio que continuó, el recurso crítico que permaneció dentro de límites y la recuperación que otro operador pudo comprobar.
Fuentes
- OVHcloud, «What is a DDoS attack?»: https://www.ovhcloud.com/en-gb/security/anti-ddos/ddos-definition/
- OVHcloud, «The rise of packet rate attacks: when core routers turn evil»: https://blog.ovhcloud.com/en/posts/the-rise-of-packet-rate-attacks-when-core-routers-turn-evil/
- USENIX Security 2017, página de la presentación «Understanding the Mirai Botnet»: https://www.usenix.org/conference/usenixsecurity17/technical-sessions/presentation/antonakakis
- Antonakakis et al., «Understanding the Mirai Botnet»: https://www.usenix.org/system/files/conference/usenixsecurity17/sec17-antonakakis.pdf
- Departamento de Justicia de Estados Unidos, cargos y declaraciones de culpabilidad relacionados con Mirai: https://www.justice.gov/archives/opa/pr/justice-department-announces-charges-and-guilty-pleas-three-computer-crime-cases-involving
- National Security Telecommunications Advisory Committee, informe sobre resiliencia de Internet y comunicaciones: https://www.cisa.gov/sites/default/files/publications/NSTAC%20Report%20to%20the%20President%20on%20ICR%20FINAL%20%2810-12-17%29%20%281%29-%20508%20compliant_0.pdf
- Akamai, resumen ejecutivo de «Q3 2016 State of the Internet Security»: https://www.akamai.com/site/en/documents/state-of-the-internet/q3-2016-state-of-the-internet-security-executive-summary.pdf
- Akamai, anuncio del informe «Q3 2016 State of the Internet Security»: https://www.akamai.com/content/akamai/it/newsroom/press-release/akamai-releases-third-quarter-2016-state-of-the-internet-security-report1
- ENISA, «The Internet of Things: when your washing machine and blood pressure monitor become a target for cyberattacks»: https://www.enisa.europa.eu/news/enisa-news/the-internet-of-things-when-your-washing-machine-and-blood-pressure-monitor-become-a-target-for-cyberattacks
- NTIA, anuncio del informe de Comercio y Seguridad Nacional sobre botnets: https://www.ntia.gov/press-release/2018/us-departments-commerce-homeland-security-release-report-president-promoting-action-against-botnets
- Departamentos de Comercio y Seguridad Nacional de Estados Unidos, informe sobre botnets: https://www.ntia.gov/sites/default/files/publications/eo_13800_botnet_report_for_public_comment_0.pdf
- NIST, «Mitigating IoT-Based DDoS»: https://csrc.nist.gov/pubs/pd/2017/12/14/mitigating-iotbased-ddos/final
- NIST, «Resilient Interdomain Traffic Exchange: BGP Security and DDoS Mitigation»: https://www.nist.gov/publications/resilient-interdomain-traffic-exchange-bgp-security-and-ddos-mitigation
- NIST Special Publication 800-189: https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.800-189.pdf
- IETF, RFC 2827 / BCP 38, «Network Ingress Filtering»: https://datatracker.ietf.org/doc/rfc2827/
- IETF, RFC 3704 / BCP 84, «Ingress Filtering for Multihomed Networks»: https://datatracker.ietf.org/doc/rfc3704/
- IETF, RFC 4732, «Internet Denial-of-Service Considerations»: https://datatracker.ietf.org/doc/rfc4732/
- IETF, RFC 4948, «Internet Security Challenges»: https://datatracker.ietf.org/doc/rfc4948/
- IETF, RFC 7039, «Source Address Validation Improvement»: https://datatracker.ietf.org/doc/html/rfc7039
- MANRS, guía de red sobre prevención de suplantación: https://docs.manrs.org/docs/network-guide/anti-spoofing/
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance