
Resumen
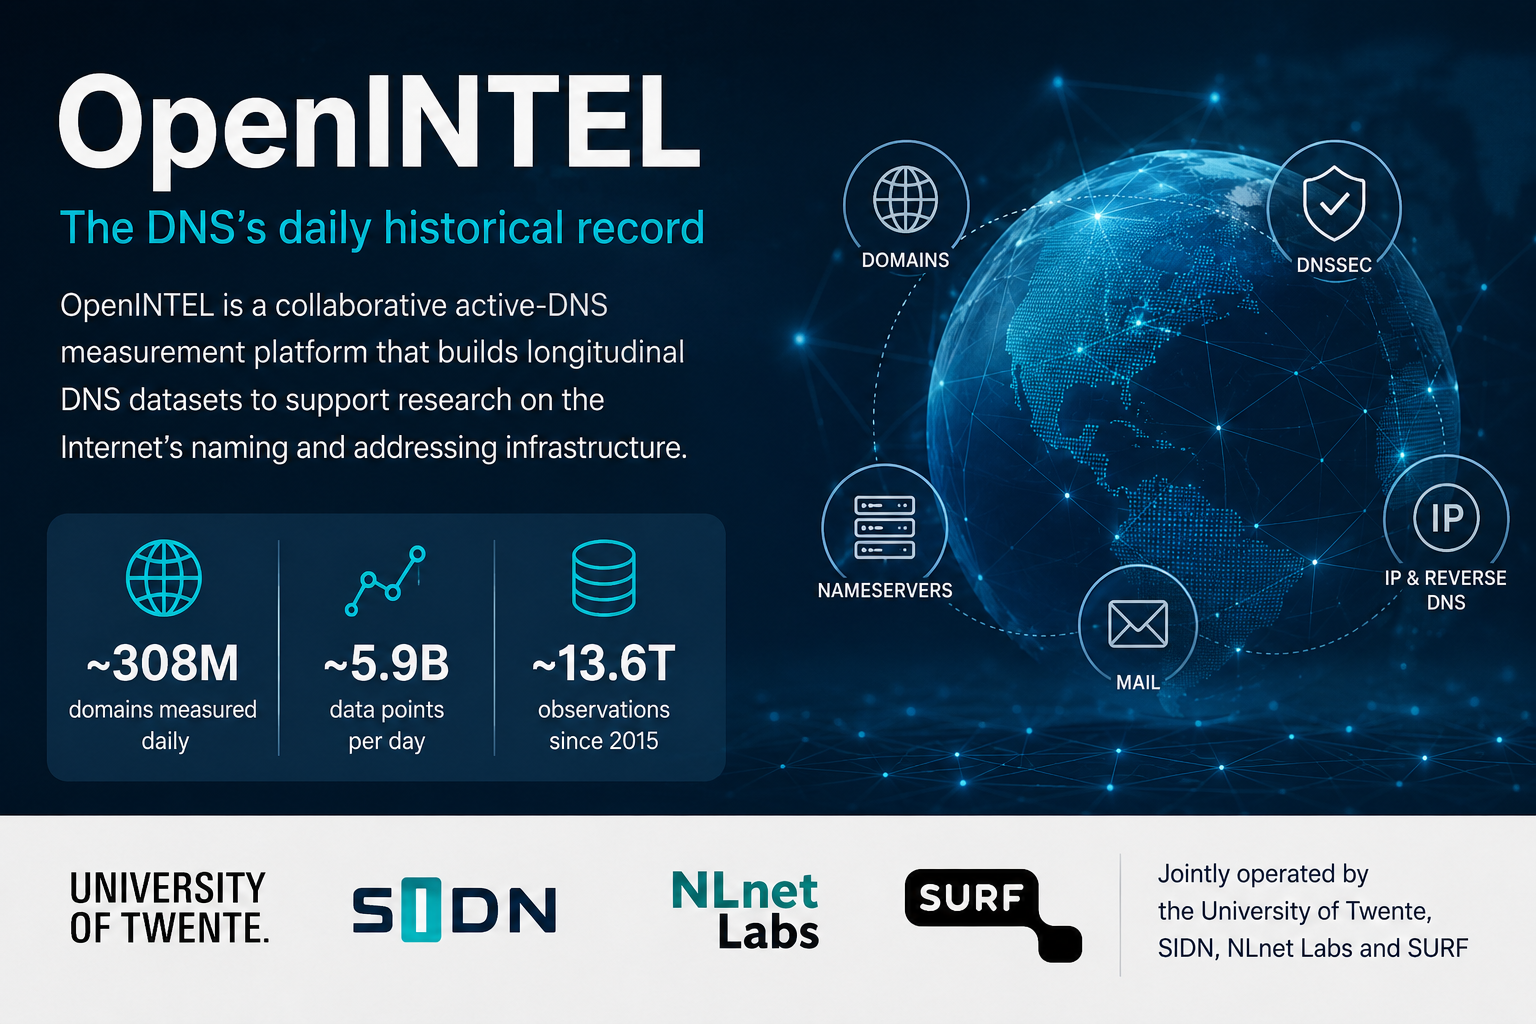
- OpenINTEL es una plataforma colaborativa de medición activa del DNS operada por la Universidad de Twente, SIDN, NLnet Labs y SURF, más que un registro, un resolutor o una empresa de DNS pasivo.
- Su página de inicio informa de unos 308 millones de dominios medidos a diario, 5.900 millones de puntos de datos producidos cada día y 13,6 billones de observaciones acumuladas desde que comenzó la operación regular en 2015.
- La continuidad longitudinal crea el valor de la plataforma, mientras que la selección de fuentes, el punto de observación, el método de consulta, la versión del software, los cambios de método y los controles de datos faltantes delimitan cada resultado.
- OpenINTEL no observa la demanda de los usuarios ni todos los estados del DNS; algunos conjuntos de datos son abiertos bajo una licencia no comercial, mientras que los contratos de acceso a zonas mantienen otro material controlado.
Un sistema de la Universidad de Twente se convirtió en infraestructura de investigación nacional compartida
La implementación de OpenINTEL comenzó en 2014 en la Universidad de Twente. La primera ejecución diaria completa demostró que el proceso podía consultar, procesar y almacenar un espacio de nombres muy grande dentro de la ventana operativa necesaria para la repetición. Las mediciones regulares comenzaron en marzo de 2015. El paso de un experimento a un sistema diario creó el principal valor del archivo: la continuidad.
El proyecto fue fundado por investigadores entre los que se encuentran Anna Sperotto, Mattijs Jonker y Roland van Rijswijk-Deij, cuyas funciones actuales abarcan el liderazgo de investigación, la arquitectura de datos, el diseño de mediciones y la financiación. El modelo operativo se expandió más allá de una sola universidad. SIDN aportó experiencia en registros y un apoyo sostenido. NLnet Labs se incorporó como socio de software de DNS y de investigación. SURF suministró el contexto de red de investigación e infraestructura. Las cuatro instituciones operan ahora conjuntamente el proyecto.
Esta configuración no debe describirse como una empresa independiente. No existe ninguna corporación OpenINTEL verificada con accionistas, ingresos consolidados o una valoración. El personal, el hardware, los contratos, las subvenciones y los derechos sobre los datos residen en las instituciones socias. La gobernanza del proyecto es menos formal en público que la junta de una fundación, pero su diversidad institucional reduce la dependencia de un solo laboratorio.
Cada socio aporta además una visión distinta del DNS. Una universidad valora la investigación reproducible y el trabajo de los estudiantes. Un registro entiende los datos de zona, las relaciones con los operadores y las limitaciones de los acuerdos de acceso. Una organización de software de DNS aporta conocimiento de protocolos e implementación. Una red nacional de investigación puede respaldar la computación y la conectividad necesarias para una medición sostenida.
El modelo crea límites. Los socios pueden financiar equipos y personal sin publicar un presupuesto único del proyecto. Los datos de zona obtenidos por contrato pueden medirse, pero no redistribuirse libremente. Las páginas de colaboradores pueden quedar desactualizadas cuando las personas cambian de empleo, por lo que son fiables para la historia del proyecto y menos fiables para los cargos actuales no relacionados. La operación compartida no convierte todos los activos institucionales en propiedad conjunta.
El desarrollo de OpenINTEL, de sistema de laboratorio a infraestructura común, también cambió sus obligaciones de servicio. Los investigadores dependen de la continuidad de los datos. Los operadores necesitan tráfico identificable y una vía para reportar daños. Los usuarios de datos necesitan formatos estables y condiciones de acceso. Las migraciones de almacenamiento deben preservar la historia. El proyecto debe comportarse como un observatorio de larga duración, no como el conjunto de datos temporal de un artículo.
La primera jornada completa fue un hito técnico. La decisión de seguir midiendo durante una década fue el logro institucional.
El DNS responde al presente y olvida el pasado
Una consulta DNS pide la respuesta actual disponible a través de una ruta determinada. La respuesta puede identificar servidores de nombres, direcciones, sistemas de correo, registros relacionados con certificados u otra configuración. Mañana, el operador puede cambiarla. El estado anterior puede permanecer en cachés durante un tiempo, aparecer en registros mantenidos por un proveedor o desaparecer por completo de la vista pública.
Ese comportamiento es apropiado para un sistema de nombres en vivo. El DNS no existe para ofrecer a los historiadores un libro mayor completo. Existe para asignar nombres y otros identificadores bajo autoridad distribuida. Los registros, los registradores, los operadores autoritativos, los resolutores recursivos y las aplicaciones conservan evidencias diferentes. Ninguna institución preserva de forma natural una vista longitudinal de muchos espacios de nombres y tipos de registro.
La ausencia importa. Los investigadores quieren saber cómo cambió la adopción de DNSSEC, cuándo se trasladó la infraestructura de alojamiento o de correo, cuánta concentración alcanzó el servicio autoritativo y si una política o una vulnerabilidad alteró el comportamiento. Los equipos de seguridad quieren reconstruir a qué resolvía un dominio antes de un incidente. Los responsables de políticas quieren evidencia de la dependencia de proveedores. Un escaneo puntual puede describir un estado; no puede revelar la transición.
OpenINTEL se construyó para crear esa evidencia temporal mediante mediciones activas repetidas. El proyecto obtiene o construye listas de nombres y rangos de direcciones, envía consultas DNS definidas según un calendario y almacena las respuestas con marcas de tiempo y metadatos. Repetir el proceso permite a un investigador comparar lo comparable a lo largo de días y años.
La palabra «comparable» exige disciplina. Las listas de fuentes cambian. Se añaden nuevos tipos de registro. El software y la infraestructura se actualizan. Algunos días quedan incompletos. Un servidor autoritativo puede limitar la velocidad o bloquear al proyecto. Una respuesta puede variar según el punto de observación, la ubicación anycast o el momento. El valor longitudinal depende de registrar esos cambios en lugar de tratar el archivo como una tabla perfectamente uniforme.
Por tanto, la contribución central de OpenINTEL no es simplemente el volumen de escaneo. Los escáneres de todo Internet también pueden producir conjuntos de datos enormes. El activo distintivo es un instrumento de larga duración cuyos métodos, socios y productos de datos son lo bastante estables como para que el propio cambio se convierta en objeto de estudio.
Esa fortaleza respalda el título de «registro histórico diario del DNS» solo con un límite. OpenINTEL conserva una historia de las mediciones que fue configurado para realizar. No registra todas las consultas DNS, todos los dominios ni todas las respuestas vistas por los usuarios. El archivo es lo bastante grande precisamente para que un lenguaje descuidado pueda hacerlo parecer universal. Su credibilidad depende de resistir esa tentación.
La lista de objetivos define el campo de visión del archivo
La medición activa del DNS requiere una población objetivo. OpenINTEL puede recibir listas de dominios derivadas de zonas, nombres de transparencia de certificados, listas de popularidad, datos de dominios de nivel superior de códigos de país, rangos de direcciones y otras fuentes. Cada fuente responde a una pregunta de investigación distinta y contiene un sesgo diferente.
Una zona de un registro puede ofrecer una cobertura amplia de los nombres delegados bajo ese dominio de nivel superior, sujeta a contrato. Puede omitir nombres de otros espacios de nombres y no dice nada sobre si un dominio aloja un servicio activo. Los registros de Transparencia de Certificados revelan nombres asociados a certificados registrados públicamente, favorecen los servicios habilitados para TLS y exponen subdominios que no figuran en las listas de zona. Las listas de popularidad enfatizan los nombres consultados con frecuencia bajo metodologías opacas o cambiantes.
La medición de DNS inverso parte del espacio de direcciones y no de los nombres.
Combinar fuentes aumenta el alcance y el riesgo de doble conteo o de cambios en la composición. Una cifra de portada de 308 millones de dominios medidos al día debe leerse como la métrica actual del proyecto para observaciones de dominios configuradas, no como 308 millones de sitios web activos únicos. Un dominio puede estar aparcado, delegado sin contenido, duplicado en varias listas o utilizado para correo e infraestructura en lugar de un sitio web.
La selección de fuentes afecta a la interpretación longitudinal. Supongamos que se añade un nuevo dominio de nivel superior a la medición. El número total de registros observados aumenta porque el instrumento se amplió, no porque el DNS cambiara orgánicamente. Una lista de popularidad puede revisar su metodología y crear una aparente rotación. La cobertura de Transparencia de Certificados puede aumentar a medida que cambian las prácticas de emisión. Los analistas necesitan listas versionadas y criterios de inclusión.
Los métodos del proyecto pueden producir tendencias sólidas cuando las comparaciones están delimitadas. Los investigadores pueden examinar un subconjunto estable de nombres a lo largo del tiempo, controlar las adiciones y clasificar los tipos de fuente. El tamaño del archivo permite estudiar eventos raros y relaciones de infraestructura, pero las cifras grandes no compensan una población indefinida.
La gobernanza de las listas también es comercial y política. Los registros pueden permitir la medición bajo acuerdos que restringen la redistribución. Los operadores pueden oponerse a la carga. Un proyecto comprometido con la ciencia abierta no puede simplemente publicar datos que no tiene derecho a compartir. Por ello, el archivo tiene capas abiertas y controladas.
La primera pregunta para cualquier resultado de OpenINTEL debería ser, por tanto: ¿qué nombres o direcciones podían medirse en esas fechas? La respuesta no es un detalle de fondo. Define la afirmación.
OpenINTEL mide nombres y espacio de direcciones desde una base institucional neerlandesa con listas de fuentes y colaboraciones globales. Eso le da materia de estudio mundial, no una representación automática de todas las regiones o experiencias de usuario.
El acceso a zonas varía entre registros. Algunas listas de códigos de país son exhaustivas, otras se construyen a partir de fuentes públicas y algunas no pueden redistribuirse. Los nombres derivados de certificados favorecen los servicios que usan certificados públicos. Un punto de observación de medición puede recibir una respuesta anycast distinta de la que se ve en otro continente. El DNS de horizonte dividido y geolocalizado puede hacer que ambas observaciones sean válidas.
Por lo tanto, los investigadores que comparan países deben separar la etiqueta de registro del dominio de la ubicación de su operador, sus usuarios y su infraestructura. Un nombre.brpuede estar alojado en Europa; un dominio de nivel superior genérico puede servir a una organización local. Contar nombres por sufijo no equivale a medir la dependencia nacional.
La replicación y los puntos de observación complementarios pueden poner a prueba la sensibilidad geográfica. Cuando los resultados difieren, la diferencia es un dato y no una molestia que promediar. Puede revelar políticas anycast, localización de contenidos o bloqueos.
El papel de interés público del proyecto es más fuerte cuando las lagunas de cobertura se cartografían explícitamente. Las regiones con acuerdos de fuentes más débiles no deberían desaparecer dentro de un porcentaje global. Un registro histórico solo puede reducir la desigualdad de conocimiento si los usuarios saben dónde su instrumento podía ver menos.
Miles de millones de consultas solo importan cuando su contexto sobrevive
El proceso de medición convierte las listas de objetivos en consultas programadas. Los trabajadores emiten solicitudes para tipos de registro definidos, reciben respuestas, normalizan campos y almacenan observaciones con marcas de tiempo y metadatos. A la escala que informa OpenINTEL —unos 5.900 millones de puntos de datos al día—, el reto operativo no es enviar un paquete DNS. Es completar el ciclo diario de forma fiable sin saturar la infraestructura autoritativa ni perder las condiciones que hay detrás del resultado.
Los trabajadores necesitan control de velocidad, política de reintentos e identificación clara de la fuente. Un tiempo de espera agotado puede significar ausencia de servicio, pérdida de paquetes, limitación de velocidad, un fallo transitorio o un bloqueo intencionado. Reintentar de forma demasiado agresiva puede crear el daño que el proyecto intenta evitar. Dar a los operadores una explicación pública y una vía de contacto hace que el tráfico sea responsable.
Las respuestas deben analizarse en muchos tipos de registro y casos límite del DNS. Los nombres pueden contener codificaciones inusuales. Las delegaciones pueden ser defectuosas o cíclicas. DNSSEC añade firmas, claves y registros de negación de existencia. La truncación puede hacer que una consulta pase de UDP a TCP. Los servidores autoritativos pueden devolver respuestas distintas según la ubicación de origen. La normalización debe preservar el significado sin convertir cada paquete en un formato inmanejable.
El sistema también necesita una definición de completitud. Una ejecución diaria puede terminar para la mayoría de los objetivos y omitir un subconjunto. Almacenar solo las respuestas con éxito haría invisible la ausencia. Los investigadores necesitan saber qué consultas se intentaron, cuáles fallaron y si una interrupción de la plataforma afectó a un período. Un registro faltante no debería convertirse automáticamente en evidencia de que un dominio lo eliminó.
La página de inicio de OpenINTEL informa de 13,6 billones de puntos de datos acumulados desde 2015. Esa cifra comunica escala y sigue siendo reportada por el proyecto. Su valor analítico depende de cómo se defina «punto de datos» entre productos y a lo largo del tiempo. Un recuento puede crecer por más dominios, más tipos de registro u observaciones más frecuentes. Los usuarios deben consultar la metodología del conjunto de datos correspondiente en lugar de comparar totales acumulados como una medida simple del crecimiento del DNS.
A este volumen, las decisiones de ingeniería condicionan la investigación. El particionado, la compresión, los índices y los formatos de almacenamiento determinan qué consultas son viables. Las migraciones de datos pueden cambiar la representación. Los sistemas de control de calidad deben identificar ejecuciones incompletas. El archivo es a la vez un instrumento científico y una plataforma de datos.
El DNS directo revela configuración, no comportamiento de aplicaciones
La medición directa comienza con un nombre y pide registros seleccionados. Los datos de delegación pueden mostrar qué proveedores autoritativos sirven el dominio. Los registros de dirección pueden mostrar relaciones de alojamiento o CDN. Los registros de intercambio de correo exponen la infraestructura de correo electrónico. Los registros DNSSEC indican el despliegue y las opciones de algoritmos. Otros tipos revelan la configuración de servicios y políticas.
Las observaciones repetidas hacen visibles las transiciones. Un dominio puede pasar de un proveedor autoritativo a otro, añadir IPv6, activar DNSSEC o cambiar el servicio de correo. A gran escala, los investigadores pueden estimar la adopción y la concentración. Pueden examinar si los cambios ocurren gradualmente o en torno a un evento.
Un registro devuelto sigue siendo una observación en un momento y desde un punto de observación. Una dirección A o AAAA no demuestra que un sitio web respondiera, que la dirección sirviera el mismo contenido a los usuarios o que la aplicación fuera segura. Un intercambio de correo no demuestra una entrega exitosa. Una firma DNSSEC puede estar presente mientras la validación falla en otro lugar. Las pruebas a nivel de aplicación requieren métodos separados.
Las CDN y el anycast complican la interpretación. Una respuesta autoritativa o recursiva puede variar según la ubicación de origen. Un dominio puede devolver direcciones seleccionadas para el punto de observación de OpenINTEL y no las que recibe un usuario de otra región. Los sistemas de horizonte dividido dan deliberadamente respuestas distintas a clientes internos y externos. La medición del proyecto no es falsa; es una vista.
El almacenamiento en caché añade otra distinción. El sistema activo de OpenINTEL puede consultar a través de rutas de resolutores definidas o de infraestructura autoritativa según el conjunto de datos. No observa lo que cada resolutor recursivo tiene en caché. Un usuario puede recibir un valor anterior hasta que expire el TTL. Los cambios del archivo pueden preceder o seguir a las transiciones visibles para el usuario.
El valor de la plataforma es más fuerte cuando la pregunta de investigación coincide con el método: cómo cambiaron las respuestas DNS configuradas observadas por el proyecto. Se debilita cuando la respuesta se usa como indicador de popularidad, éxito de una aplicación o experiencia de usuario sin evidencia adicional.
El DNS inverso y los productos de espacio de direcciones conectan los nombres con la administración de redes
El DNS inverso parte de una dirección IP y pregunta qué nombre, si lo hay, está asociado a través de la jerarquía in-addr.arpa o ip6.arpa. OpenINTEL se amplió a la medición inversa de IPv4, creando otra gran vista longitudinal. El conjunto de datos puede revelar patrones de nombres administrativos, cambios de infraestructura y la presencia de registros en el espacio de direcciones.
Un registro PTR no es una prueba autoritativa de quién usa una dirección ni de qué servicio presta. Los titulares de direcciones pueden dejar registros obsoletos, usar nombres genéricos o delegar zonas inversas. Las redes de nube y de acceso pueden aplicar nombres sistemáticos. Algunas direcciones no tienen entrada inversa. Los datos son útiles para la clasificación y el cambio, no como un mapa de identidad universal.
Medir el espacio inverso de IPv4 es manejable en comparación con IPv6 porque la población de direcciones es menor y enumerable bajo políticas definidas. IPv6 es demasiado grande para un escaneo exhaustivo dirección por dirección. La investigación debe usar prefijos asignados, direcciones observadas u otros métodos de selección de objetivos. Esta diferencia impide proyectar la metodología de IPv4 sobre el protocolo más nuevo sin matices.
El proyecto también publica productos a nivel de RIR y de prefijos de red. Las listas temporales de prefijos principales intentan clasificar prefijos de red bajo observaciones definidas. Esas listas pueden apoyar el muestreo de mediciones y la investigación, pero no son una jerarquía objetiva de importancia de redes. Un prefijo puede parecer prominente por la construcción de la lista y la población de servicios. El valor comercial, el tráfico y el número de usuarios siguen siendo cuestiones separadas.
Estos productos amplían OpenINTEL de un observatorio de dominios hacia una plataforma de nombres y direccionamiento. También aumentan la necesidad de etiquetas cuidadosas. La «historia del DNS» puede abarcar registros de dominio, nombres inversos, objetivos derivados de certificados y cambios de zona inferidos, cada uno con una población y cadencia distintas.
La expansión es valiosa analíticamente porque la infraestructura de Internet une nombres, direcciones y redes. Una migración de alojamiento puede aparecer en registros directos y en relaciones de prefijos. El nombrado inverso puede aportar contexto operativo. Los datos de los RIR pueden agrupar observaciones. La conexión sigue siendo un marco de inferencia, no un libro mayor completo de propiedad.
Zonestream reduce la brecha entre las instantáneas diarias y el cambio intradía
Un escaneo diario registra un estado amplio. El DNS puede cambiar varias veces entre escaneos. Una campaña maliciosa puede activarse y desaparecer. Un gran proveedor puede migrar registros por etapas. Un error de configuración puede introducirse y corregirse antes de la siguiente ejecución programada.
Zonestream y trabajos relacionados buscan ofrecer evidencia más orientada a eventos al inferir cambios de zona y producir fuentes más cercanas al momento del cambio. El enfoque complementa el archivo diario, no lo sustituye. Una secuencia puede identificar transiciones rápidas; el proceso diario ofrece instantáneas amplias y coherentes.
Una medición más rápida crea desafíos de carga e interpretación. Consultas más frecuentes aumentan el tráfico hacia los operadores autoritativos. Los cambios en una fuente de zona no siempre significan lo mismo que los cambios en las respuestas DNS observadas. Una secuencia puede contener ráfagas de mantenimiento o de sistemas automatizados. Los consumidores deben distinguir eventos crudos de transiciones de infraestructura significativas.
El producto muestra cómo la arquitectura de OpenINTEL ha evolucionado más allá de un solo proceso por lotes. El proyecto empezó demostrando que se podía completar una enorme ejecución diaria. Después añadió formas de observar cambios con una resolución temporal distinta. Esto amplía los casos de uso y complica la comparabilidad.
Los investigadores deben indicar qué cadencia respalda una afirmación. Un conjunto de datos diario puede mostrar que una configuración difirió entre fechas. Una secuencia puede mostrar una sucesión intermedia. Ninguno explica necesariamente por qué actuó el operador. Combinarlos con evidencia de registros, certificados o incidentes puede reforzar el relato.
Zonestream también aumenta la importancia operativa de la disponibilidad continua. Un escaneo diario perdido crea una laguna. Una fuente de eventos fallida puede perder una secuencia difícil de reconstruir. La redundancia, la repetición y la supervisión pasan a formar parte del método de investigación.
El almacenamiento es el producto más duradero del proyecto y su mayor obligación
El archivo de OpenINTEL es valioso porque el DNS de ayer no puede consultarse directamente. Una vez que un estado cambia y las cachés expiran, la medición repetida puede ser la única evidencia pública de que el punto de observación del proyecto lo observó. Eso convierte el almacenamiento y la integridad de los datos en infraestructura central.
Un archivo a escala de una década necesita algo más que capacidad. Necesita esquemas versionados, sumas de verificación, replicación, migraciones documentadas y una forma de preservar la relación entre observaciones y métodos. Una columna renombrada sin un registro de migración puede romper la reproducibilidad. Un cambio de compresión puede mejorar el coste y complicar las herramientas antiguas. Una partición dañada puede eliminar evidencia que ningún nuevo escaneo puede regenerar.
La retención crea presión financiera. Miles de millones de puntos diarios requieren cómputo, red y almacenamiento. Las fuentes públicas no revelan un coste anual consolidado. La carga se reparte entre las instituciones socias y los programas de financiación. A medida que crece el archivo, el proyecto debe elegir entre conservar el detalle bruto, producir conjuntos de datos derivados y controlar el acceso.
El coste de las consultas es otra limitación. Un investigador puede querer analizar años de registros de millones de dominios. Permitir consultas sin restricciones puede saturar la plataforma. Los productos de descarga y el acceso controlado distribuyen el trabajo, pero exigen que los usuarios almacenen y procesen los datos por sí mismos. Copias alojadas en la nube podrían mejorar el acceso a costa de plantear cuestiones de coste y gobernanza.
La integridad longitudinal también depende de preservar la ausencia. Un día sin registro puede significar que al dominio le faltaba el valor, que la consulta falló, que el objetivo no estaba en la lista o que el proceso quedó incompleto. El archivo necesita suficientes datos de control para distinguir esos estados. De lo contrario, una tendencia puede ser un artefacto de la instrumentación.
El futuro del proyecto vendrá determinado en parte por si las instituciones siguen financiando este trabajo invisible. Los nuevos tipos de registro y los paneles atraen atención. Mantener bytes antiguos, documentación y contexto crea el activo histórico. Si se pierde el almacenamiento o el personal especializado, la continuidad del archivo no podrá recuperarse después.
Cuatro instituciones comparten la plataforma sin un presupuesto visible
La resiliencia organizativa de OpenINTEL proviene de la asociación. La Universidad de Twente aporta liderazgo académico e investigadores. SIDN contribuye con conocimiento de registros y apoyo. NLnet Labs aporta software de DNS y experiencia operativa. SURF contribuye con infraestructura nacional de investigación. La combinación es más fuerte que un proyecto dependiente de un investigador principal y una subvención.
El modelo también es opaco en términos financieros convencionales. No hay ingresos, gastos ni recuento de personal consolidados del proyecto. El hardware puede estar financiado por un socio, los investigadores empleados por otro y la capacidad de red suministrada por un tercero. Las páginas públicas identifican funciones, pero no ofrecen una única carta de votación ni un registro de activos.
Eso no convierte al proyecto en no gobernado. Las decisiones ocurren a través de relaciones institucionales y un equipo central. Sí significa que los cambios en las prioridades de los socios pueden afectar a la plataforma sin manifestarse como un evento corporativo. Una subvención termina, un servidor llega a su edad de sustitución o un especialista cambia de función. El archivo puede continuar mientras la capacidad de desarrollo se estrecha.
La concentración de experiencia es un riesgo. Los sistemas de medición de larga duración acumulan conocimiento sobre peculiaridades, migraciones de datos y relaciones con operadores. La documentación y la sucesión son tan importantes como el código nuevo. Una asociación solo puede repartir la carga si más de una institución puede operar componentes críticos.
El modelo también configura la rendición de cuentas ante los operadores medidos. Una identidad de proyecto visible y un contacto para abusos permiten a los proveedores autoritativos reportar tráfico excesivo. Los socios con prestigio en la comunidad DNS pueden negociar problemas. El sistema debe preservar esa confianza a medida que crecen la escala y los productos.
OpenINTEL se describe mejor como infraestructura de investigación compartida. Su autoridad proviene de la calidad y continuidad de su evidencia, no de una pretensión estatutaria sobre el DNS. Mide un sistema distribuido bajo la tolerancia de organizaciones que siguen siendo libres de bloquearlo o restringirlo.
Los datos abiertos siguen dependiendo de contratos, licencias y financiación a largo plazo
OpenINTEL promueve el acceso a la investigación y publica conjuntos de datos elegibles bajo CC BY-NC-SA 4.0. La licencia exige atribución, restringe el uso comercial y aplica condiciones de compartir igual. Otro material permanece controlado porque los acuerdos de acceso a zonas o los contratos de fuentes no permiten la redistribución sin restricciones.
Esta configuración puede decepcionar a los usuarios que oyen «OpenINTEL» y asumen que toda observación es descargable libremente para cualquier propósito. El nombre del proyecto describe un compromiso de investigación, no la propiedad de cada entrada. Un registro puede permitir la medición bajo condiciones sin otorgar el derecho a republicar todos sus datos derivados de la zona.
La restricción no comercial apoya el intercambio académico y limita parte de la reutilización industrial. Una empresa puede necesitar un acuerdo separado para un producto comercial. El proyecto no publica una licencia comercial universal ni un precio. Los usuarios deben contactar con los operadores en lugar de suponer que las condiciones de acceso pueden inferirse de los conjuntos de datos abiertos.
Los datos controlados pueden seguir apoyando la investigación mediante solicitudes, acuerdos institucionales o productos derivados. El proceso introduce costes de selección y administración. Los investigadores con afiliaciones establecidas pueden acceder más fácilmente que los analistas independientes. La reproducibilidad es más difícil cuando el conjunto de datos subyacente no puede redistribuirse.
La tensión es estructural. La investigación longitudinal del DNS se beneficia de un acceso amplio a las fuentes. Los registros y operadores tienen preocupaciones contractuales, de seguridad y comerciales. Una plataforma que violara esos acuerdos podría publicar más a corto plazo y perder acceso futuro. La apertura sostenible a veces exige un límite documentado en lugar de la publicación máxima.
Para los usuarios de datos, la práctica correcta es específica de cada conjunto. Indique la fuente, la licencia, la cobertura y la condición de acceso. No describa los datos controlados como públicos. No asuma que una tabla derivada abierta contiene todo el archivo subyacente. La gobernanza de los datos forma parte del método.
Los conjuntos de datos abiertos actuales usan una licencia Creative Commons no comercial, mientras que otro material permanece controlado por contratos de fuentes. Esto apoya el trabajo académico y evita suponer que todo el contenido del archivo es libre para cualquier uso empresarial.
Los analistas comerciales pueden querer evidencia histórica del DNS para seguridad, investigación de mercado o debida diligencia. Su demanda podría ayudar a financiar infraestructura y puede entrar en conflicto con las restricciones impuestas por los registros y las expectativas de los operadores medidos. Una vía de pago tendría que distinguir el servicio y el soporte de los derechos que el proyecto no posee.
Los socios podrían ofrecer agregados derivados, entornos de investigación controlados o licencias negociadas para datos elegibles. Cada modelo cambia quién puede reproducir un resultado. Un producto privado construido a partir de un archivo de interés público puede generar valor sin devolver métodos ni correcciones.
La cuestión de gobernanza no es si el uso comercial es bueno o malo. Es si los acuerdos de ingresos preservan el registro longitudinal, respetan los derechos de las fuentes y evitan que los datos más completos queden disponibles solo para usuarios bien financiados.
La sostenibilidad de OpenINTEL puede acabar requiriendo niveles de acceso más formales. La credibilidad de esos niveles dependerá de criterios transparentes y de una base pública protegida. El archivo se volvió valioso mediante la investigación compartida. Financiar su futuro no debería hacer imposible examinar su pasado.
Una respuesta DNS registra configuración, no intención ni daño
Los grandes conjuntos de datos DNS invitan a conclusiones categóricas. Un registro apunta a una dirección asociada a un proveedor, por lo que se dice que el dominio está alojado allí. Un nombre devuelve NXDOMAIN, por lo que se declara inexistente. Un nombre derivado de un certificado resuelve, por lo que se asume que el servicio está activo. Cada inferencia puede ser útil y errónea en un caso concreto.
Una respuesta DNS registra lo que devolvió la infraestructura consultada bajo las condiciones de medición. No muestra por qué el operador la configuró. La dirección puede ser una redirección, un sumidero, una página aparcada o un extremo compartido de CDN. La aplicación puede rechazar el nombre de host. El registro puede estar obsoleto. Un fallo transitorio del servidor o una limitación de velocidad puede producir una ausencia aparente.
NXDOMAIN significa que la ruta DNS que respondió afirmó la inexistencia del nombre consultado en su estado actual. No prueba que el nombre nunca existió ni que no existirá más adelante. Los errores de delegación y los servidores autoritativos inconsistentes pueden crear resultados variables. Las observaciones repetidas y las comprobaciones autoritativas directas mejoran la confianza.
El análisis de seguridad exige aún más cautela. Los cambios rápidos de dominio o dirección pueden asociarse con abuso y también con CDN legítimas, conmutación por error y migraciones. Un registro no prueba que un dominio sea malicioso. Etiquetarlo requiere evidencia adicional como contenido, relaciones de campañas, registro y comportamiento observado.
La demanda de los usuarios queda completamente fuera de la medición activa. OpenINTEL genera sus propias consultas. No ve con qué frecuencia los usuarios piden un nombre, qué sirven las cachés recursivas ni qué respuesta produce tráfico. El DNS pasivo o la telemetría de resolutores abordan preguntas distintas y plantean preocupaciones de privacidad diferentes.
La cultura analítica más sólida del proyecto es la que trata estos límites como elementos de primer orden. Un archivo enorme puede respaldar mejores inferencias porque hay patrones e historia disponibles. No cambia el estatus lógico de una observación. La medición sigue siendo un insumo para la explicación, no la explicación misma.
Una respuesta NXDOMAIN puede indicar que un nombre no existe en la vista DNS correspondiente. Un tiempo de espera agotado puede indicar un servidor inalcanzable, limitación de velocidad, pérdida de paquetes o rechazo deliberado. Un SERVFAIL puede surgir de problemas de validación, delegación u operativos transitorios.
El análisis longitudinal debe preservar estas categorías en lugar de reducirlas a «caído». Un dominio que pasa de una respuesta válida a NXDOMAIN tiene una historia distinta de uno que agota el tiempo de espera intermitentemente. Un cambio de analizador o de reintento puede alterar la distribución medida sin que ningún operador cambie la configuración.
La distinción es especialmente importante en la investigación de seguridad y de políticas. Una falta de respuesta no es prueba de que un dominio fue eliminado o censurado. Pueden ser necesarios puntos de observación adicionales, consultas autoritativas y comprobaciones de aplicación.
La escala de OpenINTEL hace que la clasificación de errores sea decisiva. Una pequeña elección metodológica puede afectar a millones de registros. El tratamiento cuidadoso de la evidencia negativa es una de las formas más claras en que el proyecto puede evitar que un archivo vasto produzca conclusiones excesivamente seguras.
Las afirmaciones longitudinales dependen del historial de métodos y de las observaciones faltantes
Un conjunto de datos a escala de una década contiene dos historias: la del DNS y la del instrumento. Se sustituye hardware, cambia el software de consulta, se corrigen analizadores y se amplían los acuerdos de fuentes. Un tipo de registro añadido en 2024 no puede compararse directamente con una ausencia en 2018. Una nueva regla de reintento puede mejorar la completitud y, a la vez, cambiar la probabilidad de que un servidor lento parezca responder.
Por esta razón, el versionado de métodos forma parte de los datos. Cada serie de observaciones debe vincularse a la lista de objetivos, el tipo de consulta, el punto de observación de medición, la versión del software y los eventos operativos conocidos. Los días faltantes necesitan indicadores explícitos. Un analista no debe inferir que millones de dominios cambiaron cuando un clúster de trabajadores falló o una fuente de entrada llegó tarde.
El problema se agrava tras una migración de almacenamiento. Un nuevo esquema puede comprimir campos repetidos, normalizar nombres de forma distinta o reclasificar errores. Esos cambios pueden abaratar y facilitar el uso del archivo, pero alterar consultas antiguas. Conservar registros fuente brutos o suficientemente detallados, el código de migración y muestras de validación permite a los investigadores distinguir una tendencia del DNS de una transformación de base de datos.
La reproducibilidad no exige que toda la plataforma permanezca congelada. Exige evidencia suficiente para reconstruir cómo se produjo un resultado. El trabajo publicado debe identificar la versión del conjunto de datos o la fecha de acceso, los filtros de población y el código. Cuando las condiciones contractuales impiden redistribuir registros brutos, los investigadores pueden publicar métodos, agregados y comprobaciones de validación dentro del acuerdo.
La asociación de OpenINTEL con investigadores externos y los trabajos de replicación son importantes aquí. Una segunda implementación o una medición independiente no producirá respuestas idénticas, pero las diferencias pueden revelar supuestos. La replicación es especialmente valiosa cuando el anycast, el bloqueo o las licencias de listas hacen que un punto de observación sea estructuralmente incompleto.
La antigüedad del archivo aumenta el coste de un cambio silencioso. Una pequeña corrección de análisis aplicada retroactivamente puede alterar años de datos. Dejar el error intacto puede perpetuar un defecto conocido. El enfoque responsable es documentar la corrección, preservar el estado original cuando sea posible y especificar qué versión sustenta un resultado.
Este es el trabajo sin glamour que separa la infraestructura de una colección de archivos. Los billones de puntos de datos reportados por la plataforma solo importan si los futuros usuarios pueden saber qué puntos pertenecen a la misma comparación. La ciencia longitudinal es un ejercicio de preservar el contexto a la misma escala que las observaciones.
El escaneo responsable debe permanecer visible para los operadores que soportan su coste
La medición activa consume recursos fuera del proyecto. Una consulta DNS es pequeña, pero miles de millones de consultas llegan a sistemas autoritativos que van desde grandes plataformas anycast hasta servidores modestos. Los controles de velocidad y la programación reducen el impacto; no hacen que el coste sea cero. La base ética del trabajo incluye, por tanto, transparencia y una vía práctica para que los operadores se opongan.
Una plataforma responsable usa direcciones de origen identificables, publica una descripción de su tráfico y supervisa los canales de contacto. Debe atender solicitudes justificadas de reducir o bloquear la medición e investigar informes de carga inusual. Esas medidas no crean un consentimiento universal. Hacen que el proyecto rinda cuentas por una actividad técnicamente posible sin permiso previo.
La carga no se distribuye uniformemente. Un proveedor con muchas delegaciones puede recibir consultas de millones de nombres, mientras que un operador pequeño solo ve unas pocas. Algunos servidores están configurados para limitar la velocidad del tráfico desconocido, lo que provoca un aparente fallo de medición. Otros pueden devolver respuestas deliberadamente genéricas. Un analista debe reconocer que la defensa del operador cambia el conjunto de datos observado.
El riesgo de privacidad es distinto del registro pasivo en resolutores. OpenINTEL genera consultas a partir de listas de objetivos y no observa a usuarios individuales. Eso limita en gran medida la exposición al comportamiento de los usuarios. El archivo puede contener nombres que identifican organizaciones, dispositivos o servicios, incluidos subdominios derivados de registros de certificados. Publicar registros históricos detallados puede facilitar encontrar infraestructura olvidada.
Los controles de acceso y las licencias pueden reducir el uso indebido sin convertir cada observación DNS en datos confidenciales. El límite apropiado depende de la fuente, la granularidad y el riesgo. Los agregados amplios y los conjuntos de datos de investigación pueden publicarse de forma segura, mientras que los registros brutos derivados de zonas permanecen contractualmente controlados. Un proyecto comprometido con la ciencia abierta debe explicar estas distinciones en lugar de presentar el acceso como todo o nada.
La revisión ética también debe tener en cuenta las afirmaciones posteriores. Un artículo de investigación que etiqueta un dominio o un país como inseguro puede causar daño reputacional cuando la medición en realidad captó un error transitorio. El proyecto no puede vigilar a cada usuario, pero advertencias, condiciones y ejemplos claros pueden moldear mejores prácticas.
La legitimidad de OpenINTEL descansa en parte en el hecho de que los operadores medidos pueden ver quién pregunta. Esa visibilidad debe seguir siendo un requisito de diseño a medida que los productos se vuelven más rápidos y variados. Un observatorio se gana la tolerancia del sistema que observa haciendo que su propio comportamiento esté abierto a inspección.
El DNS activo, el DNS pasivo y el escaneo general responden a preguntas distintas
A veces se compara OpenINTEL con bases de datos de DNS pasivo, escáneres de todo Internet y sistemas distribuidos de sondas. La comparación solo es útil después de separar el modelo de observación.
El DNS pasivo recopila registros vistos en el tráfico real de consultas en resolutores recursivos u otros puntos de observación. Puede revelar qué pidieron los usuarios o sistemas y qué respuestas se devolvieron por esas rutas. La cobertura depende de los sensores participantes y plantea cuestiones de privacidad y contractuales. Una base de datos pasiva puede ver rápidamente un dominio malicioso popular y omitir un dominio tranquilo que ningún usuario observado solicita.
OpenINTEL elige sus objetivos y formula sus propias preguntas. Puede medir la misma población cada día aunque ningún usuario visite los nombres. Esa regularidad respalda la comparación longitudinal. No puede inferir popularidad ni comportamiento de caché a partir de las consultas activas. Los dos métodos son complementarios: uno refleja la demanda observada en resolutores seleccionados; el otro refleja respuestas configuradas para objetivos seleccionados desde puntos de observación de medición.
Un escáner como ZMap comienza con direcciones y pregunta si un servicio responde, a menudo seguido de un saludo de protocolo. Puede cartografiar servicios expuestos sin depender de listas de dominios. La medición DNS puede identificar nombres y delegaciones que apuntan a infraestructura compartida, incluidos registros cuyos servicios son inalcanzables. De nuevo, los métodos ven superficies distintas.
Una plataforma distribuida de sondas como RIPE Atlas puede formular preguntas DNS desde muchas redes y ubicaciones, revelando diferencias geográficas y dependientes del resolutor. OpenINTEL enfatiza la amplitud, la repetición y la escala del archivo desde su infraestructura de medición. Una población más pequeña desde muchos puntos de observación puede responder una pregunta que un único escaneo diario vasto no puede.
Estas distinciones evitan un error común: tratar todos los grandes conjuntos de datos de Internet como evidencia intercambiable. Un dominio ausente del DNS activo, no visto en datos pasivos e inalcanzable en un escaneo de direcciones puede existir aún tras un control de acceso o un nombrado de horizonte dividido. Un dominio observado por los tres métodos tiene evidencia más sólida de operación pública, pero ni siquiera eso establece quién lo usó ni por qué.
La oportunidad estratégica no es construir una base de datos universal. Es conectar métodos mediante marcas de tiempo, poblaciones e incertidumbre explícitas. OpenINTEL puede aportar la capa longitudinal de nombres en ese sistema mayor de evidencia. Su valor crece cuando los analistas saben qué preguntas requieren otro instrumento.
La adopción de DNSSEC solo se vuelve legible mediante mediciones repetidas
DNSSEC es un ejemplo útil de por qué importa un archivo diario. Una zona puede publicar material de delegación, los servidores autoritativos pueden servir registros firmados y los validadores pueden decidir si la cadena resultante es segura. Esas etapas no se mueven necesariamente a la vez. Un registro de código de país puede habilitar delegaciones firmadas mientras muchos titulares de dominios siguen sin firmar. Un dominio puede publicar claves, pero fallar la validación porque las firmas expiran o un registro superior es incorrecto.
Un escaneo de un día puede contar estados; no puede mostrar cómo los operadores entraron, salieron o los repararon.
OpenINTEL puede seguir la aparición y desaparición de registros relevantes en una población definida. Los investigadores pueden separar dominios que permanecen sin firmar de los que se configuran intermitentemente, identificar cambios en torno a transiciones de algoritmos o claves y medir cuánto persisten los estados rotos. El método repetido convierte un porcentaje de adopción en un conjunto de trayectorias operativas.
La interpretación sigue dependiendo del diseño de medición. Ver registros DNSKEY o DS no es idéntico a realizar cada paso de validación exactamente como lo haría el resolutor recursivo de un usuario. Las respuestas pueden diferir según el punto de observación, y un dominio puede estar firmado mientras su aplicación sigue sin estar disponible. Un proyecto que estudie DNSSEC debe indicar qué registros, lógica de validación y categorías de error usó. Las comparaciones entre años deben tener en cuenta el crecimiento de las listas y los cambios de software.
Esos matices hacen el resultado más útil, no menos. Los debates sobre estándares suelen apoyarse en cifras de adopción llamativas que ocultan el coste del mantenimiento. Los datos longitudinales pueden mostrar si un cambio produce una configuración duradera, una ráfaga de experimentación o un patrón de fallos recurrente. Pueden distinguir un despliegue lento de uno que llegó a una meseta porque la población restante tiene incentivos distintos.
La misma lógica se aplica a los registros IPv6, la seguridad del correo y otras prácticas de infraestructura. Una tecnología no está desplegada solo porque un registro apareció una vez. Se convierte en infraestructura cuando la configuración persiste, los fallos se reparan y los sistemas dependientes se comportan de forma coherente. El archivo de OpenINTEL puede revelar esas transiciones porque conserva suficiente evidencia diaria para separar un evento de un hábito.
Para los operadores, esa historia puede resultar incómoda. Un registro largo hace visible una mala configuración repetida. También puede establecer que un problema se corrigió antes de un incidente o una intervención política. La medición no asigna intención, pero cambia la calidad del argumento. El debate pasa del recuerdo a la evidencia fechada.
La concentración de proveedores aparece en patrones, mientras la causalidad queda fuera del conjunto de datos
El DNS puede exponer dónde se concentra la infraestructura. Muchos dominios pueden delegar al mismo proveedor autoritativo, apuntar su correo al mismo servicio o resolver nombres web en espacio de direcciones asociado a un pequeño conjunto de plataformas. Seguir esas relaciones a lo largo del tiempo puede mostrar consolidación, migración y dependencia que serían difíciles de reconstruir después de un cambio de mercado.
OpenINTEL es adecuado para la parte descriptiva de este trabajo. Los registros repetidos pueden revelar que los dominios de servidores de nombres de un proveedor aparecen en una proporción creciente de una población medida, que una adquisición va seguida de un cambio en los patrones de nombres o que los dominios se marchan tras una interrupción. El enriquecimiento con direcciones y sistemas autónomos puede conectar nombres con infraestructura de red, sujeto a la exactitud y temporalidad de los datos de enrutamiento.
El archivo no puede explicar todos los motivos de una migración. Un dominio puede usar un proveedor por precio, rendimiento, seguridad, un paquete del registrador o una fusión organizativa. Una marca compartida de servidores de nombres puede ocultar varias infraestructuras independientes. Una gran plataforma puede usar muchos sistemas autónomos, mientras que un sistema autónomo puede alojar clientes no relacionados. Los datos DNS respaldan una medida de concentración; no prueban poder de mercado ni satisfacción del cliente.
La consecuencia política es directa. Un regulador puede verse tentado a tratar una cuota medida alta como evidencia de control perjudicial. Un operador puede tratar la misma cuota como evidencia de que un servicio se ha ganado la confianza. El conjunto de datos puede establecer el patrón y la fecha. Las conclusiones económicas y jurídicas requieren contratos, registros de propiedad, evidencia de interrupciones y costes de cambio para el usuario.
La medición longitudinal aporta dos perspectivas que una instantánea de mercado pierde. Primero, puede mostrar la velocidad de la concentración. Un movimiento lento de una década tiene causas y remedios distintos de un cambio repentino causado por la retirada de un producto. Segundo, puede mostrar la reversibilidad. Si los dominios cambian de proveedor con frecuencia, un mercado concentrado puede tener aún movilidad práctica. Si las delegaciones persisten pese a fallos repetidos, la dependencia puede ser más profunda de lo que sugiere la cuota principal.
La historia también puede revelar riesgo oculto de modo común. Las organizaciones pueden creer que usan alojamientos de aplicaciones diversos mientras delegan DNS, correo y certificados a través de la misma familia de proveedores. Un fallo en esa capa compartida puede afectar a sistemas por lo demás separados. OpenINTEL no modela toda la cadena de dependencia, pero puede aportar la evidencia de nombres a partir de la cual comienza un mapa más completo.
El uso más responsable del archivo es, por tanto, tratar la concentración como una estructura observada y luego investigar el mecanismo. Una plataforma de medición debe hacer visible la dependencia sin fingir que una lista de registros contiene toda la economía política de Internet.
Certificados, registros de correo y nombres pueden combinarse sin convertirse en un solo sistema
El DNS no opera de forma aislada. Los registros de Transparencia de Certificados exponen nombres presentados para certificados públicos. Los registros de correo identifican infraestructura de intercambio y políticas. Los registros de dirección apuntan hacia redes de alojamiento. Los nombres inversos pueden dar pistas administrativas. Los productos de fuentes y las consultas repetidas de OpenINTEL permiten examinar cómo se alinean esos sistemas a lo largo del tiempo.
Los nombres derivados de certificados amplían la población observable más allá de los dominios principales disponibles en una lista de zona. Pueden revelar subdominios de servicio y nombres temporales que importan para la investigación de PKI. La fuente es selectiva: favorece certificados registrados públicamente e incluye nombres que quizá nunca sirvieron tráfico. Un certificado puede permanecer en un registro después de que el servicio asociado desaparezca. La medición activa del DNS añade una observación de configuración actual, no una prueba de que el certificado esté instalado o sea de confianza para un navegador.
Los registros de correo crean un mapa distinto. Los objetivos MX y los registros TXT relacionados pueden mostrar el movimiento hacia proveedores de correo alojado, la adopción de políticas de autenticación y errores de configuración. Observaciones repetidas pueden identificar si una política se mantuvo o se probó brevemente. No muestran el volumen de mensajes, el éxito de la entrega ni cómo aplicaron la política los sistemas receptores.
Los registros de infraestructura también pueden apoyar la reconstrucción de incidentes. Si un dominio cambió servidores de nombres, servidores de correo y direcciones en un período corto, los investigadores obtienen una línea de tiempo. La secuencia puede reflejar una migración legítima, una recuperación tras un compromiso o una apropiación. La historia del DNS reduce las preguntas; no etiqueta el evento.
El valor proviene de combinar evidencia preservando su origen. Un registro de certificados, una zona, una respuesta activa y una tabla de enrutamiento tienen tiempos y autoridades distintos. Combinarlos en un análisis puede revelar una relación, pero la conclusión solo es tan sólida como la unión más débil. Un nombre reutilizado por varios servicios, una dirección tras una plataforma compartida o un certificado obsoleto pueden crear una asociación falsa.
El papel de OpenINTEL es más fuerte cuando mantiene estos conjuntos de datos distinguibles. Los investigadores deben poder decir que un nombre entró en la lista de objetivos a través de un registro de certificados, devolvió un registro concreto durante la medición activa y se asignó a un prefijo de red bajo una vista de enrutamiento fechada por separado. Esa frase es menos dramática que decir que la plataforma «conoce Internet», pero es reproducible.
Esta disciplina multifuente es también una defensa contra la certeza retrospectiva. Después de un incidente, los analistas buscan de forma natural una historia en los datos. Un rastro de medición versionado obliga a que la historia respete lo que era observable en ese momento. Puede mostrar que dos eventos estuvieron correlacionados sin afirmar que uno causó el otro.
Las clasificaciones de prefijos extienden el archivo de los nombres hacia las redes
Las listas temporales de prefijos principales del proyecto ilustran cómo OpenINTEL puede producir productos derivados y no solo respuestas DNS brutas. Una clasificación de prefijos agrega evidencia a nivel de red y sigue cómo cambia la prominencia con el tiempo. Esto puede ayudar a los investigadores a seleccionar redes representativas, estudiar la concentración de infraestructura o comparar objetivos de medición sin reconstruir las mismas uniones para cada artículo.
Un prefijo no es una organización. Los anuncios de enrutamiento pueden cambiar, el espacio de direcciones puede arrendarse y una red puede alojar muchos servicios no relacionados. Las clasificaciones dependen de los nombres y tipos de registro incluidos, la fecha de los datos de enrutamiento y la métrica usada para contar prominencia. Una posición alta puede significar alojamiento amplio, infraestructura compartida o un efecto de selección de listas.
El diseño temporal es la parte útil. Una lista estática queda obsoleta rápidamente a medida que los servicios se mueven y el enrutamiento cambia. Las clasificaciones repetidas pueden mostrar cuándo una red entra o sale de una posición prominente y permiten a los investigadores reproducir una población apropiada para una fecha anterior. También exponen inestabilidades que una única lista de «redes principales» ocultaría.
Los conjuntos de datos derivados reducen el coste de la investigación. Pueden hacer que un análisis sofisticado de infraestructura esté disponible para equipos sin el almacenamiento ni el cómputo necesarios para procesar el archivo completo. Ese beneficio aumenta la responsabilidad del proyecto de publicar metodología y versionado. Los usuarios pueden tratar una clasificación conveniente como verdad objetiva cuando es una vista producida a partir de insumos seleccionados.
La expansión hacia productos a nivel de red no convierte a OpenINTEL en un observatorio de enrutamiento ni en un RIR. Usa contexto público de registros y enrutamiento para enriquecer observaciones DNS. La validez de rutas, las disputas de propiedad y el rendimiento operativo siguen siendo preguntas separadas.
Este límite es estratégicamente sano. El proyecto puede ofrecer evidencia derivada común sin reclamar autoridad sobre las entidades que clasifica. El producto es más valioso cuando ahorra trabajo computacional y deja visible el juicio analítico.
La investigación de seguridad obtiene una línea de tiempo, no un veredicto de maldad
Los datos históricos del DNS atraen a los equipos de seguridad porque la infraestructura de abuso a menudo se mueve. Un dominio puede rotar direcciones, servidores de nombres o sistemas de correo; una campaña puede reutilizar proveedores; un incidente puede descubrirse después de que la configuración relevante haya cambiado. OpenINTEL puede suministrar observaciones fechadas que hacen recuperables esas transiciones.
Esa evidencia es especialmente útil para delimitar. Los investigadores pueden preguntar cuándo apareció por primera vez un dominio sospechoso en una lista medida, si su servicio autoritativo cambió en torno a un evento y qué otros nombres compartían la misma infraestructura en ese momento. Un investigador de seguridad puede usar esas relaciones para generar hipótesis y elegir qué sistemas requieren un examen más detenido.
Ninguno de los registros establece maldad por sí solo. Los cambios rápidos pueden ser señal de evasión, pero también ocurren en redes de entrega de contenidos, recuperación ante desastres y migraciones legítimas. El alojamiento compartido coloca dominios benignos y dañinos en la misma dirección. Una asociación de servidores de nombres puede reflejar un valor predeterminado del registrador y no un control común. Incluso un patrón que se parece mucho a una campaña conocida necesita corroboración con contenido, registro, malware, telemetría o evidencia legal.
Esa distinción importa porque los conjuntos de datos históricos pueden hacer que las asociaciones parezcan más duraderas de lo que fueron. Un dominio que compartió una dirección durante un día puede quedar agrupado con otro durante años en una base de datos derivada de un analista. Las ventanas temporales y la confianza deben viajar con la relación. También la población fuente: un subdominio derivado de un certificado y un nombre principal de una zona de registro no entraron en el archivo de la misma forma.
El papel de OpenINTEL es preservar los hechos de infraestructura que de otro modo podrían desaparecer. Etiquetar, atribuir y responder pertenecen a procesos separados. El trabajo de seguridad es más fuerte cuando el archivo reduce la incertidumbre sin que se le pida resolver la intención.
El archivo hace impugnable el cambio de infraestructura
Cada día de medición añade valor operativo y obligación de almacenamiento. El proyecto debe mantener la capacidad de consulta, sustituir hardware, migrar bases de datos y conservar especialistas que entiendan tanto el DNS como la historia del sistema. Ninguna de esas tareas está asegurada solo porque el archivo se haya vuelto importante.
El modelo de cuatro socios reparte el riesgo, pero también hace más difícil leer la sostenibilidad desde fuera. Una institución puede financiar personal, otra cómputo y otra el acceso a datos fuente. Un cambio en cualquier componente puede reducir la cobertura sin un anuncio corporativo convencional. No hay cuentas financieras públicas del proyecto en su conjunto, por lo que los usuarios deben observar señales técnicas e institucionales en lugar de asumir la continuidad.
La custodia del archivo exige redundancia más allá de las copias de seguridad. Una copia replicada debe incluir esquemas, registros de métodos, versiones de listas de fuentes y el conocimiento necesario para interpretar anomalías. Un montón de archivos en otro sitio no es un instrumento histórico en funcionamiento. La colaboración con organizaciones como CAIDA puede mejorar la resiliencia y la comparación metodológica, aunque los datos contractuales pueden limitar lo que puede copiarse.
El modelo de licencias también configura el futuro. El acceso abierto no comercial apoya la reutilización académica, pero restringe algunas aplicaciones comerciales. Los datos de zona controlados no pueden publicarse simplemente bajo una licencia más amplia. Los socios pueden necesitar acuerdos de financiación que preserven el acceso a la investigación y recuperen el coste real de almacenamiento y soporte. Una vía comercial, si se desarrolla, no debería estrechar silenciosamente el registro público sobre el que descansa la legitimidad del proyecto.
El éxito puede crear fragilidad por sí mismo. A medida que más artículos y afirmaciones políticas dependen de OpenINTEL, un período faltante o un conjunto de datos cambiado afecta a una comunidad más amplia. El proyecto puede necesitar registros de publicación, expectativas de servicio y políticas de preservación más formales de lo que suele publicar un sistema de investigación. No son señales de que deba convertirse en una empresa. Son señales de que se ha convertido en infraestructura.
El hito futuro más valioso puede ser uno que no produzca titulares: una migración transparente a un nuevo almacenamiento con los resultados, advertencias y vías de acceso antiguos intactos. OpenINTEL ya ha demostrado que puede medir a una escala extraordinaria. La prueba más difícil es si las organizaciones que lo respaldan pueden preservar las condiciones que hacen comparables diez años de mediciones con los diez siguientes.
OpenINTEL no puede contar toda la historia del DNS. Puede mostrar que un nombre definido devolvió una respuesta definida desde su punto de observación en una fecha, y puede repetir esa observación en poblaciones enormes. Eso basta para transformar muchas afirmaciones.
Un proveedor puede decir que la adopción de DNSSEC aumentó; el archivo puede mostrar la transición y la población medidas. Un investigador puede afirmar que el alojamiento autoritativo se concentró; los datos pueden revelar qué listas y períodos lo respaldan. Un investigador de incidentes puede reconstruir cuándo cambió un registro. Otro analista puede impugnar la metodología en lugar de aceptar una captura de pantalla.
La escala del proyecto es llamativa: cientos de millones de dominios, miles de millones de puntos diarios y billones de observaciones acumuladas según sus propias métricas actuales. El logro más importante es la continuidad a través del cambio institucional y técnico. El archivo convierte el pasado del DNS en evidencia disponible y no en memoria.
Esa evidencia sigue delimitada por listas, contratos, puntos de observación y métodos. La credibilidad de OpenINTEL proviene de preservar esos límites. Llamarlo una copia completa del DNS exageraría el proyecto y debilitaría la utilidad de su registro real.
Un observatorio histórico no necesita verlo todo. Necesita decir qué vio, preservar las condiciones y seguir disponible el tiempo suficiente para que el cambio pueda medirse. OpenINTEL ha construido ese tipo de instrumento para la infraestructura de nombres. Su próximo desafío es asegurar que el archivo y las instituciones que hay detrás sean tan duraderos como las tendencias que los investigadores esperan estudiar.
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance