
Resumen
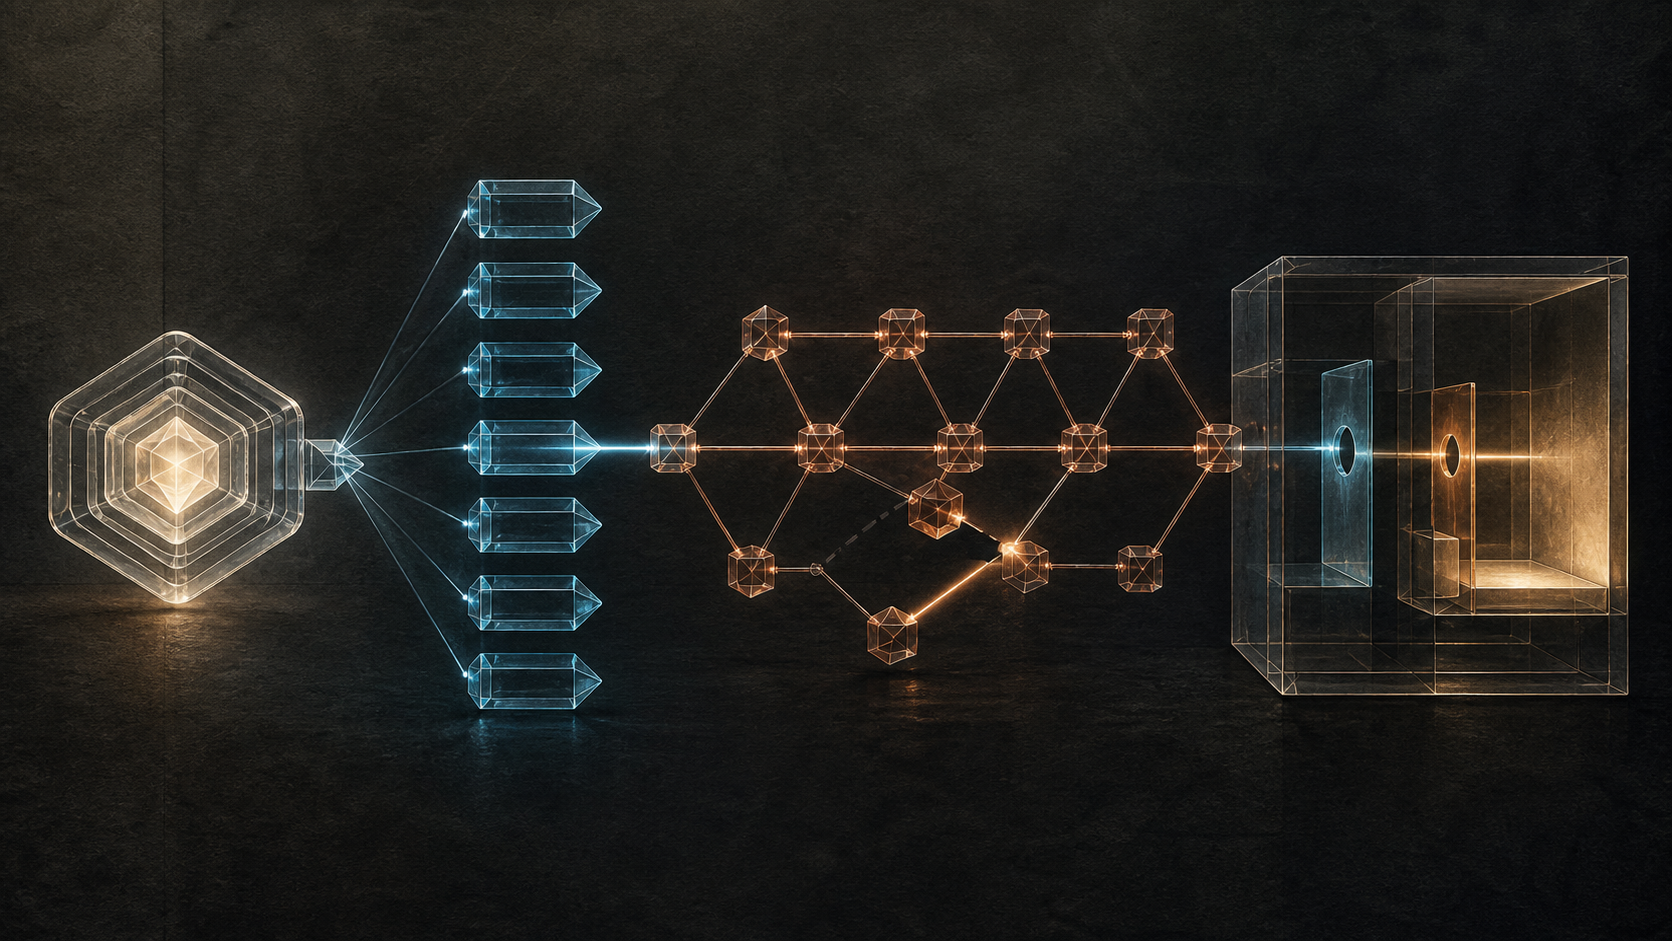
- RFC 814 no definió una única «dirección de destino». Describió traducciones distintas del nombre a la dirección, de la dirección a la ruta y del nombre de servicio al puerto de un protocolo de transporte.
- Las tablas completas no podían escalar. La propuesta combinó responsabilidad distribuida, cachés limitadas por la actividad real e interfaces de software que podían sustituirse sin reescribir las aplicaciones.
- La separación también limitó la autoridad de cada dato: resolver un nombre no demostraba alcance, elegir una ruta no identificaba el proceso y observar un puerto registrado no autenticaba el tráfico.
El tamaño correcto dependía del trabajo activo
En julio de 1982, David D. Clark podía describir una Internet de unas 25 redes activas y unos pocos cientos de hosts. Aun así, pidió diseñar para miles de redes y decenas de miles de máquinas. El dato decisivo no era el máximo previsto, sino la relación entre ese máximo y lo que un host usaba en cada momento.
Una tabla universal obligaba a cada máquina a recibir nombres que nunca consultaría y rutas que nunca recorrería. También la hacía depender del ritmo de cambio de todos los demás. RFC 814 propuso almacenar un subconjunto: nombres consultados recientemente y rutas para destinos activos. Un equipo pequeño podía mantener una sola entrada útil; un sistema multiusuario, muchas más. Ambos hablaban el mismo Internet sin cargar la misma imagen del mundo.
Esa idea convertía el límite local en una decisión legítima. La interoperabilidad exigía saber preguntar y entender la respuesta, no copiar toda la base global dentro de cada host.
El nombre conservaba la pregunta
Los nombres visibles identificaban redes, hosts y servicios. Una función los traducía a direcciones de 32 bits. Pero RFC 814 conocía el daño de una traducción antigua: después de mover un host, una copia no actualizada de la tabla del NIC podía dirigir correo en cola hacia la máquina que ocupase la dirección anterior.
La red podía entregar correctamente al lugar equivocado. Por eso el documento recomendó que el acceso a la tabla quedara detrás de una subrutina. Cuando los servidores de nombres distribuidos estuvieran disponibles, esa implementación local podría sustituirse sin sembrar cambios por cada programa. El nombre mantenía estable la pregunta aunque cambiara quién y cómo producía la dirección.
La caché introducía una obligación: registrar la procedencia y la edad de la respuesta. RFC 814 exploró consultar a la dirección remota por el nombre que decía tener. No era autenticación criptográfica; era el reconocimiento temprano de que una relación antigua no se vuelve verdadera por estar almacenada.
DNS separó la sintaxis de la topología
RFC 819, publicado un mes después, planteó una jerarquía de dominios dependiente de la administración y no estrictamente de la topología. La autoridad de nombres podía distribuirse por dominios sin convertir cada componente del nombre en un segmento de red.
RFC 1034 llevó esa idea al DNS de producción. Su espacio de nombres debía ser consistente, distribuido y capaz de asociar datos de diferentes tipos con una referencia. Expresamente evitó exigir que los nombres contuvieran identificadores de red, direcciones o rutas.
Así, una dirección era una respuesta tipada acerca de un nombre. Podía cambiar, coexistir con otras o caducar en una caché. El nombre podía permanecer. Sin embargo, permanecer no equivalía a estar autenticado, bien delegado o disponible. La arquitectura separaba estados; no declaraba infalible a ninguno.
La dirección abría el problema de la ruta
IP debía decidir si el destino estaba en la red conectada o necesitaba una puerta de enlace. Las primeras tablas estáticas, imaginadas para 256 números de red, fallaban cuando una puerta se movía, caía o dejaba de ser la mejor salida.
RFC 814 recomendó una caché de rutas. Si faltaba una entrada, el host podía enviar por una puerta accesible. Un ICMP Redirect podía señalar un siguiente salto mejor y corregir la decisión local. Ese aprendizaje pertenecía al destino operativo, no al nombre humano.
El descubrimiento inicial de puertas no se centralizó. Una red podía admitir difusión, otra ofrecer un mecanismo propio y otra depender de configuración manual. La capa común no escogía un método universal porque las redes conectadas poseían capacidades distintas.
RFC 1122 consolidó después la separación al concentrar la complejidad de encaminamiento en las puertas de enlace y proteger al software de host frente a la evolución del sistema de rutas. Propiedades como MTU o retardo podían acompañar una entrada de caché. Eran mediciones del camino observado, no atributos permanentes del nombre.
El puerto terminaba la entrega dentro del host
La dirección sólo llevaba el datagrama hasta la máquina. IP lo entregaba a TCP, UDP u otro protocolo. Ese protocolo utilizaba puertos para seleccionar proceso o conexión. RFC 814 permitió atajos de implementación, pero no convirtió el puerto en parte obligatoria de IP.
La decisión conservaba libertad para futuros transportes con otros tamaños o reglas. También mantenía las asignaciones de servicios dentro de cada protocolo y evitaba que las puertas de enlace necesitaran comprender la semántica de aplicaciones.
El texto estudió una alternativa de rendezvous: enviar un descriptor textual a un servidor que eligiera un puerto para la instancia. Funcionaba bien para un establecimiento previo. Para un único datagrama UDP añadía un viaje, un intermediario y más cabecera. La arquitectura dejó esa elección al protocolo superior.
El registro actual de IANA mantiene nombres de servicio y puertos por transporte. Su advertencia impide confundir coordinación con confianza: la asignación no respalda un producto y el tráfico visto en ese puerto puede no corresponder al servicio registrado.
La dirección de 32 bits era un compromiso de entrega
Un circuito virtual podía enviar una dirección extensa una vez y usar después un identificador corto. El datagrama de Internet debía poder viajar sin negociación previa; por eso llevaba la dirección en cada paquete. RFC 814 presentó 32 bits como el compromiso entre alcance y coste de cabecera.
No era una predicción de CIDR, NAT, IPv6 ni del valor económico actual de IPv4. Era una delimitación funcional. La dirección resolvía una necesidad compacta de entrega. Convertirla en el nombre humano habría hecho que cada cambio de topología obligara a reconstruir la referencia.
La cadena de evidencia evitaba falsos éxitos
Una operación moderna debería poder reconstruir el nombre pedido, la respuesta y su vigencia; las direcciones devueltas; la interfaz, el siguiente salto y la versión de ruta; el protocolo y los puertos; y la decisión final de la aplicación.
Esos registros permiten afirmar cosas distintas. «El nombre resolvió» no significa «había ruta». «El paquete llegó» no significa «era el servicio previsto». «El puerto respondió» no significa «el proceso estaba autenticado». «La aplicación aceptó identidad» tampoco prueba que completara la operación.
RFC 814 hizo visible una disciplina que la interfaz suele ocultar. Nombre, dirección, ruta y puerto no eran pasos redundantes, sino contratos cambiantes. El sistema podía crecer porque cada host guardaba sólo lo necesario y cada capa respondía por su propia traducción.
Fuentes
Informe para miembros
Contexto ampliado del perfil
Inicia sesión con el nivel de membresía adecuado para desbloquear el informe completo y las notas de las fuentes.
Solo para Strategic Circle
Strategic Circle
Abierto a todos los lectores. Desbloquea informes de perfil después de unirte e iniciar sesión.
Únete a Strategic CircleSolo para Leadership Alliance
Leadership Alliance
Para propietarios y directivos cualificados de activos de propiedad intelectual; inicia sesión para desbloquear los informes de la alianza.
Unirse a Leadership Alliance