
Zusammenfassung
- Slurm vergibt Knoten, CPUs, Speicher, GPUs und weitere Ressourcen und übersetzt Partitionen, Prioritäten, Quality-of-Service-Regeln, Fair-Share und Reservierungen in Warteschlangenentscheidungen.
- TRES, GRES, Topologie und cgroups ermöglichen es Betreibern, Beschleuniger als begrenzte physische Ressourcen einzuplanen; eine bloße GPU-Anzahl garantiert weder eine sinnvolle Platzierung noch eine effiziente Ausführung.
- Die Slurm-Entwickler gründeten SchedMD im Jahr 2010, um kommerzielle Entwicklung, Support und Schulungen anzubieten; NVIDIA übernahm das Unternehmen am 15. Dezember 2025 und sicherte die weitere quelloffene, anbieterneutrale Entwicklung zu.
- Die Glaubwürdigkeit nach der Übernahme wird von Multi-Vendor-Tests, dem Release-Verhalten und den Beitragsmustern abhängen, während jeder Cluster-Betreiber für die Richtlinie verantwortlich bleibt, die seine Nutzer tatsächlich erfahren.
Eine untätige GPU ist nicht unbedingt eine verfügbare GPU
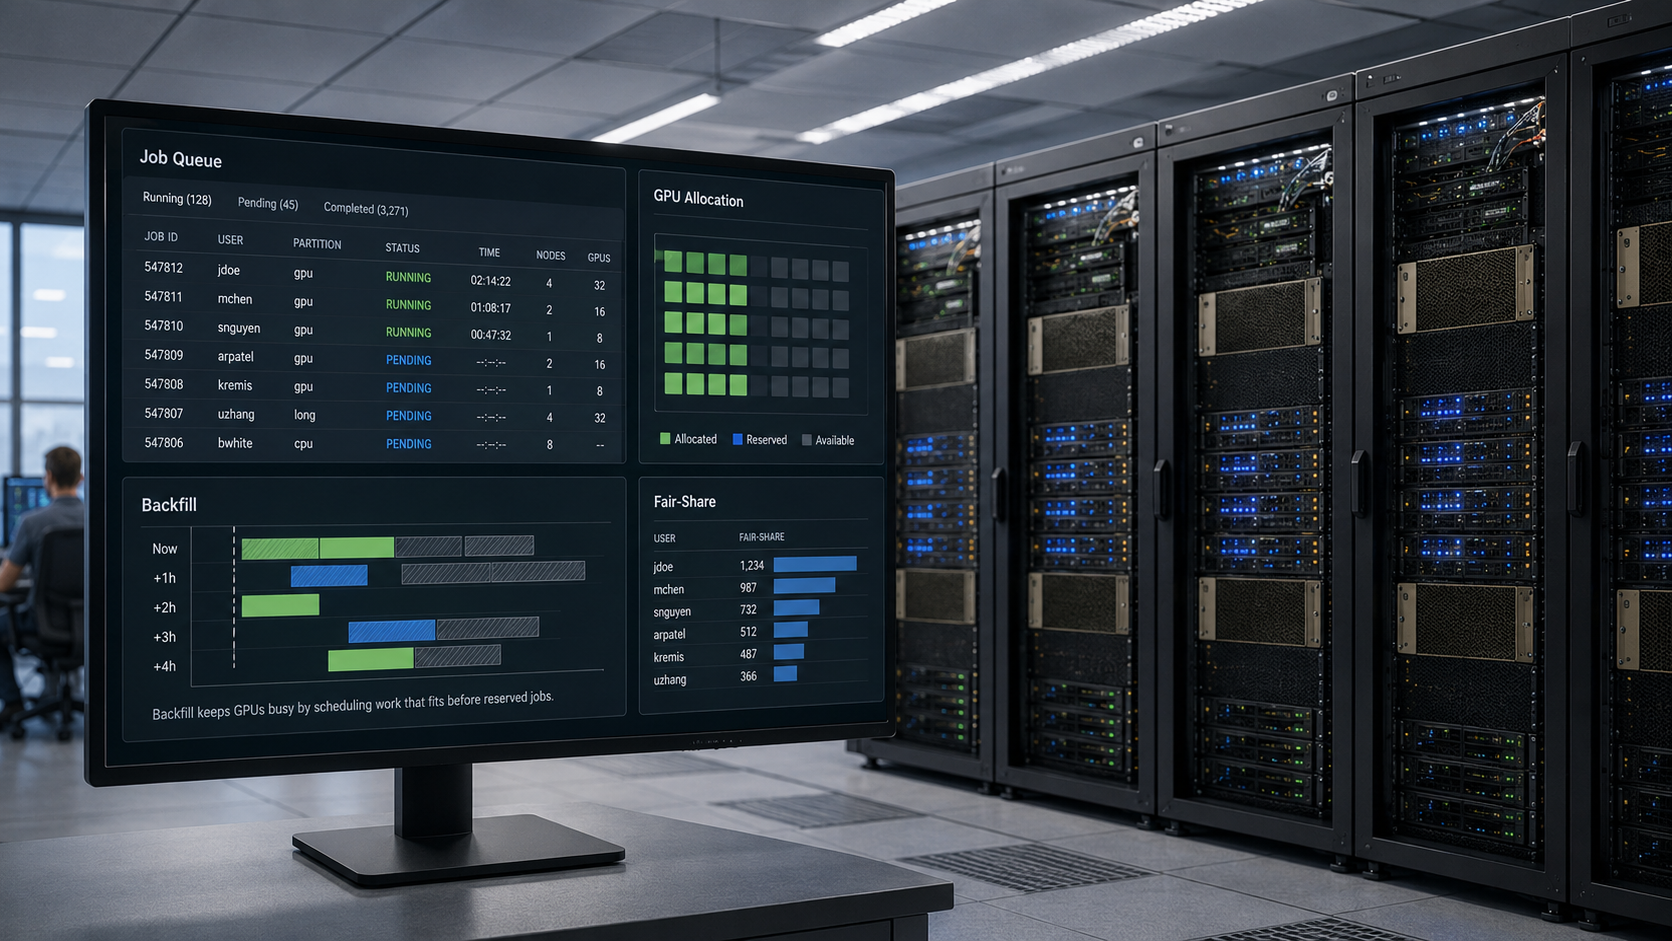
Ein physisch untätiger Beschleuniger geht in einem Slurm-Cluster nicht automatisch an die nächste Person, die einen anfordert. Ein Auftrag muss zunächst für eine Partition zulässig sein, zur angeforderten Ressourcenform passen, Konto- und Quality-of-Service-Regeln erfüllen, Reservierungen ausweichen, die die benötigten Knoten blockieren, und konkurrierende Arbeiten übertreffen. Erst dann vergibt der Scheduler Ressourcen und lässt den Auftrag starten.
Diese Abfolge macht Slurm zu mehr als einer Warteschlange. Es ist eine Zulassungs- und Zuteilungs-Kontrollebene für eine große Klasse von Hochleistungsrechner- und KI-Systemen. Nutzer übermitteln Aufträge;slurmctldbewertet sie anhand des Clusterzustands und der Richtlinien;slurmd-Prozesse auf den Rechenknoten starten und überwachen Arbeiten;slurmstepdverwaltet einzelne Auftragsschritte. Ein optionalerslurmdbd-Dienst erfasst Aufträge, Ressourcennutzung und Kontobeziehungen in einer Datenbank.
Die Folge ist sowohl wirtschaftlich als auch technisch. Ein KI-Cluster kann insgesamt genug GPUs haben und trotzdem keinen großen Trainingsauftrag starten, weil die freien Geräte über die falschen Knoten verstreut sind, hinter ungeeigneter Topologie liegen oder für ein anderes Projekt reserviert sind. Ein Scheduler kann diese Verschwendung reduzieren, indem er die relevanten Einschränkungen abbildet. Er kann fehlende GPUs nicht erschaffen, ein überlastetes Netz nicht reparieren oder eine ineffiziente Anwendung nützlich machen.
Die Bedeutung von Slurm ergibt sich daher aus den Entscheidungen, die es trifft, bevor die Anwendung läuft. Das Projekt hat mehr als zwei Jahrzehnte damit verbracht, eine einfache Frage – wer darf jetzt welche Maschine nutzen? – in ein konfigurierbares System zur Zuteilung zunehmend heterogener und teurer Infrastruktur zu verwandeln.
Slurm verwandelt lokale Richtlinien in Maschinenzeit
Slurm entstand in einer vom Lawrence Livermore National Laboratory geführten Zusammenarbeit und erschien erstmals 2002. Seine frühe Aufgabe war es, unabhängig eingereichte parallele Arbeiten über große Linux-Cluster hinweg zu koordinieren, ohne dass jede Anwendung die gesamte Maschine verstehen musste. Die ursprüngliche Architektur trennte Ressourcenzuteilung von Auftragsausführung und stellte eine gemeinsame Kontrolle bereit, die institutionsübergreifend angepasst werden konnte.
Diese grundlegende Trennung ist weiterhin sichtbar. Der Controller hält eine zentrale Sicht auf Knoten, Aufträge und Scheduling-Zustand, während Dienste auf den Rechenknoten die bereits autorisierten Arbeiten ausführen. Ein Backup-Controller und ein persistierter Zustand können die Auswirkungen eines Controller-Ausfalls verringern, doch Hochverfügbarkeit hängt weiterhin von kohärentem Zustand, funktionierender Authentifizierung, Netzerreichbarkeit und getesteten Wiederherstellungsverfahren ab. „Fault tolerant“ ist eine Designfähigkeit, keine Garantie, dass jeder Ausfall der Kontrollebene folgenlos bleibt.
Die tiefgreifendere Veränderung kam, als Slurm immer mehr Richtlinien-Primitive ansammelte. Partitionen gruppieren Knoten in Dienstklassen oder administrative Pools. Assoziationen verbinden Nutzer und Konten mit Anteilen, Limits und historischer Nutzung. Quality-of-Service-Regeln können Priorität, Limits oder Preemption-Verhalten verändern. Reservierungen halten Ressourcen für Wartung, Veranstaltungen oder benannte Nutzer frei. Die mehrfaktorielle Priorität kann Alter, Fair-Share, Auftragsgröße, Partition, QOS und standortdefinierte Faktoren kombinieren.
Es gibt keine universelle Slurm-Definition von Fairness. Eine Universität kann Projekte bevorzugen, die weniger als ihre langfristige Zuteilung verbraucht haben. Ein nationales Labor kann Kapazität für eine Kampagne reservieren. Ein kommerzieller GPU-Betreiber kann differenzierte Dienststufen schaffen. Dieselbe Software kann alle drei ausdrücken, weil der Standort die Richtlinie festlegt.
Diese Flexibilität ist eine der Stärken von Slurm und eines seiner operativen Risiken. Eine Warteschlange kann schwer zu erklären werden, wenn Partitionen sich überlappen, Ausnahmen sich anhäufen und mehrere Gewichtungssysteme zusammenwirken. Nutzer erleben das Ergebnis dann als willkürlich, auch wenn die Software die Konfiguration exakt umsetzt. Der Scheduler kann die Priorität berechnen; die Institution muss die Richtlinie dennoch rechtfertigen.
Fair-Share bestimmt, wer wartet – nicht, was Fairness bedeutet
Fair-Share wird oft so diskutiert, als wäre es eine objektive Eigenschaft des Schedulers. In der Praxis ist es ein Mechanismus, um die Zuteilungsentscheidungen einer Institution über die Zeit zu tragen. Historische Nutzung, Kontenhierarchie und konfigurierte Anteile können die künftige Priorität so beeinflussen, dass eine Gruppe, die weniger als ihren Anspruch verbraucht hat, einen Vorteil gegenüber einer Gruppe erhält, die mehr verbraucht hat.
Das macht die Abrechnung zu einem Teil der Governance.slurmdbdkann Aufträge, Schritte, Assoziationen und nachverfolgbare Ressourcen über einen oder mehrere Cluster erfassen. Administratoren nutzen diese Aufzeichnungen für Berichte, Kostenverrechnung, Nutzungslimits und Fair-Share-Berechnungen. Ein Datenbankfeld, das administrativ aussieht, kann daher beeinflussen, wann ein Forschungsteam oder ein Ingenieurteam als Nächstes knappe Rechenleistung erhält.
Die Qualität des Kontobuchs ist entscheidend. Wenn Nutzer dem falschen Konto zugeordnet werden, Ressourcennutzung nicht konsistent erfasst oder historische Daten falsch aufbewahrt werden, kann die resultierende Priorität technisch gültig und institutionell falsch sein. Änderungen bei der Projektmitgliedschaft, gemeinsame Servicekonten und manuell korrigierte Aufzeichnungen benötigen alle Governance, weil der Scheduler sie als Belege für einen Anspruch behandeln kann.
Das ist ein Grund, warum sich Warteschlangenstreitigkeiten nur schwer auf einen Softwarefehler reduzieren lassen. Eine lange Wartezeit kann durch Nachfrage, ungenaue Wanduhrzeit-Anforderungen, eine Reservierung, einen niedrigen Fair-Share-Faktor, eine Topologieanforderung, eine QOS-Regel oder einfach durch einen Auftrag verursacht werden, der nicht in die aktuell freien Ressourcen passt. Slurm legt die Mechanismen offen, aber der Betreiber braucht genügend Beobachtbarkeit, um zu rekonstruieren, welche davon ausschlaggebend war.
Für Nutzer ist die Erklärbarkeit daher Teil der Servicequalität. Eine Warteschlange ist leichter zu akzeptieren, wenn Menschen sehen können, warum ein Auftrag wartet, welche Richtlinie gilt und was ihn starten lassen würde. Je teurer und kommerziell wichtiger Cluster werden, desto mehr wird diese Transparenz zu einer Managementfrage statt zu einer Bequemlichkeit für Forscher.
Backfill macht aus leeren Lücken nutzbare Arbeit
Eine strikte Prioritätswarteschlange kann Kapazität verschwenden. Ein großer Auftrag mit hoher Priorität mag an erster Stelle stehen, kann aber erst starten, wenn genügend Knoten frei werden. Ohne zusätzliche Logik müssten auch kleinere Aufträge, die vor dieser Reservierung fertig werden könnten, warten – Ressourcen blieben ungenutzt.
Slurms Backfill-Scheduler löst dieses Problem, indem er abschätzt, wann Aufträge höherer Priorität beginnen können, und dann Arbeiten niedrigerer Priorität startet, die ohne Verzögerung für die anderen fertig werden sollten. Der Scheduler fragt nicht einfach, welcher Auftrag als Nächstes kommt. Er fragt, ob ein Auftrag eine vorübergehende Lücke nutzen kann, während der erwartete Start der vor ihm liegenden Arbeit erhalten bleibt.
Der Mechanismus ist mächtig, weil große Cluster häufig fragmentiert sind. Manche Knoten werden früher frei, andere bleiben belegt. Ein kurzer Auftrag kann in die Lücke passen, ohne den Startzeitpunkt des Auftrags zu verändern, den die Institution für wichtiger hält. Backfill kann so die Auslastung verbessern und gleichzeitig Wartezeiten verkürzen.
Seine Wirksamkeit hängt von den Informationen ab, die er erhält. Wenn Nutzer weit mehr Wanduhrzeit anfordern, als sie benötigen, kann der Scheduler zu dem Schluss kommen, dass ein Auftrag nicht sicher hineinpasst. Wenn sie zu wenig anfordern, kann der Auftrag beendet werden, bevor er fertig ist. Topologie- und Beschleunigerbeschränkungen können eine theoretisch verfügbare Lücke unbrauchbar machen. Ausfälle können den erwarteten Zeitplan entwerten.
Backfill veranschaulicht Slurms Betriebsmodell im Kleinen. Die Software kann aus deklariertem Zustand eine ausgefeilte Entscheidung treffen, aber sie kann die Zukunft nicht perfekt kennen. Bessere Warteschlangenergebnisse hängen von genauen Anfragen, zuverlässigem Clusterzustand und Richtlinien ab, die dem Scheduler genug Spielraum für Abwägungen geben.
GPUs machten die Form einer Zuteilung so wichtig wie ihre Größe
Beschleuniger haben verändert, was „verfügbare Kapazität“ bedeutet. Eine Anfrage nach acht CPUs ist bei einem verteilten Trainingsauftrag oft austauschbarer als eine Anfrage nach acht GPUs. Das Beschleunigermodell, die Speicherkapazität, PCIe- oder NVLink-Beziehungen, die Netzposition und die Knotenzusammensetzung können bestimmen, ob die Zuteilung die erwartete Leistung bringt.
Slurm bildet heterogene Ressourcen über Trackable RESources (TRES) und Generic RESources (GRES) ab. GPUs können gezählt, typisiert und Knoten zugeordnet werden. Die Geräte- und cgroup-Integration kann einen Auftrag auf die Beschleuniger beschränken, die ihm zugeteilt wurden. Topologie-Plugins und -Constraints können dem Scheduler helfen, Arbeiten mit einem gewissen Bewusstsein für die physische Maschine zu platzieren.
Das macht die GPU von einem angeschlossenen Peripheriegerät zu einer planbaren wirtschaftlichen Einheit. Administratoren können die Beschleunigernutzung abrechnen, den Zugriff begrenzen, bestimmte Gerätetypen reservieren und Richtlinien um knappe Hardware herum entwerfen. Für KI-Infrastruktur ist das wichtig, weil die Warteschlange oft über den Zugriff auf die teuerste Komponente des Clusters entscheidet.
Ein Ressourcenmodell ist jedoch nur so nützlich wie die Topologie, die es erfasst. Acht freie GPUs, die über Knoten mit ungeeigneten Kommunikationspfaden verstreut sind, müssen nicht acht GPUs in zwei eng verbundenen Servern entsprechen. Ein Scheduler kann auf Basis der konfigurierten Topologie wählen, aber er kann nicht automatisch jede Netz-, Speicher- oder Anwendungsabhängigkeit ableiten.
Dieselbe Grenze gilt für die Auslastung. Ein Dashboard kann zeigen, dass GPUs zugeteilt sind, während der Auftrag auf Speicher, kollektive Kommunikation, Datenladen oder wiederholte Fehler wartet. Slurm kann einem Betreiber sagen, wer die Ressource wann gehalten hat. Es beweist für sich genommen nicht, dass der Beschleuniger produktiv gearbeitet hat.
Der Scheduler sitzt über dem Netz, hängt aber von ihm ab
Slurm liegt nicht im Datenpfad. Sobald ein Auftrag läuft, bewegt sich der Anwendungsverkehr durch Prozessoren, Speicher, Verbindungsnetze und Speichersysteme, ohne den Scheduler zu durchlaufen. Das macht den Scheduler nicht unabhängig von der physischen Infrastruktur.
Platzierungsentscheidungen können Arbeit über Switches, Blöcke oder Beschleunigerdomänen bündeln oder verteilen. Eine topologiebewusste Zuteilung kann die Kommunikationsdistanz für einen parallelen Auftrag verringern. Eine topologieblinde Zuteilung kann aus reichlich Rohkapazität einen Auftrag mit schwacher Leistung machen, weil die nutzbare Bandbreite woanders liegt.
Der Scheduler hängt auch von einem genauen Knotenzustand ab. Eine GPU kann vorhanden, aber nicht gesund sein. Ein Knoten kann für den Controller erreichbar sein, während sein Speicherpfad beeinträchtigt ist. Eine Netzpartition kann einen laufenden Auftrag aus Sicht des Controllers anders erscheinen lassen. Plugins, Knoten-Gesundheitsprüfungen und lokale Abläufe müssen diese physischen Bedingungen in Zustände übersetzen, auf die der Scheduler reagieren kann.
Das schafft eine Grenze, die in Leistungsberichten leicht falsch gelesen wird. Wenn ein Auftrag langsam läuft, kann die Ursache in der Zuteilung, im Anwendungsverhalten, im Speicher, in Netzüberlastung, in der Beschleunigergesundheit oder in einer Kombination liegen. Wenn der Cluster untätig ist, kann die Ursache geringe Nachfrage, Fragmentierung, Reservierungen oder Ausfälle sein – nicht ein schlechter Scheduling-Algorithmus.
Für Betreiber ist das sinnvolle Maß daher der gesamte Weg von der Anfrage bis zur abgeschlossenen Arbeit: Warteschlangenverzögerung, Zuteilungsqualität, Startfolg, Ausführungszeit, Wiederholungen, verlorene Arbeit und endgültiger Abschluss. Die aggregierte GPU-Zuteilung ist informativ, aber nicht dasselbe wie produktive Leistung.
SchedMD machte aus einem offenen Projekt ein Support-Geschäft
Als Slurm über seine Ursprünge im Labor hinauswuchs, brauchten Organisationen mehr als Quellcode. Produktionscluster erforderten planbare Releases, Debugging, Upgrade-Hilfe, Schulungen und Ingenieure, die mit ungewöhnlichen Standortkonfigurationen arbeiten konnten. Die Slurm-Entwickler gründeten SchedMD im Jahr 2010, um diese kommerzielle Ebene bereitzustellen.
Die Regelung schuf einen vertrauten Open-Source-Kompromiss. Der Code blieb unter seiner Projektlizenz offen verfügbar, während Kunden für Fachwissen, Support und Entwicklung rund um schwierige Produktionssysteme zahlten. Kommerzielle Arbeit gab den Maintainern eine Möglichkeit, nachhaltige Entwicklung zu finanzieren, und gab Betreibern eine Eskalationsmöglichkeit, wenn sich die Warteschlange eines großen Clusters unerwartet verhielt.
SchedMD wurde auch zu einem Wissenszentrum. Große Scheduling-Systeme sammeln operatives Detailwissen, das sich aus Dokumentation allein schwer lernen lässt: Fehlerbehebung, Upgrade-Reihenfolge, Plugin-Interaktionen, Abrechnungs-Sonderfälle und die Auswirkungen ungewöhnlicher Richtlinien. Ein Unternehmen, das zentrale Maintainer beschäftigt, kann diese Erfahrung in einen Support-Vorteil verwandeln, ohne jeden Beitrag oder jede Bereitstellung zu besitzen.
Diese Unterscheidung ist wichtig, weil Slurm-Richtlinien immer lokal geblieben sind. SchedMD konnte Code, Patches und Anleitungen liefern; es entschied nicht über Fair-Share-Gewichte, Reservierungen oder Kontoansprüche in einer Universität, einem nationalen Labor oder einem kommerziellen KI-Dienst. Die Nutzererfahrung von Slurm ist teils Upstream-Software und teils die eigene Verfassung der Institution.
Als KI den Wert geplanter GPU-Kapazität erhöhte, war die Rolle von SchedMD daher größer als die eines herkömmlichen Softwareanbieters. Es war der wichtigste kommerzielle Verwalter einer offenen Kontrollebene, die viele Betreiber bereits in ihre Arbeitsabläufe, Skripte, Abrechnungssysteme und Betriebsverfahren eingebettet hatten.
NVIDIA veränderte die Anreize rund um die Verantwortung
NVIDIA kündigte die Übernahme von SchedMD am 15. Dezember 2025 an. Es hieß, Slurm werde quelloffen und anbieterneutral bleiben, während die Entwickler von SchedMD Zugang zu mehr Beschleunigersystemen und Ingenieursressourcen erhalten sollten. Die Lizenz wurde nicht plötzlich proprietär, und die Übernahme übertrug die lokale Scheduling-Richtlinie nicht von den Betreibern auf NVIDIA.
Was sich änderte, war die Anreizstruktur um den wichtigsten kommerziellen Verwalter des Projekts. NVIDIA ist nicht nur ein Softwareunternehmen, das Maintainer finanziert. Es ist auch ein führender Anbieter von GPUs, Vernetzung und Systemen, deren Leistung davon abhängen kann, wie Arbeitslasten erkannt, platziert und gestartet werden.
Das schafft einen plausiblen Nutzen und eine plausible Sorge. Früherer Zugang zu komplexen KI-Systemen kann das Testen verbessern und den Weg von Hardwareänderungen bis zur Scheduler-Unterstützung verkürzen. Dieselbe Nähe wirft die berechtigte Frage auf, ob konkurrierende Beschleuniger, Verbindungen und Systemdesigns weiterhin erstklassige Aufmerksamkeit erhalten.
Die in den ersten Monaten nach der Übernahme verfügbaren Belege rechtfertigen weder die Feststellung von Vereinnahmung noch von perfekter Neutralität. Die öffentliche Entwicklung ging weiter. Slurm 26.05 und spätere Patches zeigten aktive Release-Arbeit, während die Patch-Releases vom Juli 2026 Abstürze und andere betriebliche Probleme behoben. Auch Slinky entwickelte sich weiter. Das sind stärkere Indikatoren für verantwortungsvolle Verwaltung als ein Versprechen am Übernahmetag, aber sie lösen die langfristige Vergleichsfrage nicht.
NVIDIA bezeichnete Slurm außerdem als weit verbreitet in führenden Supercomputersystemen und sagte, SchedMD habe zum Zeitpunkt der Übernahme Hunderte von Kunden unterstützt. Diese Aussagen weisen auf Größe hin, bleiben aber unternehmensberichtet und datiert. Sie sind keine vollständige Erfassung privater KI-Cluster, Forschungssysteme oder jeder Scheduler-Bereitstellung.
Die Neutralitätsfrage sollte daher als beobachtbarer technischer Test formuliert werden. Bleiben Schnittstellen generisch, wo sie es sein können? Werden Probleme, die konkurrierende Hardware betreffen, offen und zeitnah behandelt? Üben Release-Prozesse und Continuous-Integration-Umgebungen eine wirklich heterogene Hardwarebasis? Können externe Beitragende den Code weiterhin beeinflussen, ohne durch ein proprietäres NVIDIA-Produkt zu gehen?
Open Source gibt Betreibern ein Austrittsrecht, keinen kostenlosen Ersatz
Slurms Open-Source-Lizenz ist wichtig, weil Betreiber den Code unter ihren Bedingungen einsehen, verändern und weiterverbreiten können. Das schafft eine formale Hürde gegen eine schlichte Umwandlung in geschlossene Software und gibt der Gemeinschaft einen rechtlichen Weg, das Projekt abzuspalten (Fork), falls die Verwaltung inakzeptabel wird.
Ein tragfähiger Fork entsteht jedoch nicht allein durch eine Lizenz. Scheduling in großem Maßstab braucht Maintainer, die Controller-Zustand, Abrechnung, Plugins, Releases, Sicherheit und eine breite Hardware-Matrix verstehen. Es braucht Testsyteme, Nutzervertrauen und Menschen, die bereit sind, Fixes über unterstützte Versionen zurückzupflegen.
Die praktischen Umstiegskosten sind zudem viel größer als das Ersetzen eines einzelnen Programms. Ausgereifte Slurm-Umgebungen sammeln Auftragsskripte, Kontostrukturen, historische Nutzung, eigene Plugins, Monitoring, Betriebsverfahren und Nutzergewohnheiten an. Ein anderer Scheduler kann technisch fähig sein und dennoch eine kostspielige Migration von Richtlinien und institutionellem Gedächtnis erfordern.
Aus diesem Grund verdient NVIDIAs Eigentümerschaft Prüfung, ohne dass man Forkbarkeit als vollständige Antwort behandelt. Die stärkste Form von Neutralität ist nicht die theoretische Möglichkeit, nach einem Problem zu gehen. Es ist ein Projekt, das über heterogene Infrastruktur hinweg nützlich bleibt, bevor ein Weggang nötig wird.
Dieselbe Überlegung gilt für kommerziellen Support. Betreiber können sich auf das Fachwissen des Unternehmens verlassen, das zentrale Maintainer beschäftigt, selbst wenn der Code offen ist. Wenn sich dieses Fachwissen auf ein Hardware-Ökosystem verengt, kann der Quellcode verfügbar bleiben, während die praktische Support-Grenze weniger neutral wird.
Slinky bringt zwei Kontrollebenen in dieselbe Umgebung
Moderne KI-Infrastruktur kombiniert zunehmend Batch-Scheduling mit Kubernetes. Plattformteams möchten Kubernetes für Provisioning, Operatoren, Dienste und Container-Lebenszyklus nutzen und dabei Slurms Auftragsmodell, Fair-Share, Reservierungen und parallele Workload-Semantik beibehalten.
Slinky ist SchedMDs Versuch, diese Welten zu verbinden. Seinslurm-operatorkann Slurm-Komponenten über Kubernetes-orientierte Mechanismen bereitstellen und verwalten, währendslurm-bridgedie Arbeit zwischen Kubernetes und Slurm über gemeinsame Ressourcen koordiniert. Version 1.2.0 wurde am 2. Juli 2026 veröffentlicht, nachdem die erste stabile Linie Ende 2025 erschienen war.
Der Reiz liegt auf der Hand. Eine Organisation kann etablierte Slurm-Richtlinien beibehalten und Cloud-native Werkzeuge nutzen, um die Infrastruktur darum herum zu verwalten. Das kann den Bedarf an einer vollständig separaten Betriebsumgebung für Batch-Compute verringern.
Die Schwierigkeit ist Autorität. Kubernetes und Slurm haben unterschiedliche Modelle von Soll-Zustand, Workload-Eigentum und Wiederherstellung. Wenn beide Systeme nach einem Ausfall glauben, einen Knoten, ein Gerät oder eine Arbeitslast zu kontrollieren, braucht die Integration eine klare Antwort darauf, welcher Zustand maßgeblich ist und wie das andere System abgeglichen wird.
Das ist kein Grund, den Ansatz abzulehnen. Es ist der Grund, warum Slinky anhand operativer Belege beurteilt werden sollte und nicht anhand architektonischer Gefälligkeit. Produktionsbereitstellungen müssen zeigen, wie Upgrades, Fencing, RBAC, Controller-Ausfälle und partielle Netzpartitionen behandelt werden, wenn zwei Orchestrierungssysteme beteiligt sind.
Slurms Geschichte hat die Grenze dessen, was der Scheduler koordiniert, wiederholt erweitert. Die Kubernetes-Integration setzt dieses Muster fort, aber jede neue Steuerfläche erhöht die Bedeutung der Frage, wohin die Verantwortung wandert, wenn etwas bricht.
Die Warteschlange kann die Auslastung verbessern und trotzdem ein schlechtes Ergebnis erzeugen
Slurm gibt Betreibern viele Möglichkeiten, teure Kapazität nützlicher zu machen. Backfill kann Leerlauf-Lücken verringern. Fair-Share kann den Zugriff über die Zeit verteilen. Topologiebewusste Platzierung kann die Lokalität verbessern. Reservierungen können kritische Arbeiten schützen. Preemption kann Platz für dringende oder Premium-Aufträge schaffen.
Jeder Mechanismus hat auch seinen Preis. Eine Reservierung kann Kapazität brachliegen lassen, wenn der erwartete Auftrag nicht eintrifft. Preemption kann nützliche Arbeit zerstören, wenn Anwendungen keinen Checkpoint erstellen können. Eine Topologieregel kann die Leistung für einen Auftrag erhalten und gleichzeitig die Fragmentierung für andere erhöhen. Fair-Share kann eine Richtlinie belohnen, die nicht mehr zu den Prioritäten der Institution passt.
Das Risiko wächst, wenn Betreiber eine einzelne Kennzahl optimieren. Eine hohe GPU-Zuteilung lässt sich erreichen, indem Geräte Arbeiten zugewiesen bleiben, die anderswo festhängen. Eine niedrige Warteschlangenzeit lässt sich erreichen, indem Aufträge auf Ressourcenformen zugelassen werden, die die Ausführung verlängern. Aggressive Preemption kann eine Serviceebene schützen und dabei Strom- und Rechenressourcen verschwenden, die bereits in unterbrochene Aufträge investiert wurden.
Für KI-Infrastruktur ist das bessere Maß die abgeschlossene nützliche Arbeit pro Einheit knapper Kapazität und Zeit. Slurm trägt zu diesem Ergebnis bei, ist aber nur eine Ebene. Trainingsframeworks, Speicher, Netzdesign, Checkpointing, Beschleunigergesundheit und die Qualität der Nutzeranfragen beeinflussen alle, ob die Zuteilung Wert schafft.
Das ist auch die Grenze zwischen Upstream- und lokaler Verantwortung. Wenn ein Standort eine Richtlinie wählt, die ein Konto bevorzugt, Reservierungen übermäßig nutzt oder unrealistische Preemption-Regeln setzt, sollte das Ergebnis nicht automatisch SchedMD oder NVIDIA zugeschrieben werden. Wenn der Scheduler den Zustand falsch berechnet, ein Gerät falsch behandelt oder eine Regression einführt, wird das Upstream-Verhalten zur maßgeblichen Ebene.
Ein glaubwürdiger Betrieb braucht genügend Auditierbarkeit, um diese Fälle zu unterscheiden.
Die tatsächliche Steuerungsfläche ist auf mehrere Akteure verteilt
Slurms Verwaltung kann zentral wirken, weil ein Controller den Cluster einplant und ein Unternehmen heute viele Experten des Projekts beschäftigt. In der Praxis ist die Kontrolle geteilt.
Upstream-Maintainer entscheiden, welcher Code in Releases einfließt. NVIDIA besitzt SchedMD und kann Ingenieursressourcen zuweisen. Hardware-Anbieter tragen Integrationsarbeit bei und stellen Systeme für Tests bereit. Cluster-Administratoren wählen Versionen, Plugins, Topologiemodelle, Konten, QOS und Limits. Institutionelle Führungskräfte entscheiden, wer Anspruch auf knappe Rechenleistung hat. Nutzer entscheiden, welche Ressourcen sie anfordern und wie genau sie die Laufzeit beschreiben. Die Anwendung bestimmt dann, ob die Zuteilung effizient genutzt wird.
Diese geschichtete Kontrolle ist die zentrale Tatsache von Slurm. Kein einzelner Akteur besitzt das gesamte Ergebnis.
Sie erklärt auch, warum Warteschlangen-Governance strategisch wichtig geworden ist. Als Beschleuniger weniger knapp und weniger wertvoll waren, konnte eine suboptimale Regel lästig sein. In einer großen KI-Umgebung kann dieselbe Regel Wartezeiten, Fragmentierung und die Menge teurer Kapazität verändern, die nützliche Arbeit abschließt.
Slurms Leistung ist, dass ein gemeinsames offenes System sehr unterschiedliche Zuteilungsmodelle ausdrücken kann, ohne jede Institution auf eine einzige Definition von Fairness festzulegen. Seine Grenze ist identisch: Die Software kann nicht garantieren, dass ein gewähltes Modell klug, verständlich oder legitim ist.
Der langfristige Test ist daher nicht, ob Slurm weiterhin Aufträge einplant. Es ist, ob Betreiber weiterhin rekonstruieren können, warum ein Auftrag Zugang zu knapper Rechenleistung erhielt oder verlor, während das Upstream-Projekt über die heterogene Hardware hinweg glaubwürdig bleibt, die diese Betreiber ausführen möchten.
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten