
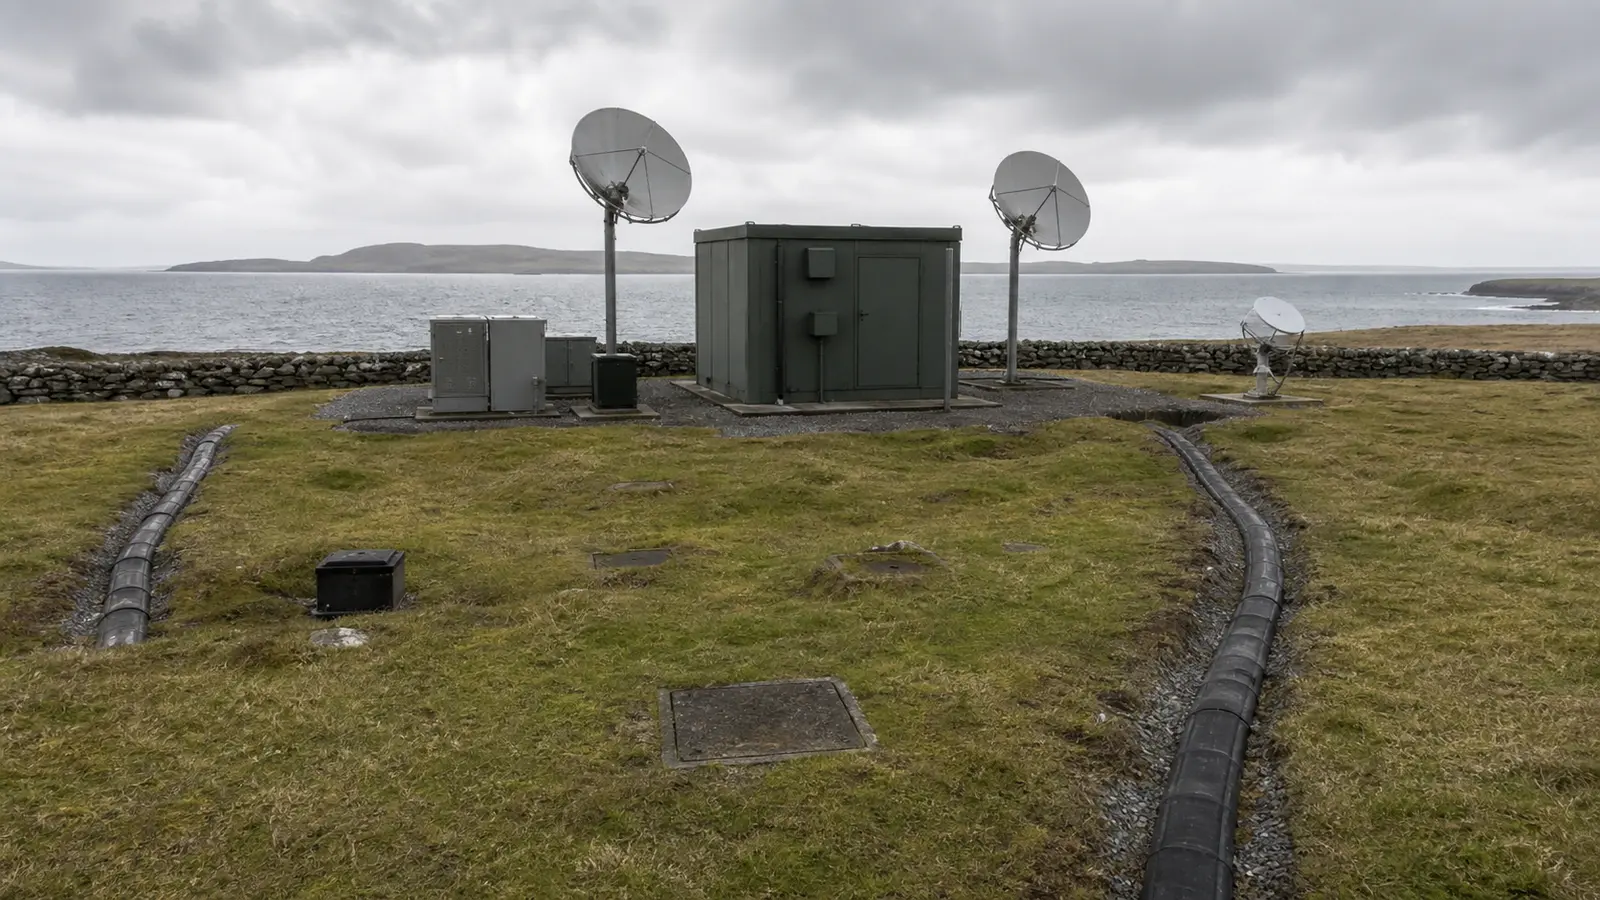
Zusammenfassung
- Ofcom berichtete, dass die Bewohner*innen von Shetland im Oktober 2022 rund 16 Stunden lang mobile und Festnetzdienste verloren, nachdem die südliche Unterseekabelverbindung beschädigt wurde, während eine sekundäre Verbindung bereits wegen eines in der Vorwoche erlittenen Schadens nicht verfügbar war. [10]
- Ofcom sagte, dass das Altverfahren von schmalbandigem Mikrowellen-Backhaul den PSTN-Voice-Sprachverkehr größtenteils aufrechterhielt. Es sagte auch, dass die vorläufige Wiederherstellung durch Erhöhung der optischen Leistung an der Quelle erreicht wurde und dass Reparaturen auf beiden Primär- und Sekundärverbindungen etwa zehn Tage dauerten. [10]
- Die Korrespondenz der Scottish Government beschreibt seit dem 14. Oktober intermittierende Probleme auf der resilienten Verbindung und schildert die Primärverbindung als kurz nach Mitternacht am 20. Oktober versehentlich durch ein UK-registriertes Fischerfahrzeug beschädigt. Der öffentliche Datensatz stützt keine Sabotagebehauptung. [4][5][11]
- Lokal berichtete Faroese Telecom, dass in der beschädigten Leitung ungenutzte Reservefaserkapazität aktiviert und ein Großteil der über BT Fibre transportierten Dienste wiederhergestellt wurde. Das ist ein Beleg für eine konkrete Wiederherstellungsmaßnahme, nicht den Nachweis, dass alle Dienste oder Anbieter gleichzeitig wiederhergestellt wurden. [15][20]
- Die Shetland Islands Council meldete, dass einige Kund*innen ohne Internetverbindung bei Anbietern blieben, die keine resilienten Verbindungen hatten und keinen Zugriff auf die unbeschädigte Faser hatten. Der Council meldete zudem Probleme bei Telecare- und Gemeindealarmen. [13]
- Police Scotland setzte Einsatzkräfte und Fahrzeuge ein, um den Zugang zu Notdiensten aufrechtzuerhalten, während die normale Kommunikation beeinträchtigt war. [12]
- Die Verantwortlichkeitsfrage ist nicht, ob zwei physische Kabel existierten. Entscheidend ist, wer nutzbare alternative Kapazität, Anbieterzugang, optische und mikrowellenbasierte Fallback, Notfallregelungen, Reparaturreihenfolge und die Evidenz zur Erklärung der Dienstwiederherstellung kontrollierte.
- Vollständige Anbieterverträge, Routing-Policys, optische Budgets, Kundenstämme und Verlustunterlagen sind nicht öffentlich. Die Evidenz stützt eine Kontrollanalyse, keine Anschuldigungen providerweise.
- Der nächste Vergleich ist Tongas Kabelbruch von 2022, aber die Fälle sind unterschiedlich. In Tonga war eine einzige internationale Route relevant, verbunden mit vulkanischen Meeresboden-Schäden und aufwendiger Reparaturlogistik. In Shetland zeigte sich die Lücke zwischen nominell unterschiedlichen Routen und dem dienstbezogenen Zugang zu verbleibender Kapazität.
Ein schwerer Ausfall kann in einem Redundanzdiagramm existieren
Redundanz ist eines der beruhigendsten Worte in der Infrastruktur.
Sie suggeriert, dass der Ausfall einer Komponente nicht zum Ausfall eines Dienstes führt. Ein zweites Kabel, ein zweiter Router, eine zweite Stromzuführung, ein zweites Rechenzentrum oder eine zweite Control Plane sollen dann die Last tragen. Das Wort erscheint oft in Architekturdiagrammen, Beschaffungsunterlagen, Regulierungsunterlagen und Risikoregisters der Leitungsebene, lange bevor jemand prüft, ob es tatsächlich funktioniert.
Der Ausfall in Shetland im Oktober 2022 zeigt, warum installierte Redundanz und nutzbare Redundanz als zwei unterschiedliche Tatsachen behandelt werden müssen.
Die Inseln waren über Unterseekabelrouten verbunden, die südlich über Orkney in Richtung schottisches Festland und nördlich Richtung Faroe Islands verliefen. Der öffentliche Datensatz beschreibt die eine als primäre Route und die andere als resilienten beziehungsweise sekundären Pfad. In der Woche vor dem 20. Oktober war die nördliche Verbindung bereits beeinträchtigt. Kurz nach Mitternacht am 20. Oktober wurde die südliche Verbindung beschädigt. Ofcom fasste das Ergebnis später als etwa 16 Stunden Ausfall von mobilen und Festnetzdiensten zusammen. [4][10]
Auf den ersten Blick wirkt das Ereignis wie Pech: zwei physische Fehler innerhalb weniger Tage. Die Beschädigung wurde offenbar versehentlich verursacht. In dem öffentlichen Datensatz ist ein Fischereifahrzeug benannt. Kabelreparaturen benötigen Schiffe, Wetterfenster, Spezialteams und physischen Zugang zu den Fehlerstellen. Keines dieser Fakten ist trivial. [4][11][16]
Aber Pech beantwortet nicht die operative Frage.
Warum erzeugte ein System mit zwei Routen eine so breite Störung? Warum kehrten einige Dienste schnell zurück, während manche Kund*innen noch den größten Teil der folgenden Woche betroffen blieben? Warum konnte die Leitungs- und Sprachdiensterückfallquote bei legacy voice höher bleiben als bei datenlastigen Diensten? Warum konnte eine Verkehrsgruppe eine wiederhergestellte oder alternative Kapazität nutzen, eine andere jedoch nicht?
Diese Fragen verlagern die Analyse weg von der Existenz von Kabelstahl, Glasfaser und Landeequipment. Sie verlagern sie auf die Kontrollflächen, die Infrastruktur in Dienstbarkeit übersetzen:
- Routenverfügbarkeit;
- optische Leistung und Reserve;
- nutzbare Faserpaare;
- reservierte und ungenutzte Kapazität;
- Umschalt- und Routing-Konfiguration;
- Wholesale-Zugang;
- Einzelhandels-Anbietervereinbarungen;
- Fallback-Backhaul;
- Notfalldienstepläne;
- Reparaturpriorität;
- Service-Monitoring;
- Wiederherstellungsevidenz.
Ein zweiter Pfad kann physisch vorhanden, aber bereits beschädigt und damit ungenutzt sein. Er kann intakt sein, aber zu wenig Kapazität für den Verkehr haben. Kapazität kann vorhanden sein, ohne einen vertraglichen oder technischen Pfad für einen bestimmten Dienst.
Ein Anbieter kann eine Route auf dem Papier haben, aber die Umschaltung nicht testen. Ein schmalbandiges Backup kann Sprache erhalten, während Breitband nicht nutzbar bleibt. Ein Betreiber kann Licht durch Fasern wiederherstellen, ohne damit nachzuweisen, dass alle nachgelagerten Dienste ebenfalls wiederhergestellt sind.
Der Shetland-Datensatz enthält Beispiele für mehrere dieser Bedingungen. Deshalb ist er eher ein Fall für Verantwortlichkeit in Netzwerkinfrastruktur als eine allgemeine Geschichte über einen einzelnen Kabelbruch.
Die beiden Störungen müssen getrennt bleiben
Das Ereignis benötigt zwei Zeitscheiben.
Korrespondenz der Scottish Government sagt, dass die resilienten Kabel bereits seit dem 14. Oktober intermittierende Probleme aufwiesen und dass Faroese Telecom Personal entsandte, um daran zu arbeiten. Das zweite Ereignis trat kurz nach Mitternacht am 20. Oktober auf, als das Primärkabel beschädigt wurde. Die Korrespondenz beschreibt die Ursache als versehentliche Beschädigung durch ein UK-registriertes Fischerfahrzeug und sagt, dass das Ereignis fast alle auf dieser Leitung transportierten Dienste betraf. [4]
Ofcoms spätere Darstellung nutzt leicht abweichende operative Begriffe. Sie sagt, dass ein sekundärer Glasfaserlink bereits wegen einer Vorwoche-Schädigung nicht verfügbar war. Sie sagt, dass das südliche Glasfaserkabel daraufhin einen Lichtverlust erlitten hatte. [10]
Diese Beschreibungen sollten nicht zu der Behauptung zusammengedrückt werden, dass zwei Kabel zu demselben Zeitpunkt sauber getrennt wurden.
Der öffentliche Datensatz unterscheidet zwischen intermittenten Störungen, Nichtverfügbarkeit, Faser-Effekten, Lichtausfall und Kabelreparatur. Der Geschäftsführer von Faroese Telecom wurde als Quelle zitiert mit der Aussage, dass der spätere Bruch Fasern betraf, aber nicht das gesamte Kabel kappte. Lokale Berichterstattung verortet den Fehler nur wenige Kilometer vor Shetland und beschreibt ein Reparaturschiff, das an mehr als einem Ort arbeitete. [15][16][18]
Diese Unterscheidung ist aus drei Gründen wichtig.
Erstens beeinflusst der physikalische Mechanismus die Wiederherstellungsoptionen. Ein vollständiger Bruch, ein beschädigtes Faserpaar, ein Verstärkerproblem, ein Stromproblem in der Einspeisung und ein reduzierter optischer Reservewert sind nicht derselbe Fehler. Sie erlauben verschiedene temporäre Maßnahmen.
Zweitens beeinflusst die Beschreibung die Verantwortung. Ein Kabelhalter kann die Reparatur und optische Wiederherstellung kontrollieren. Ein Carrier kann den Verkehrsplatz kontrollieren. Ein Einzelhandelsanbieter kann von einem Wholesale-Pfad abhängen. Eine öffentliche Behörde kann die Notfallreaktion steuern. Eine pauschale Etikettierung des gesamten Ereignisses kann diese Grenzen verschleiern.
Drittens verhindert die Unterscheidung retrospektive Überhöhung. Der Vorfall war schwer, ohne dass jedes Kabel vollständig durchtrennt oder jeder Dienst für zehn Tage vollständig ausgefallen war. Ofcoms rund 16 Stunden beschreiben den Hauptausfall von mobilen und Festnetzdiensten. Die zehn Tage beziehen sich auf Arbeiten auf beiden Glasfaserverbindungen vor permanenter Wiederherstellung. Zwischen diesen Zeitpunkten blieben Restprobleme bestehen. [10][13][18]
Eine verantwortbare Chronologie trennt daher mindestens fünf Zustände:
- Der nördliche oder sekundäre Pfad entwickelt Probleme.
- Reparaturarbeiten beginnen, während der südliche Pfad noch Dienste transportiert.
- Der südliche Pfad ist beschädigt und ein breiter Dienstverlust folgt.
- Temporäre optische und Kapazitätsmaßnahmen stellen einen Großteil des Verkehrs wieder her.
- Residualer, anbieterbezogener Ausfall bleibt bestehen, bis die Dauerreparaturen abgeschlossen sind.
Diese Abfolge ist nützlicher als eine einzige Ausfalldauer, weil jeder Zustand unterschiedliche Kontrollen und Verantwortlichkeiten offenlegt.
Physische Vielfalt ist nicht Service-Vielfalt
Resilienz wird im Netz oft auf der falschen Ebene gemessen.
Auf der physikalischen Ebene hatte Shetland mehr als eine Richtung für Glasfaserkonnektivität. Eine Route lief über Orkney zum schottischen Festland, eine andere zu den Faroe Islands. Die Geografie wirkt vielfältig.
Auf der Service-Ebene ist der Kunde jedoch kein abstrakter Richtungsanforderungsträger unter dem Meer. Der Kunde kauft ein Breitband-, Mobil-, Sprach- oder Institutionendienst. Dieser Dienst läuft durch eine Kette aus Zugangsgerät, lokaler Aggregation, Wholesale-Transport, Anbieter-Routing, Authentifizierung, Kerndiensten und übergeordneter Interkonnektion. Jeder Link dieser Kette benötigt einen funktionalen alternativen Pfad, wenn der Dienst bei einem Kabelfehler überleben soll.
Das Update der Council vom 28. Oktober ist außergewöhnlich wichtig, weil es das Service-Layer-Problem direkt formuliert. Es sagte, dass Nutzer, die weiterhin keinen Internetzugang hatten, über Unternehmen versorgt wurden, die keine resilienten Verbindungen hatten. Diese Anbieter konnten nicht auf die unbeschädigte Faser zugreifen und waren auf laufende Reparaturen angewiesen. [13]
Die Aussage publiziert nicht jeden Vertrag oder jede Routingtabelle. Sie beweist nicht, warum jeder Anbieter keinen Zugriff hatte. Sie zeigt nicht, ob die Grenze kommerziell, technisch, historisch oder eine Kombination daraus war. Sie darf nicht in eine allgemeine Behauptung umgesetzt werden, dass genannte Unternehmen Resilienz bewusst verweigerten.
Sie zeigt aber, dass alternative physische Kapazität nicht automatisch in alternative Serviceerbringung für alle Kund*innen übersetzt.
Dies ist ein wiederkehrendes Muster in Infrastrukturfällen.
Ein Rechenzentrum kann zwei Stromzuführungen haben, die dieselbe vorgelagerte Umspannstation teilen. Eine Cloud-Anwendung kann in zwei Verfügbarkeitszonen laufen und dennoch dieselbe Identitäts-Control Plane nutzen. Ein Mobilfunker kann redundanten Transport haben, während beide Routen in demselben Router enden. Ein Register kann mehrere Name-Server haben, die dieselbe fehlerhafte Zone empfangen. Eine Insel kann zwei Kabelführungslinien haben, während der Dienst eines Anbieters nur über einen einzigen Betriebs- oder kommerziellen Pfad erreichbar bleibt.
In jedem Fall überschätzt die reine Komponentenzählung die Resilienz. Die richtige Frage ist, ob Ausfallbereiche bis auf den Dienst selbst unabhängig sind.
Für Shetland bedeutet das die Prüfung:
- ob die Nord- und Südpfade an den Fehlerstellen physisch unabhängig waren;
- ob Landesequenz und terrestrische Segmente gemeinsame Schwachstellen vermieden;
- ob auf dem alternativen Pfad ausreichende Kapazität bestand;
- ob Anbieter autorisiert und konfiguriert waren, ihn zu nutzen;
- ob Failover automatisch erfolgen konnte;
- ob manuelle Umschaltverfahren aktuell waren;
- ob Serviceabhängigkeiten wie DNS, Authentifizierung und Management erreichbar blieben;
- ob Notfall- und öffentliche Dienste priorisiert wurden;
- ob Kund*innen nach wiederhergestelltem Dienst gemessen werden konnten statt nur nach wiederhergestelltem Licht.
Der öffentliche Datensatz beantwortet manche dieser Fragen und lässt andere offen. Diese Evidenzlücken sind selbst Teil der Verantwortlichkeitsbewertung und sollten explizit bleiben.
Erhöhte optische Leistung war eine Wiederherstellungskontrolle
Ofcoms Darstellung enthält ein technisches Detail, das die Deutung verschiebt.
Es wurde berichtet, dass die südliche Glasfaserleitung einen Lichtverlust erlitten hatte und dass die vorläufige Wiederherstellung durch Erhöhung der Ausgangsleistung an der Quelle erreicht wurde. [10]
Optische Fasersysteme folgen einem Link-Budget. Das ins System eingespeiste Signal verliert Leistung auf dem Weg durch Kabel, Repeater, Steckverbinder und weitere Komponenten. Ein Empfänger braucht ein genügend starkes Signal, um Daten zuverlässig zu unterscheiden. Schäden können den Verlust erhöhen, ohne jede Faser zu zerstören. Wenn der verbleibende Pfad genügend Reserve hat, kann die Änderung der Einspeiseparameter vorübergehend ein nutzbares Signal wiederherstellen.
Der öffentliche Bericht veröffentlicht nicht die exakten optischen Auslegungen, Leistungswerte, Faserpaare oder Ingenieursgrenzwerte. Diese Details aus allgemeinen Prinzipien zu rekonstruieren wäre falsch. Dennoch ist es sachgerecht, die Steuerfläche zu benennen.
Es war erforderlich:
- zu erkennen, dass das Problem ein Lichtausfallzustand war;
- zu bestimmen, welche Fasern oder Dienste noch wiederherstellbar waren;
- zu bewerten, ob zusätzliche Leistung sicher und sinnvoll war;
- die Änderung zu autorisieren;
- Fehler und Stabilität zu überwachen;
- zu entscheiden, welcher Verkehr zurückkehren durfte;
- die dauerhafte Reparaturarbeit aufrechtzuerhalten.
Das ist nicht dasselbe wie die Kontrolle über eine zweite Route.
Optische Wiederherstellung erzeugt auch eine Evidenzanforderung. „Licht wiederhergestellt“ ist eine notwendige Netzwerkinformation, aber nicht dasselbe wie „Kundenservice wiederhergestellt“. Eine Faser kann ein Signal tragen, während Routing, Authentifizierung, Kapazität oder nachgelagerte Anbieterpfade weiterhin eingeschränkt bleiben. Der Wiederherstellungsnachweis muss daher physische Messwerte mit Serviceprüfungen verbinden.
Eine verantwortbare Wiederherstellungsbewertung sollte trennen:
- optische Kontinuität;
- Link-Layer-Stabilität;
- geroutete Erreichbarkeit;
- Übergabe zwischen Anbietern;
- Sessionaufbau im Breitband;
- mobiles Backhaul und Kern-Erreichbarkeit;
- Sprachdienst;
- Notrufdienste;
- Zugang zu öffentlichen Diensten und Anwendungen;
- kundensichtbare Verfügbarkeit.
Der Shetland-Vorfall zeigt, warum dieser Schichtenansatz wichtig ist. Vielerorts kehrte der Dienst am 20. Oktober zurück, dennoch warnte die Council weiterhin am 28. Oktober vor Problemen bei Internet und Telecare. [13]
Temporärer technischen Erfolg und vollständige Servicewiederherstellung waren nicht derselbe Meilenstein.
Reservefaser war wichtig, weil sie aktiviert werden konnte
zeitnahe lokale Berichte fügen einen weiteren Wiederherstellungsmechanismus hinzu.
Shetland News berichtete, dass Faroese Telecom ungenutzte Reservefaser in der beschädigten Leitung aktiviert habe. Die Berichte sagten, diese Kapazität sei für spätere Nutzung reserviert gewesen und dass ihre Aktivierung geholfen habe, Dienste auf BT Fibre wieder anzubinden. Der geschäftsführende Direktor des Betreibers sagte, dass der Fehler Fasern betraf, aber die gesamte Leitung nicht abschaltete, und dass Techniker die Dienste so weit wie möglich wiederherstellten. [15]
Diese Wortwahl ist zitierender Berichterstattung zuzuordnen, nicht einem technischen Anhang von Ofcom. Sie sollte mit genau diesem Vertrauensniveau verwendet werden. Trotzdem zeigt sie ein wichtiges Prinzip: Reserveinfrastruktur hat nur Wert, wenn Einsatzteams sie im Zwischenfall aktivieren können.
Reservefaser kann mehrere Formen haben. Ein Kabel kann unbeleuchtete Fasern, ungenutzte Kapazität auf aktiven Paaren oder für den Wachstumspfad reservierte Kapazität enthalten. Die Umwandlung dieser Reserve in Service kann Ausrüstung, Konfiguration, Nutzungsrechte, kompatible Schnittstellen und operative Abstimmung erfordern.
Die Verantwortlichkeitsfragen sind praktisch:
- Wurde die Reservekapazität inventarisiert?
- Wussten Betreiber ihren Zustand?
- War sie mit nutzbarer Ausrüstung verbunden, die bei einem Fehler verwendet werden konnte?
- Waren Aktivierungsverfahren getestet?
- Wer war berechtigt, sie zuzuweisen?
- Welche Dienste hatten Vorrang?
- Konnte die nachgelagerte Anbieterfamilie sie erreichen?
- Reichte die Reserve für einen stabilen Dauerbetrieb?
- Was zeigte das Monitoring als Stabilität des temporären Pfads?
Der Vorfall deutet darauf hin, dass mindestens ein Teil der reservierten Kapazität in echte Wiederherstellung umgesetzt wurde. Er deutet auch darauf hin, dass diese Umwandlung nicht alle nachgelagerten Dienste abdeckte.
Das ist eine nützlichere Lehre als die pauschale Forderung „mehr Kabel bauen“. Mehr physische Assets können das Risiko reduzieren, doch ein Kabel, das bei einem Fehler nicht erreicht, geschaltet, gespeist, vertraglich nutzbar oder operativ gesteuert werden kann, ist ein teures Diagramm. Investitionen in Resilienz benötigen operative Abnahmetests.
Für jeden alternativen Pfad sollte ein Anbieter zeigen können:
- die auf den Pfad gemappten Dienste;
- die verfügbare Kapazität im Ausfall;
- den Auslöser für den Failover;
- die verwendeten Befehle oder Automatisierungen;
- die Personen mit Befähigung;
- die Abhängigkeiten, die außerhalb des Pfads liegen;
- die Testergebnisse;
- das Wiederherstellungsziel;
- das verbleibende Risiko.
Ohne diese Evidenz ist Reservekapazität eine Möglichkeit, keine belastbare Kontrolle.
Niedrigbandbreitiges Mikrowellen-Backhaul sicherte eine andere Form von Kontinuität
Ofcom sagt, dass die PSTN-Festnetzdienste für Sprache weitgehend verfügbar blieben, weil legacy low-bandwidth microwave backhaul eingesetzt wurde. [10]
Dieser Satz ist nicht als Nachweis zu lesen, dass alle Festnetze arbeiteten oder die Notfallkommunikation unberührt blieb. Die Situationserfassung der Scottish Government beschrieb einen breiten Ausfall bei landline-, Internet- und Mobilleistungen, und Police Scotland setzte weiterhin Präsenz ein, um den Notfallzugang zu sichern. [4][12]
Beide Datensätze können nebeneinander bestehen.
Legacy-Mikrowelle kann einen begrenzten Sprachpfad bewahren, während hochbandbreitige Dienste ausfallen. Verfügbarkeit kann je nach Exchange, Anbieter, Dienst, Ort und Zeitpunkt variieren. Eine Niedrigbandbreitenverbindung, die für normales Internet unzureichend ist, kann weiterhin etwas Sprache tragen. Umgekehrt profitiert eine Kundin mit einem digitalen oder anbieterspezifischen Dienst möglicherweise nicht von diesem Legacy-Pfad.
Das ist ein Hinweis, dass Fallback für Mindestfunktionsfähigkeit ausgelegt sein muss, nicht nur für normale Kapazität.
Während einer massiven Kommunikationsstörung können Prioritäten enthalten sein:
- Notrufe;
- Koordination zwischen Polizei, Feuerwehr, Rettungsdienst und Küstenwache;
- Kommunikation in Krankenhäusern und Gesundheitsbehörden;
- Telecare-Alarme;
- öffentliche Warnungen;
- zentrale Regierungsverbindungen;
- kritische Zahlungsvorgänge und Logistikfunktionen;
- Management der Reparaturteams.
Ein Fallbackpfad kann wertvoll sein, auch wenn er keinen regulären Breitbandbetrieb wiedergeben kann. Die technische und Governance-Aufgabe ist zu definieren, welche Dienste er tragen soll und nachzuweisen, dass diese diesen nutzen können.
Der Shetland-Vorfall zeigt außerdem die Gefahr, alte Infrastruktur als zufällige Resilienz zu behandeln. Wenn ein legacy-Mikrowellenpfad eine Sicherheitsfunktion trägt, sollte seine Rolle dokumentiert, gepflegt und getestet werden. Wird ein Rückbau erwartet, muss die Ersatzarchitektur vor dem Auslaufen einen gleichwertigen oder besseren Ausfallpfad vorsehen.
Andernfalls kann Modernisierung eine verborgene Kontinuitätsebene entfernen.
Altsysteme sollten nicht romantisiert werden. Niedrige Bandbreite, begrenzte Abdeckung und alternde Ausrüstung erzeugen eigene Risiken. Der wertvolle Punkt ist enger: Der Wert eines Fallbacks ergibt sich aus dem Dienst, den er bewahren kann, nicht aus dem Alter.
Notfallzugang verwandelte Netzreparatur in öffentliche Pflicht
Kommunikationsausfälle werden zu Fragen der öffentlichen Sicherheit, wenn Menschen Notdienste nicht zuverlässig erreichen können.
Police Scotland gab an, dass Fahrzeuge und Einsatzkräfte in das Gebiet verlegt wurden, um sicherzustellen, dass die Öffentlichkeit Zugang zu Notdiensten behielt. Nach Rückkehr normaler Kommunikation wurden diese Ressourcen zurückgezogen. [12]
Zeitraumberichte beschrieben die Empfehlung, einen 999-Anruf über Festnetz oder Mobiltelefon zu versuchen und im Scheitern einen Notfallwagen anzuhalten oder zu Polizei, Krankenhaus, Feuerwehr oder Ambulanz zu gehen. Zusätzliche Patrouillen und ein physischer Notfallknoten wurden als Ersatz für normale Erreichbarkeit genutzt. [19]
Diese Umgehungen sind relevant, weil sie den wirklich geschützten Dienst offenlegen.
Eine Notrufnummer ist nicht nur ein Telefonmerkmal. Sie hängt ab von:
- Erreichbarkeit des Zugangsnetzes;
- Routungsfähigkeit von Anrufen;
- Anruferstandort, soweit technisch verfügbar;
- Interkonnektion mit Notfalleinrichtungen;
- Stromversorgung an Kunden- und Netzstandorten;
- Öffentlichem Wissen über Alternativen;
- Personalplanung und physischer Erreichbarkeit, wenn Kommunikation ausfällt.
Ofcoms General Conditions formulieren Anforderungen für breite Verfügbarkeit, ununterbrochenen Zugang zu Notfalleinrichtungen und Maßnahmen zur Bereitstellung oder raschen Wiederherstellung im Katastrophenfall. Die genaue rechtliche Zuständigkeit eines Anbieters für ein konkretes Ereignis erfordert Rechtsanalyse, und aktuelle konsolidierte Leitlinien dürfen ohne Sorgfalt nicht rückwirkend auf ein Ereignis angewendet werden. Dies zeigt dennoch, warum Notfallzugriff mehr als eine normale Kundenerfahrung ist. [8]
Die Shetland-Reaktion sollte auf zwei Ebenen bewertet werden.
Die erste ist Netzprävention und -wiederherstellung. Waren Notrufswege divers genug? Funktionierte das verbleibende Sprach-Backhaul? Konnten mobile Gespräche das Notfallnetz erreichen? Hatten Anbieter getestete Regeln mit Notfalleinrichtungen?
Die zweite ist die zivile Notfallvorsorge. Als die Netz-Erreichbarkeit unsicher wurde, stellten Behörden sichtbare Alternativen bereit, verlegten Ressourcen, prüften verwundbare Personen und kommunizierten über Kanäle, die noch funktionierten.
Police Scotland und lokale Behörden kontrollierten die zweite Ebene. Sie steuerten nicht den Kabelzustand oder Wholesale-Routing. Ihre Reaktion minderte Schaden, darf aber keine Schwächen in der Netzwerkebene entschuldigen.
Eine gute Notfalllösung ist Evidenz für Resilienz, aber kein Beweis, dass der ursprüngliche Service das Verfügbarkeitsziel erfüllt hat.
Telecare legte die Abhängigkeit unterhalb der Anwendung offen
Die Shetland Islands Council berichtete von Problemen bei bestimmten Telecare- und Gemeindealarmen, einschließlich über analoge Festnetze bereitgestellter Dienste. Mitarbeitende kontaktierten Klient*innen und baten Familie und Freunde, ältere oder verletzliche Angehörige zu überprüfen. [13]
Telecare wird oft als Gerät oder Sozialanwendungsbezug diskutiert. Während eines Ausfalls werden die Netzwerkabhängigkeiten sichtbar.
Ein Notrufgerät oder Heimalarm wirkt für Nutzer*innen einfach. Dahinter steht jedoch eine Kette:
- Strom am Standort;
- die Alarmeinheit;
- lokale Verkabelung oder Funk;
- ein landbasierter, mobiler oder Internetzugangspfad;
- Exchange und Backhaul;
- ein Monitoring-Zentrum;
- ein menschlicher Reaktionsprozess.
Das Gerät kann funktionsfähig bleiben, während der Pfad nicht verfügbar ist. Ein Netz kann teilweise wiederhergestellt sein, während eine bestimmte Alarmfunktion weiterhin ausfällt. Ein Anbieter kann eine breite Servicewiederherstellung melden, während eine verletzliche Person isoliert bleibt.
Darum muss Wiederherstellung an kritischen Funktionen gemessen werden, nicht nur über aggregierte Verkehrswerte.
Das Update der Council sagt nicht, dass alle Alarme ausfielen. Es sagt, dass manche Dienste betroffen waren und einen manuellen Welfaresupport beschreibt. Diese Grenze ist wichtig, weil ein Risikosignal nicht in eine unhaltbare Verletzungsbehauptung übertragen werden darf.
Die gestützte Schlussfolgerung ist, dass Telekommunikationskontinuität Teil der Versorgungskontinuität ist. Betreiber und öffentliche Stellen brauchen eine gemeinsame Abhängigkeitskarte, die identifiziert:
- welche Alarmtypen welche Zugangstechnologien nutzen;
- von welchen Anbieter- und Wholesale-Pfaden sie abhängen;
- welche Batterie- oder Energieannahmen gelten;
- wie ein Ausfall erkannt wird;
- wer bei Kommunikationsausfall eine Warnung erhält;
- welcher manuelle Welfare-Prozess beginnt;
- wie die Wiederherstellung am Gerät verifiziert wird.
Das Shetland-Erlebnis machte aus einem abstrakten Netzausfall eine konkrete Frage: konnte eine verwundbare Person weiterhin Hilfe rufen?
Diese Frage gehört in das Infrastrukturdesign vor dem Kabelbruch.
Anbieterbezogene Ergebnisse sind Beleg, nicht Erlaubnis zur Spekulation
Restliche dienstbezogene Unterschiede zählen zu den aufschlussreichsten Teilen des Ereignisses.
Der Council sagte, dass manche betroffene Kund*innen von Unternehmen ohne resiliente Verbindungen betreut wurden und auf die unbeschädigte Faser keinen Zugriff hatten. Lokale Berichte beschrieben später einzelne Anbieter beim Umrouten, während andere weiter nicht verfügbar waren. [13][18]
Es ist verlockend, dies in eine Rangfolge verantwortlicher und unverantwortlicher Anbieter zu überführen. Die Evidenz stützt keine solche einfache Schlussfolgerung.
Die öffentlichen Quellen geben nicht preis:
- jeden Wholesale-Vertrag;
- jede Route, die jeder Einzelhandelspartner erworben hat;
- Kapazitätsgrenzen auf alternativen Pfaden;
- den genauen Zustand der Geräte jedes Anbieters;
- welche Kund*innen auf welcher Infrastruktur lagen;
- ob ein Umschaltversuch fehlgeschlagen ist;
- ob ein Pfad technisch möglich, aber kommerziell nicht verfügbar war;
- welche Service Level Objectives galten;
- welche Informationen Anbieter während der Reparatur erhielten.
Ein Anbieter kann keine Alternative haben, weil er nicht eine gekauft hat. Er kann bei einem Wholesaler abhängig sein, der keine hat. Eine Alternative kann existieren, aber zu geringe Kapazität haben. Der Dienst kann ein lokales Ausfallfeld teilen, das beide Richtungen erfasst. Ein manueller Prozess kann zu langsam sein. Das öffentliche Reporting kann nicht alle dieser Möglichkeiten auflösen.
Der verantwortbare Ansatz ist der Antrag auf Evidenz.
Jeder Anbieter, der in einem geografisch begrenzten Markt liefert, sollte in einem angemessenen Sicherheitsniveau darlegen können:
- die Ausfallbereiche im Zugang und Backhaul;
- den alternativen Pfad, wenn ein Unterseekabelsegment ausfällt;
- die auf diesem Pfad gebuchte Kapazität;
- die Bedingungen, die die Failover-Auslösung triggern;
- den letzten Ende-zu-Ende-Test;
- die Dienste, die degradieren oder nicht wiederhergestellt bleiben;
- das Wiederherstellungsziel;
- den Kommunikationsplan für Kund*innen und Behörden.
Das ist keine Forderung nach Offenlegung sensibler Topologie. Es ist die Forderung, „resilient“ mit operativer Kontrolle zu verknüpfen.
Der Council-Bericht ist wertvoll, weil er beobachtetes Serviceverhalten beschreibt. Manche Nutzer*innen konnten unbeschädigte Fasern nicht nutzen. Diese Tatsache soll eine fokussierte Prüfung auslösen, ohne die Antwort vorzubereiten.
Reparaturreihenfolge verteilte die Kontinuität
Kabelreparatur unterseeisch ist ein begrenzter Betriebsablauf.
Der Fehler muss lokalisiert werden. Ein passendes Schiff und Fachpersonal müssen verfügbar sein. Wetter und Seezustand müssen Arbeit erlauben. Das Kabel kann geholt, aufgeschnitten, verschweißt, getestet und zurück ins Meer gelegt werden. Wenn mehr als ein Abschnitt beschädigt ist, kann das Schiff nicht notwendigerweise beide nacheinander sofort reparieren.
Lokale Berichte sagten, dass das Reparaturschiff zuerst in einem weiteren Abschnitt westlich von Shetland fertigstellte, bevor es zum Fehler östlich der Inseln wechselte. Die vollständige Breitbandwiederherstellung wurde nach der späteren Reparatur am 30. Oktober gemeldet. [18]
Diese Abfolge zeigt, dass die Reparaturreihenfolge selbst eine Zuteilungsentscheidung ist.
Betreiber benötigen Kriterien für die Entscheidung:
- welcher Fehler das größte Servicerisiko schafft;
- welche Reparatur physisch zuerst möglich ist;
- ob ein temporärer Pfad stabil genug ist, um zu warten;
- welcher Pfad die kritischsten Dienste am besten wiederherstellt;
- ob ein weiterer Fehler zu Totalisolation führen würde;
- wie lange Backup-Kapazität die Last tragen kann;
- ob Gerät und Ersatzteile verfügbar sind;
- welches Wetterfenster zu erwarten ist.
Der öffentliche Datensatz zeigt nicht das vollständige Entscheidungsprotokoll. Er zeigt, dass Reparaturen auf beiden Primär- und Sekundärverbindungen rund zehn Tage dauerten und dass in der Zwischenzeit temporäre Steuerungen genutzt wurden. [10]
Verantwortlichkeit verlangt nicht, dass Unterseekabel sofort repariert werden können. Sie verlangt Evidenz, dass der Betreiber den sich ändernden Risikoverlauf verstand und die besten steuerbaren Entscheidungen traf.
Diese Evidenz kann enthalten:
- Vertrauen in die Fehlerlokalisation;
- Schätzungen der Serviceauswirkungen;
- Verfügbarkeit von Schiff und Personal;
- Kapazitätsstatus auf dem Pfad;
- Wettereinschränkungen;
- Stabilität der temporären Wiederherstellung;
- Notfallanforderungen;
- Begründung der Reparaturreihenfolge;
- aktualisierte Fertigstellungsprognosen;
- optische und Serviceprüfungen nach Reparatur.
Unsicherheit sollte sichtbar bleiben. Eine Schätzung auf Basis von Schiffsankunft und Wetter ist keine Garantie. Ein öffentlicher Statusbericht sollte bekannte Fehlerlage, aktuelle Umgehung, erwartete Reparaturzeit und verbleibendes Risiko trennen.
Der Shetland-Einfluss zeigt, warum Reparaturbereitschaft Teil des Netzdesigns ist. Eine Route ist nicht vollständig resilient, wenn der Betreiber Fehler nicht lokalisieren, ein Schiff nicht beschaffen, Ersatzteile nicht erreichen, Landeeinsätze nicht koordinieren und realistische Wiederherstellungsevidenz nicht kommunizieren kann.
Praktische Kontrolle war aufgeteilt
Das Ereignis betraf mehrere Organisationen, aber Kontrolle war nicht gleichmäßig verteilt.
Der Kabelhalter und Betreiber
Faroese Telecom und das SHEFA-System lagen der physischen Störungsdetektion, optischen Verfassung, Reservefaser und Dauerreparatur am nächsten. Betreiberaussagen beschreiben temporäre technische Maßnahmen und Schiffsarbeiten. Das gibt dem Kabelbetreiber eine erhebliche Kontrolle über die physische Wiederherstellung.
Es gibt dem Betreiber jedoch nicht die Kontrolle über jeden retail-Dienst eines Endkund*in oder jede nachgelagerte Vertragskonstruktion.
Wholesale- und retail-Kommunikationsanbieter
Anbieter kontrollierten – oder waren auf andere angewiesen, sie zu kontrollieren – die Verkehrsverteilung, den Zugang zum alternativen Pfad, Kapazität, Kundenkommunikation und Servicewiederherstellung. Der Council-Bericht zu anbieterspezifischer Kontinuität macht diese Ebene zentral.
Der öffentliche Datensatz offenbart nicht, welcher Teil jeder Anbieterkette die entscheidende Wahl traf. Verantwortung sollte der verifizierbaren Fähigkeit folgen, nicht der Markenpräsenz.
Ofcom und Regierung
Ofcom kontrollierte regulatorische Berichterstattung und den breiteren Resilienzrahmen, nicht die konkrete Incident-Reparatur. Die Connected Nations-Darstellung liefert einen technischen öffentlichen Baseline-Rahmen. Regierungsresilienzteams koordinierten Information und Notfallantwort. Die Regulierungs- und Politikfrage ist, ob Anbieter gefordert waren, vorhersehbare gemeinsame Ausfälle zu erkennen und zu reduzieren.
Der gestärkte Sicherheits- und Resilienzrahmen von Telekommunikation trat im Oktober 2022 in Kraft. Ofcom beschrieb Pflichten zur Risikoidentifikation, zur Reduktion von Sicherheitskompromissen und zu Gegenmaßnahmen. Ein physischer Kabelunfall ist nicht automatisch ein Sicherheitskompromiss in jeder Rechtsvorschrift, daher sollte der Rahmen als Resilienzkontext verwendet werden, nicht als unbegründete Durchsetzungsfeststellung. [6][7]
Police, Council, health and emergency partners
Öffentliche Behörden steuerten lokale Minderung: Patrouillen, physische Zugangspunkte, Fürsorgekontakt und Koordination von Diensten. Sie nahmen Folgen der Kommunikationsstörung auf und steuerten diese, kontrollierten aber nicht das Kabel oder Anbieter-Routing.
Ihre Arbeit ist ein Hinweis auf verlagertes öffentliches Risiko. Wenn normale Telekommunikation ausfällt, liefern öffentliche Organisationen Personal, Fahrzeuge und manuelle Checks zur Rekonstruktion eines Teils des Dienstes.
Kund*innen und vulnerablen Nutzer*innen
Kund*innen lieferten Belege für fehlerhafte Dienste und persönliche Folgen. Sie kontrollierten üblicherweise weder Streuung noch Reparatur noch alternativen Zugriff auf Kapazität. Ratschläge zur Nutzung alternativer Geräte, Ortswechsel oder Nachbarn können Schaden mindern, verlagern aber keine infrastrukturelle Verantwortung auf die Nutzerseite.
Diese Kontrollkarte vermeidet zwei Fehler.
Erstens die Behauptung, der Akteur nahe der physischen Beschädigung sei für alle nachgelagerten Folgen verantwortlich. Zweitens die Annahme, verteilte Verantwortung bedeute keine Verantwortung. Unterschiedliche Parteien kontrollierten unterschiedliche Präventions-, Kontinuitäts-, Wiederherstellungs- und Evidenzfunktionen.
Verantwortlichkeit verlangt nicht den Nachweis böser Absicht
Der öffentliche Datensatz beschreibt versehentliche Beschädigung durch Fischereitätigkeit. [4][11][16]
Dieses Ergebnis schränkt die Einordnung des Ereignisses ein. Die verfügbare Evidenz stützt nicht die Rahmung als Sabotage, geopolitische Attacke oder vorsätzliche Störung.
Das nimmt die Verantwortlichkeit nicht weg.
Infrastruktur wird häufig durch normale Ursachen geschädigt: Baggerarbeiten, Anker, Schleppnetzseile, Wetter, Wartungsfehler und Konfigurationsfehler. Ein Resilienzsystem ist deshalb nötig, weil diese Ursachen vorhersehbar sind, auch wenn der genaue Zeitpunkt nicht ist.
Die Verantwortlichkeitsfragen lauten daher:
- War die Route angemessen geschützt und überwacht?
- War die zweite Route tatsächlich unabhängig?
- Hatten Dienste tatsächlich nutzbaren Zugang dazu?
- Wurde Failover getestet?
- War die Back-up-Kapazität ausreichend?
- Konnten Helfer beschädigte Fasern wiederherstellen?
- Waren Notfallvereinbarungen aktuell?
- War die Reparatur bereit?
- Wurde die Öffentlichkeit über weiterhin Unverfügbarkeiten informiert?
- Reduzierte die Nachbereitung die Wiederholungsgefahr?
Keine dieser Fragen hängt von böswilliger Absicht ab.
Absicht ist für juristische und sicherheitsbezogene Zuschreibung relevant. Kontrolle ist relevant für operative Verantwortlichkeit.
Diese Unterscheidung schützt vor unfairen Schuldzuweisungen. Ein Kabelhalter kann nicht verhindern, dass jedes Fischereifahrzeug ein Kabel berührt. Ein retail-Anbieter kann keinen Unterseekabel reparieren, den er nicht besitzt. Ein lokaler Council kann nicht die Carrier-Backhaul-Routen neu konfigurieren. Die faire Prüfung fragt, was jede Partei vor, während und nach dem Ereignis realistisch tun konnte.
Ein Betreiber kann für Streckenmarkierung, Monitoring, Fehlerlokalisation und Reparaturbereitschaft verantwortlich sein. Ein Carrier kann für alternative Kapazität und getesteten Failover verantwortlich sein. Ein Regulator kann für Resilienzanforderungen und Evidenz verantwortlich sein. Öffentliche Agenturen können für Notfallpläne verantwortlich sein.
Das ist stärker als eine Schuldnarration, weil es steuerbare Kontrollen identifiziert.
Wirkungszahlen brauchen Schichtenlogik
Der Vorfall erzeugte mehrere unterschiedliche Zeit- und Wirkungsmaße.
Ofcoms rund 16 Stunden beziehen sich auf die Hauptphase, in der Bewohner*innen von mobil und Festnetz abgeschnitten waren. Der Regulator beschreibt außerdem zehn Tage Reparaturarbeiten auf beiden Verbindungen vor permanenter Wiederherstellung. [10]
Lokale Quellen berichten, dass einzelne Nutzer*innen während dieser Zeit weiter betroffen blieben, insbesondere dort, wo Anbieter keinen alternativen Zugriff nutzten. [13][18]
Diese Kennziffern sollten nicht zu einem einzigen Vorwurf verdichtet werden, dass alle Kund*innen zehn Tage offline waren.
Ebenso sollten Berichte über „vollständigen Ausfall“ kontextualisiert werden. Die Lageeinschätzung der Regierung besagte, dass zu einem bestimmten Zeitpunkt die meisten Festnetzdienste, alle Internetdienste und alle mobilen Dienste betroffen waren. Ofcom sprach später davon, dass PSTN voice größtenteils über Mikrowellen-Backhaul verfügbar blieb. [4][10]
Diese Sätze können unterschiedliche Zeitpunkte, Dienstdefinitionen und Informationsstände der jeweiligen Institutionen widerspiegeln. Der verantwortbare Ansatz ist die gemeinsame Darstellung beider Sätze ohne erfundene Präzision.
Eine sinnvolle Rechenschaft unterscheidet:
- Zeitraum breit angelegter Serviceausfälle;
- zeitpunkt der temporären Wiederherstellung;
- verbleibende anbieterbezogene Störungen;
- dauerhafte physische Reparatur;
- individuelle Ausfallzeiten der Kund*innen;
- Dauer öffentlicher Notfallumgehungen.
Auch jede Wiederherstellungsauskunft muss Nutzergruppen, Abonnements, Anschlüsse und Dienste getrennt betrachten. Ein Haushalt kann Fest-Breitband, mehrere Mobilabonnements und ein Festnetz haben. Ein Telecare-Alarm kann ausfallen, während ein anderer Sprachdienst arbeitet. Ein Anbieter kann den aggregierten Verkehr wiederherstellen, obwohl eine spezifische Gruppe weiterhin getrennt bleibt.
Ohne anbieterbezogene Aufzeichnungen ist keine vollständige Nutzerzahl oder ein vollständiger finanzieller Verlust ableitbar.
Diese Grenze ist kein zu verbergendes Defizit. Sie ist eine Befundung der Qualität öffentlicher Evidenz.
Wiederherstellungsansprüche brauchen eine Matrix, nicht einen Zeitpunkt
Die Aussage „Dienste wiederhergestellt“ ist für öffentliche Kommunikation notwendig, kann aber eine ungleiche Erholung verschleiern.
Für Shetland waren mindestens vier Wiederherstellungszustände zu unterschiedlichen Zeiten wahr:
- Eine temporäre technische Lösung stellte am 20. Oktober einen Großteil der breiten Dienste wieder her.
- Police Scotland berichtete später, dass normale Kommunikation stabil genug war, um zusätzliche Ressourcen abzubauen. [12]
- Einige Kund*innen und Telecare-Funktionen hatten am 28. Oktober weiterhin Probleme. [13]
- Die vollständige Breitbandwiederherstellung wurde nach dauerhafter Reparatur am 30. Oktober gemeldet. [18]
Eine Wiederherstellungsmatrix macht diese Unterschiede explizit.
Zeilen sollten die Servicefunktionen repräsentieren:
- PSTN voice;
- mobile voice;
- Notrufdienst;
- mobile Daten;
- Fest-Breitband;
- Geschäftskonnektivität;
- Ressourcen des Council;
- Gesundheitssysteme;
- Telecare;
- Zahlungssysteme;
- Flughafen- und Transportkommunikation.
Spalten sollten die Evidenz repräsentieren:
- optischer Link-Status;
- Routen-Erreichbarkeit;
- Sessionaufbau;
- erfolgreiche Transaktionen;
- externe Probes;
- Anbieter-Telemetrie;
- Bestätigung durch Behörden;
- Kundenbeobachtungen;
- Verbleibende Incident-Kohorte.
Ein Dienst sollte erst von „beeinträchtigt“ zu „wiederhergestellt" wechseln, wenn die erforderliche Evidenz vorliegt. Der Standard muss nicht bei jedem Service identisch sein. Notrufdienste können stärkere Tests brauchen als gewöhnliches Web-Browsing. Ein Anbieter kann ausweisen, dass der Dienst für die meisten Nutzenden wiederhergestellt ist, während ein bekanntes Kollektiv weiterhin betroffen bleibt.
Das vermeidet zwei schädliche Extreme.
Das eine ist, auf volle Sicherheit zu warten, bevor irgendein Fortschritt kommuniziert wird. Das andere ist, Totalaussagen zur Wiederherstellung zu machen, obwohl nur der Kerndurchsatz zurückkehrt.
Shetlands gestufte Wiederherstellung ist genau der Typ Fall, für den eine Matrix nützlich ist.
Die regulatorische Lehre ist Evidenz, nicht Schlagworte
Ofcom bezog den Shetland-Vorfall in seine Connected Nations 2022-Diskussion zur Netzwerk- und Serviceresilienz ein. Diese Veröffentlichung verleiht dem Vorfall über die lokale Berichterstattung hinaus regulatorische Bedeutung. [9][10]
Die Lehre sollte nicht auf „mehr Regulierung“ oder „mehr Investitionen“ verkürzt werden.
Ein wirksamer Resilienzrahmen braucht Evidenz, dass Anbieter:
- kritische Abhängigkeiten identifizieren;
- geografische und logische gemeinsame Ausfallmodi verstehen;
- ausreichende alternative Kapazität bereithalten;
- Failover unter realistischer Last testen;
- Notfallzugriff schützen;
- Abbau von Degradation überwachen;
- Major-Incident-Kommunikation durchführen;
- Reparaturfähigkeit bewahren;
- aus beobachtetem Ausfall lernen.
Ofcoms aktuelle General Conditions formulieren breite Verfügbarkeits- und Notfallplanerwartungen. Seine Netzsicherheitsarbeit beschreibt einen Rahmen zur Risikoreduktion und Behebung. Die präzise rechtliche Anwendung hängt von Anbieter, Dienst und Datum ab, und keine event-spezifische Compliance-Feststellung folgt aus den verfügbaren öffentlichen Daten. [6][7][8]
Der Vorfall unterstützt ein Verifikationsprinzip.
Regulierungsbehörden sollten die Existenz einer zweiten Route nicht als Beweis von Resilienz akzeptieren. Sie sollten fragen, welche Dienste sie nutzen können, mit welcher Kapazität, unter welcher Auslösebedingung und mit welchen Testbelegen.
Das ist eine Praxisorientierung gegenüber Telekommunikationskontinuität. Ein Diagramm ist ein Entwurfsanspruch. Beobachtete Umschaltung ist Evidenz.
Die Unterscheidung verbessert auch Investitionsentscheidungen. Wenn der Ausfall durch fehlende physische Vielfalt entstand, sollte eine weitere Route aufgebaut werden. Wenn alternative Kapazität existierte, aber Anbieter nicht zugreifen konnten, sollten Zugang und Interkonnektion verbessert werden. Wenn Failover zu langsam war, sollten Automatisierung und Verfahren verbessert werden. Wenn Notfallsysteme auf eine Technologie angewiesen waren, sollte deren Pfad diversifiziert werden. Wenn Reparaturlogistik dominierte, sollten Ersatzteile und Schiffsarrangements verbessert werden.
Unterschiedliche Fehlermuster brauchen unterschiedliche Abhilfen.
Shetland ist nicht Tonga
Eine sinnvolle Vergleichsbezugnahme ist der 2022er Kabelbruch in Tonga. Beide Ereignisse betreffen Inseln, Unterseekabel, Fallback-Kapazität, Reparaturschiffe und Abhängigkeit öffentlicher Dienste.
Der gemeinsame Wortschatz macht sie noch keine Duplikate.
Der Tonga-Ereignis war geprägt durch die Schädigung der Hauptinternationalen Leitung nach der Eruption von Hunga Tonga-Hunga Ha'apai und danach ausgelöster Tsunami. Er umfasste vulkanische Seebodeneffekte, eine einzige internationale Unterseekabelroute, begrenzte Satellitenfalle und eine deutlich längere Wiederherstellungsphase für die inländische Konnektivität.
Der Shetland-Vorfall 2022 hatte zwei nominal unterschiedlich ausgerichtete Richtungen, die innerhalb einer Woche beeinträchtigt wurden. Der Datensatz zeigt temporäre optische Wiederherstellung, Aktivierung reservierter Fasern, legacy Mikrowellen-Voice-Fallback und unterschiedliche Resultate je nach Anbieter, je nachdem ob alternativer Kapazitätszugang bestand.
Die Kontrollfragen sind unterschiedlich.
Für Tonga:
- Warum gab es nur eine internationale Faserroute?
- Welche Fallback-Kapazität war vorhanden?
- Waren Reservebestand und Reparaturschiffe bereit?
- Wie sollte ein Land einen langen Wiederherstellungszeitraum nach einem Extremereignis managen?
Für Shetland:
- Waren die zwei installierten Routen operativ unabhängig?
- Welche Dienste konnten die verbleibende oder wiederhergestellte Kapazität nutzen?
- Waren Anbieter mit ausreichendem alternativen Zugriff ausgestattet?
- Wie funktionierten optische, Reservefaser- und Mikrowellenkontrollen?
- Warum unterschieden sich Nachwirkungen je Anbieter?
Der Vergleich ist nützlich, wenn er genau diese Grenzen schärft.
Was der öffentliche Datensatz nicht nachweisen kann
Mehrere materielle Fakten bleiben unbekannt.
Der öffentliche Datensatz gibt nicht preis:
- vollständige SHEFA-2 Faser- und Gerätemetadaten;
- exakte optische Budgets vor und nach Schäden;
- alle Routenkonfigurationen;
- Traffic-Volumina nach Dienst;
- Kapazitätsreservierungen;
- alle Wholesale-Vereinbarungen der Anbieter;
- präzise Kund*innenzahlen je Anbieter;
- vollständige Failover-Logs;
- interne Incident-Commands;
- Protokolle der Reparaturpriorisierung;
- vollständige finanzielle Verluste;
- alle Telecare-Ausfälle;
- getestete Remediations mit Bestätigung.
Er belegt auch nicht, dass die nördliche und südliche Störung einen gemeinsamen Ursprung hatten, dass eine davon böswillig war oder dass jede genannte Institution eine Rechtsverletzung hatte.
Diese Lücken sind wichtig, weil sie die Verteilung der Verantwortlichkeit begrenzen.
Sie definieren zugleich, was ein belastbarer öffentlicher Nachgangsbericht enthalten sollte:
- eine begrenzte Topologie, die Ausfallbereiche zeigt, ohne sensible Details offenzulegen;
- eine Service-Einwirkungszeitleiste;
- die verfügbare alternative Kapazität;
- Failover-Ergebnisse nach Serviceklasse;
- Notfallzugangsbelege;
- temporäre Wiederherstellungsmaßnahmen;
- Reparaturfolge und Einschränkungen;
- Kohorten verbleibender Ausfälle;
- Konfidenz der Ursachenanalyse;
- Remediationsprüfungen.
Ein qualitativ hochwertiger Nachgangsbericht braucht nicht alle angreifbaren Details der Netztopologie preiszugeben. Er braucht ausreichend Evidenz für Kund*innen, öffentliche Stellen und Regulierer, um vermeidbare physische Schäden von steuerbaren Kontinuitätsfehlern zu unterscheiden.
Ein Test für Verantwortlichkeit bei nutzbarer Redundanz
Der Shetland-Vorfall stützt einen wiederverwendbaren Test für Insel- und Randregionenkonnektivität.
1. Mappen Sie den Dienst, nicht nur die Ressource
Identifizieren Sie jeden Pfad vom Kundenzugang über lokale Aggregation, Unterseekabeltransport, Anbieterkern, Authentifizierung bis zur externen Interkonnektion. Markieren Sie gemeinsame Landeeinrichtungen, Stromversorgung, Routing und Management-Abhängigkeiten.
2. Geografische Unabhängigkeit belegen
Dokumentieren Sie physische Trennung in wahrscheinlichen Schadenszonen, Landeeinrichtungen und Landabschnitten. Eine Nord- und Südbezeichnung beweist nicht, dass alle relevanten Segmente unabhängig sind.
3. Nutzbare Kapazität reservieren
Geben Sie an, wie viel alternative Kapazität während eines Ausfalls gebucht ist. Schließen Sie kritische Dienste und degradierte Betriebszustände ein.
4. Anbieter an die Alternative binden
Zeigen Sie, dass jeder abhängige Anbieter technische und kommerzielle Fähigkeit besitzt, die Route zu nutzen. Eine gesunde Faser, auf die ein Dienst nicht zugreifen kann, ist für diesen Dienst keine Redundanz.
5. End-to-End-Failover testen
Führen Sie kontrollierte Übungen durch, die Routing, Sessions, DNS, Authentifizierung, Voice, Notrufdienste und öffentliche Serviceanwendungen verifizieren. Dokumentieren Sie das Ergebnis und beheben Sie Lücken.
6. Mindestfunktionale Kontinuität definieren
Definieren Sie, welche Funktionen bestehen müssen, wenn normale Breitbandkapazität nicht verfügbar ist. Sprache, Notfallkoordination und Telecare können unterschiedliche Fallback-Pfade benötigen.
7. Ruhende Steuereinheiten inventarisieren
Reservefasern, Mikrowellenlinks und Satellitenterminals sollten Eigentümer, Aktivierungsprozesse, Kompatibilitätstests und Monitoring besitzen.
8. Physische Reparatur vorbereiten
Pflegen Sie Fehlerlokalisierung, Ersatzteile, Kabel-Schiff-Vereinbarungen, Landeeinsätze, Wetterannahmen und Reparaturprioritäten.
9. Wiederherstellung anhand von Diensten messen
Verwenden Sie eine Matrix, die optische Wiederherstellung, Routenwiederherstellung und kundenorientierte Servicewiederherstellung unterscheidet. Bewahren Sie verbleibende Kohortendaten auf.
10. Begrenzte Evidenz veröffentlichen
Erklären Sie, was ausfiel, was funktionierte, was unbekannt blieb und wie Remediation getestet wurde. Nutzen Sie den Begriff „resilient“ nicht als Ersatz für Nachweis.
Fazit
Der Shetland-Ausfall 2022 wurde durch zwei physische Kabelprobleme innerhalb eines kurzen Zeitfensters ausgelöst. Dieses Timing war unglücklich. Verteilung und Dauer des Dienstschadens wurden durch Steuerung bestimmt.
Ofcom verzeichnete etwa 16 Stunden einen breiten Verlust von mobilen und festen Diensten, legacy Mikrowellenunterstützung für weiten Teil der PSTN-Sprachversorgung, vorläufige Wiederherstellung durch erhöhte optische Leistung und zehn Tage Reparatur auf beiden Glasfaserverbindungen. Die Aufzeichnungen von Regierung und Betreiber zeigen versehentliche Beschädigung durch Fischereitätigkeit, Aktivierung von Reservefaser und vorbeugenden Satellitenbetrieb. Die Council-Dokumentation zeigte anbieterbezogene Restausfälle und Telecare-Probleme. Police Scotland stellte physischen Notfallzugang bereit, während die normale Kommunikation unsicher war.
[4][10][12][13][15]
Zusammen führen diese Fakten eine einfache Annahme ins Gegenteil.
Two cables do not equal two usable services.
Redundanz existiert nur, wenn der Alternativpfad Kapazität hat, abhängige Anbieter ihn erreichen können, Failover funktioniert, kritische Funktionen überleben und die Wiederherstellung nachweislich erfolgt. Eine Linie in einem Netzdiagramm ist eine Designbehauptung. Die Verantwortlichkeits-Evidenz ist das tatsächliche Verhalten des Netzes, als eine Linie bereits eingeschränkt war und die andere beschädigt wurde.
Das ist die bleibende Prüfung aus Shetland: Nicht ob eine zweite Route installiert war, sondern wer nachweisen konnte, dass sie nutzbar war, als Kontinuität davon abhing.
Quellen
- https://news.sky.com/story/complete-outage-on-shetland-leaves-phones-internet-and-computers-unusable-12725347
- https://news.stv.tv/highlands-islands/internet-and-mobile-services-restored-in-shetland-after-power-outage-caused-by-damaged-subsea-cables
- https://news.stv.tv/highlands-islands/shetlands-damaged-subsea-cable-to-faroe-islands-now-repaired-confirms-operator
- https://www.gov.scot/binaries/content/documents/govscot/publications/foi-eir-release/2024/01-b/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/documents/202200331574---annex-a/202200331574---annex-a/govscot%3Adocument/202200331574%2B-%2BAnnex%2BA.pdf
- https://www.gov.scot/publications/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/
- https://www.ofcom.org.uk/internet-based-services/network-security
- https://www.ofcom.org.uk/internet-based-services/network-security/ofcom-begins-new-role-overseeing-security-of-telecoms-networks
- https://www.ofcom.org.uk/phones-and-broadband/accessibility/general-conditions-of-entitlement
- https://www.ofcom.org.uk/phones-and-broadband/coverage-and-speeds/connected-nations-2022
- https://www.ofcom.org.uk/siteassets/resources/documents/research-and-data/multi-sector/infrastructure-research/connected-nations-2022/connected-nations-uk-report.pdf?v=321647
- https://www.parliament.scot/chamber-and-committees/questions-and-answers?ref=S6W-12628
- https://www.scotland.police.uk/what-s-happening/news/2022/october/update-landline-and-mobile-phone-outage-shetland-resolved/
- https://www.shetland.gov.uk/news/article/2404/continuing-problems-affecting-connectivity-in-shetland-including-some-telecarecommunity-alarm-lines
- https://www.shetnews.co.uk/2022/10/21/cable-fault-the-third-reported-in-waters-around-shetland-since-mid-september/
- https://www.shetnews.co.uk/2022/10/24/perfect-storm-of-cable-failure-was-incredibly-bad-luck/
- https://www.shetnews.co.uk/2022/10/25/subsea-cable-fault-took-place-a-few-kilometres-off-shetland-telecoms-chief-says/
- https://www.shetnews.co.uk/2022/10/26/more-digital-disruptions-as-cable-repairs-get-under-way/
- https://www.shetnews.co.uk/2022/10/31/shetland-fully-connected-once-again/
- https://www.theguardian.com/uk-news/2022/oct/20/shetland-loses-telephone-internet-services-subsea-cable-damaged
- https://www.theguardian.com/uk-news/2022/oct/21/telephone-and-internet-restored-in-shetland-after-cable-damage
Mitgliederbriefing
Detaillierter Profilkontext
Melden Sie sich mit der richtigen Mitgliedschaftsstufe an, um das vollständige Briefing und die Quellennotizen freizuschalten.
Nur für Strategic Circle
Strategic Circle
Offen für alle Leser. Schalten Sie Profil-Briefings nach Beitritt und Anmeldung frei.
Strategic Circle beitretenNur für Leadership Alliance
Leadership Alliance
Für qualifizierte Inhaber von IP-Assets und Management; melden Sie sich an, um Leadership-Alliance-Briefings freizuschalten.
Leadership Alliance beitreten