
Resumo
A Meta publicou a pesquisa e os checkpoints originais do V-JEPA em 15 de fevereiro de 2024. O treinamento previa características latentes de regiões ocultas usando o contexto visível, sem texto, rótulos humanos, encoder de imagem pré-treinado, exemplos negativos ou reconstrução de pixels.
Nas avaliações, o backbone de representação ficava congelado, mas probes leves eram treinados para tarefas específicas. Cada resultado continuava preso ao checkpoint, conjunto de dados, resolução, amostragem, probe e protocolo exatos.
O artefato inicial não era gerador de vídeo, sistema de legendas, interface de linguagem, planejador autônomo ou produto. Linguagem, previsão condicionada à ação, robótica e condições comerciais posteriores do V-JEPA 2 não se aplicam retroativamente.
Cerca de dois milhões de vídeos de conjuntos públicos não eliminavam procedência, licença, consentimento ou representatividade. Qualquer fluxo privado ainda precisava fixar entrada, retenção, proteção dos embeddings, abstinência, revisão e autoridade humana.
O evento correto é o lançamento original
O nome V-JEPA reapareceu em trabalhos posteriores, mas a evidência deve seguir os bytes e a data. Este artigo trata apenas da versão de 15 de fevereiro de 2024. Checkpoints, dados, objetivos, avaliações e termos posteriores formam registros distintos.
Sem essa separação, uma demonstração posterior de linguagem ou robótica parece ter existido no primeiro encoder. A cronologia mostra o contrário. A versão inicial pesquisava representações e apresentava planejamento como direção futura.
Também não era um serviço. Autenticação, retenção, interface, monitoramento, suporte e permissão para agir não vinham no checkpoint. Adicionar essas camadas criaria outro sistema, que precisaria de testes e responsabilidades próprios.
A previsão acontecia no espaço latente
O V-JEPA dividia um vídeo em contexto visível e regiões-alvo mascaradas. Um caminho representava o contexto; o preditor estimava a representação do alvo. A comparação ocorria entre características, não entre um quadro verdadeiro e uma reconstrução pixel a pixel.
Esse objetivo podia evitar gastar capacidade em textura, iluminação ou ruído imprevisível. Ainda assim, uma representação útil não prova compreensão física completa. Fundo, movimento de câmera ou edição podem oferecer atalhos que funcionam em um teste e falham em outro ambiente.
Máscaras, duração do clipe, seleção de quadros e pré-processamento pertencem à configuração. Alterá-los muda a pergunta de aprendizado. Uma reprodução precisa guardar esses valores junto ao hash do checkpoint.
Prever características não gera vídeo
A palavra previsão pode sugerir uma sequência futura visível. O objetivo original produzia uma representação numérica. Não entregava, por si, quadro reconstruído, legenda, explicação ou probabilidade calibrada de evento.
Um decoder adicional poderia transformar a representação em uma visualização, mas acrescentaria treinamento e erros próprios. Essa imagem seria saída do sistema combinado, não prova de que o encoder original gerava vídeo.
Da mesma forma, um probe precisa converter embeddings em um vocabulário definido. Depois, uma política decide como usar o rótulo. A incerteza não desaparece; ela passa por várias camadas.
Autossupervisão não é autovalidação
A Meta informou que o pré-treinamento não usava texto, anotações humanas, encoder de imagem pré-treinado, negativos ou reconstrução pixel a pixel. O isolamento permitia testar diretamente o valor da previsão de características de vídeo.
As escolhas humanas continuavam presentes na arquitetura, nas máscaras, na mistura de dados, na otimização, na computação e nas avaliações. Autossupervisionado descreve a formação do alvo; não significa que o modelo verificou legalidade, qualidade ou representatividade.
Dados sem rótulos ainda podem conter atalhos. Cenário, enquadramento ou câmera podem correlacionar com uma atividade. Testes locais devem variar essas pistas mantendo o fenômeno relevante, para descobrir o que o probe realmente utiliza.
Dois milhões de vídeos ainda têm linhagem
A pesquisa usou cerca de dois milhões de vídeos reunidos de conjuntos públicos. Escala pode ampliar padrões observados, mas público não é licença universal. Cada fonte preserva contexto de coleta, condições, pessoas retratadas e cobertura geográfica.
Um arquivo disponível pode mostrar pessoas, locais e atividades sensíveis. Acesso técnico não responde se o conteúdo deve ser usado para treinamento, avaliação ou decisão. Finalidade, consentimento, retenção e reutilização precisam de análise própria.
A mistura também pode favorecer ações populares, iluminação boa e câmeras comuns. Eventos raros ou condições locais podem faltar. Uma média de benchmark não demonstra cobertura de todos os grupos ou contextos.
Backbone congelado ainda significa probe treinado
As avaliações mantinham o encoder fixo e treinavam um probe leve por tarefa. Isso mede informação acessível sem ajustar o backbone, mas não elimina rótulos, aprendizado downstream ou definição de classe.
Arquitetura do probe, divisão rotulada, semente, otimização e limiar afetam o resultado. A frase correta é backbone congelado com probe treinado. Dizer apenas sem adaptação esconde a etapa que transforma vetores em rótulos.
Um cabeçote pequeno pode ser instável, desigual ou excessivamente confiante. Seu tamanho não concede autoridade. Aceitação depende de testes locais, abstinência e consequência do uso.
O número pertence à configuração
Resultados dependiam do checkpoint, dados, resolução, amostragem temporal, pré-processamento, probe e vistas de avaliação. Manter apenas o nome V-JEPA remove o denominador necessário para reproduzir e comparar.
Resolução muda o detalhe visível; amostragem muda o instante observado; vocabulário do probe muda a pergunta. Um resultado de pesquisa da Meta sustenta uma conclusão estreita dentro do protocolo citado, não confiabilidade universal.
Uma aceitação local precisa de erros por classe, casos raros, abstinências, revisões humanas, computação e latência do caminho completo. A média e a velocidade isolada do encoder podem esconder custos e falhas importantes.
Embedding não é explicação nem permissão
Uma representação pode guardar informação útil sem dizer por que o probe escolheu uma classe. O vetor não é justificativa causal. Vizinhos e visualizações dependem da métrica e das referências escolhidas, servindo como diagnóstico.
O probe pode usar fundo ou movimento de câmera como atalho. Testes controlados devem mudar esses sinais enquanto preservam a ação pretendida. Uma pontuação alta não prova que o conceito correto causou a decisão.
Rótulos podem ajudar busca e priorização sem decidir acesso, sanção ou ação de segurança. O processo deve nomear quem confirma, rejeita, corrige e interrompe.
A licença não comercial é uma porta separada
A Meta apresentou o V-JEPA original sob termos Creative Commons não comerciais. Disponibilidade para pesquisa não significa autorização geral para produto pago, redistribuição ou serviço comercial.
A equipe deve fixar revisão do repositório, bytes do checkpoint e texto de licença. Desempenho técnico, permissão jurídica e segurança operacional são decisões diferentes. Probe e dados locais acrescentam outras condições.
Termos posteriores do V-JEPA 2 não mudam arquivos anteriores. A licença segue a linhagem exata. Não é válido usar um checkpoint antigo com um anúncio mais recente para ampliar a permissão.
Linguagem e planejamento pertencem ao futuro
O primeiro encoder não recebia perguntas em linguagem natural nem produzia legendas. Ligar um modelo de linguagem cria um sistema composto, com riscos de alinhamento errado entre características e palavras e de conteúdo inventado.
Também não escolhia ações. Planejamento requer objetivo, espaço de ações, feedback, política de incerteza e interrupção. Experimentos posteriores do V-JEPA 2 usavam artefatos diferentes e não provam que a primeira versão fazia robótica.
Vídeo privado exige controles fora do modelo
Antes da codificação, uma organização precisa definir fonte legal, finalidade, acesso e retenção. Deve minimizar quadros e identificadores desnecessários. Taxa de quadros, duração, corte, resolução e normalização precisam ser registrados.
Depois, embeddings também merecem proteção, pois podem conservar informação sobre pessoas e atividades. O probe precisa de limiares calibrados e abstinência. Casos desconhecidos devem chegar a uma fila humana com contexto suficiente.
O revisor deve poder rejeitar e corrigir. Monitoramento deve acompanhar erros por classe, abstinências, reversões e mudança de ambiente, ligando cada degradação a restrição, reavaliação, rollback ou retirada.
Um recibo completo conecta toda a cadeia
O recibo mínimo registra hash, revisão, licença, tamanho, resolução, amostragem, pré-processamento, backbone congelado, arquitetura do probe, dados rotulados, semente, vistas, erros, computação e latência completa.
Ele acrescenta procedência, consentimento, representatividade, retenção e exclusão dos vídeos locais. Define abstinência, escalonamento, contestação e correção. Exclui explicitamente geração, legendas, linguagem, planejamento, robótica e V-JEPA 2.
Se faltar uma ligação, a aceitação deve parar. Checkpoint desconhecido, licença não fixada, probe sem registro ou dados não representativos impedem dizer o que foi testado e qual autoridade seria razoável.
A contribuição é forte porque tem limites
O V-JEPA mostrou que previsão de características latentes podia sustentar probes úteis em condições definidas. Esse resultado já orienta pesquisa e avaliação; não precisa ser ampliado para uma afirmação de entendimento físico geral.
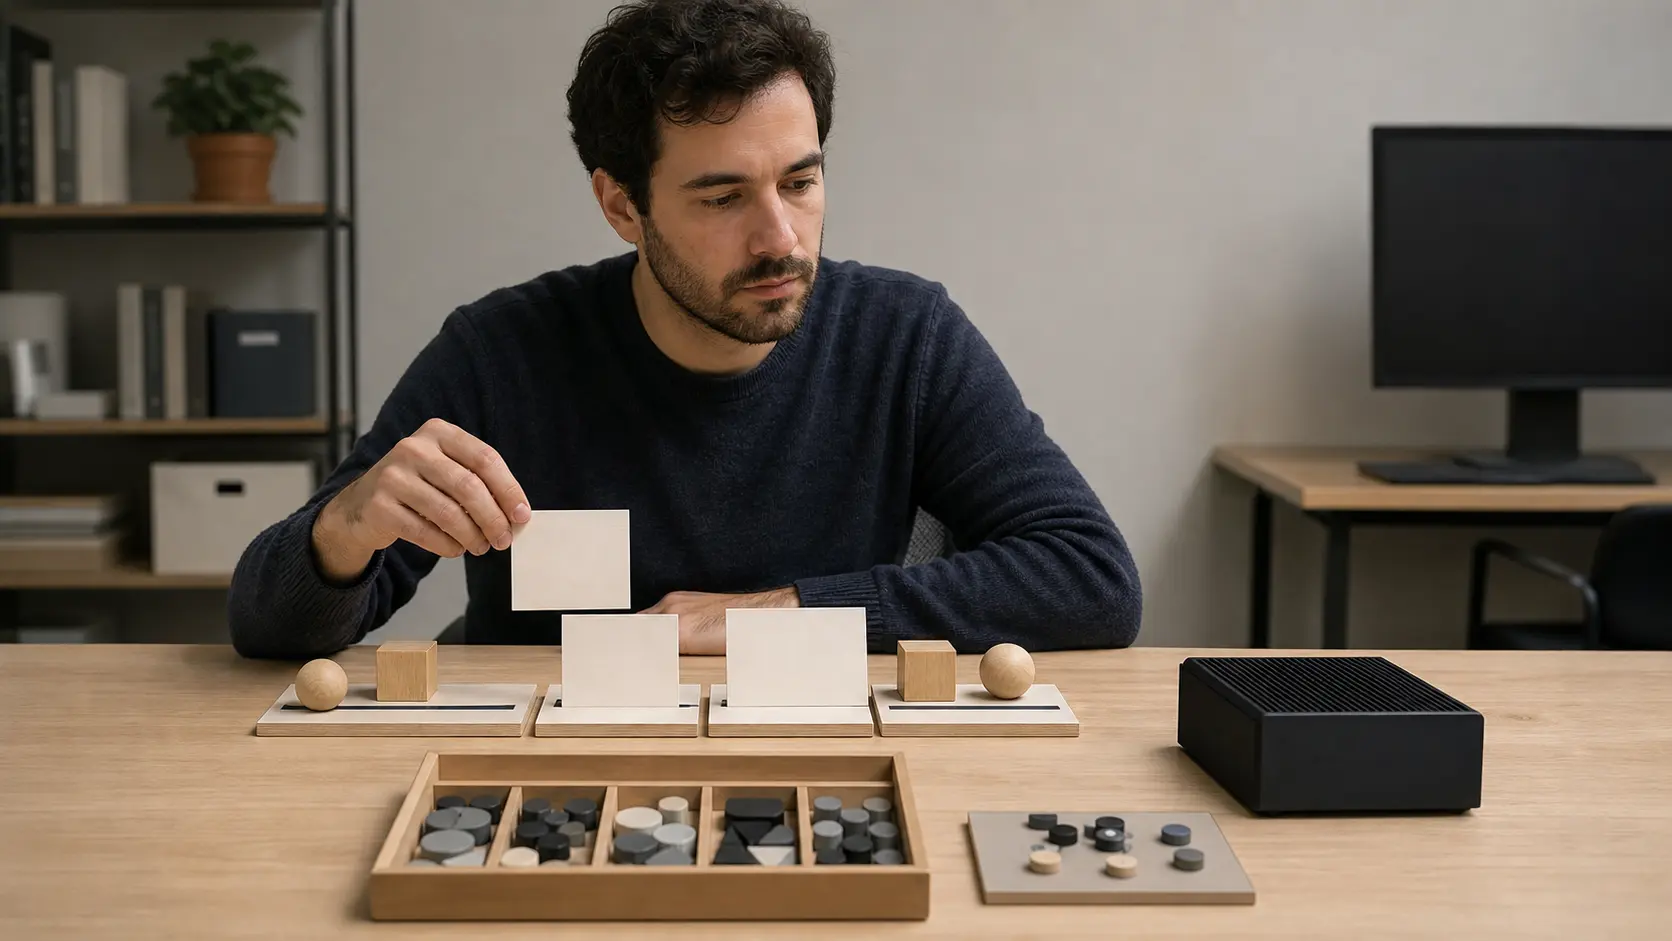
A imagem editorial mantém o mesmo limite. O pesquisador fictício, os cartões cobertos, os tokens e o quadro de probe são adereços, não equipe ou instalação da Meta, checkpoint, dataset, saída, benchmark, licença ou prova de segurança.
Fontes
- Meta AI Research, publicação original de 15 de fevereiro de 2024: https://ai.meta.com/research/publications/revisiting-feature-prediction-for-learning-visual-representations-from-video/
- Meta FAIR, repositório JEPA e contexto dos checkpoints: https://github.com/facebookresearch/jepa
- Bardes e coautores, artigo original do V-JEPA: https://arxiv.org/abs/2404.08471
- Meta, relato contemporâneo e limite de trabalho futuro: https://ai.meta.com/blog/v-jepa-yann-lecun-ai-model-video-joint-embedding-predictive-architecture/
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance