
Resumo
- O Slurm aloca nós, CPUs, memória, GPUs e outros recursos, transformando partições, prioridades, regras de qualidade de serviço, fair-share e reservas em decisões de fila.
- TRES, GRES, topologia e cgroups permitem que operadores agendem aceleradores como recursos físicos restritos; apenas a contagem de GPUs não garante posicionamento útil nem execução eficiente.
- Os desenvolvedores do Slurm fundaram a SchedMD em 2010 para oferecer engenharia comercial, suporte e treinamento; a NVIDIA adquiriu a empresa em 15 de dezembro de 2025 e se comprometeu a manter o desenvolvimento de código aberto e neutro em relação a fornecedores.
- A credibilidade após a aquisição dependerá de testes com vários fornecedores, do comportamento dos lançamentos e dos padrões de contribuição, enquanto cada operador de cluster continua responsável pela política que seus usuários realmente experimentam.
Uma GPU ociosa não é necessariamente uma GPU disponível
Em um cluster Slurm, um acelerador fisicamente ocioso não vai automaticamente para a próxima pessoa que o solicita. Um trabalho primeiro precisa ser elegível para uma partição, ajustar-se ao formato de recurso solicitado, satisfazer regras de conta e de qualidade de serviço, evitar reservas que bloqueiem os nós necessários e superar em prioridade os trabalhos concorrentes. Só então o escalonador aloca os recursos e permite que o trabalho seja iniciado.
Essa sequência faz do Slurm mais do que uma fila. Ele é um plano de controle de admissão e alocação para uma ampla classe de sistemas de computação de alto desempenho e IA. Usuários submetem trabalhos; oslurmctldos avalia contra o estado do cluster e as políticas; os processosslurmdnos nós de computação iniciam e monitoram o trabalho; oslurmstepdgerencia etapas individuais de trabalho. Um serviço opcional, oslurmdbd, registra trabalhos, uso de recursos e relações de conta em um banco de dados.
A consequência é tanto econômica quanto técnica. Um cluster de IA pode ter GPUs suficientes no total e ainda assim não conseguir iniciar um grande trabalho de treinamento porque os dispositivos livres estão fragmentados nos nós errados, estão atrás de uma topologia inadequada ou estão reservados para outro projeto. Um escalonador pode reduzir esse desperdício ao representar as restrições relevantes. Ele não pode criar GPUs ausentes, corrigir uma malha congestionada ou tornar útil um aplicativo ineficiente.
A importância do Slurm vem, portanto, das decisões que ele toma antes de o aplicativo ser executado. O projeto passou mais de duas décadas transformando uma pergunta simples — quem pode usar qual máquina agora? — em um sistema configurável para alocar infraestrutura cada vez mais heterogênea e cara.
O Slurm transforma políticas locais em tempo de máquina
O Slurm começou em uma colaboração liderada pelo Lawrence Livermore National Laboratory e apareceu pela primeira vez em 2002. Sua função inicial era coordenar trabalhos paralelos submetidos de forma independente em grandes clusters Linux, sem exigir que cada aplicativo entendesse a máquina inteira. A arquitetura original separou a alocação de recursos da execução dos trabalhos e expôs uma camada de controle comum que podia ser adaptada entre instituições.
Essa separação básica continua visível. O controlador mantém uma visão central dos nós, dos trabalhos e do estado de agendamento, enquanto os daemons dos nós de computação executam o trabalho que já foi autorizado. Um controlador de backup e o estado persistido podem reduzir o impacto de uma indisponibilidade do controlador, mas a alta disponibilidade ainda depende de estado coerente, autenticação funcional, alcance de rede e procedimentos de recuperação testados. “Tolerante a falhas” é uma capacidade de projeto, não uma garantia de que toda falha no plano de controle seja inofensiva.
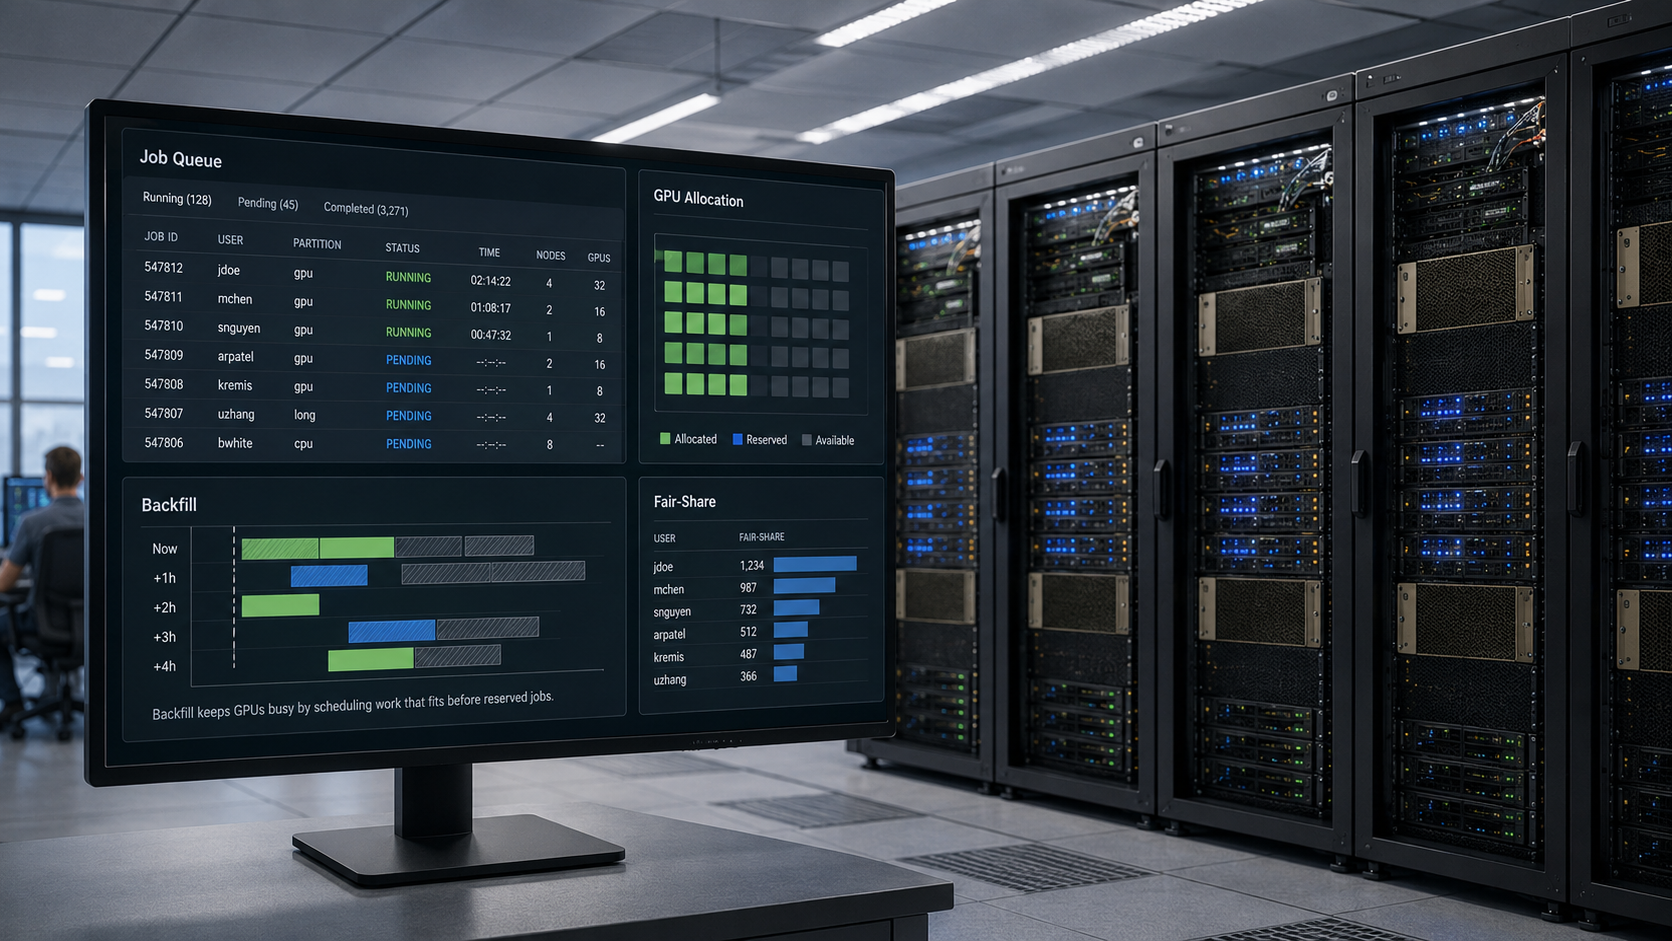
A mudança mais profunda veio à medida que o Slurm acumulou primitivas de política. Partições agrupam nós em classes de serviço ou pools administrativos. Associações conectam usuários e contas a cotas, limites e uso histórico. Regras de qualidade de serviço podem alterar prioridade, limites ou comportamento de preempção. Reservas mantêm recursos para manutenção, eventos ou usuários específicos. A prioridade multifatorial pode combinar idade, fair-share, tamanho do trabalho, partição, QOS e fatores definidos pelo site.
Não existe uma definição universal de justiça no Slurm. Uma universidade pode favorecer projetos que usaram menos do que sua alocação de longo prazo. Um laboratório nacional pode reservar capacidade para uma campanha. Um operador comercial de GPUs pode criar níveis de serviço diferenciados. O mesmo software consegue expressar as três opções porque o site define a política.
Essa flexibilidade é um dos pontos fortes do Slurm e um de seus riscos operacionais. Uma fila pode ficar difícil de explicar quando partições se sobrepõem, exceções se acumulam e vários sistemas de ponderação interagem. Os usuários passam a perceber o resultado como arbitrário mesmo quando o software está implementando exatamente a configuração definida. O escalonador pode calcular a prioridade; a instituição ainda precisa justificar a política.
O fair-share determina quem espera, não o que significa justiça
O fair-share costuma ser discutido como se fosse uma propriedade objetiva do escalonador. Na prática, é um mecanismo para transportar as escolhas de alocação de uma instituição ao longo do tempo. O uso histórico, a hierarquia de contas e as cotas configuradas podem influenciar a prioridade futura, de modo que um grupo que consumiu menos do que sua cota receba vantagem sobre um grupo que consumiu mais.
Isso faz da contabilização parte da governança. Oslurmdbdpode registrar trabalhos, etapas, associações e recursos rastreáveis em um ou mais clusters. Administradores usam esses registros para relatórios, chargeback, limites de uso e cálculos de fair-share. Um campo de banco de dados que parece administrativo pode, portanto, afetar quando um pesquisador ou uma equipe de engenharia receberá computação escassa novamente.
A qualidade do registro contábil importa. Se os usuários forem mapeados para a conta errada, o uso de recursos não for registrado de forma consistente ou os dados históricos forem retidos incorretamente, a prioridade resultante pode ser tecnicamente válida e institucionalmente errada. Mudanças na participação em projetos, contas de serviço compartilhadas e registros corrigidos manualmente precisam de governança porque o escalonador pode tratá-los como evidência sobre o direito de acesso.
Esse é um dos motivos pelos quais disputas de fila são difíceis de reduzir a um bug de software. Uma espera longa pode ser causada por demanda, solicitações imprecisas de tempo de execução, uma reserva, um fator de fair-share baixo, um requisito de topologia, uma regra de QOS ou simplesmente um trabalho que não cabe nos recursos livres atuais. O Slurm expõe os mecanismos, mas o operador precisa de observabilidade suficiente para reconstruir qual deles importou.
Para os usuários, a explicabilidade é, portanto, parte da qualidade do serviço. Uma fila é mais fácil de aceitar quando as pessoas conseguem ver por que um trabalho está pendente, qual política se aplica e o que permitiria que ele fosse iniciado. À medida que os clusters se tornam mais caros e comercialmente mais importantes, essa transparência vira uma questão de gestão, e não uma conveniência para pesquisadores.
O backfill transforma lacunas vazias em trabalho útil
Uma fila estritamente por prioridade pode desperdiçar capacidade. Um trabalho grande e de alta prioridade pode ser o primeiro da fila, mas não conseguir iniciar até que nós suficientes fiquem livres. Sem lógica adicional, trabalhos menores que poderiam terminar antes dessa reserva também esperariam, deixando recursos ociosos.
O escalonador com backfill do Slurm aborda esse problema estimando quando trabalhos de maior prioridade podem começar e, então, iniciando trabalhos de menor prioridade que devem terminar sem atrasá-los. O escalonador não pergunta simplesmente qual trabalho vem a seguir. Ele pergunta se um trabalho pode usar uma abertura temporária preservando o início esperado dos trabalhos à sua frente.
O mecanismo é poderoso porque grandes clusters são frequentemente fragmentados. Alguns nós terminam cedo; outros continuam ocupados. Um trabalho curto pode caber na lacuna sem mudar o horário de início do trabalho que a instituição considera mais importante. O backfill pode, portanto, melhorar a utilização e reduzir o tempo de espera ao mesmo tempo.
Sua eficácia depende das informações que recebe. Se os usuários solicitarem muito mais tempo de execução do que precisam, o escalonador pode concluir que um trabalho não cabe com segurança. Se solicitarem menos tempo do que o necessário, o trabalho pode ser encerrado antes de terminar. Restrições de topologia e de aceleradores podem tornar inutilizável uma lacuna teoricamente disponível. Falhas podem invalidar o cronograma esperado.
O backfill ilustra em miniatura o modelo de operação do Slurm. O software pode tomar uma decisão sofisticada a partir do estado declarado, mas não pode conhecer o futuro perfeitamente. Melhores resultados de fila dependem de solicitações precisas, estado confiável do cluster e políticas que deem ao escalonador espaço suficiente para fazer concessões.
As GPUs tornaram o formato de uma alocação tão importante quanto seu tamanho
Os aceleradores mudaram o significado de “capacidade disponível”. Uma solicitação de oito CPUs costuma ser mais intercambiável do que uma solicitação de oito GPUs em um trabalho de treinamento distribuído. O modelo do acelerador, a capacidade de memória, as relações PCIe ou NVLink, a posição na rede e a composição dos nós podem determinar se a alocação terá o desempenho esperado.
O Slurm representa recursos heterogêneos por meio de Trackable RESources, ou TRES, e Generic RESources, ou GRES. GPUs podem ser contadas, tipadas e associadas a nós. A integração com dispositivos e cgroups pode restringir um trabalho aos aceleradores que lhe foram alocados. Plugins de topologia e restrições podem ajudar o escalonador a posicionar o trabalho com alguma consciência da máquina física.
Isso transforma a GPU de um periférico acoplado em uma unidade econômica agendável. Administradores podem contabilizar o uso de aceleradores, limitar o acesso, reservar tipos específicos de dispositivo e desenhar políticas em torno de hardware escasso. Para infraestrutura de IA, isso é importante porque a fila muitas vezes decide o acesso ao componente mais caro do cluster.
Um modelo de recursos, no entanto, só é tão útil quanto a topologia que captura. Oito GPUs livres espalhadas por nós com caminhos de comunicação inadequados podem não equivaler a oito GPUs dentro de dois servidores fortemente conectados. Um escalonador pode escolher com base na topologia configurada, mas não consegue inferir automaticamente toda dependência de rede, memória ou aplicativo.
O mesmo limite se aplica à utilização. Um painel pode mostrar GPUs alocadas enquanto o trabalho espera por armazenamento, comunicação coletiva, carregamento de dados ou falhas repetidas. O Slurm pode dizer ao operador quem deteve o recurso e quando. Ele não prova, por si só, que o acelerador estava realizando trabalho produtivo.
O escalonador fica acima da malha, mas continua dependente dela
O Slurm não está no caminho dos dados. Quando um trabalho começa, o tráfego do aplicativo passa por processadores, memória, interconexões e armazenamento sem passar pelo escalonador. Isso não torna o escalonador independente da infraestrutura física.
As escolhas de posicionamento podem concentrar ou espalhar o trabalho entre switches, blocos ou domínios de aceleradores. Uma alocação ciente da topologia pode reduzir a distância de comunicação de um trabalho paralelo. Uma alocação cega à topologia pode transformar capacidade bruta suficiente em um trabalho de baixo desempenho porque a largura de banda útil está em outro lugar.
O escalonador também depende de um estado preciso dos nós. Uma GPU pode estar presente, mas degradada. Um nó pode estar alcançável pelo controlador enquanto seu caminho de armazenamento está degradado. Uma partição de rede pode fazer um trabalho em execução parecer diferente da visão do controlador. Plugins, verificações de saúde dos nós e operações locais precisam traduzir essas condições físicas em estados sobre os quais o escalonador possa agir.
Isso cria uma fronteira fácil de interpretar mal em relatórios de desempenho. Se um trabalho roda devagar, a causa raiz pode ser a alocação, o comportamento do aplicativo, o armazenamento, a disputa de rede, a saúde do acelerador ou uma combinação desses fatores. Se o cluster está ocioso, a causa pode ser demanda baixa, fragmentação, reservas ou falhas, e não um algoritmo de agendamento ruim.
Para operadores, a medida útil é, portanto, o caminho inteiro do pedido ao trabalho concluído: atraso na fila, qualidade da alocação, sucesso na inicialização, tempo de execução, repetições, trabalho perdido e conclusão final. A alocação agregada de GPUs é informativa, mas não é o mesmo que produção útil.
A SchedMD transformou um projeto aberto em um negócio de suporte
À medida que o Slurm foi além de suas origens de laboratório, as organizações precisaram de mais do que código-fonte. Clusters de produção exigiram lançamentos previsíveis, depuração, ajuda em atualizações, treinamento e engenheiros capazes de trabalhar com configurações incomuns de cada site. Os desenvolvedores do Slurm fundaram a SchedMD em 2010 para oferecer essa camada comercial.
O arranjo criou um acordo típico de código aberto. O código continuou disponível abertamente sob a licença do projeto, enquanto clientes pagavam por conhecimento especializado, suporte e desenvolvimento em torno de sistemas de produção difíceis. O trabalho comercial deu aos mantenedores um caminho para financiar engenharia contínua e deu aos operadores um canal de escalonamento quando a fila que controla um grande cluster se comportava de forma inesperada.
A SchedMD também se tornou um ponto de concentração de conhecimento. Sistemas grandes de agendamento acumulam detalhes operacionais difíceis de aprender apenas com documentação: recuperação de falhas, ordem de atualizações, interações entre plugins, casos extremos de contabilização e efeitos de políticas incomuns. Uma empresa que emprega mantenedores-chave pode transformar essa experiência em vantagem de suporte sem ser dona de toda contribuição ou de toda implantação.
Essa distinção importa porque a política do Slurm sempre permaneceu local. A SchedMD podia entregar código, correções e orientações; ela não decidia os pesos de fair-share, reservas ou direitos de conta dentro de uma universidade, laboratório nacional ou serviço comercial de IA. A experiência do usuário do Slurm é em parte software upstream e em parte a constituição da própria instituição.
Quando a IA ampliou o valor da capacidade de GPU agendada, o papel da SchedMD já era, portanto, maior do que o de um fornecedor convencional de software. Ela era a principal guardiã comercial de um plano de controle aberto que muitos operadores já haviam incorporado a seus fluxos de trabalho, scripts, sistemas de contabilização e procedimentos operacionais.
A NVIDIA mudou os incentivos em torno da tutela do projeto
A NVIDIA anunciou a aquisição da SchedMD em 15 de dezembro de 2025. Ela afirmou que o Slurm continuaria aberto e neutro em relação a fornecedores, argumentando que os desenvolvedores da SchedMD teriam acesso a mais sistemas acelerados e recursos de engenharia. A licença não se tornou proprietária de repente, e a aquisição não transferiu dos operadores para a NVIDIA a política local de agendamento.
O que mudou foi a estrutura de incentivos em torno do principal administrador comercial do projeto. A NVIDIA não é apenas uma empresa de software que financia mantenedores. Ela também é uma fornecedora líder de GPUs, redes e sistemas cujo desempenho pode depender de como as cargas de trabalho são descobertas, posicionadas e iniciadas.
Isso cria um benefício plausível e uma preocupação plausível. O acesso antecipado a sistemas complexos de IA pode melhorar os testes e encurtar o caminho entre mudanças de hardware e suporte no escalonador. A mesma proximidade levanta uma questão legítima: aceleradores, interconexões e designs de sistema concorrentes continuarão a receber atenção de primeira classe?
As evidências disponíveis nos primeiros meses após a aquisição não justificam declarar captura nem neutralidade perfeita. O desenvolvimento público continuou. O Slurm 26.05 e os patches seguintes mostraram trabalho ativo de lançamento, enquanto os patches de julho de 2026 trataram de travamentos e outras questões operacionais. O Slinky também continuou a evoluir. Esses são indicadores de gestão mais fortes do que uma promessa feita no dia da aquisição, mas não resolvem a questão comparativa de longo prazo.
A NVIDIA também descreveu o Slurm como amplamente usado em sistemas de supercomputação de referência e afirmou que a SchedMD atendia centenas de clientes na época da aquisição. Essas declarações indicam escala, mas continuam sendo fornecidas pela empresa e datadas. Não são um censo completo de clusters privados de IA, sistemas de pesquisa ou todas as implantações de escalonadores.
A questão da neutralidade deve, portanto, ser formulada como um teste de engenharia observável. As interfaces continuam genéricas onde podem ser? Questões que afetam hardware concorrente são tratadas de forma aberta e rápida? Os processos de lançamento e os ambientes de integração contínua exercitam uma base de hardware genuinamente heterogênea? Contribuidores externos ainda conseguem influenciar o código sem passar por um produto proprietário da NVIDIA?
O código aberto dá aos operadores um direito de saída, não uma substituição gratuita
A licença de código aberto do Slurm importa porque os operadores podem inspecionar, modificar e redistribuir o código sob seus termos. Isso cria uma barreira formal contra uma simples conversão em software fechado e dá à comunidade um caminho legal para fazer um fork se a gestão se tornar inaceitável.
Um fork viável, no entanto, não é criado apenas por uma licença. Agendamento em larga escala precisa de mantenedores que entendam estado do controlador, contabilização, plugins, lançamentos, segurança e uma matriz ampla de hardware. Precisa de sistemas de teste, confiança dos usuários e pessoas dispostas a fazer backport de correções entre versões suportadas.
O custo prático de troca também é muito maior do que substituir um executável. Ambientes maduros de Slurm acumulam scripts de trabalhos, estruturas de contas, uso histórico, plugins personalizados, monitoramento, procedimentos operacionais e hábitos dos usuários. Outro escalonador pode ser tecnicamente capaz e ainda assim exigir uma migração cara de políticas e de memória institucional.
É por isso que a propriedade da NVIDIA merece escrutínio sem tratar a possibilidade de fork como resposta completa. A forma mais forte de neutralidade não é a capacidade teórica de sair depois de um problema. É um projeto que permanece útil em infraestrutura heterogênea antes que sair se torne necessário.
O mesmo raciocínio se aplica ao suporte comercial. Os operadores podem depender da experiência da empresa que emprega os mantenedores-chave mesmo quando o código é aberto. Se essa experiência se estreitar em torno de um ecossistema de hardware, o código-fonte pode continuar disponível enquanto a fronteira prática do suporte se torna menos neutra.
O Slinky coloca dois planos de controle no mesmo ambiente
A infraestrutura moderna de IA combina cada vez mais agendamento em lote com Kubernetes. Equipes de plataforma podem querer Kubernetes para provisionamento, operadores, serviços e o ciclo de vida dos contêineres, mantendo o modelo de trabalhos do Slurm, o fair-share, as reservas e a semântica de cargas paralelas.
O Slinky é a tentativa da SchedMD de conectar esses mundos. Seuslurm-operatorpode implantar e gerenciar componentes do Slurm por meio de mecanismos orientados a Kubernetes, enquanto oslurm-bridgecoordena o trabalho entre Kubernetes e Slurm sobre recursos compartilhados. A versão 1.2.0 foi lançada em 2 de julho de 2026, depois que a primeira linha estável apareceu no fim de 2025.
A atração é clara. Uma organização pode preservar as políticas já estabelecidas do Slurm enquanto usa ferramentas nativas de nuvem para gerenciar a infraestrutura ao redor. Isso pode reduzir a necessidade de construir um ambiente operacional totalmente separado para computação em lote.
A dificuldade é a autoridade. Kubernetes e Slurm têm modelos diferentes de estado desejado, propriedade da carga de trabalho e recuperação. Se ambos os sistemas acreditarem que controlam um nó, um dispositivo ou uma carga de trabalho após uma falha, a integração precisa de uma resposta clara sobre qual estado é o autoritativo e como o outro sistema é reconciliado.
Isso não é motivo para rejeitar a abordagem. É a razão pela qual o Slinky deve ser julgado por evidências operacionais, e não pela elegância arquitetural. Implantações de produção precisam mostrar como atualizações, fencing, RBAC, falhas de controlador e partições parciais de rede são tratados quando dois sistemas de orquestração estão envolvidos.
A história do Slurm expandiu repetidamente a fronteira daquilo que o escalonador coordena. A integração com Kubernetes continua esse padrão, mas cada nova superfície de controle aumenta a importância de saber para onde a responsabilidade se move quando algo quebra.
A fila pode melhorar a utilização e ainda assim produzir um resultado ruim
O Slurm dá aos operadores muitas formas de tornar a capacidade cara mais útil. O backfill pode reduzir lacunas ociosas. O fair-share pode distribuir o acesso ao longo do tempo. O posicionamento ciente da topologia pode melhorar a localidade. Reservas podem proteger trabalhos críticos. A preempção pode abrir espaço para trabalhos urgentes ou premium.
Cada mecanismo também tem um custo. Uma reserva pode deixar capacidade ociosa se o trabalho esperado não chegar. A preempção pode destruir trabalho útil quando aplicativos não conseguem fazer checkpoint. Uma regra de topologia pode preservar o desempenho de um trabalho enquanto aumenta a fragmentação para outros. O fair-share pode recompensar uma política que não corresponde mais às prioridades da instituição.
O risco cresce quando operadores otimizam uma única métrica. Uma alocação alta de GPUs pode ser alcançada mantendo dispositivos atribuídos a trabalhos que estão parados em outro ponto. Um tempo de fila baixo pode ser alcançado admitindo trabalhos em formatos de recurso que prolongam a execução. A preempção agressiva pode proteger um nível de serviço enquanto desperdiça energia e computação já gastas em trabalhos interrompidos.
Para infraestrutura de IA, a melhor medida é o trabalho útil concluído por unidade de capacidade escassa e tempo. O Slurm contribui para esse resultado, mas é apenas uma camada. Frameworks de treinamento, armazenamento, desenho de rede, checkpointing, saúde dos aceleradores e a qualidade das solicitações dos usuários afetam se a alocação cria valor.
Essa também é a fronteira entre a responsabilidade upstream e a local. Se um site escolhe uma política que privilegia uma conta, usa reservas em excesso ou define regras de preempção irreais, o resultado não deve ser automaticamente atribuído à SchedMD ou à NVIDIA. Se o escalonador calcula mal o estado, trata mal um dispositivo ou introduz uma regressão, o comportamento upstream se torna a camada relevante.
Uma operação confiável precisa de auditabilidade suficiente para distinguir esses casos.
A superfície de controle real está dividida entre vários atores
A administração do Slurm pode parecer central porque um único controlador agenda o cluster e uma única empresa hoje emprega muitos dos especialistas do projeto. Na prática, o controle é dividido.
Mantenedores upstream decidem qual código entra nos lançamentos. A NVIDIA é dona da SchedMD e pode alocar recursos de engenharia. Fornecedores de hardware contribuem com trabalhos de integração e fornecem sistemas para testes. Administradores de cluster escolhem versões, plugins, modelos de topologia, contas, QOS e limites. Líderes institucionais decidem quem tem direito à computação escassa. Usuários decidem quais recursos solicitar e com que precisão descrevem o tempo de execução. O aplicativo, então, determina se a alocação é usada com eficiência.
Esse controle em camadas é o fato central do Slurm. Nenhum ator isolado é dono do resultado inteiro.
Isso também explica por que a governança da fila se tornou estrategicamente importante. Quando os aceleradores eram menos escassos e menos valiosos, uma regra subótima podia ser apenas irritante. Em um grande parque de IA, a mesma regra pode mudar tempos de espera, fragmentação e a quantidade de capacidade cara que conclui trabalho útil.
A realização do Slurm é que um sistema aberto comum pode expressar modelos de alocação muito diferentes sem forçar toda instituição a adotar uma única definição de justiça. Sua limitação é idêntica: o software não pode garantir que o modelo escolhido seja sensato, legível ou legítimo.
O teste de longo prazo não é, portanto, se o Slurm continua agendando trabalhos. É se os operadores ainda conseguem reconstruir por que um trabalho recebeu ou perdeu acesso à computação escassa, enquanto o projeto upstream continua confiável em todo o hardware heterogêneo que esses operadores querem executar.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance