
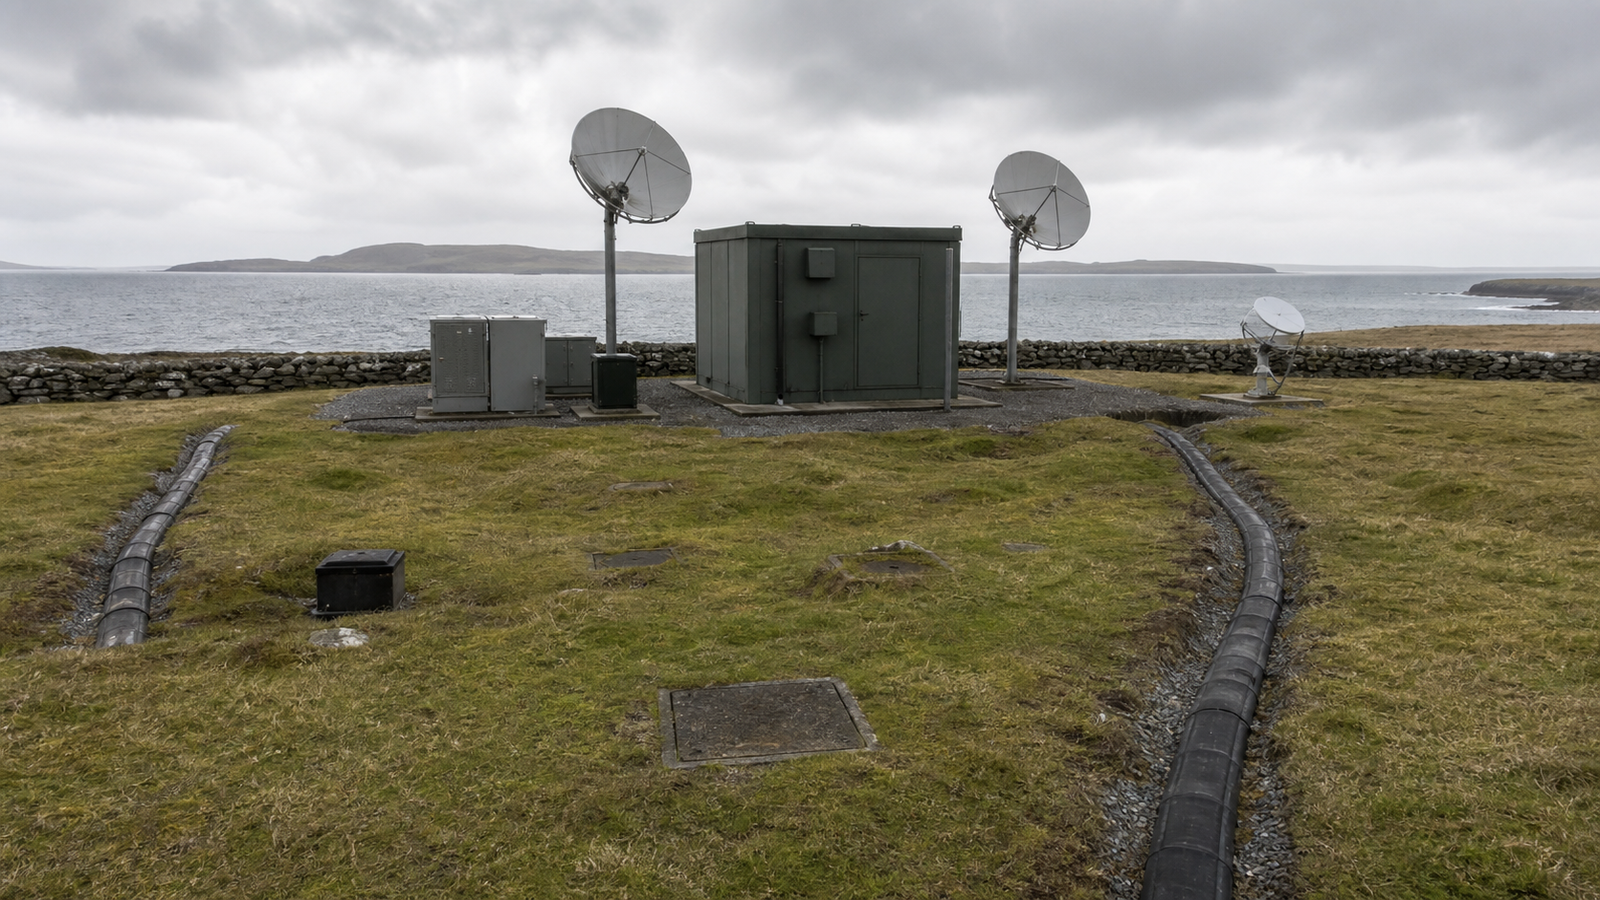
Resumo
- A Ofcom informou que moradores de Shetland perderam serviços de telefonia móvel e fixa por cerca de 16 horas em outubro de 2022, depois que o enlace de fibra submarina sul foi danificado enquanto um enlace secundário já estava indisponível por danos ocorridos na semana anterior. [10]
- A Ofcom disse que um backhaul legado de micro-ondas de baixa largura de banda manteve a maior parte da voz PSTN disponível. Também informou que a restauração temporária foi alcançada com o aumento da potência óptica na origem e que os reparos nos dois enlaces principal e secundário levaram cerca de dez dias. [10]
- Registros de correspondência do Governo Escocês registram problemas intermitentes no enlace resiliente a partir de 14 de outubro e descrevem o enlace principal como danificado acidentalmente por um barco pesqueiro registrado no Reino Unido logo após meia-noite de 20 de outubro. O registro público não sustenta a alegação de sabotagem. [4][5][11]
- Declarações da Faroese Telecom divulgadas na época relataram que técnicos ativaram capacidade de fibra reserva ou não utilizada no cabo danificado e reconectaram boa parte do serviço transportado na fibra da BT. A própria formulação diz respeito a uma evidência sobre uma ação de recuperação específica, não prova de que todo serviço ou provedor tenha sido recuperado ao mesmo tempo. [15][20]
- O Shetland Islands Council afirmou que alguns clientes permaneceram offline porque seus provedores não tinham conexões resilientes e não conseguiam acessar fibra sem dano. O Conselho também reportou problemas afetando alguns serviços de teleassistência e alarmes comunitários. [13]
- A Police Scotland enviou oficiais e viaturas para preservar o acesso aos serviços de emergência enquanto as comunicações normais estavam comprometidas. [12]
- A questão de accountability não é se existiam dois cabos físicos. É quem controlou capacidade alternativa utilizável, acesso do provedor, fallback óptico e de micro-ondas, arranjos de emergência, sequência de reparo e a evidência usada para declarar serviços restaurados.
- Contratos completos de provedores, políticas de roteamento, orçamentos ópticos, populações de clientes e registros de perda não são públicos. As evidências sustentam uma análise de controle, não uma acusação provedor a provedor.
- A comparação mais próxima é a ruptura de cabo de Tonga em 2022, mas os casos são distintos. Tonga tinha uma rota internacional principal, dano do fundo marinho por atividade vulcânica e logística de reparo longa. Shetland expôs a lacuna entre rotas aparentemente diversas e acesso de serviço a capacidade sobrevivente.
Uma grande interrupção pode existir dentro de um diagrama redundante
Redundância é uma das palavras mais tranquilizadoras da infraestrutura.
Ela sugere que a falha de um componente não se tornará a falha de um serviço. Um segundo cabo, roteador, alimentação elétrica, data center ou plano de controle é esperado para absorver a carga. O termo costuma aparecer em diagramas de arquitetura, documentos de aquisição, submissões regulatórias e matrizes de risco executivas muito antes de alguém ver se isso funciona de fato.
O apagão de Shetland em outubro de 2022 mostra por que redundância instalada e redundância utilizável precisam ser tratadas como fatos diferentes.
As ilhas eram conectadas por rotas de fibra submarina passando ao sul via Orkney em direção ao continente escocês e ao norte em direção às Ilhas Faroé. O registro público descreve uma como rota principal e a outra como rota resiliente ou secundária. Na semana anterior a 20 de outubro, o enlace norte já estava prejudicado. Pouco depois da meia-noite de 20 de outubro, o enlace sul foi danificado. A Ofcom resumiu o resultado em perda aproximada de 16 horas nos serviços móveis e fixos. [4][10]
À primeira vista, o evento pode ser descrito como azar: duas falhas físicas em poucos dias. O dano foi relatado como acidental. Um barco pesqueiro foi identificado no registro público. O reparo de cabos exige navios, janelas de clima, equipes especializadas e acesso físico aos pontos de falha. Nenhum desses fatos é trivial. [4][11][16]
Mas azar não responde à questão operacional.
Por que um sistema com duas rotas gerou interrupção tão ampla? Por que alguns serviços voltaram rapidamente enquanto alguns clientes permaneceram afetados por grande parte da semana seguinte? Por que a voz legada permaneceu mais disponível do que serviços dependentes de dados? Por que um conjunto de tráfego pôde usar capacidade restaurada ou alternativa enquanto outro não?
Essas perguntas movem a análise para além da existência de aço, vidro e equipamentos de aterragem. Elas movem para os controles que transformam infraestrutura em serviço:
- disponibilidade de rota;
- potência óptica e margem;
- pares de fibra utilizáveis;
- capacidade reservada e sobrante;
- configuração de comutação e roteamento;
- acesso atacado;
- arranjos de provedor de varejo;
- backhaul de fallback;
- planos de serviço de emergência;
- prioridade de reparo;
- monitoramento de serviço;
- evidência de restauração.
Uma segunda rota pode estar fisicamente presente, mas indisponível porque já está danificada. Pode estar saudável e ainda assim não ter capacidade suficiente. Pode haver capacidade sem um caminho contratual ou técnico para um serviço específico. Um provedor pode ter uma rota no papel e falhar em testar o estado de failover. Um backup de baixa largura de banda pode manter a voz enquanto banda larga continua indisponível. Um operador pode restaurar luz pelas fibras sem provar que todo serviço a jusante recuperou.
O registro de Shetland contém exemplos de várias dessas condições. É isso que o torna um caso de accountability de infraestrutura de rede e não uma história genérica sobre corte de cabo.
As duas falhas devem permanecer separadas
O evento exige dois relógios.
Correspondência do Governo Escocês diz que o cabo resiliente apresentou problemas intermitentes desde 14 de outubro e que a Faroese Telecom enviou equipes para trabalhar nele. O segundo evento ocorreu pouco depois da meia-noite de 20 de outubro, quando o cabo principal foi danificado. A correspondência descreve a causa como dano acidental por um navio pesqueiro registrado no Reino Unido e diz que o evento afetou quase todos os serviços transportados naquele cabo. [4]
O relato posterior da Ofcom usa linguagem operacional ligeiramente diferente. Diz que um enlace de fibra secundário já estava indisponível por danos ocorridos na semana anterior. Diz também que o cabo de fibra sul sofreu perda de luz. [10]
Essas descrições não devem ser achatadas em uma alegação de que dois cabos foram limpos e rompidos no mesmo momento.
O registro público distingue indisponibilidade intermitente, indisponibilidade, efeitos de fibra, perda de luz e reparo de cabo. O diretor executivo da Faroese Telecom foi citado dizendo que a ruptura posterior afetou fibras, mas não cortou totalmente o cabo. Reportagens locais situam a falha a alguns quilômetros de Shetland e descrevem um navio reparador atuando em mais de um local. [15][16][18]
Essa distinção importa por três razões.
Primeiro, o mecanismo físico afeta as opções de recuperação. Uma quebra total, um par de fibras danificado, um problema de amplificador, um problema de alimentação de potência e margem óptica reduzida não são a mesma falha. Podem permitir medidas temporárias diferentes.
Segundo, a descrição afeta responsabilidades. O proprietário de um cabo pode controlar reparo e restauração óptica. Um operador pode controlar posicionamento de tráfego. Um provedor varejista pode depender de um caminho atacado. Uma autoridade pública pode controlar resposta de emergência. Dar um único rótulo ao evento inteiro pode ocultar essas fronteiras.
Terceiro, a distinção evita exagero retrospectivo. O incidente foi grave sem precisar afirmar que cada cabo foi completamente cortado ou que todo serviço ficou indisponível por dez dias. A aproximação de 16 horas da Ofcom descreve a perda principal de serviços móveis e de linha fixa. O período de dez dias descreve trabalho nos dois enlaces de fibra antes da restauração permanente. Alguns problemas residuais de serviço seguiram entre esses marcos. [10][13][18]
Uma cronologia responsável, portanto, separa pelo menos cinco estados:
- A rota norte ou secundária desenvolve problemas.
- O trabalho de reparo começa enquanto a rota sul ainda mantém serviço.
- A rota sul é danificada e segue perda ampla de serviço.
- Medidas temporárias de potência óptica e capacidade restauram boa parte do tráfego.
- Falhas residuais específicas de provedor continuam até os reparos permanentes concluírem.
Essa sequência é mais útil que uma única duração de interrupção porque cada estado expõe controles e responsáveis de decisão diferentes.
Diversidade física não é diversidade de serviço
A resiliência de rede é frequentemente medida na camada errada.
Na camada física, Shetland tinha mais de uma direção de conectividade por fibra. Uma rota seguia para Orkney e para a Escócia continental. Outra seguia para as Ilhas Faroé. A geografia parece diversa.
No entanto, na camada de serviço, o cliente não compra uma direção abstrata pelo leito marinho. O cliente compra banda larga, celular, voz ou serviço institucional. Esse serviço atravessa uma cadeia de equipamentos de acesso, agregação local, transporte atacado, roteamento do provedor, autenticação, sistemas centrais e interconexão a montante. Cada elo dessa cadeia precisa de uma alternativa operacional se o serviço precisa sobreviver a uma falha de cabo.
A atualização de 28 de outubro do Council é incomum porque registra diretamente o problema de camada de serviço. Informou que usuários ainda sem internet eram atendidos por empresas sem conexões resilientes. Esses provedores não conseguiam acessar a fibra íntegra e dependiam de reparos. [13]
Esse enunciado não publica todos os contratos ou tabelas de roteamento. Não prova por que cada provedor não teve acesso. Não mostra se a limitação era comercial, técnica, histórica ou combinação de fatores. Não deve ser convertida em uma alegação ampla de que empresas nomeadas recusaram deliberadamente resiliência.
O que prova é que capacidade física alternativa não se traduz automaticamente em serviço alternativo para todos os clientes.
Esse é um padrão recorrente de falha em infraestrutura.
Um data center pode ter duas entradas de energia que compartilham uma subestação a montante. Um aplicativo em nuvem pode rodar em dois availability zones enquanto depende de um único plano de controle de identidade. Um operador móvel pode ter transporte redundante enquanto ambas as rotas terminam no mesmo roteador. Um registry pode ter vários name servers que recebem a mesma zona malformada. Uma ilha pode ter duas direções de cabo enquanto o serviço de um provedor é alcançável por apenas um caminho operacional ou comercial.
Em cada caso, contar componentes superestima a resiliência. A pergunta correta é se os domínios de falha são independentes até o serviço.
Para Shetland, isso significa testar:
- se os caminhos norte e sul foram fisicamente independentes nos pontos de falha;
- se os segmentos de aterragem e terrestre evitaram pontos comuns;
- se havia capacidade suficiente no caminho alternativo;
- se os provedores estavam autorizados e configurados para usá-lo;
- se o failover podia ocorrer automaticamente;
- se os procedimentos de rerroteamento manual estavam atualizados;
- se dependências de serviço como DNS, autenticação e gestão permaneceram alcançáveis;
- se tráfego de emergência e de serviços públicos teve prioridade;
- se os clientes puderam ser medidos por serviço restaurado, não apenas por luz restaurada.
O registro público responde a algumas dessas perguntas e deixa outras em aberto. Essas lacunas de evidência fazem parte da accountability e devem permanecer explícitas.
O aumento da potência óptica foi um controle de recuperação
O relato da Ofcom contém um detalhe técnico que muda a narrativa.
Ele informa que o cabo de fibra sul sofreu perda de luz e que a restauração temporária foi alcançada com aumento da potência óptica de saída na origem. [10]
Sistemas de fibra óptica dependem de um orçamento de enlace. O sinal lançado na fibra perde potência conforme percorre cabo, repetidores, conectores e outros componentes. Um receptor precisa de sinal suficiente para distinguir os dados de forma confiável. O dano pode aumentar a perda sem destruir toda a fibra. Se o caminho remanescente tem margem, alterar as condições de emissão pode restaurar temporariamente um sinal utilizável.
O relatório público não divulga o projeto óptico exato, os níveis de potência, os pares de fibra ou os limiares de engenharia. Seria incorreto reconstruir esses detalhes apenas por princípios gerais. Ainda é razoável identificar a superfície de controle.
Alguém teve que:
- detectar que o problema era uma condição de perda de luz;
- definir quais fibras ou serviços continuavam recuperáveis;
- avaliar se potência adicional era segura e útil;
- autorizar a alteração;
- monitorar erros e estabilidade;
- decidir qual tráfego poderia retornar;
- manter o trabalho permanente de reparo em andamento.
Isso não é o mesmo controle de possuir uma segunda rota.
A restauração óptica também cria uma exigência de evidência. "Luz restaurada" é um fato necessário da rede, mas não é o mesmo que "serviço do cliente restaurado". Uma fibra pode passar sinal enquanto roteamento, autenticação, capacidade ou caminhos posteriores de provedores permanecem comprometidos. O registro de recuperação deve, portanto, ligar medições físicas a testes de serviço.
Um relatório de restauração com accountability separaria:
- continuidade óptica;
- estabilidade da camada de enlace;
- alcançabilidade roteada;
- handoff de provedor;
- estabelecimento de sessão de banda larga;
- backhaul móvel e alcançabilidade de núcleo;
- serviço de voz;
- chamada de emergência;
- acesso a aplicações de serviço público;
- disponibilidade observada pelo cliente.
O incidente de Shetland mostra por que essa abordagem em camadas importa. Grande parte do serviço retornou em 20 de outubro, embora o Council ainda sinalizasse problemas de internet e teleassistência em 28 de outubro. [13]
Sucesso de engenharia temporário e recuperação de serviço completa não foram o mesmo marco.
A fibra reserva importou porque pôde ser ativada
Reportagens locais contemporâneas adicionam outro mecanismo de recuperação.
A Shetland News relatou que a Faroese Telecom ativou capacidade de fibra reserva e não utilizada no cabo danificado. O relatório diz que essa capacidade havia sido reservada para uso posterior e que a ativação ajudou a reconectar serviços transportados em fibra BT. O diretor executivo do operador afirmou que a falha afetou fibras sem cortar totalmente o cabo e que técnicos restauraram serviços na medida do possível. [15]
A redação é reportagem atribuída, não um anexo técnico de engenharia da Ofcom. Deve ser usada com esse nível de confiança. Mesmo assim, demonstra um princípio importante: infraestrutura reserva só tem valor se os respondentes conseguem ativá-la durante o incidente.
Fibras de reserva podem existir em várias formas. Um cabo pode conter fibras não iluminadas, capacidade não utilizada em pares iluminados ou capacidade reservada para crescimento. Converter essa reserva em serviço pode exigir equipamentos, configuração, direitos de uso, interfaces compatíveis e coordenação operacional.
As questões de accountability são práticas:
- o inventário de capacidade reserva existia?
- os operadores conheciam seu estado?
- ela estava conectada a equipamentos que pudessem ser usados durante uma falha?
- os procedimentos de ativação foram testados?
- quem tinha autoridade para alocá-la?
- quais serviços tinham prioridade?
- provedores a jusante conseguiram alcançá-la?
- havia margem suficiente para operação sustentada?
- o monitoramento mostrou que o caminho temporário estava estável?
O incidente sugere que ao menos parte da capacidade reservada foi convertível em restauração real. Também sugere que essa conversão não cobriu todos os serviços a jusante.
Esta é uma lição mais útil do que afirmar apenas "construir mais cabos". Mais ativos físicos podem reduzir risco, mas um cabo que não pode ser alcançado, comutado, energizado, contratado ou operado durante uma falha é um diagrama caro. Investimento em resiliência precisa de testes de aceitação operacional.
Para cada rota alternativa, um provedor deveria ser capaz de mostrar:
- os serviços mapeados para a rota;
- a capacidade disponível sob falha;
- o gatilho para o failover;
- os comandos ou automação usados;
- as pessoas autorizadas a agir;
- as dependências que permanecem fora da rota;
- os resultados de teste;
- o objetivo de recuperação;
- o risco residual.
Sem essa evidência, capacidade de sobra é possibilidade, não controle.
Micro-ondas de baixa largura de banda preservaram um tipo diferente de continuidade
A Ofcom diz que a voz PSTN das linhas fixas permaneceu em grande parte disponível por causa de backhaul de micro-ondas legado de baixa largura de banda. [10]
Essa frase não deve ser lida como prova de que todas as linhas fixas funcionaram ou de que a comunicação de emergência ficou sem impacto. Relatórios do governo escocês descreveram perda ampla em serviços fixos, internet e celular, e a Police Scotland ainda posicionou presença física para preservar o acesso de emergência. [4][12]
Os dois registros podem coexistir.
Micro-ondas legado pode preservar um caminho de voz delimitado enquanto serviços de alta largura de banda falham. A disponibilidade pode variar por central, provedor, serviço, local e tempo. Uma ligação de baixa largura de banda insuficiente para tráfego de internet normal pode ainda carregar parte da voz. Por outro lado, um cliente dependente de serviço digital ou específico de provedor pode não se beneficiar desse caminho legado.
Isso lembra que fallback deve ser projetado em torno de funções mínimas viáveis, não apenas da capacidade normal.
Durante uma falha severa de comunicações, as prioridades podem incluir:
- chamadas de emergência;
- coordenação entre polícia, bombeiros, ambulâncias e guarda costeira;
- comunicações hospitalares e do health board;
- alarmes de teleassistência;
- alertas públicos;
- contato governamental essencial;
- funções críticas de pagamento e logística;
- gestão de equipes de reparo.
Um caminho de fallback pode ser valioso mesmo sem reproduzir a banda larga ordinária. A tarefa de engenharia e governança é identificar quais serviços ele precisa suportar e provar que podem usá-lo.
O incidente de Shetland também mostra o risco de tratar infraestrutura antiga como resiliência acidental. Se um caminho de micro-ondas legado está carregando função de segurança, seu papel deve ser documentado, mantido e testado. Se sua remoção está prevista, a arquitetura de substituição precisa de uma trajetória de falha equivalente ou melhor antes da retirada.
Em contrário, a modernização pode remover uma camada oculta de continuidade.
Sistemas legados não devem ser romantizados. Baixa largura de banda, cobertura limitada e equipamentos envelhecidos criam seus próprios riscos. O ponto de accountability é mais estreito: o valor de fallback é determinado pelo serviço que consegue preservar, não se é novo ou antigo.
O acesso de emergência transformou a recuperação de rede em dever público
Interrupções de comunicação tornam-se eventos de segurança pública quando as pessoas não conseguem contatar organizações de emergência com confiabilidade.
A Police Scotland afirmou que oficiais e viaturas foram deslocados para garantir que o público tivesse acesso a serviços de emergência. Depois do retorno da normalidade nas comunicações, esses recursos foram retirados. [12]
Reportagens contemporâneas descreveram orientação para tentar 999 por linha fixa ou celular e, se falhasse, sinalizar um veículo de emergência ou ir a uma delegacia, hospital, bombeiros ou ambulância. Patrulhas extras e um polo físico de emergência foram usados como substitutos da alcançabilidade normal. [19]
Essas alternativas importam porque revelam o serviço real em proteção.
Um número de emergência não é só um recurso telefônico. Depende de:
- disponibilidade da rede de acesso;
- roteamento de chamada;
- localização do chamador quando tecnicamente disponível;
- interconexão com organizações de emergência;
- energia em sites do cliente e da rede;
- conhecimento público de alternativas;
- pessoal e alcançabilidade física quando comunicações falham.
As condições gerais de elegibilidade da Ofcom descrevem requisitos voltados à ampla disponibilidade, acesso ininterrupto a organizações de emergência e arranjos para prestação ou restauração rápida durante desastre. As obrigações legais aplicáveis a um provedor e a um evento específico exigem análise jurídica, e diretrizes consolidadas atuais não devem ser aplicadas retroativamente sem cautela. Ainda assim, isso mostra por que o acesso de emergência é tratado como mais que uma métrica comum de experiência de cliente. [8]
A resposta de Shetland deve ser avaliada em duas camadas.
A primeira é prevenção e recuperação de rede. As rotas de chamada de emergência eram diversas? O backhaul de voz remanescente funcionava? Chamadas móveis alcançavam a rede de emergência? Os provedores tinham arranjos testados com as organizações de emergência?
A segunda é contingência civil. Quando a alcançabilidade de rede ficou incerta, as autoridades estabeleceram alternativas visíveis, movimentaram recursos, verificaram pessoas vulneráveis e se comunicaram por canais ainda ativos?
Polícia e autoridades locais controlaram a segunda camada. Elas não controlaram condição do cabo ou roteamento atacado. Sua resposta reduziu danos, mas não deve ser usada para desculpar fragilidades na camada de rede.
Um bom workaround de emergência é evidência de resiliência. Não é evidência de que o serviço original atingiu seu objetivo de disponibilidade.
Teleassistência expôs a dependência abaixo da aplicação
O Shetland Islands Council reportou problemas afetando alguns serviços de teleassistência e alarmes comunitários, inclusive serviços entregues por linhas analógicas. Funcionários contataram clientes e pediram a familiares e amigos que verificassem parentes idosos ou vulneráveis. [13]
Teleassistência costuma ser tratada como dispositivo ou aplicação de assistência social. Em uma interrupção, suas dependências de rede ficam visíveis.
Um colar de alarme ou alarme residencial pode parecer simples ao usuário. Por trás dele existe uma cadeia:
- energia no local;
- a unidade de alarme;
- fiação local ou rádio;
- um acesso por linha fixa, celular ou internet;
- troca e backhaul;
- um centro de monitoramento;
- um processo humano de resposta.
O dispositivo pode estar funcional enquanto o caminho está indisponível. Uma rede pode ser parcialmente restaurada enquanto um alarme específico ainda falha. Um provedor pode relatar recuperação ampla de serviço enquanto um usuário vulnerável segue isolado.
Por isso a restauração de serviço precisa ser medida por função crítica, não apenas tráfego agregado.
O comunicado do Council não diz que todos os alarmes falharam. Diz que alguns serviços foram afetados e descreve uma resposta manual de bem-estar. Essa fronteira é importante porque um sinal de risco não pode ser inflado em uma alegação de dano não suportada.
A conclusão suportada é que continuidade de telecomunicações é continuidade de cuidado. Operadores e agências públicas precisam de um mapa compartilhado de dependências que identifique:
- quais tipos de alarme usam quais tecnologias de acesso;
- de quais caminhos e rotas atacadas e de quais provedores dependem;
- quais pressupostos de bateria ou energia se aplicam;
- como a falha é detectada;
- quem recebe alerta quando o caminho de comunicação falha;
- como inicia o processo manual de bem-estar;
- como a restauração é verificada no dispositivo.
A experiência de Shetland tornou uma interrupção abstrata de rede em uma pergunta específica: a pessoa vulnerável ainda podia pedir ajuda?
Essa pergunta deve integrar o projeto de infraestrutura antes de o cabo quebrar.
Resultados específicos por provedor são evidência, não licença para especular
Diferenças residuais por provedor estão entre as partes mais reveladoras do evento.
O Conselho informou que alguns usuários afetados eram atendidos por empresas sem conexões resilientes e sem acesso à fibra íntegra. Reportagens locais posteriores descrevem alguns provedores como rerroteando enquanto outros permaneceram indisponíveis. [13][18]
É tentador transformar esse registro em uma tabela de provedores responsáveis e irresponsáveis. As evidências não sustentam uma conclusão tão simples.
As fontes públicas não divulgam:
- todos os contratos atacados;
- todas as rotas compradas por cada provedor varejista;
- limites de capacidade em caminhos alternativos;
- o estado exato do equipamento de cada provedor;
- quais clientes estavam em qual infraestrutura;
- se uma tentativa de failover falhou;
- se uma rota era tecnicamente possível, mas comercialmente indisponível;
- quais objetivos de nível de serviço se aplicavam;
- quais informações os provedores receberam durante o reparo.
Um provedor pode não ter alternativa porque não a comprou. Pode depender de um atacado que não a possui. Uma alternativa pode existir, mas ter capacidade insuficiente. O serviço pode compartilhar um domínio de falha local que não sobrevive nem a uma direção. Um processo manual pode ser lento demais. A reportagem pública não resolve todas essas possibilidades.
A abordagem com accountability é pedir evidência.
Cada provedor que vendeu serviço em um mercado geograficamente restrito deve ser capaz de declarar, no nível de segurança adequado:
- os domínios de falha no seu acesso e backhaul;
- a rota alternativa disponível quando um segmento submarino falha;
- a capacidade comprometida nessa rota;
- as condições que disparam failover;
- o teste mais recente ponta a ponta;
- os serviços que podem degradar ou permanecer indisponíveis;
- o alvo de recuperação;
- o plano de comunicação com clientes e autoridades públicas.
Isso não é demanda para publicar topologia sensível. É demanda para provar que "resiliente" está ligado a um controle operacional.
O registro do Council é valioso justamente por relatar comportamento observado de serviço. Alguns usuários não conseguiam usar fibra íntegra. Esse fato deve gerar investigação focalizada sobre o porquê, sem assumir a resposta.
A sequência de reparo distribuiu continuidade
Reparo físico de cabo é operação com restrições.
É necessário localizar a falha. Um navio e tripulação especializados devem estar disponíveis. Condições meteorológicas e de mar precisam permitir o trabalho. O cabo pode precisar ser recuperado, cortado, emendado, testado e devolvido ao leito. Se mais de uma seção está danificada, o navio não consegue reparar as duas ao mesmo tempo.
Reportagens locais disseram que o navio de reparo concluiu trabalho em outra seção a oeste de Shetland antes de ir para a falha a leste das ilhas. A restauração completa de banda larga foi reportada após o reparo final em 30 de outubro. [18]
Essa sequência mostra que a ordem de reparo também é uma decisão de alocação.
Os operadores precisam de critérios para decidir:
- qual falha cria maior risco de serviço;
- qual reparo é fisicamente possível primeiro;
- se um caminho temporário é estável o bastante para aguardar;
- qual rota restaura os serviços mais críticos;
- se outra falha criaria isolamento total;
- quanto tempo a capacidade de backup suporta carga;
- se há equipamentos e sobressalentes disponíveis;
- qual janela de clima é esperada.
O registro público não mostra o log completo de decisão. Ele mostra que reparos nos dois enlaces principal e secundário levaram cerca de dez dias e que controles temporários foram usados durante o intervalo. [10]
Accountability não exige fingir que reparo submarino pode ser instantâneo. Exige evidência de que o operador compreendia o risco mutável e tomou as melhores decisões controláveis.
Essa evidência pode incluir:
- confiança na localização da falha;
- estimativas de impacto de serviço;
- disponibilidade de navio e tripulação;
- estado de capacidade da rota;
- restrições meteorológicas;
- estabilidade da restauração temporária;
- requisitos de emergência;
- racional do pedido da sequência de reparo;
- estimativas de conclusão atualizadas;
- testes ópticos e de serviço pós-reparo.
A incerteza deve ficar visível. Previsão baseada em chegada de navio e clima não é promessa. Uma atualização pública deve distinguir estado conhecido da falha, workaround atual, prazo estimado de reparo e risco remanescente.
O evento de Shetland mostra por que prontidão de reparo é parte do desenho de rede. Uma rota não é plenamente resiliente se o operador não localiza falha, obtém navio, tem sobressalentes, coordena pontos de aterragem e comunica evidências de recuperação realistas.
O controle prático era dividido
O evento envolveu várias organizações, mas o controle não foi distribuído de forma uniforme.
O dono e operador do cabo
Faroese Telecom e o sistema SHEFA estavam mais próximos da detecção física de falhas, condição óptica, fibras reservas e reparo permanente. Declarações atribuídas ao operador descrevem ações técnicas temporárias e trabalho de navio de cabo. Isso dá ao operador de cabo controle significativo sobre a recuperação física.
Não lhe confere controle sobre o desenho de serviço de todo cliente varejista nem sobre todo contrato posterior.
Provedores de atacado e varejo de comunicações
Provedores controlaram, ou dependeram de terceiros para controlar, posicionamento de tráfego, acesso à rota alternativa, capacidade, comunicação aos clientes e restauração de serviço. O registro do Council de continuidade específica por provedor torna essa camada central.
O registro público não revela qual parte de cada cadeia do provedor tomou a decisão determinante. A responsabilidade deve seguir a capacidade verificada, não a visibilidade da marca.
Ofcom e governo
A Ofcom controlou o reporting regulatório e a moldura de resiliência mais ampla, não o reparo do incidente. Sua conta Connected Nations fornece uma linha de base técnica pública. Equipes governamentais de resiliência coordenaram informação e resposta de emergência. A questão regulatória e de política é se provedores foram cobrados a entender e reduzir falha comum mensurável.
O marco fortalecido de segurança e resiliência de telecom entrou em vigor em outubro de 2022. A Ofcom descreveu deveres de identificar riscos, reduzir efeito de compromissos de segurança e tomar ação corretiva. Um acidente físico por navio não é automaticamente um compromisso de segurança em todas as normas legais, então o marco deve ser usado como contexto de resiliência, não como sanção sem suporte fático. [6][7]
Polícia, Council, saúde e parceiros de emergência
Autoridades públicas controlaram mitigação local: patrulhas, pontos de acesso físico, contato de bem-estar e coordenação de serviço. Elas absorveram consequências criadas pela falha de comunicações, mas não controlaram o cabo ou roteamento de provedor.
Esse trabalho é evidência de transferência de custo público. Quando telecomunicações normais falham, organizações públicas fornecem pessoas, veículos e verificações manuais para recompor parte do serviço.
Clientes e usuários vulneráveis
Clientes sustentaram evidência de serviço falho e consequências pessoais. Em geral, não controlam diversidade de rota, reparo ou capacidade alternativa. A orientação para usar outro dispositivo, mudar de local ou pedir checagem a vizinho pode reduzir dano, mas não transfere responsabilidade de infraestrutura ao usuário.
Esse mapa de controle evita dois erros.
O primeiro é culpar o ator mais próximo do dano físico por todas as consequências a jusante. O segundo é tratar responsabilidade distribuída como ausência de responsabilidade. Partes diferentes controlaram prevenção, continuidade, recuperação e produção de evidência.
Accountability não exige provar intenção maliciosa
O registro público descreve dano acidental por atividade pesqueira. [4][11][16]
Esse achado delimita o evento. As evidências disponíveis não sustentam enquadrar a interrupção como sabotagem, ataque geopolítico ou perturbação deliberada.
Isso não remove accountability.
Infraestrutura frequentemente é ferida por causas comuns: escavação, ancoras, tralhas, clima, falha de manutenção, perda de energia e erros de configuração. Um sistema de resiliência existe porque essas causas são previsíveis, ainda que o momento exato não seja.
As perguntas de accountability, portanto, são:
- o enlace foi protegido e monitorado adequadamente?
- a segunda rota era genuinamente independente?
- os serviços tinham acesso utilizável a ela?
- o failover foi testado?
- o backup tinha capacidade suficiente?
- os técnicos conseguiram restaurar fibras degradadas?
- os arranjos de emergência estavam atualizados?
- os reparos estavam prontos?
- o público foi informado do que ainda estava indisponível?
- o trabalho pós-incidente reduziu reincidência?
Nenhuma dessas perguntas depende de intenção maliciosa.
Intenção importa para atribuição legal e de segurança. Controle importa para accountability operacional.
Essa distinção também evita culpa indevida. Um dono de cabo não pode prevenir todo contato de navio pesqueiro com cabo. Um provedor varejista não pode reparar fibra submarina que não possui. Um Council local não pode reconfigurar backhaul de uma operadora. A investigação justa pergunta o que cada parte poderia fazer realisticamente antes, durante e depois do evento.
Um operador pode ser responsável por marcação de rota, monitoramento, localização de falha e prontidão de reparo. Um carrier pode ser responsável por capacidade alternativa e failover testado. Um regulador pode ser responsável por expectativas de resiliência e evidência. Agências públicas podem ser responsáveis por planos de emergência.
Isso é mais forte que narrativa de culpa porque identifica controles que podem mudar.
As figuras de impacto precisam de disciplina em camadas
O incidente produziu várias medidas de tempo e impacto diferentes.
As 16 horas aproximadas da Ofcom referem-se ao principal período em que moradores ficaram sem serviços móveis e de linha fixa. O regulador também descreve dez dias de reparos nos dois enlaces antes da restauração permanente. [10]
Fontes locais reportam que alguns clientes permaneceram com problemas durante esse intervalo, particularmente onde provedores não podiam usar capacidade alternativa. [13][18]
Esses números não devem ser combinados em uma alegação de que todos os clientes ficaram offline por dez dias.
Da mesma forma, relatos de "interrupção completa" devem ser lidos no contexto. O relatório situacional do governo disse que a maioria dos serviços fixos, toda a internet e todos os serviços móveis estavam afetados em certo ponto. A Ofcom relatou depois que a voz PSTN permaneceu em grande parte disponível por micro-ondas de fallback. [4][10]
Esses registros podem refletir timestamps diferentes, definições de serviço e informação disponível para cada instituição. A abordagem responsável é apresentar ambos e evitar precisão falsa.
Uma contabilidade útil distingue:
- período de perda ampla de serviço;
- tempo de restauração temporária;
- disrupção residual específica por provedor;
- reparação física permanente;
- tempo de inatividade do usuário individual;
- duração de workaround de emergência.
Qualquer narrativa de restauração também precisa separar usuários, assinaturas, unidades e serviços. Uma residência pode ter banda larga fixa, múltiplas assinaturas móveis e linha fixa. Um alarme de teleassistência pode falhar enquanto outro serviço de voz funciona. Um provedor pode restaurar tráfego agregado enquanto um grupo específico permanece desconectado.
Sem registros nível provedor, não é possível produzir contagem completa de clientes afetados ou perda financeira total.
Essa limitação não é fraqueza a ocultar. É achado sobre qualidade da evidência pública.
Reclamações de restauração precisam de matriz, não de um único timestamp
A frase "serviços restaurados" é necessária para comunicação pública, mas pode ocultar recuperação desigual.
Para Shetland, pelo menos quatro declarações de restauração eram verdadeiras em tempos diferentes:
- Uma solução técnica temporária restaurou grande parte do serviço amplo em 20 de outubro.
- A polícia disse depois que comunicações normais tinham retornado o suficiente para retirar recursos extras. [12]
- Alguns clientes e funções de teleassistência ainda tinham problemas em 28 de outubro. [13]
- A restauração completa de banda larga foi reportada após reparo permanente em 30 de outubro. [18]
Uma matriz de restauração tornaria essas diferenças explícitas.
Linhas devem representar funções de serviço:
- voz PSTN;
- voz móvel;
- chamada de emergência;
- dados móveis;
- banda larga fixa;
- conectividade corporativa;
- serviços do Council;
- sistemas de saúde;
- teleassistência;
- sistemas de pagamento;
- comunicações de aeroporto e transporte.
Colunas devem representar evidência:
- estado de enlace óptico;
- alcançabilidade de rota;
- estabelecimento de sessão;
- transações com sucesso;
- provas externas;
- telemetria de provedor;
- confirmação de autoridade pública;
- observações de clientes;
- contagem residual de incidente.
Um serviço deveria migrar de "degradado" para "restaurado" somente quando a evidência necessária estiver presente. O padrão não precisa ser idêntico para todos os serviços. Chamada de emergência pode exigir teste mais forte que navegação web comum. Um provedor pode afirmar que o serviço foi restaurado para a maioria dos usuários enquanto um grupo conhecido ainda permanece afetado.
Isso evita dois extremos nocivos.
Um é esperar certeza perfeita antes de comunicar qualquer progresso. O outro é declarar restauração total quando apenas o caminho central retornou.
O comportamento de Shetland é exatamente o tipo de evento que se beneficia de uma matriz.
A lição regulatória é evidência, não slogans
A Ofcom incluiu o evento de Shetland em sua discussão do Connected Nations 2022 sobre resiliência de rede e serviço. Essa publicação dá ao incidente relevância regulatória além do relato local. [9][10]
A lição não deve ser reduzida a "mais regulação" ou "mais investimento".
Uma moldura eficaz de resiliência precisa de evidência de que provedores:
- identificam dependências críticas;
- entendem modos comuns geográficos e lógicos;
- mantêm capacidade alternativa suficiente;
- testam failover sob carga realista;
- protegem acesso de emergência;
- monitoram degradação;
- comunicam incidentes de grande impacto;
- preservam capacidade de reparo;
- aprendem com falhas observadas.
As condições gerais atuais de elegibilidade da Ofcom descrevem expectativas amplas de disponibilidade e planejamento de emergência. Seu trabalho em segurança de rede descreve uma estrutura para redução de risco e remediação de comprometimentos. A aplicação legal precisa precisa de provedor, serviço e data, e nenhuma conclusão de conformidade específica do evento decorre das evidências públicas disponíveis. [6][7][8]
O que o incidente sustenta é um princípio de verificação.
Reguladores não devem aceitar a existência de uma segunda rota como prova de resiliência. Devem perguntar quais serviços podem usá-la, com que capacidade, sob que gatilho e com que evidência de teste.
Isso é primazia de código de operação aplicada à continuidade telecom. O diagrama é uma alegação. O failover observado é evidência.
A distinção também melhora decisões de investimento. Se a falha foi causada por ausência de diversidade física, construa outra rota. Se capacidade alternativa existiu, mas provedores não alcançaram, corrija acesso e interconexão. Se failover foi lento, aprimore automação e procedimentos. Se sistemas de emergência dependiam de uma tecnologia de acesso, diversifique o caminho de serviço. Se a logística de reparo dominou a recuperação, melhore sobressalentes e arranjos de navio.
Mecanismos de falha diferentes exigem remédios diferentes.
Shetland não é Tonga
Uma comparação útil é a ruptura de cabo de Tonga em 2022. Ambos os eventos envolvem ilhas, fibra submarina, capacidade de fallback, navios reparadores e dependência de serviço público.
O vocabulário comum não os torna duplicados.
Em Tonga, o cabo internacional principal foi rompido após a erupção do Hunga Tonga-Hunga Ha'apai e tsunami. O evento envolveu processos vulcânicos no fundo marinho, uma rota internacional única, fallback de satélite limitado, logística de reparo internacional e história de restauração muito mais longa para conectividade doméstica.
O evento de Shetland em outubro de 2022 envolveu duas direções nominais diferentes afetadas dentro de uma semana. O registro mostra restauração óptica temporária, ativação de fibra reserva, fallback de micro-ondas legado de voz e resultados distintos entre provedores que podiam ou não usar capacidade alternativa.
As perguntas de controle são diferentes.
Para Tonga:
- Por que havia apenas uma rota internacional?
- Que fallback estava disponível?
- Havia sobressalentes e navios de reparo prontos?
- Como um país gerencia reparo longo após evento natural extremo?
Para Shetland:
- As duas rotas instaladas eram operacionalmente independentes?
- Quais serviços puderam usar capacidade remanescente ou restaurada?
- Os provedores tinham acesso alternativo suficiente?
- Como funcionaram controle óptico, fibras de reserva e micro-ondas?
- Por que falhas residuais diferiram por provedor?
A comparação é útil apenas se afiar essas fronteiras.
O que o registro público não consegue provar
Vários fatos materiais permanecem desconhecidos.
O registro público não revela:
- topologia completa de fibra e equipamentos SHEFA-2;
- orçamentos ópticos exatos antes e após o dano;
- todas as configurações de rota;
- volumes de tráfego por serviço;
- reservas de capacidade;
- todos os contratos de atacado de cada provedor;
- contagens precisas de clientes por provedor;
- logs de failover completos;
- comandos internos de incidente;
- registros de priorização de reparo;
- perdas financeiras completas;
- todas as falhas de teleassistência;
- remediações testadas de forma independente.
Também não estabelece que os incidentes norte e sul tinham causa única, que qualquer um foi malicioso, ou que cada instituição citada falhou em dever legal.
Essas lacunas importam porque limitam a alocação de responsabilidade.
Elas também definem o que um registro público pós-incidente mais robusto deveria conter:
- uma topologia acotada que mostra domínios de falha sem expor detalhe sensível;
- uma linha do tempo de impacto por serviço;
- a capacidade alternativa disponível;
- resultados de failover por classe de serviço;
- evidência de acesso de emergência;
- ações temporárias de restauração;
- sequência de reparo e restrições;
- coortes residuais de indisponibilidade;
- confiança de causa raiz;
- testes de remediação.
Um relatório pós-incidente de alta qualidade não precisa revelar detalhe de rede explorável. Precisa de evidência suficiente para clientes, autoridades públicas e reguladores distinguirem dano físico inevitável de falha de continuidade controlável.
Um teste de accountability de redundância utilizável
O evento de Shetland sustenta um teste reutilizável para conectividade em ilhas e regiões remotas.
1. Mapear o serviço, não apenas o ativo
Identificar todo o caminho do acesso do cliente via agregação local, transporte submarino, núcleo do provedor, autenticação e interconexão externa. Marcar dependências comuns de aterragem, energia, roteamento e gestão.
2. Comprovar independência geográfica
Documentar separação física em zonas prováveis de dano, pontos de aterragem e segmentos terrestres. Um rótulo norte/sul não prova que todos os trechos relevantes são independentes.
3. Reservar capacidade utilizável
Indicar quanto de capacidade alternativa está comprometido durante falha. Incluir serviços críticos e modos degradados de operação.
4. Víncular provedores à alternativa
Mostrar que cada provedor dependente tem capacidade técnica e comercial para usar a rota. Uma fibra saudável sem acesso funcional ao serviço não é redundância para esse serviço.
5. Testar failover ponta a ponta
Executar exercícios controlados que verifiquem roteamento, sessões, DNS, autenticação, voz, chamada de emergência e aplicações de serviço público. Registrar o resultado e corrigir lacunas.
6. Definir continuidade mínima viável
Especificar quais funções devem sobreviver quando a banda larga normal não está disponível. Voz, coordenação de emergência e teleassistência podem exigir caminhos de fallback distintos.
7. Inventariar controles adormecidos
Fibras reserva, enlaces de micro-ondas e terminais por satélite devem ter donos, procedimentos de ativação, testes de compatibilidade e monitoramento.
8. Preparar reparo físico
Manter capacidade de localizar falhas, sobressalentes, arranjos de navios de cabo, acesso a pontos de aterragem e premissas de clima e prioridades de reparo.
9. Medir restauração por serviço
Usar matriz que separa restauração óptica, restauração de rota e restauração percebida no cliente. Preservar dados de coorte residual.
10. Publicar evidência delimitada
Explicar o que falhou, o que funcionou, o que permaneceu desconhecido e como a remediação foi testada. Não usar o termo "resiliente" como substituto de evidência.
Conclusão
O apagão de Shetland em 2022 foi acionado por dois problemas físicos de cabo em curto intervalo. O timing foi de azar. A distribuição e duração do dano de serviço foram moldadas por controles.
A Ofcom registrou uma perda ampla aproximada de 16 horas de serviços móveis e fixos, suporte legado de micro-ondas para parte da voz PSTN, restauração temporária via aumento de potência óptica e dez dias de reparo nos dois enlaces de fibra. Registros governamentais e de operador atribuído descrevem dano acidental por embarcação pesqueira, ativação de fibra reserva e suporte satelital preventivo. O Council documentou descontinuidade residual específica por provedor e preocupações de teleassistência. A polícia forneceu acesso físico de emergência enquanto comunicações normais estavam incertas. [4][10][12][13][15]
Juntos, esses fatos derrubam uma suposição simples.
Dois cabos não significam dois serviços utilizáveis.
Redundância existe somente quando o caminho alternativo tem capacidade, os provedores dependentes conseguem alcançá-lo, o failover funciona, funções críticas sobrevivem e a restauração pode ser verificada. Uma linha em diagrama de rede é uma alegação de projeto. A evidência de accountability é o que a rede fez quando uma linha já estava prejudicada e a outra foi danificada.
Esse é o teste duradouro de Shetland: não se um segundo enlace foi instalado, mas quem conseguiu provar que ele era utilizável quando a continuidade dependia dele.
Fontes
- https://news.sky.com/story/complete-outage-on-shetland-leaves-phones-internet-and-computers-unusable-12725347
- https://news.stv.tv/highlands-islands/internet-and-mobile-services-restored-in-shetland-after-power-outage-caused-by-damaged-subsea-cables
- https://news.stv.tv/highlands-islands/shetlands-damaged-subsea-cable-to-faroe-islands-now-repaired-confirms-operator
- https://www.gov.scot/binaries/content/documents/govscot/publications/foi-eir-release/2024/01-b/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/documents/202200331574---annex-a/202200331574---annex-a/govscot%3Adocument/202200331574%2B-%2BAnnex%2BA.pdf
- https://www.gov.scot/publications/damage-to-the-telecommunication-cable-between-scottish-mainland-and-shetland-october-2022-foi-release/
- https://www.ofcom.org.uk/internet-based-services/network-security
- https://www.ofcom.org.uk/internet-based-services/network-security/ofcom-begins-new-role-overseeing-security-of-telecoms-networks
- https://www.ofcom.org.uk/phones-and-broadband/accessibility/general-conditions-of-entitlement
- https://www.ofcom.org.uk/phones-and-broadband/coverage-and-speeds/connected-nations-2022
- https://www.ofcom.org.uk/siteassets/resources/documents/research-and-data/multi-sector/infrastructure-research/connected-nations-2022/connected-nations-uk-report.pdf?v=321647
- https://www.parliament.scot/chamber-and-committees/questions-and-answers?ref=S6W-12628
- https://www.scotland.police.uk/what-s-happening/news/2022/october/update-landline-and-mobile-phone-outage-shetland-resolved/
- https://www.shetland.gov.uk/news/article/2404/continuing-problems-affecting-connectivity-in-shetland-including-some-telecarecommunity-alarm-lines
- https://www.shetnews.co.uk/2022/10/21/cable-fault-the-third-reported-in-waters-around-shetland-since-mid-september/
- https://www.shetnews.co.uk/2022/10/24/perfect-storm-of-cable-failure-was-incredibly-bad-luck/
- https://www.shetnews.co.uk/2022/10/25/subsea-cable-fault-took-place-a-few-kilometres-off-shetland-telecoms-chief-says/
- https://www.shetnews.co.uk/2022/10/26/more-digital-disruptions-as-cable-repairs-get-under-way/
- https://www.shetnews.co.uk/2022/10/31/shetland-fully-connected-once-again/
- https://www.theguardian.com/uk-news/2022/oct/20/shetland-loses-telephone-internet-services-subsea-cable-damaged
- https://www.theguardian.com/uk-news/2022/oct/21/telephone-and-internet-restored-in-shetland-after-cable-damage
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance