
Resumo
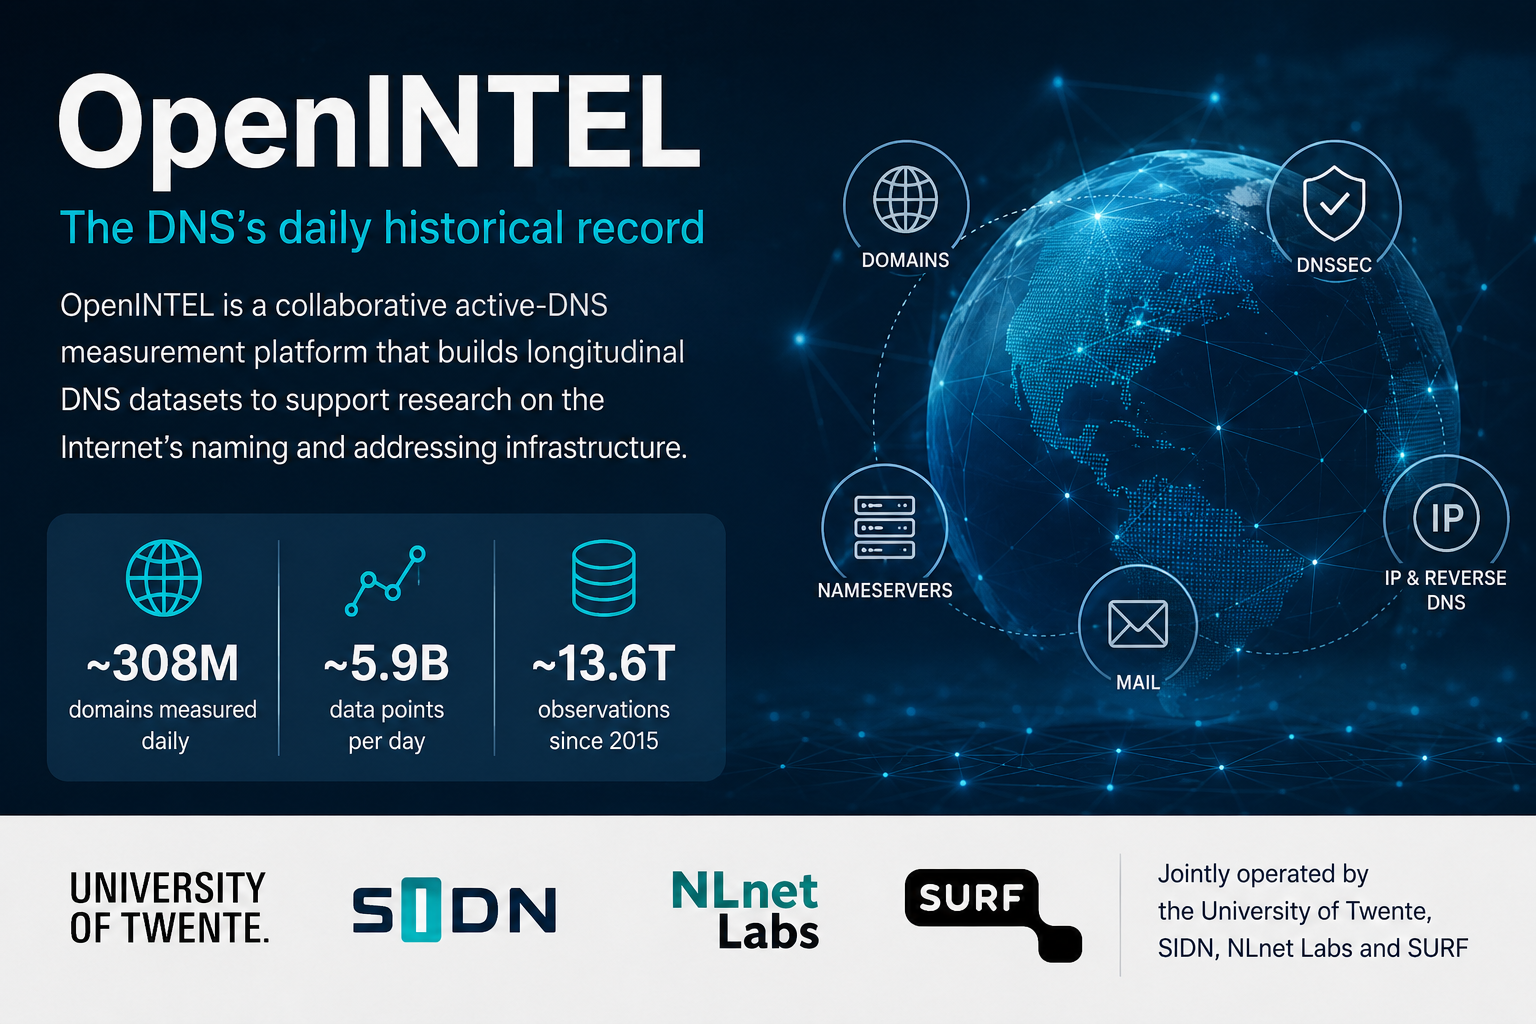
- O OpenINTEL é uma plataforma colaborativa de medição ativa de DNS operada pela University of Twente, SIDN, NLnet Labs e SURF, e não um registro, resolvedor ou empresa de DNS passivo.
- Sua página inicial relata cerca de 308 milhões de domínios medidos diariamente, 5,9 bilhões de pontos de dados produzidos por dia e 13,6 trilhões de observações acumuladas desde o início da operação regular em 2015.
- A consistência longitudinal cria o valor da plataforma, enquanto a seleção de fontes, o ponto de observação, o método de consulta, a versão do software, as mudanças de método e os controles de dados ausentes limitam cada resultado.
- O OpenINTEL não observa a demanda dos usuários nem todos os estados do DNS; alguns conjuntos de dados são abertos sob uma licença não comercial, enquanto contratos de acesso a zonas mantêm outros materiais controlados.
Um sistema da University of Twente se tornou infraestrutura nacional de pesquisa compartilhada
A implementação do OpenINTEL começou em 2014 na University of Twente. A primeira execução diária completa demonstrou que o pipeline podia consultar, processar e armazenar um espaço de nomes muito grande dentro da janela operacional necessária para repetição. As medições regulares começaram em março de 2015. A mudança de um experimento para um sistema diário criou o principal valor do arquivo: continuidade.
O projeto foi fundado por pesquisadores, incluindo Anna Sperotto, Mattijs Jonker e Roland van Rijswijk-Deij, cujas funções atuais no projeto abrangem liderança de pesquisa, arquitetura de dados, desenho de medição e financiamento. O modelo operacional se expandiu além de uma única universidade. A SIDN trouxe experiência em registros e apoio sustentado. A NLnet Labs entrou como parceira de software de DNS e pesquisa. A SURF forneceu contexto de rede de pesquisa e infraestrutura. As quatro instituições agora operam o projeto em conjunto.
Esse arranjo não deve ser descrito como uma empresa autônoma. Não há uma corporação OpenINTEL verificada com acionistas, receita consolidada ou avaliação. Pessoal, hardware, contratos, bolsas e direitos sobre dados pertencem às instituições parceiras. A governança do projeto é menos formal publicamente do que um conselho de fundação, mas sua diversidade institucional reduz a dependência de um único laboratório.
Cada parceiro também contribui com uma visão diferente do DNS. Uma universidade valoriza pesquisa reproduzível e trabalho de estudantes. Um registro entende dados de zona, relações com operadores e as restrições de acordos de acesso. Uma organização de software de DNS traz conhecimento de protocolos e implementação. Uma rede nacional de pesquisa pode apoiar a computação e a conectividade necessárias para medição sustentada.
O modelo cria limites. Os parceiros podem financiar equipamentos e pessoal sem publicar um orçamento único do projeto. Dados de zona obtidos por contrato podem ser medidos, mas não redistribuídos livremente. Páginas de colaboradores podem ficar desatualizadas quando as pessoas mudam de emprego, por isso são confiáveis para o histórico do projeto e menos confiáveis para títulos atuais sem relação. Operação compartilhada não torna cada ativo institucional propriedade conjunta.
O desenvolvimento do OpenINTEL de sistema de laboratório para infraestrutura comum também mudou suas obrigações de serviço. Pesquisadores dependem da continuidade dos dados. Operadores precisam de tráfego identificável e um caminho para relatar danos. Usuários de dados precisam de formatos estáveis e termos de acesso. Migrações de armazenamento devem preservar o histórico. O projeto precisa se comportar como um observatório de longo prazo, e não como o conjunto de dados temporário de um artigo.
O primeiro dia completo foi um marco técnico. A decisão de continuar medindo por uma década foi a conquista institucional.
O DNS responde ao presente e esquece o passado
Uma consulta DNS pede a resposta atual disponível por um caminho específico. A resposta pode identificar servidores de nomes, endereços, sistemas de e-mail, registros relacionados a certificados ou outras configurações. Amanhã, o operador pode mudá-la. O estado anterior pode permanecer em caches por um tempo, aparecer em logs mantidos por um provedor ou desaparecer completamente da visão pública.
Esse comportamento é apropriado para um sistema de nomes ativo. O DNS não existe para fornecer aos historiadores um registro completo. Ele existe para mapear nomes e outros identificadores sob autoridade distribuída. Registros, registradores, operadores autoritativos, resolvedores recursivos e aplicações retêm evidências diferentes. Nenhuma instituição preserva naturalmente uma visão longitudinal de muitos espaços de nomes e tipos de registros.
A ausência importa. Pesquisadores querem saber como a adoção de DNSSEC mudou, quando a hospedagem ou a infraestrutura de e-mail se moveu, quão concentrado se tornou o serviço autoritativo e se uma política ou vulnerabilidade alterou o comportamento. Equipes de segurança querem reconstruir para o que um domínio resolvia antes de um incidente. Formuladores de políticas querem evidências de dependência de provedores. Uma verificação única pode descrever um estado; não pode revelar a transição.
O OpenINTEL foi construído para criar essa evidência temporal por meio de medição ativa repetida. O projeto obtém ou constrói listas de nomes e faixas de endereços, envia consultas DNS definidas em um cronograma e armazena respostas com carimbos de data/hora e metadados. A repetição do processo permite a um pesquisador comparar comparáveis ao longo de dias e anos.
A palavra “comparáveis” exige disciplina. As listas de fontes mudam. Novos tipos de registros são adicionados. Software e infraestrutura são atualizados. Alguns dias ficam incompletos. Um servidor autoritativo pode limitar a taxa ou bloquear o projeto. Uma resposta pode variar conforme o ponto de observação, a localização anycast ou a hora. O valor longitudinal depende do registro dessas mudanças, em vez de tratar o arquivo como uma tabela perfeitamente uniforme.
A contribuição central do OpenINTEL, portanto, não é simplesmente o volume de varredura. Verificadores em toda a internet também podem produzir conjuntos de dados enormes. O ativo distintivo é um instrumento de longa duração cujos métodos, parceiros e produtos de dados são estáveis o suficiente para que a própria mudança se torne objeto de estudo.
Esse ponto forte sustenta o título de “registro histórico diário do DNS” apenas com uma ressalva. O OpenINTEL preserva um histórico das medições que foi configurado para fazer. Ele não registra cada consulta DNS, cada domínio ou cada resposta vista pelos usuários. O arquivo é grande exatamente o suficiente para que uma linguagem descuidada possa fazê-lo parecer universal. Sua credibilidade depende de resistir a essa tentação.
A lista de alvos define o campo de visão do arquivo
A medição ativa de DNS exige uma população alvo. O OpenINTEL pode receber listas de domínios derivadas de zonas, nomes de transparência de certificados, listas de popularidade, dados de ápice de códigos de país, faixas de endereços e outras fontes. Cada fonte responde a uma pergunta de pesquisa diferente e contém um viés diferente.
Uma zona de registro pode fornecer ampla cobertura de nomes delegados sob aquele domínio de topo, sujeita a contrato. Ela pode omitir nomes em outros espaços de nomes e não diz nada sobre se um domínio hospeda um serviço ativo. Os logs de Transparência de Certificados revelam nomes associados a certificados registrados publicamente, favorecendo serviços habilitados para TLS e expondo subdomínios não presentes em listas de zonas. Listas de popularidade enfatizam nomes acessados com frequência sob metodologias opacas ou mutáveis. A medição de DNS reverso começa pelo espaço de endereços, e não pelos nomes.
Combinar fontes aumenta o alcance e o risco de contagem dupla ou mudança de composição. Um número de 308 milhões de domínios medidos diariamente na página inicial deve ser lido como a métrica atual do projeto para observações de domínios configuradas, e não como 308 milhões de sites ativos únicos. Um domínio pode estar estacionado, delegado sem conteúdo, duplicado entre listas ou usado para e-mail e infraestrutura em vez de um site.
A seleção de fontes afeta a interpretação longitudinal. Suponha que um novo domínio de topo seja adicionado à medição. O número total de registros observados aumenta porque o instrumento se expandiu, não porque o DNS mudou organicamente. Uma lista de popularidade pode revisar sua metodologia e criar rotatividade aparente. A cobertura de Transparência de Certificados pode aumentar à medida que as práticas de emissão mudam. Analistas precisam de listas versionadas e critérios de inclusão.
Os métodos do projeto ainda podem produzir tendências robustas quando as comparações são delimitadas. Pesquisadores podem examinar um subconjunto estável de nomes ao longo do tempo, controlar adições e classificar tipos de fonte. O tamanho do arquivo permite estudar eventos raros e relações de infraestrutura, mas números grandes não compensam uma população indefinida.
A governança das listas também é comercial e política. Registros podem permitir medição sob acordos que restringem a redistribuição. Operadores podem se opor à carga. Um projeto comprometido com a ciência aberta não pode simplesmente publicar dados que não tem o direito de compartilhar. O arquivo, portanto, tem camadas abertas e controladas.
A primeira pergunta para qualquer resultado do OpenINTEL, portanto, deve ser: quais nomes ou endereços eram elegíveis para medição nessas datas? A resposta não é detalhe de fundo. Ela define a afirmação.
O OpenINTEL mede nomes e espaço de endereços a partir de uma base institucional holandesa, com listas de fontes e colaborações globais. Isso lhe dá assunto global, não representação automática de cada região ou experiência de usuário.
O acesso a zonas varia entre os registros. Algumas listas de códigos de país são abrangentes, outras são montadas a partir de fontes públicas e algumas não podem ser redistribuídas. Nomes derivados de certificados favorecem serviços que usam certificados públicos. Um ponto de observação de medição pode receber uma resposta anycast diferente daquela vista em outro continente. DNS de horizonte dividido e geolocalizado podem tornar ambas as observações válidas.
Pesquisadores que comparam países, portanto, precisam separar o rótulo de registro do domínio da localização de seu operador, usuários e infraestrutura. Um nome.brpode estar hospedado na Europa; um domínio de topo genérico pode atender uma organização local. Contar nomes por sufixo não é o mesmo que medir a dependência nacional.
Replicação e pontos de observação complementares podem testar a sensibilidade geográfica. Onde os resultados diferem, a diferença é dado, e não um inconveniente a ser anulado por média. Ela pode revelar política anycast, localização de conteúdo ou bloqueio.
O papel de interesse público do projeto é mais forte quando lacunas de cobertura são mapeadas explicitamente. Regiões com acordos de fonte mais fracos não devem desaparecer em uma porcentagem global. Um registro histórico só pode reduzir a desigualdade de conhecimento se os usuários souberem onde seu instrumento tinha menos capacidade de enxergar.
Bilhões de consultas importam apenas quando seu contexto sobrevive
O pipeline de medição transforma listas de alvos em consultas agendadas. Os trabalhadores emitem solicitações para tipos de registros definidos, recebem respostas, normalizam campos e armazenam observações com carimbos de data/hora e metadados. Na escala relatada pelo OpenINTEL — cerca de 5,9 bilhões de pontos de dados por dia — o desafio operacional não é enviar um pacote DNS. É concluir o ciclo diário de forma confiável sem sobrecarregar a infraestrutura autoritativa nem perder as condições por trás do resultado.
Os trabalhadores precisam de controle de taxa, política de repetição e identificação clara de origem. Um tempo limite pode significar ausência de serviço, perda de pacotes, limitação de taxa, falha transitória ou bloqueio intencional. Repetir de forma agressiva demais pode criar o dano que o projeto tenta evitar. Dar aos operadores uma explicação pública e um caminho de contato torna o tráfego responsável.
As respostas devem ser analisadas em muitos tipos de registros e casos extremos de DNS. Nomes podem conter codificações incomuns. Delegações podem ser coxas ou cíclicas. O DNSSEC adiciona assinaturas, chaves e registros de negação de existência. O truncamento pode deslocar uma consulta de UDP para TCP. Servidores autoritativos podem retornar respostas diferentes por local de origem. A normalização deve preservar o significado sem transformar cada pacote em um formato ingerenciável.
O sistema também precisa de uma definição de conclusão. Uma execução diária pode terminar para a maioria dos alvos e perder um subconjunto. Armazenar apenas respostas bem-sucedidas tornaria a ausência invisível. Pesquisadores precisam saber quais consultas foram tentadas, quais falharam e se uma interrupção da plataforma afetou um período. Um registro ausente não deve se tornar automaticamente evidência de que um domínio o removeu.
A página inicial do OpenINTEL relata 13,6 trilhões de pontos de dados acumulados desde 2015. Esse número comunica escala e permanece relatado pelo projeto. Seu valor analítico depende de como “ponto de dado” é definido entre produtos e ao longo do tempo. Uma contagem pode crescer por meio de mais domínios, mais tipos de registros ou observações mais frequentes. Os usuários devem consultar a metodologia do conjunto de dados relevante, em vez de comparar totais acumulados como uma simples medida de crescimento do DNS.
Nesse volume, as decisões de engenharia moldam a pesquisa. Particionamento, compressão, índices e formatos de armazenamento determinam quais consultas são práticas. Migrações de dados podem mudar a representação. Sistemas de controle de qualidade precisam identificar execuções incompletas. O arquivo é um instrumento científico e uma plataforma de dados ao mesmo tempo.
O DNS direto revela configuração, não comportamento de aplicação
A medição direta começa com um nome e pede registros selecionados. Dados de delegação podem mostrar quais provedores autoritativos atendem o domínio. Registros de endereço podem mostrar relações de hospedagem ou CDN. Registros de troca de e-mail expõem a infraestrutura de e-mail. Registros DNSSEC indicam implantação e escolhas de algoritmos. Outros tipos revelam configuração de serviço e política.
Observações repetidas tornam as transições visíveis. Um domínio pode se mover de um provedor autoritativo para outro, adicionar IPv6, ativar DNSSEC ou mudar o serviço de e-mail. Em grande escala, pesquisadores podem estimar adoção e concentração. Eles podem examinar se as mudanças ocorrem gradualmente ou em torno de um evento.
Um registro retornado continua sendo uma observação em um momento e ponto de observação. Um endereço A ou AAAA não prova que um site respondeu, que o endereço serviu o mesmo conteúdo aos usuários ou que a aplicação era segura. Um registro de troca de e-mail não prova entrega bem-sucedida. Uma assinatura DNSSEC pode estar presente enquanto a validação falha em outro lugar. Testes na camada de aplicação exigem métodos separados.
CDNs e anycast complicam a interpretação. Uma resposta autoritativa ou recursiva pode variar conforme o local de origem. Um domínio pode retornar endereços selecionados para o ponto de observação do OpenINTEL, em vez dos endereços que um usuário em outra região recebe. Sistemas de horizonte dividido deliberadamente dão respostas diferentes a clientes internos e externos. A medição do projeto não é falsa; é uma visão.
O cache adiciona outra distinção. O sistema ativo do OpenINTEL pode consultar por caminhos de resolvedores definidos ou infraestrutura autoritativa, dependendo do conjunto de dados. Ele não observa o que cada resolvedor recursivo tem em cache. Um usuário pode receber um valor anterior até a expiração do TTL. Mudanças no arquivo podem preceder ou seguir transições visíveis aos usuários.
O valor da plataforma é mais forte quando a pergunta de pesquisa corresponde ao método: como as respostas DNS configuradas observadas pelo projeto mudaram. Ele enfraquece quando a resposta é usada como proxy para popularidade, sucesso de aplicação ou experiência do usuário sem evidências adicionais.
O DNS reverso e os produtos de espaço de endereços conectam nomenclatura e administração de rede
O DNS reverso começa com um endereço IP e pergunta qual nome, se houver, está associado por meio da hierarquia in-addr.arpa ou ip6.arpa. O OpenINTEL se expandiu para a medição reversa de IPv4, criando outra grande visão longitudinal. O conjunto de dados pode revelar padrões de nomenclatura administrativa, mudanças de infraestrutura e a presença de registros em todo o espaço de endereços.
Um registro PTR não é prova autoritativa de quem usa um endereço nem de qual serviço ele fornece. Detentores de endereços podem deixar registros obsoletos, usar nomes genéricos ou delegar zonas reversas. Redes de nuvem e de acesso podem aplicar nomenclatura sistemática. Alguns endereços não têm entrada reversa. Os dados são úteis para classificação e mudança, não um mapa universal de identidade.
Medir o espaço reverso de IPv4 é tratável em relação ao IPv6 porque a população de endereços é menor e enumerável sob políticas definidas. O IPv6 é grande demais para varredura exaustiva endereço por endereço. A pesquisa deve usar prefixos alocados, endereços observados ou outros métodos de seleção de alvos. Essa diferença impede que a metodologia de IPv4 seja projetada sobre o protocolo mais novo sem qualificação.
O projeto também publica produtos de nível de RIR e de prefixo de rede. Listas temporais de prefixos tentam classificar prefixos de rede sob observações definidas. Essas listas podem apoiar amostragem de medições e pesquisa, mas não são uma hierarquia objetiva de importância de rede. Um prefixo pode parecer proeminente por causa da construção da lista e da população de serviços. Valor de negócios, tráfego e contagem de usuários permanecem separados.
Esses produtos ampliam o OpenINTEL de um observatório de domínios para uma plataforma de nomenclatura e endereçamento. Eles também aumentam a necessidade de rótulos cuidadosos. “Histórico de DNS” pode abranger registros de domínio, nomes reversos, alvos derivados de certificados e mudanças de zona inferidas, cada um com população e cadência diferentes.
A expansão é analiticamente valiosa porque a infraestrutura da internet une nomes, endereços e redes. Uma migração de hospedagem pode aparecer em registros diretos e relações de prefixos. Nomes reversos podem fornecer contexto operacional. Dados de RIR podem agrupar observações. A conexão continua sendo uma estrutura de inferência, e não um registro completo de propriedade.
O Zonestream reduz a lacuna entre instantâneos diários e mudanças intradiárias
Uma varredura diária registra um estado amplo. O DNS pode mudar várias vezes entre varreduras. Uma campanha maliciosa pode ativar e desaparecer. Um grande provedor pode migrar registros em etapas. Um erro de configuração pode ser introduzido e corrigido antes da próxima execução programada.
O Zonestream e trabalhos relacionados visam fornecer evidências mais orientadas a eventos, inferindo mudanças de zona e produzindo feeds mais próximos do momento da mudança. A abordagem complementa o arquivo diário, em vez de substituí-lo. Um fluxo pode identificar transições rápidas; o pipeline diário fornece instantâneos amplos e consistentes.
Medições mais rápidas criam desafios de carga e interpretação. Consultas mais frequentes aumentam o tráfego para operadores autoritativos. Mudanças em uma fonte de zona nem sempre significam a mesma coisa que mudanças nas respostas DNS observadas. Um fluxo pode conter rajadas de manutenção ou sistemas automatizados. Os consumidores precisam distinguir eventos brutos de transições de infraestrutura significativas.
O produto mostra como a arquitetura do OpenINTEL evoluiu além de um único processo em lote. O projeto começou provando que uma enorme execução diária poderia ser concluída. Mais tarde, adicionou formas de observar mudanças em resolução temporal diferente. Isso amplia os casos de uso e complica a comparabilidade.
Os pesquisadores devem declarar qual cadência sustenta uma afirmação. Um conjunto de dados diário pode mostrar que uma configuração diferiu entre datas. Um fluxo pode mostrar uma sequência intermediária. Nenhum deles explica necessariamente por que o operador agiu. Combiná-los com evidências de registro, certificado ou incidente pode fortalecer o relato.
O Zonestream também aumenta a importância operacional da disponibilidade contínua. Uma varredura diária perdida cria uma lacuna. Um feed de eventos com falha pode perder uma sequência difícil de reconstruir. Redundância, reprodução e monitoramento tornam-se parte do método de pesquisa.
O armazenamento é o produto mais durável e a maior obrigação do projeto
O arquivo do OpenINTEL é valioso porque o DNS de ontem não pode ser consultado diretamente. Uma vez que um estado muda e os caches expiram, a medição repetida pode ser a única evidência pública de que o ponto de observação do projeto o observou. Isso torna o armazenamento e a integridade dos dados infraestrutura central.
Um arquivo de escala de década precisa de mais do que capacidade. Ele precisa de esquemas versionados, somas de verificação, replicação, migrações documentadas e uma forma de preservar a relação entre observações e métodos. Uma coluna renomeada sem um registro de migração pode quebrar a reprodutibilidade. Uma mudança de compressão pode melhorar o custo e complicar ferramentas antigas. Uma partição corrompida pode remover evidências que nenhuma nova varredura pode regenerar.
A retenção cria pressão financeira. Bilhões de pontos diários exigem computação, rede e armazenamento. As fontes públicas não divulgam um custo anual consolidado. O ônus é compartilhado entre instituições parceiras e programas de financiamento. À medida que o arquivo cresce, o projeto precisa escolher entre reter detalhes brutos, produzir conjuntos de dados derivados e controlar o acesso.
O custo de consulta é outra restrição. Um pesquisador pode querer examinar anos de registros em milhões de domínios. Permitir consultas irrestritas pode sobrecarregar a plataforma. Produtos para download e acesso controlado distribuem o trabalho, mas exigem que os usuários armazenem e processem os dados por conta própria. Cópias hospedadas em nuvem poderiam melhorar o acesso, criando questões de custo e governança.
A integridade longitudinal também depende da preservação da ausência. Um dia sem registro pode significar que o domínio não tinha o valor, que a consulta falhou, que o alvo não estava na lista ou que o pipeline estava incompleto. O arquivo precisa de dados de controle suficientes para distinguir esses estados. Caso contrário, uma tendência pode ser um artefato da instrumentação.
O futuro do projeto será determinado em parte pelo fato de as instituições continuarem a financiar esse trabalho invisível. Novos tipos de registros e painéis atraem atenção. Manter bytes, documentação e contexto antigos cria o ativo histórico. Se o armazenamento ou a equipe especializada forem perdidos, a continuidade do arquivo não poderá ser recomprada mais tarde.
Quatro instituições compartilham a plataforma sem um orçamento visível
A resiliência organizacional do OpenINTEL vem da parceria. A University of Twente fornece liderança acadêmica e pesquisadores. A SIDN contribui com conhecimento de registro e apoio. A NLnet Labs traz experiência em software de DNS e operação. A SURF contribui com infraestrutura nacional de pesquisa. A combinação é mais forte do que um projeto dependente de um único investigador principal e de uma bolsa.
O modelo também é opaco em termos financeiros convencionais. Não há receita, despesa ou contagem de funcionários consolidados do projeto. O hardware pode ser financiado por um parceiro, pesquisadores empregados por outro e capacidade de rede fornecida por um terceiro. Páginas públicas identificam funções, mas não fornecem uma carta de votação ou um registro de ativos.
Isso não torna o projeto sem governança. As decisões ocorrem por meio de relações institucionais e de uma equipe central. Significa que mudanças nas prioridades dos parceiros podem afetar a plataforma sem aparecer como um evento corporativo. Uma bolsa termina, um servidor chega à idade de substituição ou um especialista muda de função. O arquivo pode continuar enquanto a capacidade de desenvolvimento se estreita.
A concentração de conhecimento é um risco. Sistemas de medição de longa duração acumulam conhecimento sobre peculiaridades, migrações de dados e relações com operadores. Documentação e sucessão são tão importantes quanto código novo. Uma parceria só pode distribuir o ônus se mais de uma instituição puder operar componentes críticos.
O modelo também molda a responsabilidade perante os operadores medidos. Uma identidade de projeto visível e um contato de abuso permitem que provedores autoritativos relatem tráfego excessivo. Parceiros com presença na comunidade DNS podem negociar problemas. O sistema precisa preservar essa confiança à medida que a escala e os produtos se expandem.
O OpenINTEL é melhor descrito como infraestrutura de pesquisa compartilhada. Sua autoridade vem da qualidade e da continuidade de suas evidências, não de uma reivindicação estatutária sobre o DNS. Ele mede um sistema distribuído sob a tolerância de organizações que permanecem livres para bloqueá-lo ou restringi-lo.
Dados abertos ainda dependem de contratos, licenças e financiamento de longo prazo
O OpenINTEL promove o acesso à pesquisa e publica conjuntos de dados elegíveis sob CC BY-NC-SA 4.0. A licença exige atribuição, restringe o uso comercial e aplica condições de compartilhamento pela mesma licença. Outros materiais permanecem controlados porque acordos de acesso a zonas ou contratos de fonte não permitem redistribuição irrestrita.
Esse arranjo pode decepcionar usuários que ouvem “OpenINTEL” e supõem que toda observação é baixável gratuitamente para qualquer finalidade. O nome do projeto descreve um compromisso de pesquisa, não a propriedade de toda entrada. Um registro pode permitir medição sob condições sem conceder o direito de republicar seus dados completos derivados de zona.
A restrição não comercial apoia o compartilhamento acadêmico e limita parte do reúso industrial. Uma empresa pode precisar de um acordo separado para um produto comercial. O projeto não publica licença comercial universal nem preço. Os usuários devem contatar os operadores em vez de supor que os termos de acesso podem ser inferidos dos conjuntos de dados abertos.
Dados controlados ainda podem apoiar a pesquisa por meio de solicitações, acordos institucionais ou produtos derivados. O processo introduz seleção e custo administrativo. Pesquisadores com vínculos estabelecidos podem conseguir acesso mais facilmente do que analistas independentes. A reprodutibilidade é mais difícil quando o conjunto de dados subjacente não pode ser redistribuído.
A tensão é estrutural. A pesquisa longitudinal de DNS se beneficia de amplo acesso a fontes. Registros e operadores têm preocupações contratuais, de segurança e comerciais. Uma plataforma que violasse esses acordos poderia publicar mais no curto prazo e perder acesso futuro. Abertura sustentável às vezes exige uma fronteira documentada, em vez de liberação máxima.
Para usuários de dados, a prática correta é específica ao conjunto de dados. Declare a fonte, a licença, a cobertura e a condição de acesso. Não descreva dados controlados como públicos. Não suponha que uma tabela derivada aberta contenha o arquivo subjacente completo. A governança dos dados faz parte do método.
Os conjuntos de dados abertos atuais usam uma licença Creative Commons não comercial, enquanto outros materiais permanecem controlados por contratos de fonte. Isso apoia o trabalho acadêmico e evita a suposição simples de que todo conteúdo do arquivo é gratuito para qualquer uso comercial.
Analistas comerciais podem querer evidências históricas de DNS para segurança, pesquisa de mercado ou due diligence. Essa demanda poderia ajudar a financiar a infraestrutura e pode conflitar com restrições impostas por registros e com as expectativas dos operadores medidos. Um caminho pago precisaria distinguir serviço e suporte de direitos que o projeto não possui.
Os parceiros poderiam fornecer agregados derivados, ambientes de pesquisa controlados ou licenças negociadas para dados elegíveis. Cada modelo muda quem pode reproduzir um resultado. Um produto privado construído a partir de um arquivo de interesse público pode gerar valor sem devolver métodos ou correções.
A questão de governança não é se o uso comercial é bom ou ruim. É se os arranjos de receita preservam o registro longitudinal, respeitam os direitos das fontes e evitam tornar os dados mais completos disponíveis apenas para usuários bem financiados.
A sustentabilidade do OpenINTEL pode eventualmente exigir camadas de acesso mais formais. A credibilidade dessas camadas dependerá de critérios transparentes e de uma linha de base pública protegida. O arquivo se tornou valioso por meio da pesquisa compartilhada. Financiar seu futuro não deve tornar seu passado impossível de examinar.
Uma resposta DNS registra configuração, não intenção ou dano
Grandes conjuntos de dados de DNS convidam a conclusões categóricas. Um registro aponta para um endereço associado a um provedor, então se diz que o domínio está hospedado lá. Um nome retorna NXDOMAIN, então é declarado inexistente. Um nome derivado de certificado resolve, então o serviço é assumido ativo. Cada inferência pode ser útil e errada em um caso específico.
Uma resposta DNS registra o que a infraestrutura consultada retornou sob as condições de medição. Ela não mostra por que o operador a configurou. O endereço pode ser um redirecionamento, sinkhole, página estacionada ou borda de CDN compartilhada. A aplicação pode rejeitar o nome de host. O registro pode estar obsoleto. Uma falha transitória de servidor ou limitação de taxa pode produzir uma aparente ausência.
NXDOMAIN significa que o caminho DNS que respondeu afirmou inexistência para o nome consultado sob seu estado atual. Ele não prova que o nome nunca existiu ou que não existirá mais tarde. Erros de delegação e servidores autoritativos inconsistentes podem criar resultados variados. Observações repetidas e verificações autoritativas diretas aumentam a confiança.
A análise de segurança exige ainda mais cautela. Mudanças rápidas de domínio ou endereço podem estar associadas a abuso e também a CDNs legítimas, failover e migrações. Um registro não prova que um domínio é malicioso. A rotulação exige evidências adicionais, como conteúdo, relações de campanha, registro e comportamento observado.
A demanda dos usuários está totalmente fora da medição ativa. O OpenINTEL gera suas próprias consultas. Ele não vê com que frequência os usuários solicitam um nome, o que os caches recursivos atendem ou qual resposta produz tráfego. DNS passivo ou telemetria de resolvedores responde a outras perguntas e carrega preocupações de privacidade diferentes.
A cultura analítica mais forte do projeto é a que trata esses limites como elementos de primeira classe. Um arquivo enorme pode apoiar melhor inferência porque padrões e histórico estão disponíveis. Ele não muda o status lógico de uma observação. A medição continua sendo um insumo para a explicação, não a explicação em si.
Uma resposta NXDOMAIN pode indicar que um nome não existe na visão DNS relevante. Um tempo limite pode indicar servidor inacessível, limitação de taxa, perda de pacotes ou recusa deliberada. Um SERVFAIL pode surgir de problemas de validação, delegação ou operacionais transitórios.
A análise longitudinal deve preservar essas categorias em vez de colapsá-las em “fora do ar”. Um domínio que passa de uma resposta válida para NXDOMAIN tem um histórico diferente daquele que atinge tempo limite intermitentemente. Uma mudança de parser ou de regra de repetição pode alterar a distribuição medida sem que nenhum operador mude a configuração.
A distinção é particularmente importante na pesquisa de segurança e políticas. Uma ausência de resposta não é prova de que um domínio foi removido ou censurado. Pontos de observação adicionais, consultas autoritativas e verificações de aplicação podem ser necessários.
A escala do OpenINTEL torna a classificação de erros consequente. Uma pequena escolha metodológica pode afetar milhões de registros. O tratamento cuidadoso da evidência negativa é uma das formas mais claras de o projeto impedir que um vasto arquivo produza conclusões excessivamente confiantes.
Afirmações longitudinais dependem do histórico de métodos e de observações ausentes
Um conjunto de dados de escala de década contém duas histórias: a história do DNS e a história do instrumento. O hardware é substituído, o software de consulta muda, parsers são corrigidos e acordos de fonte se expandem. Um tipo de registro adicionado em 2024 não pode ser comparado diretamente com uma ausência em 2018. Uma nova regra de repetição pode melhorar a conclusão e mudar a probabilidade de um servidor lento parecer responsivo.
Por essa razão, o versionamento de métodos faz parte dos dados. Cada série de observações deve estar vinculada à lista de alvos, ao tipo de consulta, ao ponto de observação da medição, à versão do software e a eventos operacionais conhecidos. Dias ausentes precisam de sinalizações explícitas. Um analista não deve inferir que milhões de domínios mudaram quando um cluster de trabalhadores falhou ou um feed de entrada chegou tarde.
O problema fica mais difícil após a migração de armazenamento. Um novo esquema pode comprimir campos repetidos, normalizar nomes de forma diferente ou reclassificar erros. Essas mudanças podem tornar o arquivo mais barato e fácil de usar, ao mesmo tempo que alteram consultas antigas. Preservar registros de origem brutos ou suficientemente detalhados, código de migração e amostras de validação permite aos pesquisadores distinguir uma tendência de DNS de uma transformação de banco de dados.
Reprodutibilidade não exige que toda a plataforma permaneça congelada. Ela exige evidências suficientes para reconstruir como um resultado foi produzido. Trabalhos publicados devem identificar a versão do conjunto de dados ou a data de acesso, filtros de população e código. Quando termos contratuais impedem a redistribuição de registros brutos, os pesquisadores ainda podem publicar métodos, agregados e verificações de validação dentro do acordo.
A parceria do OpenINTEL com pesquisadores externos e o trabalho de replicação é importante aqui. Uma segunda implementação ou medição independente não produzirá respostas idênticas, mas as diferenças podem expor suposições. A replicação é particularmente valiosa quando anycast, bloqueio ou licenciamento de listas torna um ponto de observação estruturalmente incompleto.
A idade do arquivo aumenta o custo de uma mudança silenciosa. Uma pequena correção de parsing aplicada retroativamente pode alterar anos de dados. Deixar o erro intacto pode perpetuar uma falha conhecida. A abordagem responsável é documentar a correção, preservar o estado original quando possível e especificar qual versão fundamenta um resultado.
Esse é o trabalho sem glamour que separa infraestrutura de uma coleção de arquivos. Os trilhões de pontos de dados relatados pela plataforma importam apenas se os usuários futuros puderem dizer quais pontos pertencem à mesma comparação. A ciência longitudinal é um exercício de preservação de contexto na mesma escala das observações.
A varredura responsável deve permanecer visível para os operadores que arcam com seu custo
A medição ativa consome recursos fora do projeto. Uma consulta DNS é pequena, mas bilhões de consultas chegam a sistemas autoritativos que variam de grandes plataformas anycast a servidores modestos. Controles de taxa e agendamento reduzem o impacto; eles não tornam o custo zero. A base ética do trabalho, portanto, inclui transparência e um caminho prático para os operadores se oporem.
Uma plataforma responsável usa endereços de origem identificáveis, publica uma descrição de seu tráfego e monitora canais de contato. Ela deve honrar solicitações justificadas para reduzir ou bloquear a medição e investigar relatos de carga incomum. Essas medidas não criam consentimento universal. Elas tornam o projeto responsável por uma atividade tecnicamente possível sem permissão prévia.
O ônus não é distribuído uniformemente. Um provedor com muitas delegações pode receber consultas para milhões de nomes, enquanto um pequeno operador vê apenas algumas. Alguns servidores são configurados para limitar a taxa de tráfego desconhecido, causando uma aparente falha de medição. Outros podem retornar respostas deliberadamente genéricas. Um analista precisa reconhecer que a defesa do operador altera o conjunto de dados observado.
O risco de privacidade é diferente do registro de logs de resolvedores passivos. O OpenINTEL gera consultas a partir de listas de alvos e não observa usuários individuais. Isso limita muito a exposição ao comportamento dos usuários. O arquivo ainda pode conter nomes que identificam organizações, dispositivos ou serviços, incluindo subdomínios derivados de logs de certificados. Publicar registros históricos detalhados pode tornar mais fácil encontrar infraestrutura esquecida.
Controles de acesso e licenciamento podem reduzir o uso indevido sem transformar cada observação DNS em dado confidencial. O limite apropriado depende da fonte, da granularidade e do risco. Agregados amplos e conjuntos de dados de pesquisa podem ser seguros para divulgação, enquanto registros brutos derivados de zonas permanecem controlados contratualmente. Um projeto comprometido com a ciência aberta precisa explicar essas distinções em vez de apresentar o acesso como tudo ou nada.
A revisão ética também deve levar em conta as afirmações posteriores. Um artigo de pesquisa que rotula um domínio ou país como inseguro pode causar dano à reputação quando a medição na verdade capturou um erro transitório. O projeto não pode policiar todos os usuários, mas ressalvas, termos e exemplos claros podem moldar melhores práticas.
A legitimidade do OpenINTEL se apoia em parte no fato de que os operadores medidos podem ver quem está perguntando. Essa visibilidade deve continuar sendo um requisito de design à medida que os produtos se tornam mais rápidos e variados. Um observatório conquista a tolerância do sistema que observa tornando seu próprio comportamento aberto à inspeção.
DNS ativo, DNS passivo e varredura geral respondem a perguntas diferentes
O OpenINTEL às vezes é comparado a bancos de dados de DNS passivo, verificadores em toda a internet e sistemas distribuídos de sondas. A comparação só é útil depois que o modelo de observação é separado.
O DNS passivo coleta registros vistos em tráfego real de consultas em resolvedores recursivos ou outros pontos de observação. Ele pode revelar o que usuários ou sistemas solicitaram e quais respostas foram retornadas por esses caminhos. A cobertura depende dos sensores participantes e levanta questões contratuais e de privacidade. Um banco de dados passivo pode ver rapidamente um domínio malicioso popular, mas perder um domínio silencioso que nenhum usuário observado pede.
O OpenINTEL escolhe seus alvos e faz as perguntas por conta própria. Ele pode medir a mesma população todos os dias, mesmo quando nenhum usuário visita os nomes. Essa regularidade apoia a comparação longitudinal. Ele não pode inferir popularidade nem comportamento de cache a partir das consultas ativas. Os dois métodos são complementares: um reflete a demanda observada em resolvedores selecionados; o outro reflete respostas configuradas para alvos selecionados a partir de pontos de observação de medição.
Um verificador como o ZMap começa com endereços e pergunta se um serviço responde, muitas vezes seguido por um handshake de protocolo. Ele pode mapear serviços expostos sem depender de listas de domínios. A medição de DNS pode identificar nomes e delegações que apontam para infraestrutura compartilhada, incluindo registros cujos serviços estão inacessíveis. Novamente, os métodos veem superfícies diferentes.
Uma plataforma distribuída de sondas como a RIPE Atlas pode fazer perguntas de DNS a partir de muitas redes e localidades, revelando diferenças geográficas e dependentes do resolvedor. O OpenINTEL enfatiza amplitude, repetição e escala de arquivo a partir de sua infraestrutura de medição. Uma população menor de muitos pontos de observação pode responder a uma pergunta que uma única varredura diária vasta não pode.
Essas distinções evitam um erro comum: tratar todos os grandes conjuntos de dados de internet como evidência intercambiável. Um domínio ausente do DNS ativo, invisível em dados passivos e inacessível em uma varredura de endereços ainda pode existir atrás de controle de acesso ou nomenclatura de horizonte dividido. Um domínio observado pelos três métodos tem evidência mais forte de operação pública, mas mesmo isso não estabelece quem o usou nem por quê.
A oportunidade estratégica não é construir um único banco de dados universal. É conectar métodos por meio de carimbos de data/hora, populações e incerteza explícitos. O OpenINTEL pode fornecer a camada longitudinal de nomenclatura nesse sistema de evidências maior. Seu valor cresce quando os analistas sabem quais perguntas exigem outro instrumento.
A adoção de DNSSEC só se torna legível por meio de medições repetidas
O DNSSEC é um exemplo útil do porquê um arquivo diário importa. Uma zona pode publicar material de delegação, servidores autoritativos podem servir registros assinados e validadores podem decidir se a cadeia resultante é segura. Esses estágios não se movem necessariamente juntos. Um registro de código de país pode ativar delegações assinadas enquanto muitos detentores de domínio permanecem sem assinatura. Um domínio pode publicar chaves, mas falhar na validação porque as assinaturas expiram ou um registro pai está errado. Uma varredura de um dia pode contar estados; não pode mostrar como os operadores entraram, saíram ou os repararam.
O OpenINTEL pode acompanhar o aparecimento e o desaparecimento de registros relevantes em uma população definida. Os pesquisadores podem separar domínios que permanecem sem assinatura daqueles configurados intermitentemente, identificar mudanças em torno de transições de algoritmos ou chaves e medir por quanto tempo os estados quebrados persistem. O método repetido transforma uma porcentagem de adoção em um conjunto de caminhos operacionais.
A interpretação ainda depende do desenho da medição. Ver registros DNSKEY ou DS não é idêntico a executar cada etapa de validação exatamente como o resolvedor recursivo de um usuário faria. As respostas podem diferir por ponto de observação, e um domínio pode estar assinado enquanto sua aplicação permanece indisponível. Um projeto que estuda DNSSEC precisa declarar quais registros, lógica de validação e categorias de erro usou. Comparações entre anos precisam considerar o crescimento da lista e mudanças de software.
Essas qualificações tornam o resultado mais útil, não menos. Discussões de padrões muitas vezes dependem de números principais de adoção que escondem o custo da manutenção. Dados longitudinais podem mostrar se uma mudança produz configuração durável, uma explosão de experimentação ou um padrão recorrente de falhas. Eles podem distinguir uma implantação lenta de uma que chegou a um platô porque a população restante tem incentivos diferentes.
A mesma lógica se aplica a registros IPv6, segurança de e-mail e outras práticas de infraestrutura. Uma tecnologia não está implantada apenas porque um registro apareceu uma vez. Ela se torna infraestrutura quando a configuração persiste, as falhas são reparadas e os sistemas dependentes se comportam de forma consistente. O arquivo do OpenINTEL pode revelar essas transições porque preserva evidências diárias suficientes para separar um evento de um hábito.
Para os operadores, esse histórico pode ser desconfortável. Um registro longo torna visível a configuração incorreta repetida. Ele também pode estabelecer que um problema foi corrigido antes de um incidente ou intervenção de política. A medição não atribui intenção, mas muda a qualidade do argumento. A discussão passa da lembrança para evidências datadas.
A concentração de provedores aparece em padrões, enquanto a causalidade fica fora do conjunto de dados
O DNS pode expor onde a infraestrutura está concentrada. Muitos domínios podem delegar ao mesmo provedor autoritativo, apontar e-mail para o mesmo serviço ou resolver nomes da web para espaço de endereços associado a um pequeno conjunto de plataformas. Acompanhar essas relações ao longo do tempo pode mostrar consolidação, migração e dependência que seriam difíceis de reconstruir após uma mudança de mercado.
O OpenINTEL é adequado para a parte descritiva desse trabalho. Registros repetidos podem revelar que os domínios de servidores de nomes de um provedor aparecem em uma fatia crescente de uma população medida, que uma aquisição é seguida por uma mudança nos padrões de nomenclatura ou que domínios se afastam após uma interrupção. O enriquecimento de endereços e sistemas autônomos pode conectar nomes à infraestrutura de rede, sujeito à precisão e ao momento dos dados de roteamento.
O arquivo não pode explicar todos os motivos de uma mudança. Um domínio pode usar um provedor por causa de preço, desempenho, segurança, um pacote de registrador ou uma fusão organizacional. A marca compartilhada de servidor de nomes pode esconder várias infraestruturas independentes. Uma grande plataforma pode usar muitos sistemas autônomos, enquanto um sistema autônomo pode hospedar clientes sem relação. Dados de DNS apoiam uma medida de concentração; eles não provam poder de mercado nem satisfação do cliente.
A consequência para políticas é direta. Um regulador pode ser tentado a tratar uma fatia medida alta como evidência de controle nocivo. Um operador pode tratar a mesma fatia como evidência de que um serviço conquistou confiança. O conjunto de dados pode estabelecer o padrão e a data. Conclusões econômicas e jurídicas exigem contratos, registros de propriedade, evidências de interrupção e custos de troca para os usuários.
A medição longitudinal acrescenta dois insights que um instantâneo de mercado perde. Primeiro, ela pode mostrar a velocidade da concentração. Um movimento lento de uma década tem causas e remédios diferentes de uma mudança súbita causada pela retirada de um produto. Segundo, ela pode mostrar reversibilidade. Se domínios trocam de provedor com frequência, um mercado concentrado ainda pode ter mobilidade prática. Se delegações persistem apesar de falhas repetidas, a dependência pode ser mais profunda do que a fatia principal sugere.
O histórico também pode revelar risco de modo comum oculto. Organizações podem acreditar que usam hosts de aplicação diversos enquanto delegam DNS, e-mail e certificados pela mesma família de provedores. Uma falha nessa camada compartilhada pode afetar sistemas de outra forma separados. O OpenINTEL não modela toda a cadeia de dependência, mas pode fornecer a evidência de nomenclatura a partir da qual um mapa mais completo começa.
O uso mais responsável do arquivo, portanto, é tratar a concentração como uma estrutura observada e depois investigar o mecanismo. Uma plataforma de medição deve tornar a dependência visível sem fingir que uma lista de registros contém toda a economia política da internet.
Certificados, registros de e-mail e nomes podem ser unidos sem se tornar um único sistema
O DNS não opera isoladamente. Os logs de Transparência de Certificados expõem nomes enviados para certificados públicos. Registros de e-mail identificam infraestrutura de troca e política. Registros de endereço apontam para redes de hospedagem. Nomes reversos podem fornecer pistas administrativas. Os produtos de origem e as consultas repetidas do OpenINTEL tornam possível examinar como esses sistemas se alinham ao longo do tempo.
Nomes derivados de certificados expandem a população observável além dos domínios de ápice disponíveis em uma lista de zona. Eles podem revelar subdomínios de serviço e nomes temporários que importam para a pesquisa de PKI. A fonte é seletiva: favorece certificados registrados publicamente e inclui nomes que podem nunca ter servido tráfego. Um certificado pode permanecer em um log após o serviço associado desaparecer. A medição ativa de DNS acrescenta uma observação de configuração atual, não prova de que o certificado está instalado ou é confiável para um navegador.
Os registros de e-mail criam um mapa diferente. Alvos MX e registros TXT relacionados podem mostrar movimento em direção a provedores de e-mail hospedado, adoção de políticas de autenticação e erros de configuração. Observações repetidas podem identificar se uma política foi mantida ou testada brevemente. Elas não mostram volume de mensagens, sucesso na entrega nem como os sistemas receptores aplicaram a política.
Registros de infraestrutura também podem apoiar a reconstrução de incidentes. Se um domínio mudou servidores de nomes, hosts de e-mail e endereços em um período estreito, os investigadores ganham uma linha do tempo. A sequência pode refletir uma migração legítima, recuperação de comprometimento ou tomada de controle. O histórico de DNS estreita as perguntas; ele não rotula o evento.
O valor vem de unir evidências preservando sua origem. Um log de certificado, uma zona, uma resposta ativa e uma tabela de roteamento têm tempos e autoridades diferentes. Combiná-los em uma análise pode revelar uma relação, mas a conclusão é tão forte quanto a junção mais fraca. Um nome reutilizado por vários serviços, um endereço atrás de uma plataforma compartilhada ou um certificado obsoleto pode criar uma associação falsa.
O papel do OpenINTEL é mais forte quando ele mantém esses conjuntos de dados distinguíveis. Os pesquisadores devem poder dizer que um nome entrou na lista de alvos por meio de um log de certificado, retornou um registro específico durante a medição ativa e mapeou para um prefixo de rede sob uma visão de roteamento datada separadamente. Essa frase é menos dramática do que dizer que a plataforma “conhece a internet”, mas é reproduzível.
Essa disciplina de múltiplas fontes também é uma defesa contra a certeza retrospectiva. Após um incidente, analistas naturalmente procuram uma história nos dados. Uma trilha de medição versionada força a história a respeitar o que era observável na época. Ela pode mostrar que dois eventos estavam correlacionados sem afirmar que um causou o outro.
Classificações de prefixos estendem o arquivo de nomes para redes
As listas temporais de principais prefixos do projeto ilustram como o OpenINTEL pode produzir produtos derivados, em vez de apenas respostas DNS brutas. Uma classificação de prefixos agrega evidências em nível de rede e acompanha como a proeminência muda ao longo do tempo. Isso pode ajudar os pesquisadores a selecionar redes representativas, estudar a concentração de infraestrutura ou comparar alvos de medição sem reconstruir as mesmas junções para cada artigo.
Um prefixo não é uma organização. Anúncios de roteamento podem mudar, espaço de endereços pode ser alugado e uma rede pode hospedar muitos serviços sem relação. As classificações dependem dos nomes e tipos de registros incluídos, da data dos dados de roteamento e da métrica usada para contar proeminência. Uma posição alta pode significar hospedagem ampla, infraestrutura compartilhada ou um efeito de seleção da lista.
O desenho temporal é a parte útil. Uma lista estática fica obsoleta rapidamente à medida que os serviços se movem e o roteamento muda. Classificações repetidas podem mostrar quando uma rede entra ou sai de uma posição proeminente e permitir que pesquisadores reproduzam uma população apropriada a uma data anterior. Elas também expõem instabilidade que uma única lista de “principais redes” ocultaria.
Conjuntos de dados derivados reduzem o custo da pesquisa. Eles podem tornar análises sofisticadas de infraestrutura disponíveis para equipes sem o armazenamento e a computação necessários para processar o arquivo completo. Esse benefício aumenta a responsabilidade do projeto de publicar metodologia e versionamento. Os usuários podem tratar uma classificação conveniente como verdade objetiva quando ela é uma visão produzida a partir de insumos selecionados.
A expansão para produtos em nível de rede não transforma o OpenINTEL em um observatório de roteamento nem em um RIR. Ele usa contexto público de registros e roteamento para enriquecer observações de DNS. Validade de rota, disputas de propriedade e desempenho operacional permanecem perguntas separadas.
Essa fronteira é estrategicamente saudável. O projeto pode oferecer evidências derivadas comuns sem reivindicar autoridade sobre as entidades que classifica. O produto é mais valioso quando economiza trabalho computacional e deixa o julgamento analítico visível.
A pesquisa de segurança ganha uma linha do tempo, não um veredito sobre maliciosidade
Dados históricos de DNS são atraentes para equipes de segurança porque a infraestrutura de abuso muitas vezes se move. Um domínio pode rotacionar endereços, servidores de nomes ou sistemas de e-mail; uma campanha pode reutilizar provedores; um incidente pode ser descoberto depois que a configuração relevante mudou. O OpenINTEL pode fornecer observações datadas que tornam essas transições recuperáveis.
Essa evidência é especialmente útil para definir escopo. Investigadores podem perguntar quando um domínio suspeito apareceu pela primeira vez em uma lista medida, se seu serviço autoritativo mudou em torno de um evento e quais outros nomes compartilharam a mesma infraestrutura naquele momento. Um pesquisador de segurança pode usar essas relações para gerar hipóteses e escolher quais sistemas exigem exame mais próximo.
Nenhum dos registros estabelece maliciosidade por si só. Mudanças rápidas podem ser sinal de evasão, mas também ocorrem em redes de distribuição de conteúdo, recuperação de desastres e migrações legítimas. Hospedagem compartilhada coloca domínios benignos e nocivos no mesmo endereço. Uma associação de servidor de nomes pode refletir um padrão de registrador, e não controle comum. Mesmo um padrão que se assemelha fortemente a uma campanha conhecida precisa de corroboração de conteúdo, registro, malware, telemetria ou evidências legais.
Essa distinção importa porque conjuntos de dados históricos podem fazer associações parecerem mais duráveis do que foram. Um domínio que compartilhou um endereço por um dia pode ser agrupado com outro por anos em um banco de dados derivado de um analista. Janelas de tempo e confiança devem acompanhar a relação. Assim também a população de origem: um subdomínio derivado de certificado e um nome de ápice de zona de registro não entraram no arquivo da mesma forma.
O papel do OpenINTEL é preservar os fatos de infraestrutura que, de outra forma, poderiam desaparecer. Rotulação, atribuição e resposta pertencem a processos separados. O trabalho de segurança é mais forte quando o arquivo estreita a incerteza sem ser solicitado a resolver intenção.
O arquivo torna a mudança de infraestrutura contestável
Cada dia de medição agrega valor operacional e obrigação de armazenamento. O projeto deve manter capacidade de consulta, substituir hardware, migrar bancos de dados e reter especialistas que entendam tanto o DNS quanto o histórico do sistema. Nenhuma dessas tarefas está garantida apenas porque o arquivo se tornou importante.
O modelo de quatro parceiros distribui o risco, mas também torna a sustentabilidade mais difícil de ler de fora. Uma instituição pode financiar pessoal, outra computação e outra acesso a dados de origem. Uma mudança em qualquer componente pode reduzir a cobertura sem um anúncio corporativo convencional. Contas financeiras públicas do projeto como um todo não estão disponíveis, então os usuários devem observar sinais técnicos e institucionais em vez de assumir continuidade.
A curadoria do arquivo exige redundância além de backups. Uma cópia replicada deve incluir esquemas, registros de método, versões de listas de origem e o conhecimento necessário para interpretar anomalias. Uma pilha de arquivos em outro local não é um instrumento histórico funcional. A colaboração com organizações como a CAIDA pode melhorar a resiliência e a comparação metodológica, embora dados contratuais possam limitar o que pode ser copiado.
O modelo de licenciamento também molda o futuro. O acesso aberto não comercial apoia o reúso acadêmico, mas restringe algumas aplicações comerciais. Dados de zona controlados não podem simplesmente ser liberados sob uma licença mais ampla. Os parceiros podem precisar de arranjos de financiamento que preservem o acesso à pesquisa enquanto recuperam o custo real de armazenamento e suporte. Um caminho comercial, se desenvolvido, não deve estreitar silenciosamente o registro público no qual a legitimidade do projeto se apoia.
O sucesso pode criar fragilidade por si só. À medida que mais artigos e alegações de políticas dependem do OpenINTEL, um período ausente ou um conjunto de dados alterado afeta uma comunidade mais ampla. O projeto pode precisar de registros de liberação mais formais, expectativas de serviço e política de preservação do que um sistema de pesquisa normalmente publica. Esses não são sinais de que ele deva se tornar uma empresa. São sinais de que ele se tornou infraestrutura.
O marco futuro mais valioso pode ser um que não produza manchete: uma migração transparente para novo armazenamento com os resultados antigos, ressalvas e caminhos de acesso intactos. O OpenINTEL já mostrou que pode medir em escala notável. O teste mais difícil é se as organizações por trás dele podem preservar as condições que tornam dez anos de medições comparáveis aos próximos dez.
O OpenINTEL não pode contar toda a história do DNS. Ele pode mostrar que um nome definido retornou uma resposta definida de seu ponto de observação em uma data, e pode repetir essa observação em populações enormes. Isso é suficiente para transformar muitas afirmações.
Um provedor pode dizer que a adoção de DNSSEC aumentou; o arquivo pode mostrar a transição e a população medidas. Um pesquisador pode afirmar que a hospedagem autoritativa se concentrou; os dados podem revelar quais listas e períodos sustentam isso. Um investigador de incidentes pode reconstruir quando um registro mudou. Outro analista pode contestar a metodologia em vez de aceitar uma captura de tela.
A escala do projeto é impressionante: centenas de milhões de domínios, bilhões de pontos diários e trilhões de observações acumuladas, de acordo com suas próprias métricas atuais. A conquista mais importante é a continuidade em meio a mudanças institucionais e técnicas. O arquivo torna o passado do DNS disponível como evidência, não como memória.
Essa evidência permanece limitada por listas, contratos, ponto de observação e método. A credibilidade do OpenINTEL vem da preservação desses limites. Chamá-lo de cópia completa do DNS superestimaria o projeto e enfraqueceria a utilidade de seu registro real.
Um observatório histórico não precisa ver tudo. Ele precisa declarar o que viu, preservar as condições e permanecer disponível por tempo suficiente para que a mudança seja medida. O OpenINTEL construiu esse tipo de instrumento para a infraestrutura de nomenclatura. Seu próximo desafio é garantir que o arquivo e as instituições por trás dele permaneçam tão duráveis quanto as tendências que os pesquisadores esperam estudar.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance