
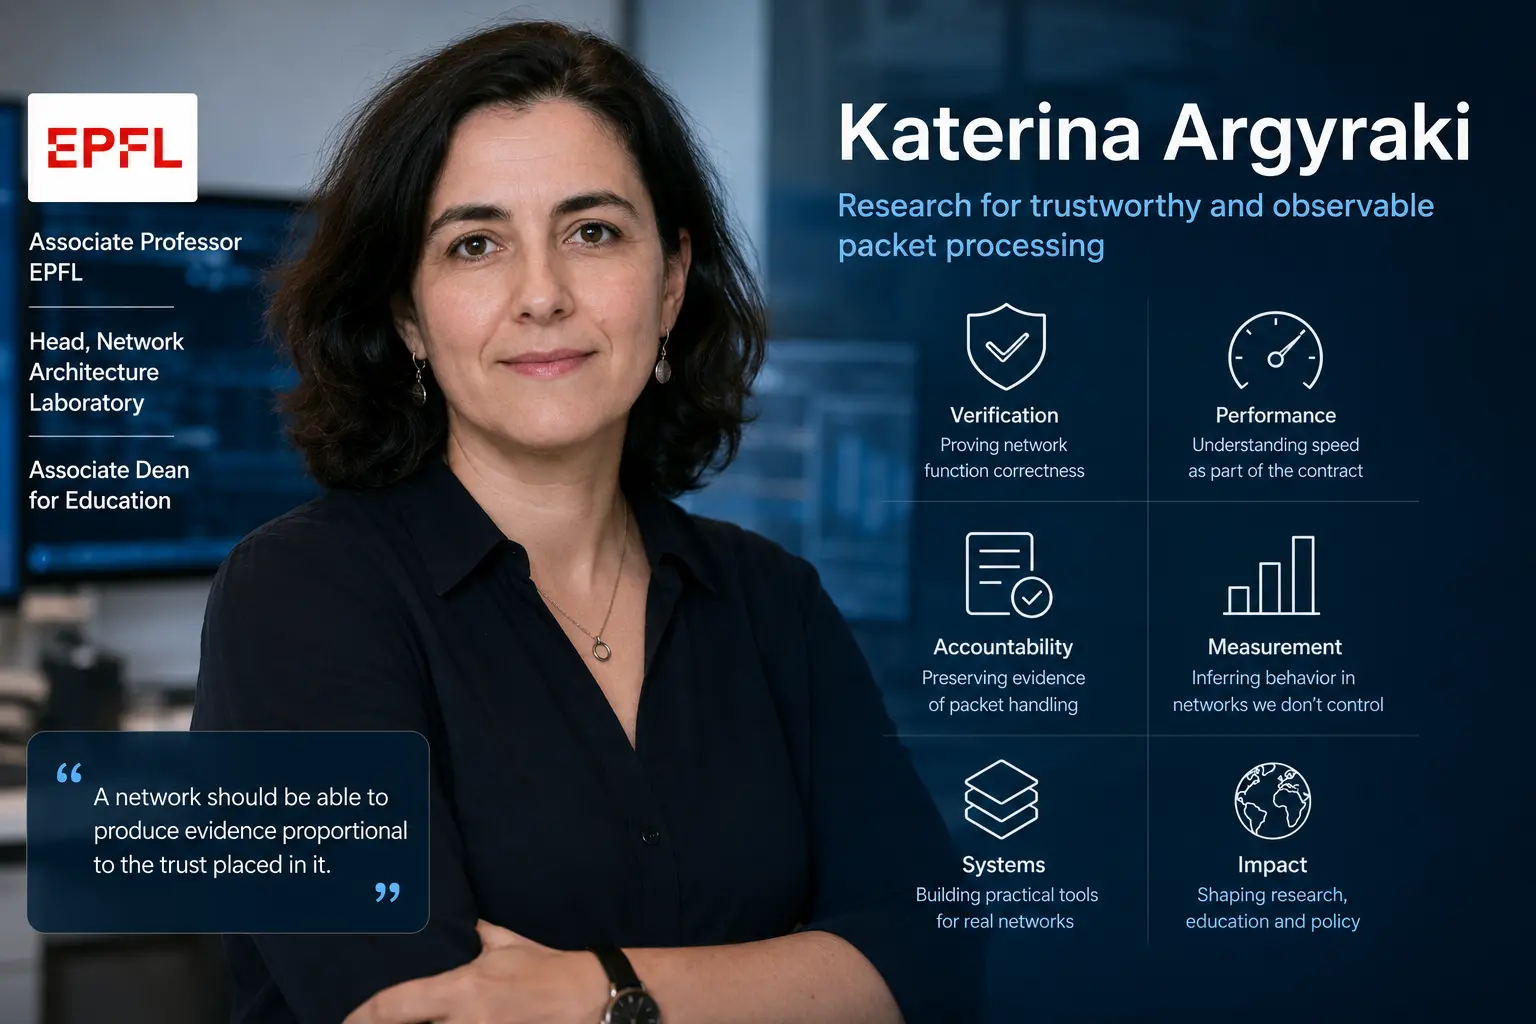
Resumo
- Katerina Argyraki lidera o Network Architecture Laboratory da EPFL e atua como vice-diretora de Educação; sua pesquisa investiga como o comportamento do processamento de pacotes pode ser comprovado, medido e explicado, em vez de aceito por confiança.
- RouteBricks estabeleceu que o encaminhamento por software poderia escalar por meio de paralelismo, enquanto trabalhos posteriores — Software Dataplane Verification, um NAT verificado, Vigor e Klint — deslocaram a garantia de regras abstratas para o código de implementação e até para binários sem código-fonte.
- PIX e o raciocínio posterior sobre cache tratam o desempenho como parte da correção, reconhecendo que uma função pode encaminhar os pacotes certos e ainda violar expectativas de latência ou vazão em uma CPU, NIC ou hierarquia de memória específica.
- Recibos de pacotes, inferência de neutralidade, extração de latência de gravações de jogos e estudos de cache de borda ampliam a responsabilização para redes que observadores não controlam, mas nenhum desses métodos consegue provar toda causa interna ou intenção apenas com evidência externa.
O processamento de pacotes normalmente pede que o usuário confie em uma cadeia invisível
Um pacote entra em um roteador de software ou middlebox. O código analisa seus cabeçalhos, consulta tabelas, atualiza estado, talvez altera um endereço ou escolhe um backend e então encaminha ou descarta o pacote. O operador vê contadores e logs. O cliente vê um resultado. Nenhum dos dois possui necessariamente uma prova de que a implementação realizou a transformação pretendida, evitou falhas de memória, cumpriu seu objetivo de latência e tratou tráfego comparável de forma consistente.
Essa lacuna é fácil de ignorar quando a função é empacotada como um appliance. Um firewall pode expor uma interface de políticas e um painel de integridade enquanto esconde o caminho de código que aplica a regra. Uma função de rede virtual pode ser entregue como um binário cujo fornecedor considera o código-fonte proprietário. Um serviço de nuvem pode revelar latência de ponta a ponta, mas não as filas, caches ou decisões de posicionamento que a produziram.
A garantia de rede tradicionalmente aborda partes do problema. A verificação de configuração pode verificar se as regras de encaminhamento criam um loop ou violam isolamento. Testes podem enviar pacotes representativos. Monitoramento pode observar perda e atraso. Esses controles são úteis, mas não respondem à mesma pergunta. Um modelo de política correto não prova que a implementação em C é segura quanto à memória. Um teste funcional aprovado não descreve o desempenho sob um estado de cache diferente. O atraso de ponta a ponta não identifica qual rede aplicou tratamento diferente.
O histórico de pesquisa de Argyraki pode ser lido como um esforço para construir evidências em cada fronteira. O primeiro passo foi mostrar que o processamento de pacotes por software poderia alcançar desempenho sério. Uma vez que o software flexível se tornou um plano de dados viável, a correção não podia mais ser descartada como um problema de protótipos de baixa velocidade. O trabalho de verificação passou então de modelos de alto nível para código e binários. O trabalho de interface de desempenho tratou a velocidade como um comportamento a ser descrito, não um benchmark a ser repetido.
Recibos de pacotes preservaram evidências de eventos de encaminhamento selecionados. A medição externa buscou responsabilização onde o observador não tinha acesso à implementação.
O resultado não é um sistema de certificação único. É uma pilha de métodos com suposições diferentes. Prova formal precisa de uma especificação e de um modelo de ambiente confiável. Verificação de binários precisa de contratos que descrevam o comportamento permitido. Uma interface de desempenho está ligada a hardware e carga de trabalho. Um recibo pode ser autêntico e ainda assim incompleto. Uma inferência externa pode revelar um padrão sem provar motivo.
Argyraki é professora associada da EPFL, chefe do Network Architecture Laboratory e vice-diretora de Educação na School of Computer and Communication Sciences. Seus papéis institucionais estabelecem responsabilidade atual por um programa de pesquisa e educação; não fazem dela a única autora dos sistemas associados ao laboratório. Os artigos incluem estudantes e colaboradores cujo trabalho de implementação e conceitual deve permanecer visível.
A forma mais útil de avaliar sua contribuição, portanto, não é contar nomes de projetos. É examinar como esses projetos reduzem formas distintas de incerteza. A questão comum é se uma rede pode produzir evidências proporcionais à confiança depositada nela.
Trabalhos iniciais conectaram comutação de alta velocidade a questões acadêmicas de sistemas
Registros da EPFL indicam que Argyraki concluiu o doutorado na Universidade Stanford em 2007 e foi funcionária dos primeiros anos da Arista Networks antes de ingressar na EPFL. A combinação é relevante porque a colocou perto de duas pressões que moldaram a rede moderna: a demanda por comutação de alto desempenho e o desejo de mover mais comportamento de rede para o software.
O contexto inicial da Arista não deve ser transformado em autoria de produtos ou em uma narrativa de participação acionária sem respaldo em evidências públicas. Sua importância é experiencial. A comutação comercial expõe restrições que modelos acadêmicos podem simplificar: taxas de pacotes, hierarquias de memória, interfaces de dispositivos, pressão de lançamento e clientes cujas redes não podem pausar para uma prova.
Planos de dados em software ofereciam uma forma diferente de controle. Processadores de propósito geral permitiam que desenvolvedores alterassem funções de pacotes sem esperar por um novo ASIC de função fixa. A contrapartida era desempenho e previsibilidade. Uma implementação flexível que processasse poucos pacotes por segundo ou se comportasse de forma errática sob carga continuaria sendo um objeto de laboratório.
Essa tensão criou a base para RouteBricks. Se o encaminhamento por software pudesse escalar por meio de paralelismo entre núcleos e servidores, roteadores e middleboxes poderiam se tornar sistemas programáveis comuns. Uma vez que isso aconteceu, as questões familiares de software vieram em seguida: como estabelecer segurança de memória, correção funcional, comportamento de desempenho e responsabilização após a implantação.
A pesquisa de Argyraki resistiu consistentemente a resolver uma camada fingindo que as outras não existem. Uma prova que ignora o driver ou o hardware pode ser útil, mas limitada. Um benchmark que omite a complexidade das políticas pode ser rápido, mas não representativo. Uma inferência que detecta diferenciação não pode identificar automaticamente a intenção. Os sistemas são construídos em torno dessas fronteiras, em vez de escondidos atrás de uma alegação universal.
O ambiente acadêmico também importa. Um laboratório pode desenhar métodos cujo valor não é imediatamente comercial. Recibos de pacotes podem exigir nova infraestrutura e governança antes que um operador os adote. A verificação de binários pode alterar a aquisição sem se tornar um produto autônomo. A medição externa pode informar um debate regulatório mesmo quando não produz uma conclusão legal.
O papel atual de Argyraki como vice-diretora de Educação acrescenta outra dimensão institucional. O trabalho depende da formação de pesquisadores que possam circular entre redes, métodos formais, medição e desempenho de sistemas. Esses campos usam conceitos diferentes de evidência. Um engenheiro de redes pode aceitar um teste; um pesquisador de verificação pergunta o que foi provado; um cientista de medição pergunta como a amostra foi selecionada. O programa de pesquisa ganha força ao trazer esses padrões para a mesma conversa.
RouteBricks tornou o encaminhamento por software rápido o bastante para merecer garantias mais fortes
RouteBricks, reconhecido com o prêmio de melhor artigo da SOSP 2009, explorou como o processamento de pacotes poderia ser distribuído entre servidores commodity e núcleos de processadores. A arquitetura usava paralelismo para construir um roteador de software de alta velocidade, em vez de supor que uma única máquina de propósito geral tivesse que carregar cada pacote por um único caminho serial.
A importância do trabalho não é um número de vazão atemporal. Hardware, drivers e frameworks de processamento de pacotes mudaram substancialmente desde 2009. RouteBricks demonstrou que o roteamento por software poderia ser organizado como um sistema escalável e que os limites de desempenho não eram necessariamente um argumento para manter a lógica de pacotes dentro de appliances fechados.
O encaminhamento paralelo por software levanta várias questões de projeto. Os pacotes devem ser distribuídos entre núcleos sem destruir a afinidade de fluxos. O estado compartilhado por fluxos pode criar contenção. As filas da interface de rede precisam ser mapeadas para threads de processamento. A alocação de memória e a localidade de cache afetam a vazão. Enviar trabalho para outro servidor acrescenta preocupações de comunicação e ordenação.
A arquitetura só pode escalar onde a carga de trabalho puder ser particionada. Um encaminhador sem estado é mais fácil do que uma função de rede com contadores compartilhados, estado de conexão ou políticas complexas. Um benchmark baseado em pacotes de tamanho mínimo estressa um caminho diferente daquele dominado por transferências grandes. As evidências experimentais do artigo devem permanecer ligadas ao seu ambiente de teste e às suas funções.
RouteBricks, ainda assim, mudou o problema da responsabilização. Se o roteamento por software fosse permanentemente mais lento que o hardware, a garantia formal poderia permanecer uma preocupação de nicho. Um roteador de software de alta velocidade e credível criou uma escolha real de implantação. Os operadores poderiam ganhar flexibilidade, mas também executariam mais código no caminho dos pacotes e precisariam de evidências de que esse código era seguro.
O trabalho antecipou frameworks posteriores como DPDK, VPP e XDP sem ser idêntico a eles. Esses ecossistemas fornecem E/S e modelos de processamento de pacotes de alto desempenho. Eles não verificam automaticamente toda função de rede construída sobre eles. RouteBricks pertence à linhagem de desempenho que tornou essas funções práticas; a pesquisa posterior de Argyraki tratou da confiança que elas exigiam.
O prêmio foi um resultado de equipe. Um perfil centrado em uma professora não deve apagar os colaboradores que projetaram, implementaram e avaliaram o sistema. A contribuição defensável é seu papel em uma trajetória de pesquisa que conectou a escala do encaminhamento por software com questões posteriores de verificação.
A transição é importante porque desempenho e correção frequentemente competem pela atenção da engenharia. Código otimizado usa agrupamento (batching), prefetching, layouts de memória especializados e suposições de driver que podem tornar o raciocínio mais difícil. Os sistemas posteriores de Argyraki não evitaram essa tensão. Eles tentaram mostrar que garantias úteis poderiam coexistir com processamento competitivo de pacotes, em vez de exigir uma implementação lenta e simplificada.
A verificação de planos de dados de software levou a garantia para além do modelo de configuração
Por volta de 2014, a verificação de redes havia avançado substancialmente na checagem de regras e configurações de encaminhamento. Um modelo podia determinar se um pacote poderia alcançar um destino proibido ou ficar preso em um loop. O modelo supunha que os dispositivos implementavam suas regras corretamente. A verificação de planos de dados de software desafiou essa suposição ao analisar o código de implementação.
Uma função de rede pode violar sua política de várias formas que um modelo de configuração não revelará. Ela pode desreferenciar memória inválida, lidar mal com pacotes malformados, atualizar estado na ordem errada, falhar em um cabeçalho inesperado ou implementar um protocolo de forma diferente da especificação. Uma prova sobre a tabela de encaminhamento pretendida não cobre esses defeitos.
O trabalho de melhor artigo da NSDI 2014 teve como alvo o próprio plano de dados de software. A pesquisa usou técnicas de verificação para estabelecer propriedades dos caminhos de implementação, trazendo o código de processamento de pacotes para um domínio mais associado a pequenos programas críticos do que a redes orientadas a desempenho.
Essa mudança altera a base de computação confiável. Em vez de supor que a função de rede está correta, a prova assume um verificador, uma especificação e um modelo do ambiente. Drivers, hardware, comportamento do compilador e bibliotecas externas podem permanecer fora da fronteira. Uma declaração responsável de verificação deve nomear essas suposições.
Especificações são outra fonte de risco. Um verificador pode provar que o código atende a uma propriedade incompleta ou errada. Para um NAT, a especificação deve dizer como os mapeamentos são alocados, quando expiram e quais pacotes são rejeitados. Para um firewall, ela deve definir política e comportamento de estado. Um operador pode se importar com requisitos de nível de serviço que não estão presentes no modelo formal.
O trabalho continua estrategicamente valioso porque realoca o desacordo. Em vez de argumentar que um binário é “confiável” porque um fornecedor o construiu, as partes podem examinar a propriedade, a fronteira da prova e as suposições. Uma verificação que falha pode identificar um caminho concreto. Uma verificação bem-sucedida pode reduzir uma classe de incerteza sem alegar onisciência.
A verificação em nível de código também tem implicações operacionais. Funções de rede evoluem. Um patch pode invalidar uma prova ou alterar uma suposição. O processo de verificação precisa ser repetível como parte do desenvolvimento, em vez de ser realizado uma única vez para um artigo. Ferramentas, reprodutibilidade de build e propriedade da especificação passam a fazer parte do ciclo de vida do software.
Protótipos acadêmicos enfrentam uma lacuna de industrialização nessa fronteira. Um artigo pode verificar uma função limitada em um ambiente documentado. Um operador precisa de integração com CI, suporte para seu compilador e versões de driver, diagnósticos quando a prova falha e engenheiros capazes de atualizar o contrato. A pesquisa demonstra a possibilidade; a implantação sustentada exige uma instituição em torno do método.
Um NAT verificado mostrou como especificações estreitas podem produzir afirmações fortes
O trabalho sobre um tradutor de endereços de rede formalmente verificado forneceu um teste focado da abordagem de verificação. NAT é conceitualmente familiar, mas com estado. Ele mapeia endereços e portas internos para externos, rastreia sessões, reescreve pacotes e lida com timeouts. Um pequeno erro pode enviar tráfego para o endpoint errado, vazar um mapeamento ou derrubar a função.
Um alvo de verificação útil precisa ter complexidade suficiente para importar e estrutura suficiente para especificar. NAT oferece ambos. A implementação pode ser verificada quanto à segurança de memória e às relações entre pacotes de entrada, estado e saída. O resultado pode mostrar que transformações definidas valem em todos os caminhos do programa, e não apenas para um conjunto de testes.
A força da afirmação depende do que o modelo inclui. Se o driver entrega um comprimento de buffer malformado que o modelo de ambiente exclui, a prova pode não cobrir o comportamento resultante. Se o hardware ou o compilador violar uma suposição, a propriedade verificada no código-fonte pode não valer no binário. Se a implantação adicionar um recurso customizado, a prova original não descreve mais a função completa.
Essas ressalvas não tornam a verificação formal vazia. Testes comuns também dependem de um ambiente e deixam de cobrir caminhos não testados. O valor de uma prova é que suas suposições e propriedades podem ser declaradas com precisão e que ela cobre um espaço mais amplo de entradas dentro dessas suposições do que testes amostrados.
A linhagem do NAT ajudou a motivar componentes verificados reutilizáveis. Uma função totalmente provada à mão pode exigir um esforço indisponível para a maioria dos desenvolvedores de rede. Para influenciar a infraestrutura, o método precisa de abstrações para estruturas de dados comuns e padrões de processamento de pacotes. O ônus da prova precisa migrar para ferramentas e bibliotecas, em vez de permanecer inteiramente com especialistas.
A questão é econômica tanto quanto técnica. A verificação custa tempo antecipadamente. Seus benefícios aparecem como defeitos evitados, revisão mais fácil ou maior confiança na aquisição. Esses benefícios são difíceis de quantificar sem evidência de produção. Uma função de rede de alto risco pode justificar o esforço; um recurso experimental pode mudar rápido demais para que uma prova profunda permaneça atual.
A pesquisa de Argyraki não fornece uma fórmula universal de custo. Ela demonstra um caminho pelo qual a afirmação “esta função é segura” pode ser substituída por uma garantia limitada e inspecionável. Essa mudança importa em infraestrutura onde um único binário pode processar tráfego de muitos inquilinos e onde o código-fonte pode não estar disponível para o operador.
Vigor tentou tornar a prova de pilha completa um fluxo de trabalho de desenvolvimento
Vigor, publicado na SOSP em 2019, buscou automatizar a construção de funções de rede verificadas usando componentes reutilizáveis, execução simbólica e especificações formais. A ambição era prática: um desenvolvedor não deveria precisar se tornar especialista em prova de teoremas para construir um NAT, uma bridge, um firewall, um balanceador de carga ou um policiador com garantias fortes.
O sistema fornecia estruturas de dados verificadas e um modelo de programação restrito. A execução simbólica explorava caminhos de pacotes e estado. As especificações descreviam a relação esperada entre entradas, estado e saídas. As funções resultantes buscavam entregar desempenho competitivo com software comum enquanto carregavam provas sobre segurança e comportamento.
Restringir o modelo de programação faz parte do método. C arbitrário com ponteiros e concorrência sem restrições é difícil de verificar. Um framework pode tornar a prova tratável controlando como o estado é representado e quais operações são permitidas. Essa restrição também pode tornar alguns recursos inconvenientes ou impossíveis. A pergunta certa não é se Vigor verifica “C” em geral, mas qual classe de função de rede se encaixa em seu modelo.
A expressão “pilha completa” exige cuidado. Descrições de projetos podem sugerir verificação até o hardware, mas toda garantia mantém componentes confiáveis e modelos. O verificador, as especificações, o compilador, as suposições do driver e a interface de hardware formam uma fronteira. Uma errata de CPU ou um defeito de firmware de NIC não é eliminado porque a lógica da função de rede foi provada.
A importância de Vigor está na composabilidade. Containers verificados e primitivas de processamento de pacotes podem ser reutilizados entre funções. A prova de um componente reduz o esforço repetido. O fluxo de trabalho de desenvolvimento pode detectar violações quando o código muda, em vez de após uma implantação.
O sistema também ilustra por que o desempenho não é uma preocupação secundária. Uma função verificada que consome substancialmente mais CPU pode ser rejeitada por operadores mesmo quando sua segurança é mais forte. As avaliações de Vigor tentaram mostrar que a prova não exige um plano de dados impraticável. Os resultados permanecem ligados ao hardware e às funções avaliadas.
A adoção operacional exigiria mais do que código aberto. Toolchains precisam rodar em sistemas atuais. As especificações precisam de donos. Desenvolvedores precisam de contraexemplos compreensíveis. A integração com NICs, orquestração e telemetria tem que preservar a fronteira da prova. Repositórios públicos estabelecem que os artefatos existem; não estabelecem compromisso de suporte de produção nem base de clientes.
Vigor deve, portanto, ser tratado como um sistema de pesquisa importante, não como um selo de certificação. Ele mostra que uma classe de funções de rede de alto desempenho pode ser desenvolvida com garantia formal substancial. Também expõe o trabalho institucional necessário antes que uma prova se torne parte das operações comuns de rede.
Klint mudou a negociação entre operador e fornecedor ao mirar binários
A verificação de código-fonte é difícil quando o operador não recebe o código-fonte. Funções de rede comerciais podem ser entregues como binários proprietários. Um fornecedor pode fornecer documentação e testes, mas o cliente não pode supor que o binário enviado corresponde exatamente ao código-fonte revisado ou ao build.
Klint, apresentado na NSDI em 2022, tratou dessa fronteira ao verificar binários selecionados de funções de rede sem exigir código-fonte ou símbolos de depuração. Ele usou contratos e “mapas fantasma” abstratos para modelar estado e interações. A abordagem visava permitir que um operador obtivesse garantias sobre o executável que iria executar.
Isso muda a conversa de aquisição de forma concreta. Um fornecedor poderia preservar a confidencialidade do código-fonte enquanto fornece um binário e um contrato descrevendo seu comportamento pretendido. O operador poderia verificar propriedades definidas de forma independente. O desacordo passaria a girar em torno da completude do contrato e da confiabilidade da ferramenta de verificação, em vez de permanecer uma exigência de tudo ou nada por código-fonte.
O método é limitado. Klint avaliou um conjunto de funções de rede e relatou verificação na escala de minutos para esses casos. Esse resultado não é um tempo genérico de prova para binários arbitrários. Concorrência complexa, instruções não suportadas, código dinâmico ou bibliotecas externas podem expandir o espaço de estados ou ficar fora do modelo.
Um contrato também pode omitir o comportamento que mais importa. Um balanceador de carga pode ser seguro quanto à memória e ainda violar um requisito de negócio sobre afinidade. Um firewall pode satisfazer uma regra no nível de pacotes e lidar mal com tráfego de gerenciamento. O operador precisa de conhecimento para declarar as propriedades certas e identificar as suposições de ambiente.
A verificação de binários oferece uma vantagem distinta em relação a confiar em um build a partir do código-fonte. Ela verifica o artefato destinado à implantação. Isso pode capturar diferenças de compilador ou de build dentro do modelo. Não verifica hardware, firmware ou todos os componentes privilegiados ao redor da função.
A responsabilidade se torna uma questão importante de governança. Se um fornecedor fornece um contrato incompleto e a verificação passa, quem responde pela propriedade omitida? Se o verificador tem um bug, o resultado é uma garantia ou evidência de pesquisa? Ferramentas técnicas podem mudar a evidência disponível em uma disputa, mas contratos e regulação decidem o remédio.
A contribuição estratégica de Klint é tornar a disponibilidade de código-fonte e a garantia menos acopladas. Código aberto continua valioso para inspeção e manutenção. A verificação de binários fornece outro caminho onde a divulgação é restrita. Os dois podem se complementar em vez de definir campos opostos.
Um resultado verde de prova só é tão honesto quanto sua base de computação confiável
Métodos formais às vezes são apresentados por meio de um resultado binário: verificado ou não verificado. Infraestrutura exige um rótulo mais detalhado. Uma prova se aplica a uma propriedade, implementação, modelo de ambiente e toolchain. Tudo fora desse conjunto permanece confiável, não modelado ou testado separadamente.
Para uma função de rede de software, a base de computação confiável pode incluir o verificador, o provador de teoremas, o compilador, o runtime, o framework de E/S de pacotes, o driver, o firmware da NIC, a CPU e os serviços do sistema operacional. Alguns sistemas reduzem esse conjunto; nenhum remove a realidade física. A afirmação deve identificar quais componentes foram verificados e quais foram assumidos.
A especificação faz parte da base confiável porque define o sucesso. Uma implementação perfeitamente provada de uma política falha é confiavelmente errada. Especificações precisam de revisão por pessoas que entendam tanto o protocolo quanto a implantação. A precisão formal não fornece automaticamente relevância operacional.
Modelos de ambiente podem esconder entradas raras, mas importantes. Comprimentos de pacotes, comportamento de DMA, temporização, concorrência e injeção de falhas podem ser simplificados. O modelo deve ser desafiado com incidentes e fuzzing, não tratado como um documento estático. Testes e verificação formal são complementares porque falham de maneiras diferentes.
A manutenção da prova é outra fronteira. Uma função muda após uma divulgação de segurança, um pedido de recurso ou uma atualização de compilador. Se o pipeline de verificação não rodar em cada lançamento, a organização pode continuar implantando com base na reputação de um resultado antigo. A prova se torna dívida técnica em vez de garantia.
A comunicação importa porque operadores podem ler demais os rótulos. “NAT verificado” pode ser interpretado como seguro, rápido e pronto para produção quando a prova cobriu apenas transformações selecionadas de pacotes e segurança de memória. Pesquisadores e fornecedores precisam de linguagem que declare garantias sem transformar cada ressalva em uma nota de rodapé ilegível.
A pesquisa de Argyraki retorna repetidamente a esse problema de evidência calibrada. O objetivo não é fazer o usuário confiar cegamente no verificador. É substituir uma alegação vaga de confiança por uma declaração estruturada que possa ser examinada, combinada com outras evidências e atualizada quando as suposições mudarem.
É por isso que seus projetos posteriores de desempenho e responsabilização pertencem ao mesmo perfil. A prova funcional responde a uma pergunta. Ela não mostra que a função atende a um objetivo de latência, preserva evidências de um pacote disputado ou explica o comportamento em uma rede remota. Uma pilha de garantia credível precisa de instrumentos separados para essas dimensões.
PIX tratou o desempenho como uma interface, e não como um resultado de benchmark
Uma função de rede pode encaminhar todos os pacotes corretamente e ainda falhar com seu usuário. A latência pode aumentar sob um determinado tamanho de estado. A vazão pode cair para uma distribuição de pacotes. Uma mudança no layout de memória pode criar misses de cache. Um offload de NIC pode ajudar uma carga de trabalho e prejudicar outra. Correção funcional não implica desempenho utilizável.
PIX, publicado na NSDI em 2022, introduziu interfaces de desempenho: descrições compactas extraídas automaticamente de funções de rede. Em vez de relatar um único número de benchmark, o sistema tentou descrever como o desempenho mudava com entradas relevantes e condições do sistema. A interface poderia apoiar detecção de regressão, diagnóstico e raciocínio sobre offload.
A ideia aborda um problema recorrente de aquisição. Um fornecedor afirma que uma função pode processar uma determinada taxa. A carga de trabalho do operador contém diferentes tamanhos de pacote, distribuições de estado e hardware. Uma interface de desempenho pode tornar explícitas as dimensões da afirmação e revelar onde a função muda de comportamento.
A extração é, em si, uma aproximação. O sistema observa ou analisa a função em um espaço escolhido. Ele precisa selecionar variáveis, amostras e hardware. Uma interação importante omitida desse espaço não aparecerá na interface. Um modelo compacto pode ser útil sem ser completo.
A portabilidade é o limite mais agudo. Uma descrição extraída em uma CPU, hierarquia de cache, NIC, compilador e posicionamento NUMA pode não valer após uma atualização. Mesmo uma pequena mudança de código pode invalidá-la. A interface precisa de uma versão e identidade de ambiente, assim como uma API.
A avaliação de PIX cobriu doze funções de rede e vários usos. Isso estabelece uma demonstração limitada, não um modelo universal para todo processamento de pacotes. O valor de pesquisa está em tornar o desempenho um objeto de primeira classe que pode ser comparado e verificado, em vez de uma expectativa informal.
Uma interface de desempenho também pode melhorar a verificação. Se contratos funcionais dizem o que os pacotes devem fazer e contratos de desempenho dizem em quais condições eles permanecem oportunos, um operador pode avaliar ambos. Os dois podem conflitar: uma checagem de segurança mais forte pode aumentar o custo, e uma otimização pode complicar a prova. Tornar o trade visível é melhor do que deixá-lo aparecer como uma regressão inexplicada.
A abordagem depende de adoção organizacional. Desenvolvedores devem reexecutar a extração, operadores devem definir regiões aceitáveis e sistemas de implantação devem identificar o hardware com precisão. Sem esse fluxo de trabalho, a interface permanece um artefato de artigo. Com ele, o desempenho pode se tornar parte do controle de mudanças, em vez de uma surpresa descoberta em produção.
Raciocínio sobre cache de CPU levou a evidência de desempenho para além das abstrações de nível de pacote
O código de processamento de pacotes geralmente parece simples: analisar, consultar, modificar, encaminhar. Em processadores modernos, o custo pode ser dominado por onde os dados residem na hierarquia de cache, como as estruturas mapeiam para conjuntos de cache e se vários núcleos disputam linhas compartilhadas. Duas implementações com o mesmo algoritmo podem se comportar de forma muito diferente por causa do layout de memória.
O grupo de Argyraki continuou a agenda de interfaces de desempenho com um trabalho sobre raciocínio automatizado sobre o uso de cache de CPU, publicado na OSDI em 2024. A pesquisa tentou identificar comportamentos de desempenho que a análise comum de perfilagem pode expor apenas depois que uma carga de trabalho alcança um alinhamento ou padrão de contenção infeliz.
O raciocínio sobre cache importa porque funções de rede manipulam estruturas de dados repetidas em alta taxa. Uma entrada de tabela que vaza de um nível de cache, um layout de estado por fluxo que cria conflict misses ou um contador compartilhado entre núcleos pode mudar a latência de cauda e a vazão. Esses efeitos podem aparecer apenas em determinados tamanhos de tabela ou distribuições de tráfego.
Benchmarks empíricos continuam necessários. Um modelo de comportamento de cache depende de detalhes do processador e suposições do programa. Prefetching, execução fora de ordem, NUMA e DMA de NIC podem alterar os resultados. O raciocínio automatizado pode identificar condições e reduzir o espaço de busca; não cria garantias de desempenho independentes do hardware.
O trabalho reforça um ponto mais amplo: o desempenho faz parte do contrato observável do sistema. Um operador que decide se deve fazer offload de uma função precisa saber não apenas o custo médio de CPU, mas onde o software se torna instável ou sensível. Um desenvolvedor revisando um patch precisa de evidências de que um novo campo não criou um precipício de cache.
Esse nível de análise pode ser caro e especializado. Equipes de produto podem não executá-lo para cada mudança. O desafio estratégico é integrar as verificações mais valiosas em ferramentas comuns, assim como Vigor buscou transferir conhecimento de prova para componentes reutilizáveis.
O programa de pesquisa de Argyraki ganha coerência com essa progressão. RouteBricks mostrou que software paralelo podia ser rápido. A verificação estabeleceu garantias funcionais. PIX e o raciocínio sobre cache tornaram o comportamento de desempenho inspecionável. A próxima questão era como preservar evidências depois que os pacotes passassem por um sistema ou por uma rede que o observador não possuía.
Recibos de pacotes preservam evidências selecionadas sem reter todo o tráfego
A captura completa de pacotes pode fornecer evidências detalhadas, mas é cara e invasiva. Redes de alta taxa produzem volumes enormes. Payloads e identificadores levantam preocupações de privacidade e segurança. A retenção cria um alvo valioso. Um operador pode precisar investigar um evento disputado sem armazenar todos os pacotes indefinidamente.
Amostragem retroativa de pacotes e MorphIT exploraram alternativas baseadas em recibos compactos e seleção pós-evento. O objetivo era preservar evidências criptográficas ou estruturadas suficientes para que um evento pudesse ser auditado depois, reduzindo o armazenamento e limitando a exposição do conteúdo do tráfego.
A palavra “recibo” é útil porque separa evidência de captura. Um recibo pode se comprometer com o fato de que um pacote ou transformação foi observado sem reproduzir o pacote inteiro. Ele pode apoiar uma consulta ou disputa posterior. A informação exata retida determina o que pode ser provado.
A completude é o trade central. A amostragem reduz custo e risco de privacidade, mas pode perder o pacote que importa. Uma regra de seleção determinística pode ser antecipada ou enviesada. Técnicas retroativas buscam preservar opções para seleção posterior, mas ainda operam dentro de suposições de armazenamento e sensor.
A integridade criptográfica não prova que o sensor viu todos os pacotes ou foi colocado na fronteira alegada. Um ponto de medição comprometido pode omitir eventos. Um recibo pode mostrar que a evidência registrada não foi alterada, deixando a completude da captura fora da garantia.
A governança determina se o sistema é útil. Quem controla os recibos? Por quanto tempo são retidos? Os clientes podem consultá-los? Forças policiais ou litigantes podem compelir o acesso? Os recibos revelam relações de comunicação mesmo sem payload? O formato técnico não pode responder a essas questões institucionais.
MorphIT recebeu o IRTF Applied Networking Research Prize de 2020, reconhecendo a relevância prática dessa linha de trabalho. O prêmio pertence à pesquisa coautoral e não deve ser convertido em prova de implantação ou crédito pessoal exclusivo.
Recibos de pacotes poderiam mudar disputas entre operadores e clientes ao criar um objeto de evidência compartilhado. Também poderiam criar uma nova camada de vigilância se implantados sem minimização. A contribuição de Argyraki é expor o trade, não afirmar que a criptografia sozinha produz responsabilização.
Inferência de neutralidade busca evidências onde o operador controla a narrativa interna
Usuários e reguladores frequentemente querem saber se uma rede trata o tráfego de forma diferente. O operador controla roteadores, políticas e telemetria interna. Um observador externo vê latência, perda e vazão afetadas por muitas causas: congestionamento, roteamento, servidores, condições de rádio, posicionamento de conteúdo e política intencional.
Argyraki e colaboradores desenvolveram métodos para inferência de neutralidade de rede e para localizar diferenciação de tráfego. O objetivo era projetar medições que pudessem identificar diferenças consistentes de tratamento e estreitar onde elas ocorriam, em vez de depender de um único teste de velocidade ou de uma explicação do operador.
Inferência não é observação direta de política. Evidências estatísticas podem mostrar que duas classes de tráfego se comportam de forma diferente sob condições controladas. Podem identificar um segmento consistente com a diferença. Não podem estabelecer automaticamente motivo, discriminação legal ou a linha exata de configuração responsável.
O desenho experimental é, portanto, decisivo. O tráfego deve ser comparável. As medições precisam de pontos de observação e períodos suficientes para separar congestionamento transitório de tratamento persistente. Caminhos compartilhados criam observações correlacionadas. Diferenças de servidor e conteúdo precisam ser controladas ou modeladas.
O trabalho se cruza com a regulação, mas não fornece padrões legais. Um regulador deve decidir que tratamento diferencial é proibido, qual ônus da prova se aplica e quais remédios são proporcionais. Evidências técnicas podem informar a decisão e expor alegações fracas; não podem definir justiça sozinhas.
A falsa certeza é um risco nas duas direções. Um operador pode descartar evidências externas por falta de visibilidade interna. Um crítico pode tratar toda diferença de desempenho como throttling intencional. O uso responsável da inferência declara as explicações alternativas e a confiança com que podem ser rejeitadas.
Essa linha de pesquisa estende a pilha de responsabilização além do software que o analista pode verificar. Onde código-fonte, contratos e recibos não estão disponíveis, uma medição cuidadosamente projetada ainda pode criar evidências. Seus pontos cegos diferem da prova formal, razão pela qual os métodos podem se apoiar mutuamente em vez de competir por um único rótulo universal.
Tero transforma gravações públicas de jogos em um sensor distribuído de latência
Um trabalho recente associado ao laboratório de Argyraki usa gravações públicas de jogos para inferir latência de rede. Jogos online frequentemente exibem ou codificam informações de latência visíveis em streams ou vídeos gravados. Tero extrai observações desse conteúdo público para construir evidências quase em tempo real sem implantar uma sonda dedicada em cada residência.
O método é inventivo porque reutiliza uma superfície de medição existente. Jogadores estão distribuídos geograficamente, são sensíveis à latência e frequentemente expõem métricas durante o jogo comum. Gravações públicas podem fornecer observações de lugares onde a cobertura de sondas de pesquisa é limitada.
A amostra não é representativa de todos os usuários da internet. Ela é enviesada para jogos, plataformas, streamers e regiões onde gravações são publicadas. A métrica exibida pode refletir a latência do servidor do jogo, e não um caminho completo para outros serviços. Dispositivos e overlays podem afetar a interpretação.
A extração também depende de consistência visual ou de plataforma. Mudanças de interface, overlays ocultos e compressão de vídeo podem reduzir a precisão. Uma observação pública precisa de contexto de tempo e local para se tornar útil. O método pode gerar um sinal rico sem se tornar um censo global.
Seu valor é complementar. Sistemas dedicados como RIPE Atlas fornecem sondas controladas com software e agendamento conhecidos. Gravações de jogos fornecem observações oportunistas ligadas à experiência real do usuário. Combiná-las pode revelar onde a infraestrutura controlada e o desempenho vivido discordam.
O projeto ilustra a abordagem mais ampla de Argyraki à evidência externa. Quando a rede não fornece telemetria interna, procure artefatos observáveis que restrinjam a explicação possível. O resultado deve ser usado com a humildade apropriada à sua amostra.
Tero também levanta questões de privacidade e consentimento. Conteúdo público está disponível para observação, mas a extração em grande escala pode criar conjuntos de dados que o publicador original não previu. Pesquisadores e operadores precisam de políticas para retenção, agregação e identificação. Métodos de responsabilização não devem recriar o problema de privacidade que pretendem resolver.
O trabalho é melhor entendido como um novo instrumento de medição. Sua importância estratégica dependerá da validação contra caminhos conhecidos, da transparência sobre o viés e de operadores ou formuladores de políticas conseguirem usar o sinal para investigar condições específicas de rede.
Cache de borda complica a ideia de que a diferenciação acontece dentro da rede de acesso
O melhor artigo de estudante da SIGCOMM 2025 sobre cache de borda como diferenciação faz uma pergunta difícil sobre neutralidade. Os usuários podem receber desempenho diferente não porque um provedor de acesso fez throttling de pacotes, mas porque conteúdo popular foi colocado nas proximidades enquanto conteúdo menos popular ou menos conectado permaneceu distante.
Cache é eficiente econômica e tecnicamente. Servir objetos populares da borda reduz tráfego de backbone e latência. Tratar toda vantagem resultante como discriminação indevida minaria um mecanismo básico de entrega de conteúdo. Ignorar o posicionamento inteiramente também pode esconder diferenças estruturais em quem recebe bom desempenho.
A evidência relevante precisa distinguir tratamento de pacotes de arquitetura de conteúdo. Dois fluxos podem receber política de encaminhamento idêntica e ainda experimentar atraso diferente porque um termina em um cache local. Um teste de velocidade focado no link de acesso não explicará a diferença. Uma política focada apenas em throttling pode perder como relações comerciais e popularidade moldam o posicionamento.
A intenção continua difícil de inferir. Um cache pode ser posicionado de acordo com demanda e custo, não com o desejo de prejudicar um concorrente. Um provedor de conteúdo menor pode não ter volume de tráfego ou recursos de integração necessários para implantação na borda. O usuário experimenta diferenciação mesmo quando nenhuma regra de pacote a cria explicitamente.
Isso reformula a responsabilização. A questão passa a ser qual camada produziu o resultado e se o mecanismo é transparente e contestável. Operadores, redes de conteúdo e reguladores podem precisar de evidências sobre alcance de cache, taxas de hit, critérios de posicionamento e interconexão, em vez de apenas comportamento de filas.
O prêmio do artigo foi especificamente um Best Student Paper e envolveu uma equipe. O reconhecimento deve preservar a autoria dos estudantes e o resultado de pesquisa limitado. Não estabelece uma medição universal de discriminação por cache na internet.
Para o programa de pesquisa de Argyraki, o cache de borda conecta o trabalho inicial de desempenho com a transparência externa. Uma rede pode se comportar corretamente segundo seu código de encaminhamento e ainda produzir serviço desigual por meio da arquitetura. A responsabilização deve, portanto, incluir onde conteúdo e computação são posicionados, não apenas o que roteadores fazem com pacotes.
A implicação política não é uma regra simples. Infraestrutura eficiente depende de cache. Alegações de justiça precisam identificar quando o posicionamento reflete demanda comum, quando o acesso não está disponível em termos razoáveis e qual parte controla a decisão relevante. A medição pode esclarecer a estrutura; a governança deve definir o remédio.
Reconhecimento acadêmico não substitui evidência de implantação
O histórico de Argyraki inclui o melhor artigo da SOSP 2009 por RouteBricks, o melhor artigo da NSDI 2014 por Software Dataplane Verification, o Jochen Liedtke Young Researcher Award da EuroSys 2016, o IRTF Applied Networking Research Prize de 2020 por MorphIT e o melhor artigo de estudante da SIGCOMM 2025 associado ao trabalho de cache de borda. Esses prêmios estabelecem reconhecimento entre pares e a importância de contribuições de pesquisa específicas. Eles não provam que os sistemas estejam amplamente implantados, tenham suporte comercial ou sejam mantidos anos após a publicação.
Um artefato de artigo pode ser influente e difícil de construir no hardware atual.
Essa distinção é especialmente importante para verificação. Um protótipo bem-sucedido pode demonstrar que uma classe de função de rede pode ser provada. Um operador precisa de suporte para seus binários, drivers e processo de lançamento. Repositórios públicos mostram disponibilidade, não um compromisso de nível de serviço.
A atribuição de equipe é outro controle editorial. Perfis de professores frequentemente comprimem o trabalho no nome do líder do laboratório. Estudantes e colaboradores podem ter projetado mecanismos importantes e escrito o código. O próprio registro de prêmios atuais sinaliza essa questão por meio da categoria Best Student Paper.
O papel de Argyraki é substancial sem apagar essas contribuições. Ela liderou uma agenda de laboratório que conecta desempenho, prova e responsabilização em muitos projetos. Orientar, enquadrar e sustentar o programa são formas de autoria e liderança distintas de implementar cada sistema.
A ausência de um censo público de implantação comercial deve moldar as afirmações. Seria razoável dizer que o trabalho influenciou a pesquisa e criou métodos que poderiam alterar aquisição ou regulação. Seria irresponsável afirmar que Vigor, Klint ou recibos de pacotes são prática padrão de produção sem evidência de operadores.
A pesquisa acadêmica pode criar valor antes da adoção do produto. Ela muda quais perguntas podem ser feitas a fornecedores e operadores. Um comprador pode solicitar um contrato de binário. Um regulador pode exigir uma metodologia de inferência. Um desenvolvedor pode tratar desempenho como uma interface. Essas mudanças conceituais fazem parte da infraestrutura mesmo quando as ferramentas permanecem experimentais.
A pilha de responsabilização funciona porque suas camadas falham de maneiras diferentes
Verificação funcional pode provar propriedades selecionadas sob um modelo. Pode perder erros de hardware e especificação. Interfaces de desempenho podem identificar regiões onde uma função desacelera. Podem não sobreviver a uma mudança de hardware. Recibos de pacotes podem preservar evidências de eventos selecionados. Podem perder o pacote disputado ou criar risco de privacidade. Medições externas podem revelar resultados diferenciais. Podem não identificar intenção.
Os métodos se tornam mais fortes quando combinados. Uma função de rede verificada pode produzir recibos cujo formato e processamento também são especificados. Uma interface de desempenho pode identificar quando uma mudança de software altera a temporização mesmo que a prova funcional ainda passe. Medições externas podem revelar que uma implantação supostamente correta se comporta de forma diferente do modelo.
A composição também cria um problema de governança. Partes diferentes podem controlar cada camada. Um fornecedor fornece o binário e o contrato. Um operador executa o verificador. Uma plataforma fornece hardware. Um terceiro armazena recibos. Pesquisadores ou reguladores conduzem medições externas. A responsabilização depende do acesso à evidência e do acordo sobre sua interpretação.
Nenhum indicador verde deve se tornar um selo universal de confiança. “Verificado” pode esconder uma propriedade estreita. “Dentro da interface de desempenho” pode ignorar o impacto no nível de serviço. “Recibo presente” pode omitir a completude da captura. “Diferenciação detectada” pode ser relatada como intenção. A força da pilha está em preservar essas distinções.
Essa abordagem é mais exigente que um rótulo de certificação, mas é mais adequada a redes programáveis. Código, hardware e políticas mudam. As evidências precisam ser versionadas com o artefato e o ambiente. Uma garantia que não pode ser atualizada ficará obsoleta enquanto mantém autoridade.
A pesquisa de Argyraki passou de sistemas que o operador controla para redes observadas de fora. A trajetória é coerente porque ambos os cenários envolvem confiança assimétrica. Em um, o fornecedor diz que seu código está correto. No outro, o operador diz que sua rede é neutra ou tem bom desempenho. A pesquisa pergunta que evidência pode tornar a afirmação testável.
O desafio não resolvido é a adoção institucional. Ferramentas exigem donos, padrões e incentivos. Fornecedores podem resistir a contratos que exponham o comportamento. Operadores podem não querer reter recibos. Reguladores podem preferir métricas simples. O sucesso acadêmico não garante que a evidência será coletada quando ocorrer uma disputa.
A contribuição duradoura do programa pode ser mudar a pergunta padrão de “Confiamos neste sistema?” para “Qual afirmação, sob quais suposições, esta evidência pode sustentar?” Essa é uma pergunta mais limitada e uma base mais útil para decisões de infraestrutura.
A verificação muda a aquisição apenas quando a afirmação se torna um contrato
Um operador de rede que compra um appliance de software ou uma função de rede virtual normalmente recebe uma lista de recursos, números de desempenho e termos de suporte. Um modelo de aquisição orientado a verificação faria um conjunto diferente de perguntas. Qual propriedade é alegada? Qual binário e configuração foram verificados? Que ambiente foi modelado? Quais componentes permanecem confiáveis? O que acontece quando o fornecedor atualiza o código?
O trabalho de Argyraki sobre verificação em nível de código-fonte e de binário torna essas perguntas práticas. Klint é especialmente relevante porque mira binários em vez de exigir divulgação de código-fonte. Um operador poderia, em princípio, pedir a um fornecedor que fornecesse um binário, um contrato funcional e evidências de que o artefato o satisfaz. Isso muda a discussão de confiança de “revisamos nosso código” para uma afirmação limitada sobre o arquivo que o cliente executará.
O contrato ainda precisa ser escrito. Um firewall pode ser seguro quanto à memória e sem crashes enquanto aplica a política errada. Um NAT pode preservar invariantes de mapeamento sob o modelo e falhar quando um driver se comporta de forma diferente. Um balanceador de carga pode distribuir fluxos corretamente e perder um requisito de desempenho. A verificação deve, portanto, estar ligada ao objetivo de serviço do operador, e não à propriedade que a ferramenta consegue provar mais facilmente.
Atualizações criam a fronteira comercial mais difícil. Evidências para um lançamento não cobrem automaticamente um lançamento posterior. Uma mudança de compilador, atualização de biblioteca ou flag de build diferente pode alterar o binário. Fornecedores e clientes precisam de uma regra sobre quando a reverificação é necessária e com que rapidez ela pode ser concluída. Builds reproduzíveis e artefatos assinados podem conectar a prova ao pacote implantado.
Interfaces de desempenho como PIX poderiam complementar o contrato funcional. Em vez de aceitar um máximo de vazão, um comprador poderia exigir uma descrição de como a latência ou a vazão muda com o tamanho dos pacotes, a ocupação do estado, o comportamento de cache e os recursos selecionados. A interface precisaria ser regenerada para o hardware e a versão de software alvo. Seu valor está em revelar sensibilidade, não em prometer que toda implantação corresponderá a um laboratório.
A base de computação confiável deve aparecer na linguagem de aquisição. Se uma prova assume um framework, driver, modelo de NIC e comportamento de CPU, essas suposições pertencem à matriz de suporte. Um fornecedor não deveria vender “verificação de pilha completa” enquanto deixa o cliente descobrir que um caminho proprietário de offload foi excluído.
Esse modelo não exige que toda função de rede seja formalmente verificada. Ele cria níveis de evidência. Uma função de alto raio de explosão que lida com tráfego não confiável pode justificar prova mais forte e verificações de binário. Uma ferramenta interna de baixo risco pode depender de testes. A decisão pode refletir o custo da falha e a frequência de mudanças.
O efeito estratégico seria tornar a garantia portátil entre organizações. Hoje, muito conhecimento de verificação permanece com uma equipe de pesquisa ou um fornecedor especializado. Um contrato que nomeia propriedades, versões e componentes confiáveis dá aos operadores algo que podem auditar depois que funcionários e fornecedores mudam. Sem esse invólucro operacional, mesmo uma prova forte permanece uma publicação, e não governança de infraestrutura.
Evidência de pacotes precisa de custódia, limites de privacidade e uma declaração honesta de completude
Recibos de pacotes e amostragem retroativa buscam preservar evidências sem armazenar todos os pacotes. Seu valor prático dependerá de como a evidência é coletada e governada depois que o mecanismo criptográfico faz seu trabalho.
Um recibo pode mostrar que um ponto de medição se comprometeu com informações selecionadas de pacotes. Ele não pode provar que o sensor viu todos os pacotes, que foi colocado na fronteira alegada ou que seu relógio e chaves eram confiáveis. Um auditor precisa de identidade do dispositivo, versão do software, histórico de chaves e um relato das condições de captura. Caso contrário, um recibo íntegro pode autenticar uma observação incompleta.
Cadeia de custódia importa durante disputas. Recibos devem ter carimbo de tempo, ser retidos sob uma política documentada e protegidos contra alteração ou exclusão seletiva. O acesso deve ser registrado porque mesmo evidência compactada ou que preserva privacidade pode revelar relações de comunicação. A parte que opera a rede não deve ser a única capaz de interpretar o registro quando o registro se destina a apoiar a responsabilização externa.
Restrições de privacidade não são secundárias. A captura completa de pacotes pode expor conteúdo e identificadores muito além da questão operacional. Amostragem e compromissos criptográficos podem reduzir a retenção, mas os parâmetros determinam o que permanece vinculável. Um projeto deve especificar quem pode consultar a evidência, sob que autoridade e se consultas repetidas podem reconstruir atividade que um único recibo pretendia ocultar.
A completude deve ser relatada como uma propriedade, não implícita. Se o sistema amostra eventos probabilisticamente, o resultado pode apoiar declarações sobre probabilidade e padrões observados. Não deve ser apresentado como prova de que um evento não observado não aconteceu. A seleção retroativa é valiosa porque investigadores podem não saber antecipadamente quais pacotes são relevantes, mas permanece limitada pelo que foi comprometido e retido.
Esses requisitos de governança conectam o trabalho de Argyraki sobre responsabilização de pacotes com sua pesquisa de inferência externa. Ambos criam evidências sobre sistemas que o observador não controla completamente. Sua credibilidade depende de explicar o ponto de observação e as causas alternativas. Uma medição de neutralidade pode identificar diferenciação persistente sem provar motivo. Um recibo pode estabelecer evidência de processamento selecionado sem provar o caminho interno completo.
A contribuição prática é, portanto, um vocabulário mais forte para disputas. Operadores, usuários e reguladores podem perguntar o que foi medido, onde, com quais garantias e o que permanece desconhecido. Isso é mais defensável do que tratar os logs internos do operador ou uma sonda externa como a verdade completa.
Um contraexemplo é mais valioso quando muda a regra operacional
Ferramentas de verificação frequentemente produzem um pacote, estado ou caminho de execução que viola uma propriedade alegada. O artefato pode encurtar a depuração, mas seu valor maior é institucional. Ele revela se a especificação, a implementação ou a suposição de implantação estava errada.
Equipes devem preservar contraexemplos como casos de regressão e vinculá-los ao contrato corrigido. Se a propriedade estava incompleta, a especificação muda. Se o código estava errado, o binário e os testes de código-fonte mudam. Se o ambiente violou uma suposição, a matriz de suporte ou o monitor de runtime muda. Fechar apenas o bug imediato perde a evidência.
Essa prática conecta o trabalho de verificação de Argyraki com interfaces de desempenho e responsabilização de pacotes. Um contraexemplo funcional, uma regressão de desempenho e uma medição externa são formas diferentes de desacordo entre afirmação e comportamento. Cada um se torna conhecimento durável de infraestrutura apenas quando alguém é dono da regra resultante e a verifica após mudanças posteriores.
A prova se torna operacional apenas quando alguém é dono das suposições
O trabalho de Argyraki não oferece uma máquina que possa certificar uma rede uma vez e remover a incerteza. Ele oferece métodos para tornar incertezas específicas visíveis. Essa distinção determina se a pesquisa se torna prática responsável ou linguagem de marketing.
Um operador que usa verificação precisa de um dono para a especificação. A equipe que extrai uma interface de desempenho precisa reexecutá-la quando o hardware muda. Um sistema de recibos precisa de regras de retenção e acesso. Um programa de medição externa precisa de amostragem e validação. Cada suposição deve pertencer a alguém que possa atualizá-la ou desafiá-la.
A oportunidade de infraestrutura é significativa. Binários proprietários poderiam ser comprados com contratos verificáveis. Funções de rede de alto desempenho poderiam carregar propriedades formais de segurança. Regressões de desempenho poderiam ser detectadas antes da implantação. Usuários poderiam obter evidências sobre o tratamento de pacotes sem exigir acesso interno completo.
Os riscos são igualmente concretos. Um verificador pode se tornar um novo monopólio de confiança. Recibos podem criar vigilância. Modelos de desempenho podem ficar obsoletos. Inferências podem ser superinterpretadas em disputas de política. Um rótulo formal pode dar a um sistema inseguro mais credibilidade do que um sistema abertamente não verificado.
A resposta correta não é rejeitar a garantia porque ela é limitada. Operações de rede comuns já dependem de evidências limitadas — testes, contadores, logs e alegações de fornecedores. O programa de Argyraki melhora a precisão desses limites e dá a diferentes partes maneiras de desafiá-los.
Seu trabalho atual na EPFL conecta o caminho dos pacotes a uma questão maior de transparência da internet. Encaminhamento rápido, prova formal, comportamento de cache e latência de jogos podem parecer tópicos separados. São locais diferentes onde se pede ao usuário que confie em um sistema que não pode inspecionar completamente.
Uma rede não pode provar tudo o que fez com cada pacote sem custo e intrusão de privacidade inaceitáveis. Ela pode, muitas vezes, produzir evidências melhores do que produz hoje. O valor da pesquisa de Argyraki está em definir o trade: o que pode ser provado, o que pode ser medido, o que pode ser retido e o que deve permanecer uma inferência.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance