
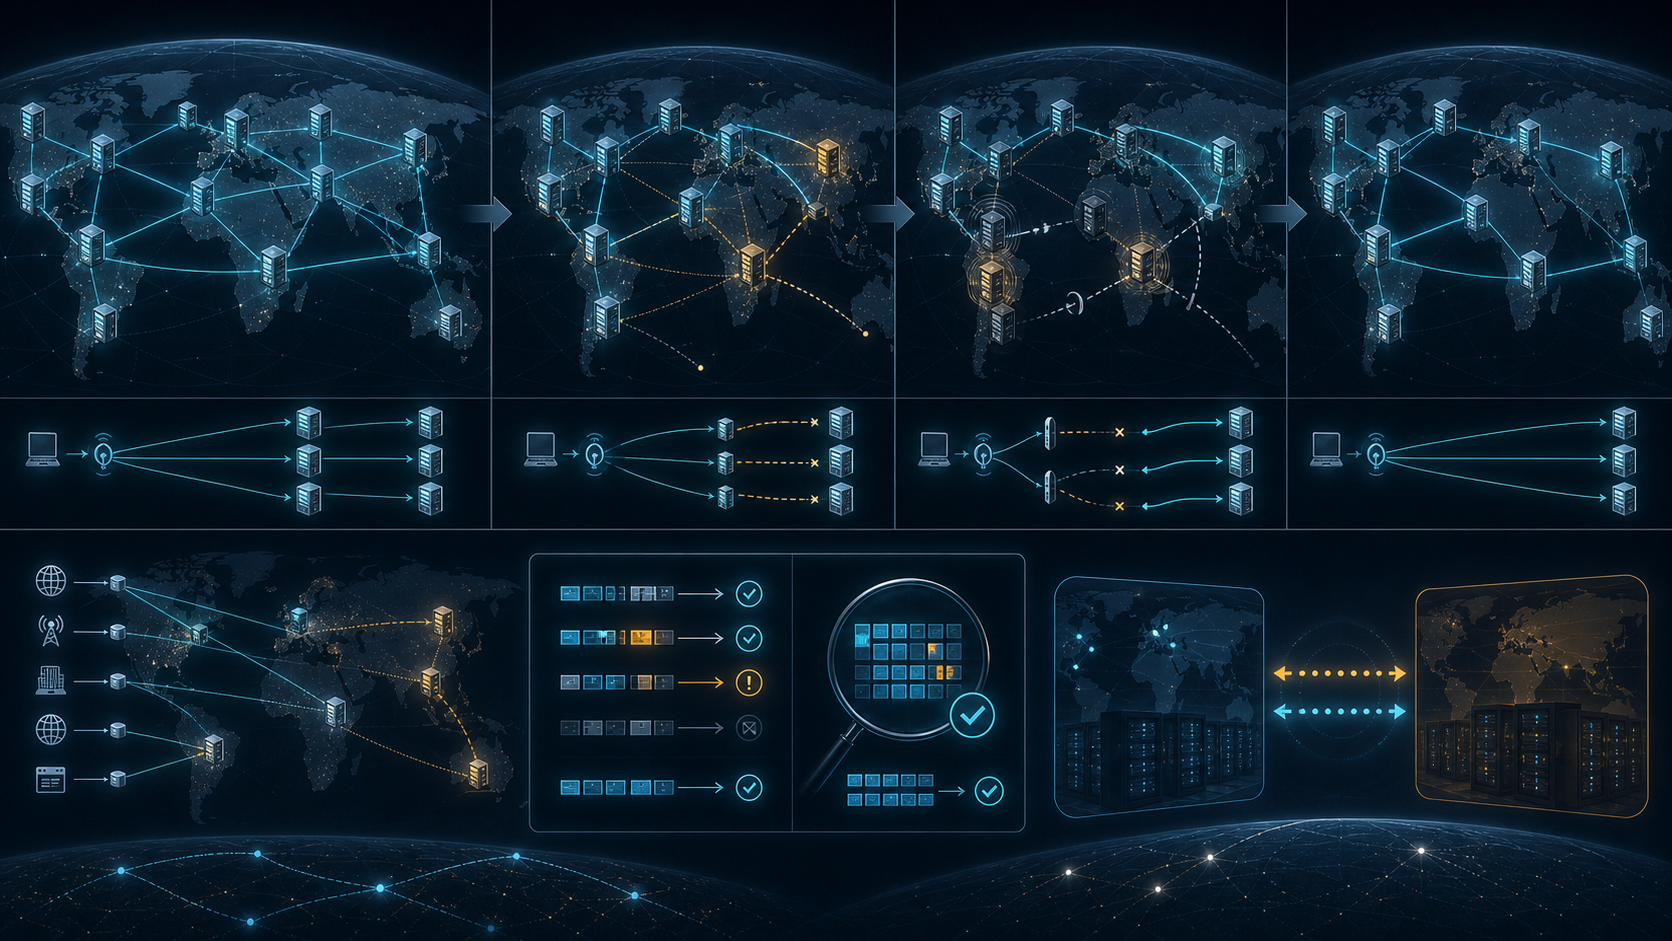
Resumo
- Um bug introduzido durante uma liberação gradual de software da Cloudflare fez alguns nós do F-Root operados em parceria omitirem registros de glue necessários, causando falhas esporádicas de resolução sob
.net. - A Internet Systems Consortium registrou conhecimento do problema às 17h33 UTC, reconhecimento às 17h41, verificação e escalonamento às 17h46 e restauração completa às 20h51: um intervalo de 3 horas e 18 minutos.
- A recuperação combinou correção de software, retirada BGP dos prefixos afetados e posterior reanúncio. Essas etapas estavam sob controles operacionais distribuídos entre Cloudflare e ISC.
- O relato pós-incidente documentou um acordo para testar regularmente a retirada BGP, mas o material público examinado não estabelece a execução posterior, a frequência, os critérios de sucesso ou uma verificação independente desses exercícios específicos.
- A ausência de confirmação pública não prova que nenhum teste ocorreu. Ela limita o que terceiros podem considerar demonstrado sobre a durabilidade da mitigação.
O mecanismo da omissão de glue
Uma infraestrutura distribuída pode continuar respondendo em muitos lugares e, ainda assim, falhar em uma propriedade essencial do serviço. Foi esse o caráter do incidente do F-Root de 23 de janeiro de 2020. O problema não consistiu na perda uniforme de toda a capacidade. Alguns nós continuavam acessíveis, mas suas respostas omitiam dados necessários para que determinadas resoluções DNS prosseguissem corretamente.
Segundo o relato técnico publicado pela Internet Systems Consortium, um bug introduzido durante uma liberação gradual de software da Cloudflare fez com que determinados nós do F-Root operados no âmbito da parceria omitissem registros de glue necessários. O efeito documentado foram falhas esporádicas na resolução de nomes sob .net.
Registros de glue ajudam o resolvedor a alcançar os servidores de nomes indicados por uma delegação. Em uma situação na qual o endereço do servidor precisa acompanhar a delegação para evitar uma dependência circular, a ausência desse dado pode impedir que a consulta avance pelo caminho esperado. Um servidor pode, portanto, aceitar pacotes, executar o processo DNS e enviar uma resposta, mas ainda assim deixar de fornecer um elemento necessário para a resolução correta.
Essa distinção explica por que disponibilidade e correção não são sinônimos. Uma verificação que mede apenas latência, uso de recursos, alcance da rede ou existência de resposta pode considerar o nó saudável. Para o usuário, entretanto, uma resposta incompleta pode produzir a mesma consequência prática de uma indisponibilidade: o nome procurado não é resolvido.
O caráter esporádico também importa. Em uma arquitetura anycast, consultas destinadas ao mesmo endereço podem alcançar instâncias diferentes conforme a localização e as decisões de roteamento. Se somente parte dos nós executa o comportamento defeituoso, um resolvedor pode receber uma resposta correta em uma tentativa e uma resposta incompleta em outra. O problema pode variar entre redes, regiões e momentos sem que toda a infraestrutura desapareça de uma só vez.
O material público examinado não quantifica o número total de usuários, redes, resolvedores ou consultas atingidos. Não há base, portanto, para converter o incidente em uma estimativa global de impacto. O que a fonte estabelece é o mecanismo: alguns nós omitiram glue necessário, e essa omissão produziu falhas esporádicas de resolução de .net.
Uma liberação gradual deveria limitar o raio inicial de um defeito. Mas esse benefício depende da capacidade de comparar os grupos que receberam e não receberam a mudança. Se a observação procura somente falhas totais, um erro semântico pode atravessar a fase gradual sem produzir os alarmes usados para decidir se a liberação deve continuar.
O controle relevante é mais exigente: consultas representativas devem ser executadas de vários pontos, e as respostas devem ser avaliadas por sua conformidade com propriedades essenciais do protocolo. A pergunta não é apenas se o nó respondeu. É se devolveu todos os elementos que a classe de consulta exige.
Quem controlava a liberação, a detecção e a retirada
A cadeia operacional estava dividida. O registro de ISC sobre o incidente atribui à Cloudflare o controle da liberação que introduziu o defeito e da correção do software. A ISC recebeu a informação, verificou o comportamento, escalou o incidente e solicitou a retirada dos prefixos afetados.
A distinção é necessária para evitar atribuições excessivas. O registro não sustenta a conclusão de que a ISC controlava diretamente a versão de software da Cloudflare. Tampouco sustenta tratar a Cloudflare como autora de todas as etapas institucionais da resposta. As organizações possuíam capacidades diferentes dentro do mesmo caminho de restauração.
A entrada da Internet Systems Consortium no diretório da BTW identifica a entidade vinculada ao artigo. Para compreender o caso, porém, o aspecto decisivo não é apenas a identidade formal dos participantes. É o mapa prático de autoridade: quem podia interromper a liberação, quem conseguia reproduzir a falha, quem tinha condições de alterar o software e quem podia pedir ou executar o isolamento por roteamento.
O primeiro marco público da cronologia decorreu do aviso de um grande operador de rede. Isso torna a observação externa parte material do caso. O fato não autoriza dizer que todos os controles internos eram ausentes ou inadequados; a fonte examinada não oferece uma avaliação completa de toda a telemetria. A conclusão delimitada é que o alerta que iniciou a sequência publicada veio de fora e precisou ser verificado pela ISC.
Para serviços críticos, relatórios externos não deveriam depender de improvisação. É preciso haver um caminho que permita registrar a consulta problemática, reproduzi-la de vários pontos, comparar respostas entre instâncias, identificar a versão executada por cada grupo e alcançar rapidamente a parte que controla a mudança.
A retirada BGP acrescenta outra divisão de responsabilidade. Em uma implantação anycast, diferentes localidades podem anunciar o mesmo prefixo. Retirar o anúncio associado a nós defeituosos pode impedir que novos fluxos sejam encaminhados até eles, deslocando o tráfego para instâncias que continuam anunciadas. Essa é uma medida de contenção, não a correção da causa.
O procedimento exige decisões anteriores à crise. Quem possui autoridade para declarar que uma resposta semanticamente incorreta justifica a retirada? Quem executa a mudança? Como se confirma, a partir de pontos externos, que os anúncios deixaram de ser vistos? Qual capacidade permanece depois do isolamento? Que teste autoriza o reanúncio?
Se essas respostas estiverem distribuídas entre organizações, a interface institucional se torna parte do sistema técnico. Contatos, escalonamento, permissões e critérios de ação precisam ser tratados como controles operacionais, e não como detalhes administrativos.
A sequência de restauração de 3 horas e 18 minutos
A cronologia publicada pela ISC registra quatro momentos. Às 17h33 UTC, a organização teve conhecimento do problema. Às 17h41, reconheceu o relato. Às 17h46, havia verificado o comportamento e escalado o incidente. Às 20h51, o serviço estava plenamente restaurado.
Do primeiro registro de conhecimento até a restauração completa decorreram 3 horas e 18 minutos. Entre 17h33 e a verificação e o escalonamento às 17h46 passaram-se 13 minutos. Esses números são marcos documentados, mas não devem ser transformados em uma divisão precisa do trabalho realizado em cada etapa. A fonte não atribui todos os minutos do intervalo a diagnóstico, decisão, correção, retirada, propagação ou reanúncio.
A sequência mostra, contudo, que a resposta inicial e a recuperação completa são medidas diferentes. Verificar a falha e encaminhá-la à organização que controlava o software ocorreu relativamente cedo. Restaurar todo o serviço exigiu uma cadeia mais longa de ação coordenada.
A recuperação combinou correção de código, retirada dos anúncios BGP dos prefixos afetados e reanúncio posterior. Cada ação cumpria uma função distinta. A correção tratava a causa imediata. A retirada reduzia a exposição a nós ainda capazes de fornecer respostas defeituosas. O reanúncio devolvia capacidade depois que a correção pudesse ser considerada segura.
A ordem e os critérios importam. Corrigir o software sem isolar rapidamente os nós afetados pode permitir que usuários continuem alcançando respostas incorretas durante a implantação do reparo. Retirar rotas sem avaliar a capacidade restante pode transferir carga excessiva para outras instâncias. Reanunciar antes da validação pode recolocar o defeito em serviço. Adiar demais o reanúncio pode prolongar uma redução desnecessária de capacidade ou diversidade.
Uma boa análise de restauração deve, por isso, separar cinco relógios: tempo para detectar, tempo para confirmar, tempo para obter autoridade, tempo para executar e observar o isolamento e tempo para corrigir e reintroduzir a capacidade. O total de 3 horas e 18 minutos fornece uma referência histórica, mas não revela sozinho o desempenho de cada controle.
Também não representa necessariamente a experiência uniforme de todos os usuários. Como o defeito era esporádico e afetava parte da superfície distribuída, diferentes resolvedores podem ter encontrado resultados diferentes. A fonte não fornece uma distribuição temporal ou geográfica suficiente para quantificar essas experiências.
O uso responsável da cronologia é mais limitado. Ela demonstra quando a ISC registrou conhecimento, reconhecimento, verificação, escalonamento e restauração. Também permite identificar que o caminho de recuperação atravessou fronteiras entre software, validação institucional e roteamento.
Por que a redundância não eliminou o risco de coordenação
A distribuição global e o anycast oferecem defesas reais. Eles reduzem a dependência de uma única localização, distribuem carga e podem permitir que o tráfego seja atendido por instâncias não afetadas. O incidente não demonstra que esses mecanismos sejam inúteis. Demonstra que eles não respondem sozinhos a todos os tipos de falha.
Há uma diferença entre independência física e independência lógica. Servidores em diferentes locais podem executar a mesma versão defeituosa. Uma causa comum de software pode atravessar fronteiras geográficas sem derrubar a conectividade. O número de nós permanece alto, mas a diversidade efetiva de comportamento diminui.
Uma implantação gradual procura limitar esse risco ao liberar a mudança para um subconjunto antes de ampliar sua distribuição. Para funcionar como controle, ela precisa de um sinal capaz de detectar a classe de defeito introduzida. Se o critério de avanço mede somente disponibilidade, um nó que responde rapidamente com conteúdo incompleto pode parecer apto a receber mais tráfego ou servir como modelo para a próxima fase.
A redundância também não define quem pode isolar uma instância problemática. Essa autoridade pode depender do operador do serviço, do parceiro que controla o software, da equipe que anuncia o prefixo ou de uma combinação entre eles. Quando o relato chega a uma organização e a correção depende de outra, o tempo de recuperação inclui comunicação, confirmação e autorização.
Não há base na evidência examinada para afirmar que a parceria não possuía capacidade de resposta. O serviço foi restaurado, e a fonte documenta as principais etapas. A conclusão mais precisa é que a capacidade existia, mas sua execução dependia de controles distribuídos.
Esse ponto transforma coordenação em uma propriedade mensurável. Não basta que cada organização mantenha seu próprio procedimento. Um exercício realista deve atravessar toda a cadeia: detecção externa, reprodução da consulta, identificação da versão, decisão de contenção, retirada, observação da propagação, correção, validação e reanúncio.
Se apenas uma parte é testada, o resultado pode criar confiança indevida. Uma equipe pode demonstrar que sabe emitir um comando de retirada sem provar que a autoridade necessária será obtida a tempo. Outra pode provar que corrige o código rapidamente sem verificar quanto tempo os nós defeituosos permanecem alcançáveis. Uma terceira pode testar o reanúncio sem reproduzir as condições de validação que deveriam precedê-lo.
A arquitetura deve, portanto, incluir as relações entre organizações em seu modelo de ameaça e continuidade. Um contato desatualizado, uma permissão ambígua ou um critério de isolamento não aprovado pode atrasar a recuperação tanto quanto um obstáculo técnico.
O que o compromisso de testar prova — e o que não prova
Depois do incidente, a ISC registrou um acordo com a Cloudflare para testar regularmente a função de retirada BGP. Esse compromisso tem valor probatório limitado, mas real. Ele mostra que as partes reconheceram a retirada como uma dependência do caminho de recuperação e identificaram a necessidade de exercitá-la.
O acordo, entretanto, não é equivalente à execução. O material público examinado não estabelece datas posteriores dos exercícios relacionados a esse compromisso, sua frequência, os participantes, os critérios de sucesso, os tempos observados, as falhas encontradas ou a conclusão de ações corretivas.
Também não apresenta uma verificação independente dos resultados. A independência pode assumir várias formas: revisão por uma equipe separada da execução, auditoria contratual, observação por uma função de continuidade ou atestação que confirme escopo, data, critérios e resultado sem divulgar detalhes exploráveis.
A ausência dessas informações no registro examinado não prova que nenhum teste tenha ocorrido. Pode haver exercícios internos, documentação não publicada ou material fora do conjunto analisado. A conclusão responsável é somente que a execução posterior e seu desempenho não estão demonstrados pela evidência pública usada neste artigo.
Essa diferença entre ausência de evidência e evidência de ausência protege a precisão. Não seria justificável acusar as organizações de não testar sem uma fonte que sustente a afirmação. Também não seria justificável apresentar a intenção documentada como prova de prontidão contínua.
Para transformar o compromisso em garantia verificável, seria necessário responder a perguntas específicas. Quando ocorreu o teste mais recente? Que prefixos ou ambiente representativo foram usados? Quanto tempo decorreu entre a decisão e o desaparecimento observável dos anúncios? De quantos pontos externos a retirada foi confirmada? Qual capacidade permaneceu? Que condições autorizaram o reanúncio? Alguma deficiência gerou correção com responsável e prazo?
Uma organização pode manter os detalhes técnicos sob acesso restrito e ainda oferecer evidência suficiente para supervisão. A proteção de topologia, comandos e contatos não exige que o resultado seja reduzido a uma promessa genérica. Um conselho, regulador, cliente crítico ou auditor pode receber uma atestação controlada que confirme se o procedimento foi exercitado e se cumpriu critérios previamente definidos.
A durabilidade não é demonstrada por um único êxito histórico. O uso bem-sucedido da retirada em 2020 prova que o caminho pôde ser acionado naquele incidente. Mudanças de pessoas, ferramentas, contratos, topologia, capacidade e permissões podem alterar o desempenho posterior. Por isso, a prontidão precisa ser renovada por testes repetidos.
Um teste limitado de durabilidade para operadores e conselhos
O caso permite formular uma avaliação prática sem presumir falhas não documentadas. O objetivo não é reconstruir todos os controles internos de ISC ou Cloudflare, mas identificar a evidência necessária para demonstrar que um caminho semelhante continua funcional.
1. Mapear a autoridade real
Cada etapa deve ter um proprietário identificado. O mapa precisa distinguir quem autoriza uma liberação, quem pode interrompê-la, quem verifica a correção das respostas, quem declara a necessidade de isolamento, quem solicita a retirada, quem a executa e quem autoriza o reanúncio.
Substitutos e cobertura fora do horário normal devem constar do mesmo mapa. Uma autoridade existente apenas em organogramas ou contratos, mas indisponível durante a janela do incidente, não oferece a mesma proteção que uma função operacionalmente alcançável.
2. Testar a semântica das respostas
Os monitores devem verificar mais do que a existência de uma resposta. Para DNS, isso significa executar consultas representativas e avaliar se delegações, registros necessários e códigos de resposta mantêm as propriedades esperadas.
A observação deve combinar pontos internos e externos. A telemetria interna ajuda a vincular comportamento a versões e instâncias. As sondas externas revelam o que resolvedores em redes distintas realmente recebem depois das decisões de anycast e roteamento.
3. Tornar a liberação gradual interrompível
Cada fase de implantação precisa ter condições de entrada, continuidade e saída. Se uma classe crítica de resposta divergir do comportamento esperado, a expansão deve poder ser suspensa antes de alcançar mais nós.
A rastreabilidade deve permitir saber quais instâncias receberam a mudança e quais permaneceram na versão anterior. Sem essa distinção, comparar grupos e delimitar o raio do defeito se torna mais difícil.
4. Exercitar a retirada de ponta a ponta
O teste não deve terminar quando o comando é emitido. É necessário medir o intervalo desde a decisão autorizada até o desaparecimento observável dos anúncios relevantes em múltiplos pontos. A equipe também deve confirmar que consultas deixaram de alcançar os nós isolados.
O exercício precisa incluir as organizações que controlam cada etapa. Um teste realizado por somente uma equipe pode demonstrar capacidade local, mas não a interface institucional revelada pelo incidente.
5. Medir a capacidade remanescente
Isolar nós defeituosos pode transferir tráfego para outras localidades. A retirada deve ser avaliada junto com latência, carga, distribuição geográfica e margem de capacidade restante.
Uma mitigação que elimina respostas erradas, mas cria saturação não prevista, ainda pode ser a decisão correta. A diferença é que o risco deve ser conhecido e comparado com critérios aprovados antes da crise.
6. Definir a prova de correção
O reanúncio precisa depender de evidência explícita. Essa evidência pode incluir testes de regressão, comparação entre versões, consultas externas e uma janela de estabilidade. O simples fato de o patch ter sido implantado não demonstra que todas as respostas relevantes voltaram ao comportamento correto.
A decisão também deve registrar quem avaliou a prova e quem aceitou o risco residual. Isso evita que a urgência de recuperar capacidade substitua silenciosamente os critérios de qualidade.
7. Preservar resultados revisáveis
Cada exercício deve deixar data, escopo, participantes, tempos, critérios, desvios, ações corretivas e responsáveis. Uma revisão posterior deve confirmar se as correções foram concluídas e se um novo teste verificou sua eficácia.
A evidência pode permanecer protegida. Ainda assim, deve permitir que pessoas autorizadas distingam um procedimento escrito de uma capacidade realmente demonstrada.
8. Comparar o desempenho ao longo do tempo
Os 13 minutos entre o conhecimento inicial e a verificação e o escalonamento, e as 3 horas e 18 minutos até a restauração, são referências históricas do incidente. Eles não são metas universais. Podem, porém, orientar a decomposição do tempo atual.
Operadores e conselhos deveriam acompanhar separadamente o tempo para detectar, confirmar, autorizar, retirar, observar a propagação, corrigir, validar e reanunciar. Uma melhora no total pode esconder piora em uma etapa crítica, assim como um total maior pode resultar de uma validação deliberadamente mais rigorosa.
A conclusão que o registro permite
A causa imediata descrita no relato foi corrigida e o serviço foi restaurado. A cronologia registra conhecimento às 17h33 UTC, reconhecimento às 17h41, verificação e escalonamento às 17h46 e restauração completa às 20h51. A recuperação combinou correção de software, retirada BGP e reanúncio posterior.
O episódio mostra por que o número de nós não é uma prova completa de resiliência. A distribuição pode limitar o alcance de uma falha, mas também pode manter em serviço um subconjunto que responde incorretamente. Quando software, detecção e roteamento estão sob controles diferentes, a recuperação depende da interface entre organizações.
O compromisso posterior de testar regularmente a retirada BGP demonstra reconhecimento dessa dependência. Não demonstra sozinho que os exercícios ocorreram, que seguiram uma frequência definida, que cumpriram critérios mensuráveis ou que seus resultados foram verificados de modo independente.
A ausência de confirmação pública não deve ser transformada em alegação de que nada foi feito. O limite correto é outro: a evidência examinada documenta a resposta imediata, mas não oferece uma cadeia pública suficiente para avaliar a durabilidade posterior da capacidade de retirada.
Para operadores, a consequência é prática. Disponibilidade, correção semântica, autoridade de isolamento e execução de roteamento devem ser testadas como um único caminho. Para conselhos e responsáveis pela continuidade, a pergunta central não é se existe um procedimento, mas quando ele foi exercitado pela última vez, segundo quais critérios e com que resultado verificável.
A restauração de 2020 prova que uma combinação de correção e isolamento pôde funcionar naquele momento. A prontidão durável exige demonstrações repetidas de que o mesmo caminho continua disponível quando pessoas, sistemas e relações institucionais mudam.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance