
Resumo
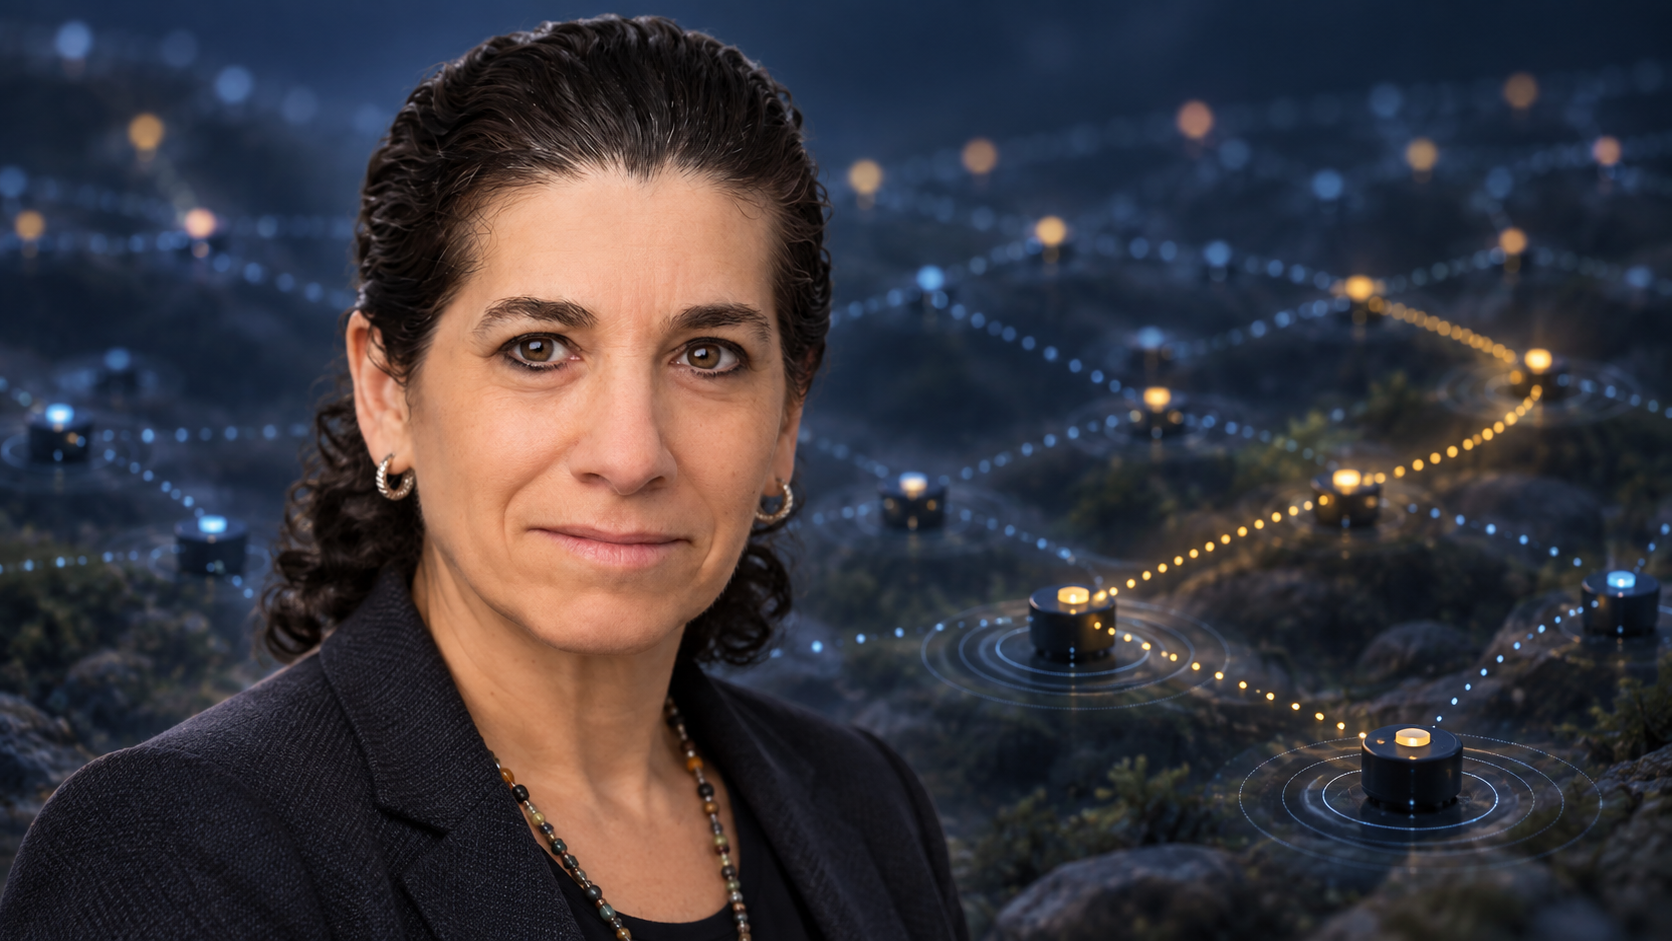
- A directed diffusion descrevia os dados procurados por atributos, espalhava interesses que criavam gradientes de estado temporário e reforçava uma ou poucas rotas após tráfego exploratório.
- Uma rota reforçada registra preferência sob uma métrica observada; não autentica o sensor, não garante a veracidade ou a totalidade do fenômeno e não revela sozinha o que foi agregado.
Uma pergunta antes do produtor
Em redes convencionais, o endereço costuma vir antes da mensagem. Os cenários de sensores do fim dos anos 1990 invertiam essa ordem. Havia muitos dispositivos pequenos, recursos de rádio e energia limitados e mudanças físicas que nenhum controlador acompanharia perfeitamente. A aplicação queria saber o que ocorria numa região, sem necessariamente conhecer o número do equipamento capaz de responder.
O artigo Next Century Challenges, de 1999, foi assinado por Deborah Estrin, Ramesh Govindan, John Heidemann e Satish Kumar. Ele argumentava a favor de algoritmos localizados, nos quais decisões simples entre vizinhos produziriam coordenação global. Estrin foi uma das pesquisadoras principais do SCADDS, mas a directed diffusion foi obra coletiva. O trabalho de MobiCom 2000 é de Chalermek Intanagonwiwat, Govindan e Estrin; a versão de 2003 inclui também Heidemann e Fabio Silva. Uma nota do texto atribui a Van Jacobson a sugestão de difundir dados nomeados por atributos.
A aplicação formulava uma tarefa como um interesse: pares atributo-valor podiam especificar tipo de evento, região, intervalo e duração. O nó que emitia a solicitação era o sink. Ele não apontava para um produtor identificado; publicava um predicado que os dados deveriam satisfazer.
Isso torna o esquema parte do controle. Uma taxonomia imprecisa pode juntar fenômenos diferentes; uma versão antiga pode continuar produzindo correspondências formalmente corretas e operacionalmente erradas. E o silêncio não prova ausência. O evento pode não ter ocorrido, mas também pode faltar sensor, caminho, energia, estado válido ou compatibilidade semântica.
O gradiente não era um mapa
Ao receber o interesse, cada nó o guardava e lembrava o vizinho de onde ele viera. Para esse vizinho criava um gradiente, um estado local de direção que podia incluir taxa desejada e validade. Vários vizinhos podiam deixar vários gradientes para a mesma demanda.
Interesses e gradientes eram soft state. Como a solicitação não tinha entrega garantida, precisava ser renovada; timestamp e expiração removiam memória antiga. Atualizar depressa custava mensagens e bateria. Atualizar devagar aumentava o tempo em que uma visão obsoleta orientava a rede.
Logo, o gradiente comprovava somente que um nó ainda lembrava uma demanda compatível recebida por um vizinho. Não autenticava esse vizinho, não identificava o sensor físico e não certificava continuidade fim a fim. Uma trilha operacional deveria registrar a versão do interesse, vizinho imediato, criação, renovação, expiração e motivo de remoção.
O que o reforço realmente escolhia
Um sensor que produzisse dados compatíveis tornava-se uma fonte. Mensagens iniciais podiam percorrer múltiplos gradientes em ritmo exploratório. O sink comparava chegadas e reforçava um vizinho preferido; o processo repetia-se salto a salto até a fonte. Depois, a maior parte dos dados seguia uma ou poucas rotas reforçadas.
Primeira chegada ou menor latência podiam orientar a escolha. Reforço negativo eliminava ramos duplicados ou piores, enquanto novas explorações descobriam alternativas. A rede respondia à experiência local, não a uma tabela onisciente.
Mas rapidez não é identidade. Um caminho pode parecer melhor porque outros perderam pacotes. A menor latência não mede a precisão do sensor, a cobertura do evento ou o custo energético futuro. Concentrar tráfego pode descarregar os melhores retransmissores antes dos demais.
O reforço, portanto, distribui recursos. A rota escolhida carrega mais dados, aparece mais nas medições e ganha nova chance de ser escolhida. Sem separar qualidade da rota e confiança na observação, a visibilidade inicial vira reputação.
A economia que altera a evidência
Nós intermediários podiam guardar, suprimir, transformar ou agregar mensagens. Processar perto da origem economizava transmissões e podia impedir loops ou duplicações. Para redes alimentadas por bateria, era parte central do desenho.
Ainda assim, dois relatos parecidos podem ser repetições ou confirmações independentes. Suprimir um deles economiza rádio, mas talvez apague concordância. Uma média correta esconde divergência. O sink recebe um produto útil, não necessariamente o histórico de todas as observações.
O resultado agregado precisa de recibo: regra e versão, quantidade de entradas e saídas, janela, nó executor, razão da supressão e disponibilidade dos dados brutos. Sem isso, não se sabe quais diferenças foram trocadas por eficiência.
O limite dos ensaios
O estudo de 2003 combinou análise, simulação e pequenas plataformas num cenário de vigilância remota ou rastreamento de veículos. Mostrou economia relevante nas condições examinadas, não uma garantia para todo sensor.
Trabalho posterior de Heidemann, Silva e Estrin comparou pull em duas fases, pull em uma fase e push. Número de fontes e sinks, frequência, geografia e assimetria mudavam o resultado. Diferenças de 40% a 60% nos experimentos demonstraram o custo de escolher mal o algoritmo; não oferecem um percentual universal de ganho.
A contribuição histórica foi organizar a rede por uma demanda temporária em vez de um produtor previamente endereçado. Ao fazer isso, o programa de Estrin tornou energia e adaptação parte explícita do protocolo. Também mostrou por que encontrar correspondência, selecionar um caminho e confiar num relato exigem provas separadas.
Fontes
- https://www.cs.cornell.edu/people/deborah-estrin
- https://www.isi.edu/websites/scadds/projects/diffusion.html
- https://ant.isi.edu/~johnh/PAPERS/Estrin99f.html
- https://ant.isi.edu/~johnh/PAPERS/Estrin99e.pdf
- https://ant.isi.edu/~johnh/PAPERS/Intanagonwiwat03a.html
- https://ant.isi.edu/~johnh/PAPERS/Intanagonwiwat03a.pdf
- https://ant.isi.edu/~johnh/PAPERS/Silva04a.html
- https://ant.isi.edu/~johnh/PAPERS/Silva04a.pdf
- https://ant.isi.edu/~johnh/PAPERS/Heidemann03a.html
- https://ant.isi.edu/~johnh/PAPERS/Heidemann03a.pdf
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance