
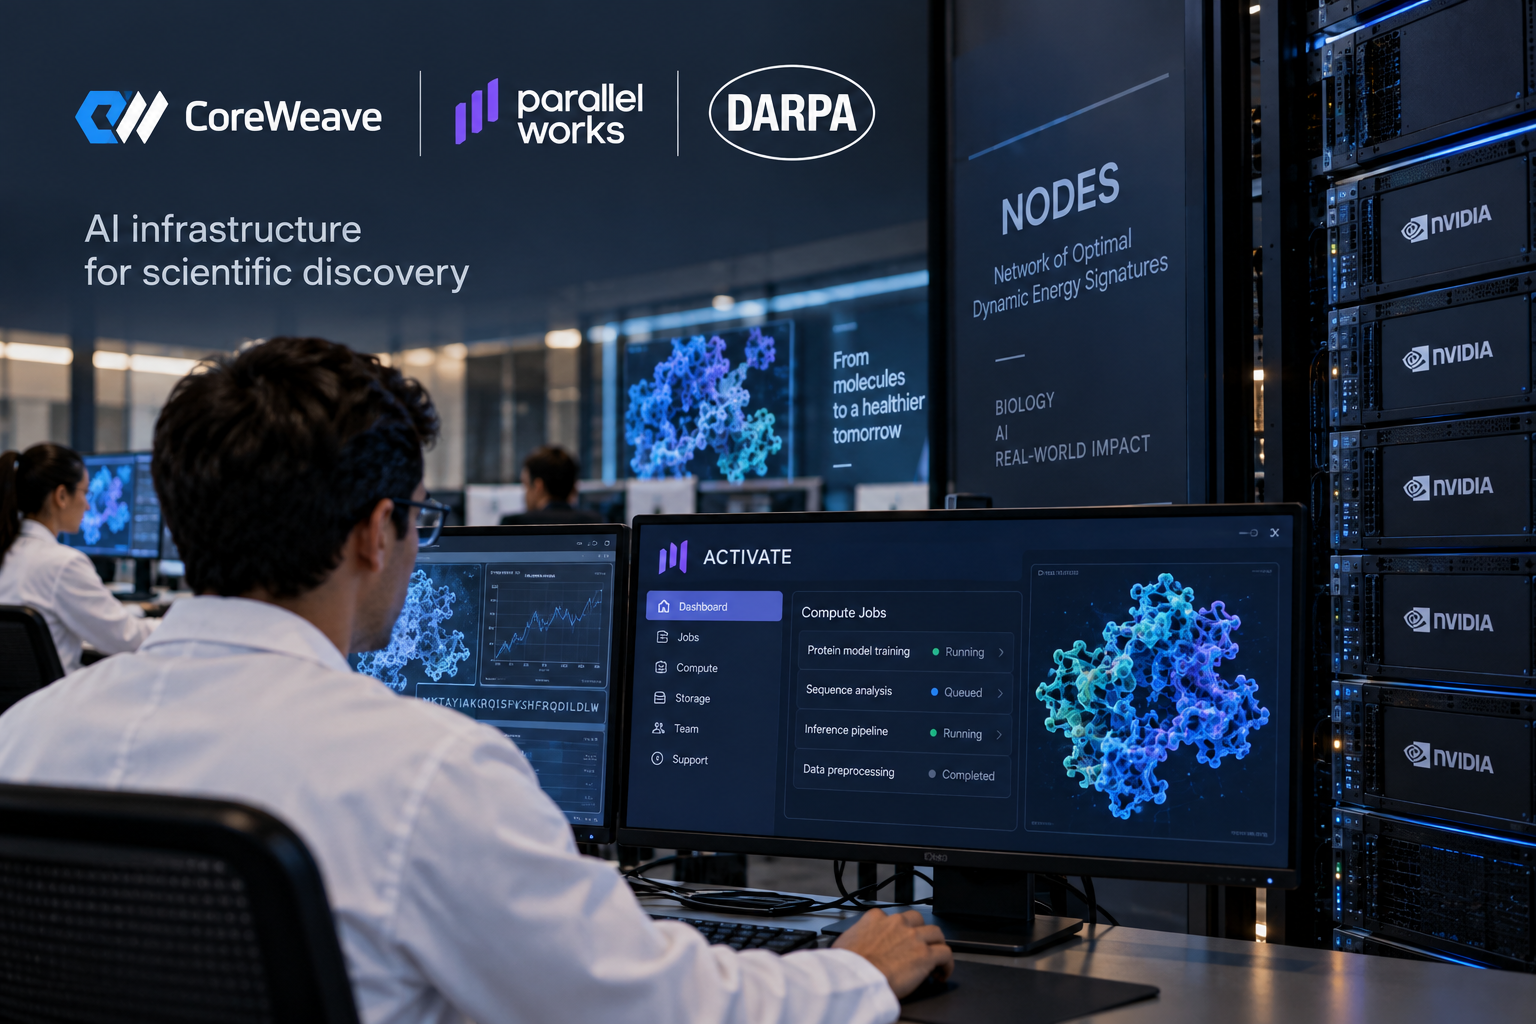
- CoreWeave e Parallel Works implantaram um ambiente gerenciado de computação para IA para o programa de pesquisa NODES da DARPA, usando sistemas NVIDIA H100
- Cada equipe de pesquisa recebe capacidade computacional garantida e pode usar recursos compartilhados adicionais quando estiverem disponíveis
O fato
A CoreWeave e a Parallel Works implantaram um ambiente gerenciado de computação para IA e computação de alto desempenho para o programa Network of Optimal Dynamic Energy Signatures, ou NODES, da DARPA. Os pesquisadores acessam o sistema pela plataforma ACTIVATE da Parallel Works, que gerencia autenticação, contas de usuário, provisionamento, agendamento e relatórios de uso. A CoreWeave fornece a infraestrutura subjacente de computação, armazenamento e rede, incluindo sistemas NVIDIA HGX H100 e conexões InfiniBand de alta velocidade.
A capacidade é distribuída entre as equipes de pesquisa do NODES. Cada equipe recebe uma alocação garantida e também pode usar a capacidade compartilhada quando ela estiver disponível. As empresas também oferecem suporte técnico, para que cada equipe não precise criar e gerenciar seu próprio ambiente de nuvem separado.
O NODES está desenvolvendo ferramentas de aprendizado profundo para analisar sequências de proteínas e prever funções biológicas. A DARPA permite que os pesquisadores usem seus próprios recursos computacionais, mas afirma que os produtos finais e as demonstrações de capacidade devem ser executados em sistemas governamentais de computação de alto desempenho. O novo ambiente de nuvem dá suporte ao programa de pesquisa; ele não demonstra que o NODES tenha alcançado seus objetivos científicos.
A avaliação
As equipes de pesquisa não precisam apenas de GPUs; elas precisam de uma forma prática de acessá-las. Neste caso, a Parallel Works cuida das contas, do acesso e do agendamento, enquanto a CoreWeave fornece a plataforma de computação. Assim, os pesquisadores do NODES devem ter menos infraestrutura para configurar e gerenciar antes de iniciar o trabalho.
A forma como a capacidade é compartilhada será importante. Cada equipe tem uma alocação garantida, com capacidade adicional disponível em uma reserva comum quando ela estiver livre. Isso oferece aos pesquisadores uma base previsível para o planejamento e, ao mesmo tempo, melhora o aproveitamento dos recursos ociosos. Resta saber como esse arranjo funcionará quando várias equipes precisarem de mais capacidade computacional ao mesmo tempo.
Para os leitores da BTW, este é um exemplo útil de infraestrutura de IA fornecida como serviço gerenciado, e não apenas como aluguel de hardware. O valor desse modelo ficará mais claro se os pesquisadores conseguirem começar a usar o sistema rapidamente, realizar seu trabalho sem longas esperas e passar menos tempo lidando com o próprio ambiente computacional.
O que observar
Observe a rapidez com que as equipes de pesquisa são integradas à plataforma e como a capacidade compartilhada responde à medida que a demanda aumenta. Informações sobre tempos de espera, uso de recursos, tarefas com falha ou atendimento de suporte técnico mostrariam se as equipes do NODES têm acesso previsível na prática.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance