
Resumo
- A ThousandEyes situa a restauração das informações de DNS às 09h25 UTC de 20 de outubro de 2025, mas relata falhas de lançamento ou problemas de conectividade em novas instâncias EC2 até 20h50 UTC. São marcos de recuperação diferentes, não a medida de uma falha uniforme para todos os clientes. Análise da ThousandEyes.
- O relato de Dipak Kr das descreve sobrecarga na recuperação da gestão dos servidores e, separadamente, um acúmulo de atualizações de rede. A consequência técnica é que voltar a acessar o DynamoDB não equivalia a dispor de nova capacidade computacional utilizável. Análise publicada no Medium.
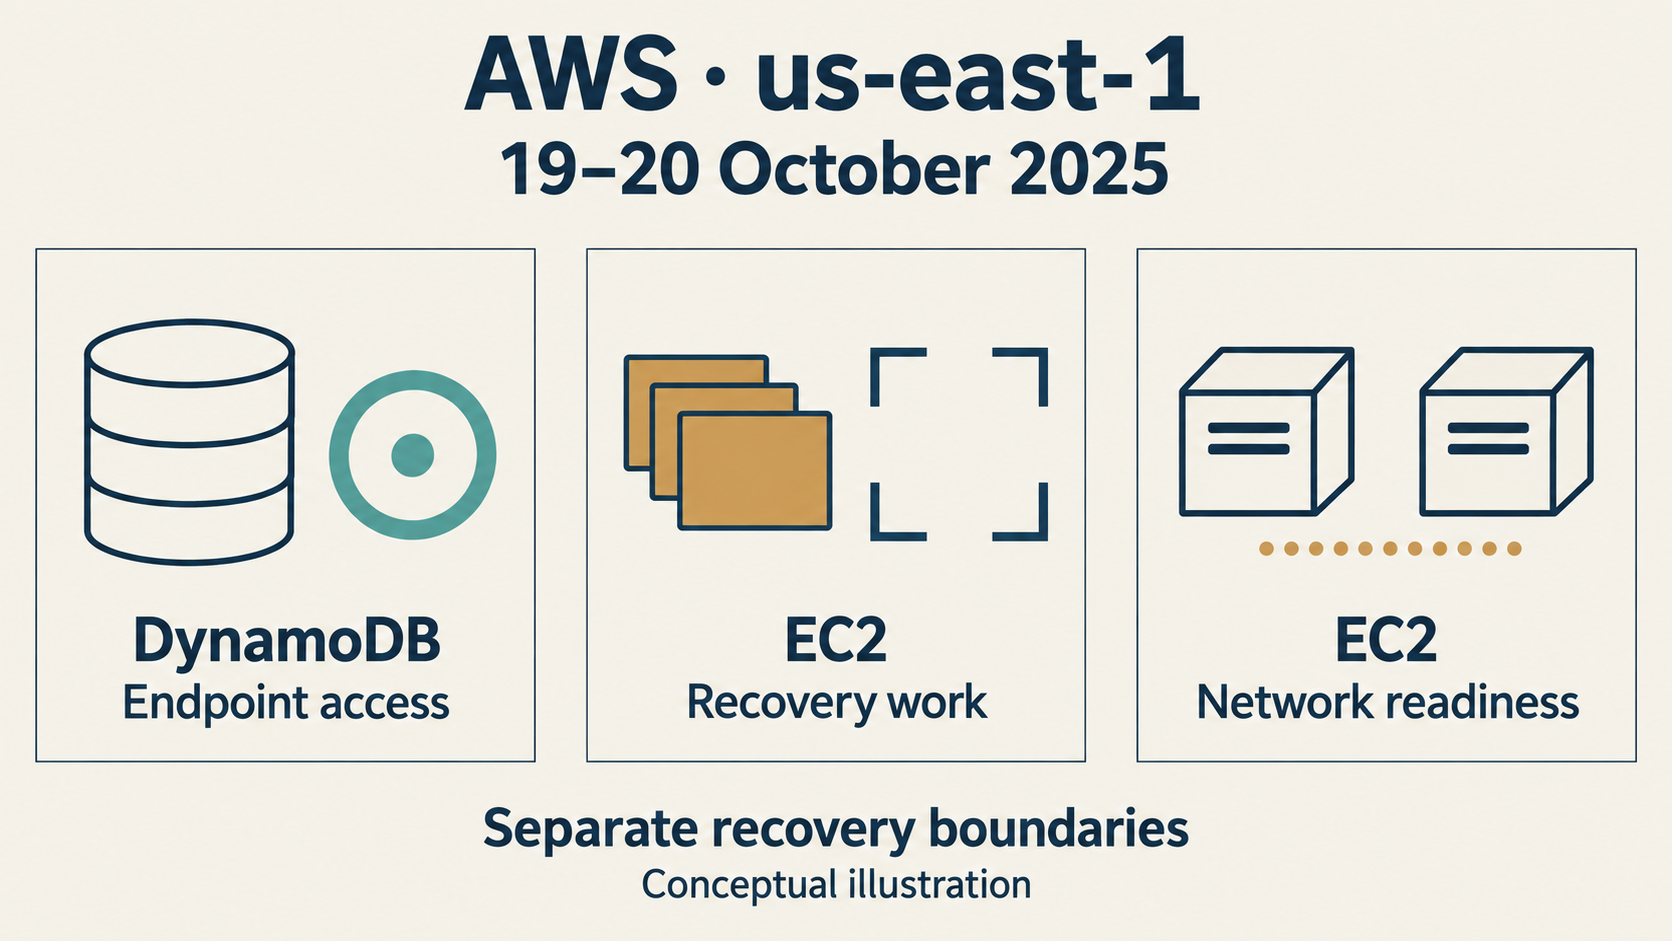
Uma recuperação pode criar trabalho antes de devolver capacidade. Essa é a distinção mais útil para entender o episódio de 19 e 20 de outubro de 2025 na região us-east-1, da Amazon Web Services, na Virgínia do Norte. Na reconstrução de Dipak Kr das, o problema começou na resolução do endereço de acesso ao DynamoDB, mas a volta dessa dependência não bastou para normalizar os sistemas responsáveis por disponibilizar novas instâncias EC2. Seu relato atribui a falha inicial a uma condição de corrida latente na gestão automatizada de DNS: uma situação em que o resultado depende da ordem de execução de operações concorrentes. Relato de Dipak Kr das.
Não se trata de uma descrição de pane atual. É uma análise retrospectiva sobre o que significa recuperar um serviço quando outros componentes acumularam trabalho durante sua indisponibilidade. Também não é um relato de falha simultânea em todas as regiões da AWS.
A dependência estava na gestão dos servidores
Segundo a ThousandEyes, o Droplet Workflow Manager, ou DWFM, do EC2 não conseguia concluir verificações de estado necessárias enquanto o DynamoDB estava indisponível. Isso prejudicou a gestão de seus leases. Nesse contexto, lease é uma relação interna de gerenciamento com validade limitada, não o contrato comercial pelo qual um cliente paga por uma instância. A distinção importa: a dificuldade atingia a capacidade do sistema de gerenciar recursos, e não necessariamente a execução de toda máquina virtual já existente. Descrição da ThousandEyes.
Dipak Kr das explica que essas verificações no DynamoDB estavam associadas aos servidores físicos que hospedavam instâncias EC2. Em seu relato, quando a dependência voltou, uma grande quantidade de trabalho de restabelecimento dos leases sobrecarregou o DWFM, impedindo que o sistema avançasse. Engenheiros limitaram a entrada de trabalho e reiniciaram seletivamente hosts do DWFM para recuperar sua operação. São intervenções descritas pelo autor em sistemas internos da AWS; não procedimentos disponíveis a um cliente comum do EC2. Explicação de Dipak Kr das.
O mecanismo ajuda a evitar uma conclusão apressada. Se a interrupção de uma dependência deixa tarefas pendentes, restaurá-la pode liberar essas tarefas de uma vez. O componente seguinte precisa absorver esse trabalho, e não apenas voltar a responder a uma consulta. A disponibilidade da dependência e a capacidade de processar a recuperação são condições distintas.
Três horários, três significados
A cronologia selecionada pela ThousandEyes permite separar a restauração do DNS da recuperação das conexões e dos problemas posteriores no EC2. Todos os horários abaixo são de 20 de outubro de 2025, em UTC.
| Marco relatado | O que permite afirmar | O que não permite afirmar |
|---|---|---|
| 09h25: restauração das informações de DNS | As informações necessárias à resolução do endereço foram restauradas | Todos os clientes e serviços já estavam recuperados |
| 09h25–09h40: retorno da resolução e das conexões à medida que registros em cache expiravam | A restauração se propagou para os acessos descritos nessa janela | O provisionamento de novas instâncias EC2 já estava normal |
| Até 20h50: falhas de lançamento ou problemas de conectividade em novas instâncias EC2 | O relato registra comprometimento da entrega de nova capacidade até esse marco | Todo lançamento falhou continuamente durante todo o intervalo |
Entre 09h25 e 20h50 há 11 horas e 25 minutos. O cálculo dimensiona a distância entre dois marcos diferentes da mesma cronologia. Não mede uma indisponibilidade contínua de todo o EC2, muito menos o tempo de interrupção de cada aplicação. Um cliente que precisava criar capacidade naquele período enfrentava uma questão diferente da de outro que já mantinha recursos em execução.
Também seria incorreto escolher 09h25 como horário universal de recuperação. Mesmo no acesso ao endpoint, a ThousandEyes distingue a restauração das informações de DNS da janela posterior em que a expiração dos registros em cache permitiu retomar resolução e conexões. A dependência teve sua própria sequência de retorno; os sistemas que dependiam dela tinham outras condições de conclusão.
Instância criada ainda precisava de rede
O relato de Dipak Kr das identifica um segundo acúmulo de trabalho, separado da recuperação do DWFM. O Network Manager precisava propagar estado de rede para as instâncias recém-iniciadas. Segundo o autor, o atraso nesse processamento deixou algumas delas sem conectividade ou com falhas nas verificações de integridade. Descrição do acúmulo de atualizações de rede.
Isso introduz mais uma fronteira. Aceitar uma solicitação de lançamento não demonstra que a instância resultante esteja acessível. E uma instância acessível não demonstra, por si só, que a aplicação consiga completar sua operação. O caso não exige tratar todo esse percurso como uma única falha de DNS: a resolução do endereço, a gestão dos servidores e a configuração de rede desempenhavam funções diferentes.
O atraso de propagação descrito tampouco é evidência de uma falha de roteamento da Internet inteira. A explicação é mais delimitada: havia trabalho de configuração de rede necessário para transformar recursos recém-criados em capacidade utilizável. Sem preservar essa diferença, uma melhora na primeira etapa poderia ser confundida com a conclusão da última.
Continuar executando não era o mesmo que continuar atendendo
A Gremlin distingue as instâncias EC2 iniciadas antes do evento, que descreve como tendo permanecido saudáveis, das dificuldades dos clientes para iniciar novas instâncias depois de resolvido o problema no DynamoDB. Essa afirmação precisa de um limite imediato: execução contínua de uma instância não comprova disponibilidade de ponta a ponta da aplicação que roda nela. Análise de confiabilidade da Gremlin.
Uma aplicação ainda pode depender de serviços externos àquela instância para completar uma operação. Portanto, o contraste relevante não é entre clientes inteiramente protegidos e clientes inteiramente desprotegidos. É entre manter recursos já em funcionamento e conseguir obter outros recursos, com rede funcional, no momento em que eles se tornam necessários.
Esse contraste torna mais concreta a avaliação de redundância. Contar zonas ou regiões em um desenho não informa, sozinho, se a recuperação exige criar instâncias, obter credenciais, acessar dados ou configurar um caminho de rede. O episódio justifica testar essas etapas. Não demonstra que toda arquitetura com múltiplas zonas ou regiões tenha falhado, nem que qualquer alternativa específica estivesse disponível para todos os clientes.
O alcance da reconstrução
A análise se apoia em três relatos técnicos secundários, não em uma auditoria independente dos registros internos da AWS. Os marcos de horário são atribuídos à ThousandEyes; o mecanismo detalhado de sobrecarga, as intervenções e o acúmulo de atualizações de rede vêm da explicação de Dipak Kr das no Medium. A distinção entre instâncias existentes e novos lançamentos é a apresentada pela Gremlin.
Esses relatos sustentam uma conclusão delimitada: restaurar a dependência que iniciou a crise não encerrou o trabalho necessário para entregar nova capacidade EC2. Não permitem estimar perdas financeiras, determinar a situação de cada cliente, afirmar perda ou ausência de perda de dados, nem avaliar a eficácia atual das correções. A lição não depende de supor que os defeitos históricos continuem presentes. Depende de definir qual função precisa voltar antes de chamar uma recuperação de concluída.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance