
Resumo
- A FCC concluiu que um registro de provisionamento não continha os endereços IP corretos da Comtech. Uma mudança não relacionada levou esse registro para a lista branca ativa dos Session Border Controllers [1].
- As conexões estavam classificadas como ativos de cliente, e não de infraestrutura. Essa categoria permitiu a mudança sem os testes mais rigorosos e as janelas fora do horário de pico aplicados a ativos críticos [1].
- Quando os erros ultrapassaram um limite, a Proxy Location Routing Function reiniciou enlaces compartilhados pelos dois provedores de informação de roteamento. A recuperação retirou também o caminho que deveria permanecer saudável [1].
- A AT&T informou que cerca de 12.600 pessoas únicas não conseguiram chegar diretamente ao 911. O centro manual de retransmissão não fora dimensionado para transbordamento nacional e descartou a grande maioria das chamadas adicionais [1].
- A operadora relatou mudanças na classificação, na entrega de alarmes, na separação lógica dos caminhos e em um retorno manual de VoLTE para 3G. Essas medidas registradas não são, sozinhas, prova permanente de desempenho posterior [1].
Delimitar o evento corretamente
Este texto trata da interrupção nacional do 911 na rede AT&T Mobility VoLTE em 8 de março de 2017. Não trata da interrupção regional de 22 de agosto de 2023 nem da indisponibilidade móvel nacional de 22 de fevereiro de 2024. Esses eventos posteriores possuem cronologias, causas e processos regulatórios próprios. A separação é necessária para não misturar controles e consequências.
O relatório final da FCC é a fonte factual principal [1]. Ele afirma que quase todos os clientes VoLTE da AT&T Mobility no país perderam o serviço 911 por cinco horas. A AT&T estimou aproximadamente 12.600 usuários únicos que tentaram ligar e não chegaram aos serviços de emergência pela rede tradicional. Esse número deve permanecer atribuído à operadora no registro regulatório; não estabelece tentativas não registradas, resultados médicos individuais ou perdas financeiras.
O relatório também observa que algumas chamadas usaram redes legadas, outras chegaram a um centro de contingência e algumas localidades aparentaram não sofrer impacto. Uma análise responsável preserva essas limitações. O aviso público da FCC abriu o processo PS 17-68 [2], o relatório preliminar apresentou a avaliação inicial [3], e registros da NENA e da APCO fornecem o contexto das entidades de segurança pública [4][5].
O caminho previsto para a chamada
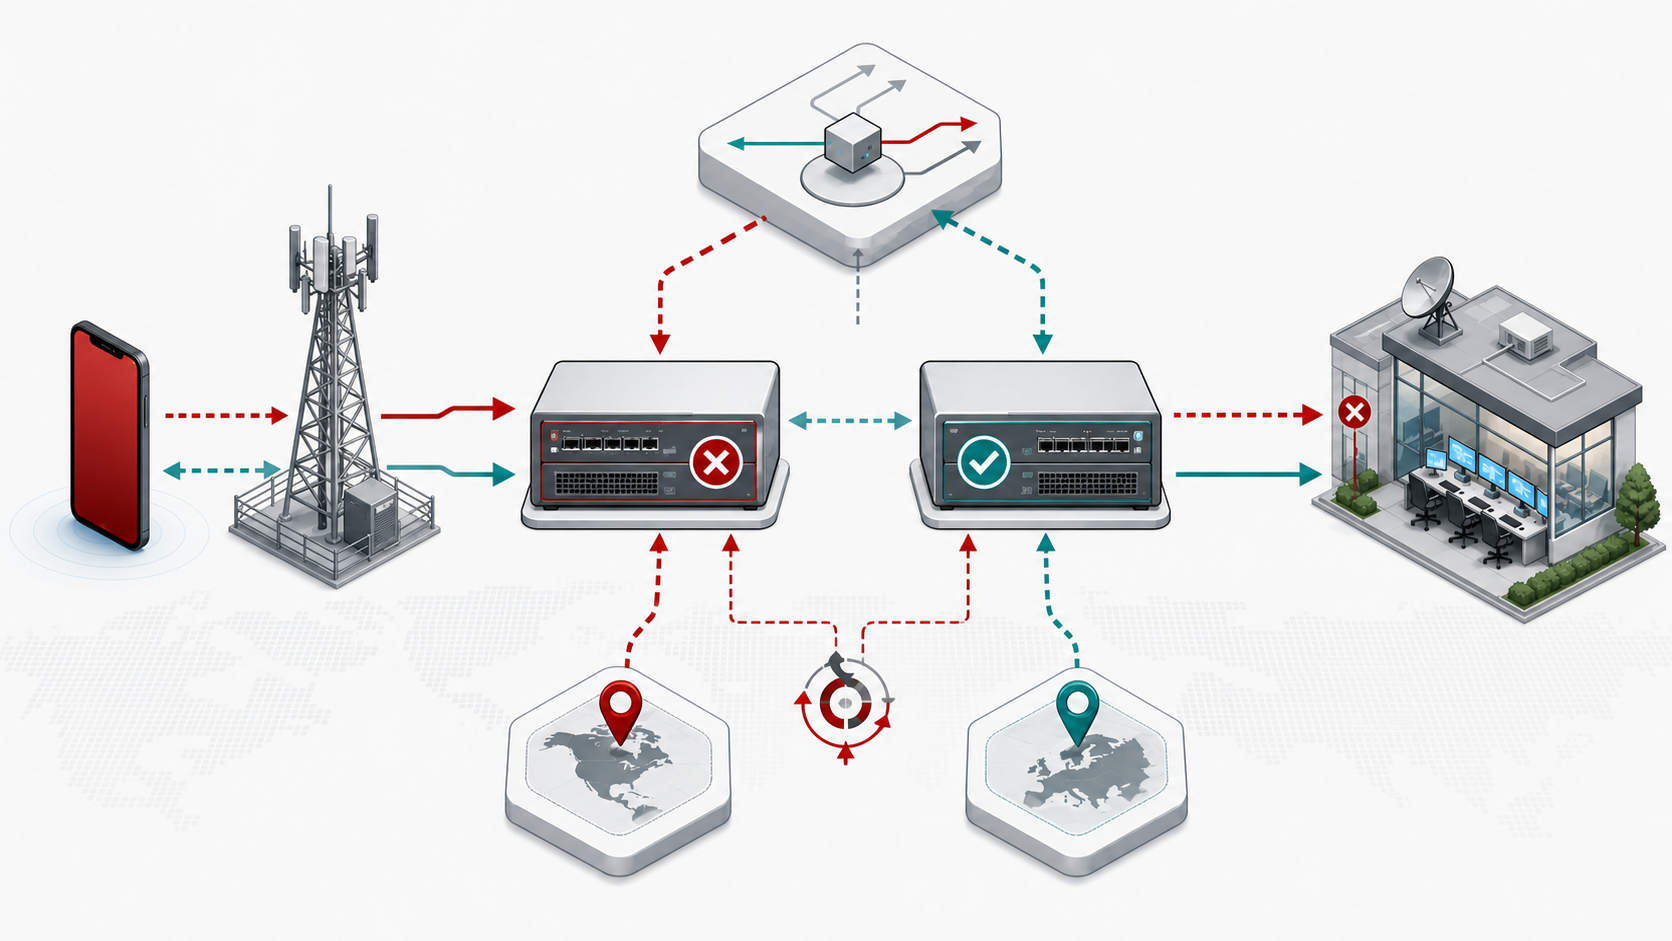
Segundo a FCC, a chamada começava na rede VoLTE e chegava a uma estação LTE. A rede de emergência da AT&T enviava os dados para um de dois provedores, Comtech ou West. O provedor determinava o Public Safety Answering Point adequado a partir da localização, adicionava informações de roteamento e devolvia os dados. A AT&T entregava então a chamada pela operadora local que atendia o PSAP [1].
A Proxy Location Routing Function, ou PLRF, escolhia o provedor com base no setor celular. Os Session Border Controllers, ou SBCs, controlavam a fronteira com os provedores. No retorno, os SBCs verificavam se o endereço IP de origem constava de uma lista branca autorizada.
Essa lista ativa era um controle de segurança. O sistema de provisionamento mantinha um registro das identidades e endereços aprovados. Registro e estado em operação eram relacionados, mas diferentes. O primeiro expressava uma intenção; o segundo decidia se o tráfego real seria aceito. Um fluxo de aprovação correto ainda pode implantar o resultado errado quando o registro está incompleto.
Antes de 8 de março, o registro não incluía os endereços apropriados da Comtech. A comunicação continuava porque o erro ainda não havia substituído a configuração ativa. Uma mudança iniciada por outro projeto transferiu o registro para os SBCs. O retorno da Comtech deixou de corresponder ao conjunto confiável e os dados necessários para escolher o PSAP foram rejeitados [1].
Há quatro controles distintos nessa sequência. Qualidade do dado pergunta se o conjunto registrado está correto. Reconciliação compara registro e configuração em serviço. Admissão avalia o delta proposto. Verificação após a mudança confirma uma transação ponta a ponta por cada caminho. Um hash comprova quais bytes foram implantados, mas não que incluam toda identidade necessária. Um commit bem-sucedido comprova aceitação pelo equipamento, mas não que a chamada percorra o serviço completo.
A classificação determinou controles insuficientes
As conexões dos SBCs aos provedores estavam marcadas como ativos de cliente. Os ativos de infraestrutura da AT&T passavam por testes de falha mais rigorosos e por janelas de manutenção fora do pico. A classificação de cliente permitiu realizar a mudança em horário de maior tráfego do 911 e sem essas proteções [1].
Não se tratava apenas de terminologia. A etiqueta selecionava uma política executável: profundidade da revisão, horário permitido e testes negativos. Uma ligação voltada a um fornecedor continua sendo infraestrutura compartilhada crítica se sua perda puder retirar o roteamento de emergência em escala nacional. A consequência plausível deve prevalecer sobre a posição organizacional do objeto.
A FCC disse que testes mais cuidadosos provavelmente teriam revelado a atribuição IP incorreta. O limite probabilístico importa. Nenhum teste isolado garante a detecção de toda divergência. O pacote robusto combina comparação estática, rejeição de um endereço não aprovado, transação positiva por cada fornecedor e falha controlada que prove a independência dos caminhos.
Dois provedores acoplados pela recuperação
A rejeição do tráfego da Comtech gerou erros entre os SBCs e a PLRF. Quando a densidade de erros ultrapassou um valor configurado, a PLRF executou reinicializações leves nos enlaces. Como Comtech e West usavam os mesmos caminhos, a reação também interrompia o fornecedor saudável. O processamento apoiado pela West retornava após a recuperação e podia cair novamente diante de outra onda de erros [1].
A arquitetura tinha dois provedores e instalações geograficamente diversas, mas um comportamento comum os colocou no mesmo domínio de falha. Contar componentes não prova redundância. O teste relevante remove o provedor A, mantém o B disponível, entrega alarmes específicos e mostra que a recuperação automática não amplia o incidente.
Diagramas podem desenhar caixas separadas sem mostrar os limites de reset, as dependências de configuração e as transições de estado. A independência é uma propriedade do código e da configuração em execução. Precisa ser demonstrada sob uma falha representativa.
A contingência manual não absorveu a escala
Quando não obtinha o PSAP correto, a AT&T direcionava a chamada a um Emergency Call Relay Center. Atendentes perguntavam a localização e tentavam encaminhar manualmente. O centro fora criado para uma pequena fração de chamadas que não seguiam a rota normal, e não para uma indisponibilidade nacional. Segundo a FCC, ele não suportou o volume adicional e perdeu a maioria esmagadora das chamadas [1].
Uma contingência faz parte do desenho primário quando é apresentada como controle de continuidade. É necessário declarar quais falhas ela absorve, quanto demora para ativar, quais dados conserva e como se comporta depois da saturação. O objetivo não é capacidade infinita. É uma fronteira testada e um mecanismo adicional que impeça uma falha local de virar transbordamento nacional.
O registro público menciona sinal de ocupado rápido, chamadas que tocavam repetidamente ou silêncio. Também apresenta exemplos na Flórida e localidades sem reclamações públicas. Essa variação não sustenta uma afirmação uniforme sobre todas as regiões. Sustenta a conclusão de que milhares de chamadas não completaram o caminho normal e que o recurso alternativo não cobriu a escala.
O alerta foi rápido; o diagnóstico não
A linha do tempo mostra chamados críticos poucos minutos depois do início. A equipe do 911 reconheceu-os dezesseis minutos mais tarde. A escalada passou sequencialmente pelas equipes de 911, VoLTE, serviço amplo e backbone antes de envolver a equipe IP. Quase cinco horas após o começo, a equipe IP relacionou o horário da falha com a mudança e pediu a reversão. O serviço voltou três minutos depois [1].
Um alarme só tem valor quando chega às pessoas capazes de testar a hipótese certa. Um incidente que atravessa domínios exige distribuição simultânea, cronologia comum de mudanças, acesso ao estado ativo e autoridade de rollback. A escalada serial pode ser apropriada para problemas pequenos, mas cria atraso quando nenhum grupo enxerga a cadeia inteira.
As notificações aos PSAPs também foram tardias e incompletas. Uma mensagem útil pode proteger endereços e topologia, mas ainda deve informar serviço afetado, área conhecida, hora de início, confiança, alternativa e próxima atualização. Sem isso, órgãos locais têm pouca base para divulgar números de contato alternativos.
Mudanças relatadas depois da falha
A FCC registrou quatro ações principais informadas pela AT&T [1]. A operadora reclassificou os enlaces como infraestrutura, modificou a entrega de alarmes para avisar em paralelo as equipes de 911, VoLTE e IP, separou logicamente os links entre SBCs e PLRF e criou um processo manual para retirar o serviço VoLTE e usar 3G em chamadas 911 durante uma indisponibilidade VoLTE.
As ações correspondem à cadeia de falha. Ainda assim, a prova durável exige identidade da configuração, resultados por caminho, exercício de isolamento, registros de entrega de alarmes, ativação do fallback e histórico operacional. Um teste seguro pode omitir um endereço de fornecedor em uma configuração candidata, confirmar que o delta é bloqueado ou contido e manter a transação sintética pelo segundo caminho.
O registro apoia a realidade; não governa sozinho
O sistema de provisionamento era um livro de identidades e endereços aprovados. Esse papel era necessário para segurança e automação. O incidente mostra o limite: um registro não vira verdade operacional apenas por estar autorizado. Ele produziu efeito quando foi transferido à lista ativa, e sua correção só poderia ser julgada diante dos endereços reais e de uma transação de emergência.
Essa é a superfície Heng.lu do caso. Metadados de segurança, identidade de rede e histórico de mudanças sustentam a continuidade, mas não substituem a rede em funcionamento. Permissão para implantar não prova correspondência com a realidade. Uma classificação não muda a consequência da falha. Um segundo provedor no projeto não prova um segundo caminho independente.
Para a mesma janela, uma evidência defensável liga identidades aprovadas, registro, hashes da configuração candidata e ativa, transações por caminho, alarmes, rollback e resultado do serviço. Qualquer divergência deve bloquear a mudança ou abrir um incidente nomeado antes que chamadas públicas dependam do novo estado.
A retenção também conta. A AT&T mantinha os registros de provisionamento por 90 dias e não conseguiu determinar quando ou por que a entrada errada foi criada [1]. A duração da evidência precisa acompanhar a janela provável de descoberta de uma divergência crítica, não somente o custo rotineiro do armazenamento.
Fronteira de responsabilidade
A AT&T controlava registro, lista branca, classificação, SBCs, PLRF, distribuição de alarmes e contingência da operadora. Comtech e West forneciam dados de roteamento. Os PSAPs administravam respostas e comunicações locais. A FCC reuniu o histórico entre essas fronteiras.
Operação compartilhada não elimina propriedade. Conforme a reconstrução da FCC, a lista incorreta e o comportamento de reset estavam na rede da AT&T. Fornecedores e órgãos públicos ainda precisavam de informação rápida para conter o impacto. Responsabilização inclui o controle iniciador e as interfaces que permitem a reação dos demais.
A conclusão é objetiva. Um registro crítico é confiável somente quando coincide com a configuração ativa e uma transação bem-sucedida. Provedores redundantes são independentes somente quando a perda de um deixa o outro operacional. A contingência protege dentro de uma capacidade testada. E o rollback rápido depende de as equipes com a evidência correta identificarem a mudança responsável a tempo.
Fontes
- https://docs.fcc.gov/public/attachments/DOC-351492A1.pdf
- https://docs.fcc.gov/public/attachments/DA-17-277A1_Rcd.pdf
- https://docs.fcc.gov/public/attachments/DOC-344049A1.pdf
- https://www.nena.org/news/334578/NENA-Statement-on-March-8-9-1-1-Outage.htm
- https://ecfsapi.fcc.gov/file/10410294707272/APCO%20Apr2017%20ex%20parte%20-%20ATT%20Mobility%20Outages%20v2.pdf
- https://about.att.com/content/dam/snrdocs/Tips%20for%20Customers%20for%20911.pdf
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance