
Resumo
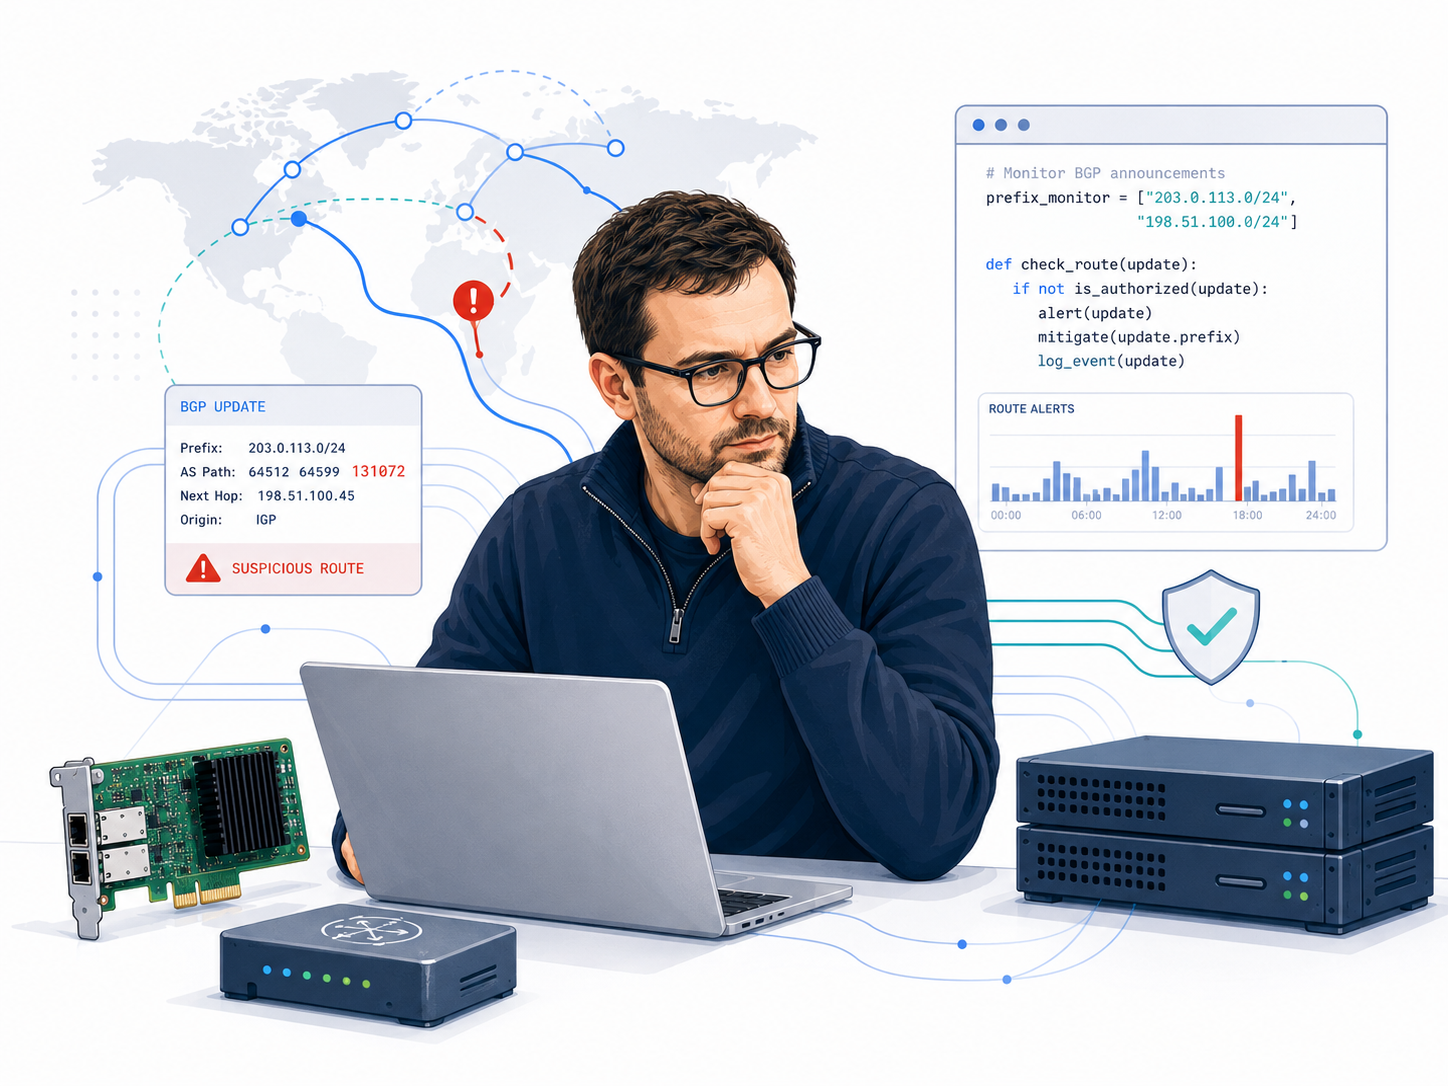
- ARTEMIS é um sistema de código aberto operado pela própria organização que compara observações de BGP em tempo real com a intenção local de roteamento, oferecendo às redes um contexto que os coletores públicos, isoladamente, não conseguem fornecer.
- A pesquisa de 2018 da FORTH e da CAIDA relatou detecção em segundos e neutralização em menos de um minuto nas condições testadas; o resultado não é uma garantia universal de produção.
- Sua mitigação pode anunciar rotas mais específicas ou acionar fluxos de trabalho personalizados, mas filtros, políticas desatualizadas, visibilidade incompleta e credenciais amplas podem transformar uma resposta rápida em um segundo incidente.
- O projeto agora depende de lançamentos disciplinados, evidências confiáveis de implantação e uma fronteira transparente com a Code BGP, cuja manutenção comercial pode sustentar o software aberto sem substituir seu histórico de pesquisa.
Uma mudança real de rota mostrou por que os segundos são apenas o começo
O relatório anual de 2019 da CAIDA afirma que ARTEMIS detectou, em segundos, um sequestro real que afetava um /30 da Internet2. O evento é importante porque leva as evidências além dos anúncios sintéticos concebidos pelos pesquisadores. Uma rota ativa mudou em uma rede participante da implantação, e o sistema reconheceu o desvio com rapidez suficiente para apoiar a investigação.
O relatório não estabelece uma distribuição universal dos tempos de detecção. Um /30 é um prefixo específico em um contexto específico de roteamento, observado pelos feeds disponíveis naquela implantação. Outro evento pode se propagar de maneira diferente, durar menos tempo ou permanecer fora do alcance dos coletores conectados. O relatório também não comprova, por si só, intenção maliciosa nem todos os efeitos no plano de dados. A conclusão segura é que ARTEMIS detectou em segundos um evento real relatado durante o programa de implantação da CAIDA.
Estudos de caso têm valor justamente quando seus limites são preservados. Eles revelam como o software se comporta diante de mudanças reais, como os operadores recebem o alerta e quais evidências ficam disponíveis depois. Mais registros de incidentes, incluindo falsos positivos, eventos não detectados e resultados das mitigações, fariam mais para estabelecer a maturidade em produção do que outra alegação chamativa sobre tempo de resposta.
Um alerta de BGP pode chegar em segundos e ainda deixar sem resposta as perguntas mais importantes. Um coletor de rotas pode mostrar que um sistema autônomo desconhecido anunciou um prefixo ou que uma rota mais específica apareceu e começou a se propagar. Essa evidência informa ao operador que o plano de controle já não corresponde ao padrão esperado. Por si só, porém, ela não estabelece quem fez a mudança, se foi acidental, se o tráfego seguiu o novo caminho, se usuários foram prejudicados ou qual resposta restaurará o serviço sem criar outro problema.
ARTEMIS foi concebido em torno dessa lacuna entre detecção e ação. Seu nome significa Automatic and Real-Time dEtection and MItigation System, mas o acrônimo em letras maiúsculas não deve desviar a atenção do modelo operacional. Não se trata de um serviço central que observa toda a internet e repara remotamente as redes de terceiros. Uma organização implanta o software na infraestrutura que controla, define o estado de roteamento considerado legítimo, conecta observações públicas e privadas e decide até onde o sistema pode ir quando essas observações divergem da política.
A promessa do projeto é velocidade com contexto; sua limitação é que o contexto e a autoridade são locais.
ARTEMIS, portanto, se parece menos com uma força policial da internet e mais com um instrumento de sala de controle pertencente ao operador. Ele pode organizar evidências, reduzir o tempo gasto na busca por atualizações de rotas e preparar uma resposta previamente discutida. Não pode dispensar o julgamento do operador. A decisão final pode afetar o roteamento global, as relações com provedores upstream e o tráfego dos clientes; por isso, a qualidade da resposta depende tanto de pessoas, configuração e autoridade exercitada quanto do detector.
O BGP pode transmitir alcançabilidade antes de comprovar autoridade
O Border Gateway Protocol permite que redes operadas de forma independente troquem informações de alcançabilidade e apliquem políticas locais. Um sistema autônomo anuncia que consegue alcançar um conjunto de prefixos IP; as redes vizinhas decidem se aceitam, preferem e repassam essas rotas. Esse arranjo permitiu que a internet ganhasse escala entre organizações sem um controlador comum, mas o protocolo original não associa uma prova criptográfica a cada alegação sobre origem ou caminho. Assim, uma exportação equivocada, uma configuração desatualizada ou um anúncio deliberado pode introduzir uma rota que não deveria existir.
A seleção de rotas pode tornar um anúncio indevido atraente. Quando duas rotas cobrem prefixos de igual extensão, as redes aplicam políticas e regras de seleção que variam entre operadores. Quando um invasor ou uma rede equivocada anuncia um subprefixo mais específico, a correspondência normal pelo prefixo mais longo costuma direcionar o tráfego para a rota mais estreita onde quer que ela seja aceita. O mecanismo não é uma função especial de ataque; é a regra comum que permite aos roteadores escolher o destino mais preciso.
Por isso, um anúncio aparentemente pequeno pode redirecionar o tráfego rapidamente, mesmo que o agregado legítimo continue visível.
A palavra “sequestro” é uma abreviação útil, mas pode sugerir uma intenção que as mensagens de roteamento não revelam. Uma origem não autorizada pode ser maliciosa, acidental ou resultar de uma mudança comercial legítima que não foi refletida na política de monitoramento. Um caminho fabricado pode ser usado para interceptar tráfego, mas uma atualização do plano de controle não comprova a interceptação. ARTEMIS funciona melhor quando trata o alerta como uma divergência entre o roteamento observado e o pretendido, deixando a atribuição e o impacto para um processo de incidente mais amplo.
Um evento de prefixo exato concorre com a rota legítima usando a mesma extensão de prefixo. Seu alcance depende das políticas e escolhas de caminho das redes que recebem os dois anúncios. Algumas partes da internet podem preferir a rota inesperada, enquanto outras continuam usando a origem legítima. O resultado pode ser alcançabilidade parcial, diferenças regionais e uma combinação confusa de êxitos e falhas, em vez de uma indisponibilidade uniforme. A detecção deve, portanto, observar não apenas a existência de uma rota, mas onde e como ela se propaga.
Um evento de subprefixo costuma exercer uma atração mais direta porque a correspondência pelo prefixo mais longo dá prioridade à rota mais estreita. Se uma rede normalmente anuncia um /20 e outra origem anuncia um /24 contido nele, os roteadores que aceitam o /24 geralmente enviam o tráfego desses endereços ao subprefixo. A desagregação também é uma defesa comum: o operador legítimo anuncia rotas de mesma especificidade ou ainda mais específicas para recuperar a preferência. A defesa, porém, encontra um limite rígido, pois muitas redes filtram rotas IPv4 mais longas que /24 e rotas IPv6 mais longas que /48.
Um operador que já anuncia nesses comprimentos pode não ter uma rota mais estreita com aceitação global disponível.
ARTEMIS também considera ocupação indevida de espaço de endereços e violações selecionadas de política, incluindo um padrão de no-export descrito nos materiais do projeto. Essas categorias importam porque incidentes de roteamento não se limitam a um desconhecido originando o prefixo de uma vítima. Uma rota pode ter origem autorizada e ainda ser exportada por uma relação inesperada. Um sistema de monitoramento precisa de contexto de política suficiente para distinguir esses casos sem fingir que os dados de BGP revelam todos os acordos privados entre redes.
ARTEMIS coloca a intenção de roteamento do operador dentro do detector
Serviços externos de monitoramento têm uma vantagem evidente: podem coletar informações de muitas partes da internet sem exigir que cada rede opere um sistema completo. A desvantagem é igualmente importante. Um terceiro pode ver prefixos e caminhos anunciados, mas talvez não saiba quais mudanças de origem, provedores de contingência, caminhos de engenharia de tráfego ou anúncios de emergência o operador considera legítimos. Regras genéricas podem, portanto, não detectar violações sutis de política ou gerar alarmes diante de mudanças planejadas.
ARTEMIS inverteu o ponto de vista. O detector é operado pela organização cujo espaço de endereços está em risco, e essa organização fornece a referência de legitimidade. Coletores públicos ainda oferecem ampla visibilidade externa, mas suas observações são interpretadas por meio do conhecimento privado sobre prefixos protegidos, ASes de origem autorizados, vizinhos aceitáveis e relações de caminho selecionadas. Feeds de roteadores locais podem acrescentar eventos que os coletores públicos não enxergam.
A combinação é a ideia definidora do projeto: evidências globais incompletas tornam-se mais úteis quando comparadas com uma intenção local explícita.
Colocar o detector dentro da rede protegida também transfere a responsabilidade para dentro. Uma rede que mantém ARTEMIS precisa decidir quem é responsável pelo arquivo de políticas, como as mudanças são revisadas, quais alertas chegam ao centro de operações de rede, o que a equipe de segurança pode inferir e quem pode autorizar uma nova rota. O software pode tornar essa responsabilidade visível. Não pode obrigar a instituição a exercê-la bem.
ARTEMIS pede que o operador defina prefixos protegidos, ASes de origem legítimos, relações aceitáveis com vizinhos e regras selecionadas de roteamento. Essa referência permite ao detector formular uma pergunta mais precisa que a de um serviço genérico de monitoramento. Em vez de decidir se uma rota parece incomum em comparação com o histórico global, o sistema pode decidir se ela viola a intenção declarada da rede.
Essa vantagem é tão confiável quanto a declaração. Redes trocam de provedores, acrescentam locais anycast, mudam ASes de origem, estabelecem caminhos temporários de contingência e fazem anúncios de emergência durante indisponibilidades. Uma política correta em janeiro pode estar errada em junho. Se a mudança operacional chegar aos roteadores, mas não ao ARTEMIS, o detector poderá gerar um falso positivo de alta gravidade. Se a política for ampliada sem cuidado para reduzir o ruído, uma violação real poderá tornar-se autorizada no papel.
O sistema transforma, assim, uma configuração técnica em um contrato institucional. Engenharia de roteamento, operações de segurança e gestão de mudanças precisam concordar sobre o significado do arquivo, quem pode editá-lo e com que rapidez ele acompanha a produção. O contexto local do projeto não elimina falsos positivos e falsos negativos; ele transfere sua principal fonte para um lugar que o operador pode governar.
Uma regra de segurança de roteamento merece a mesma disciplina aplicada a software capaz de afetar o tráfego de clientes. As mudanças devem ter responsáveis identificados, revisão, histórico de versões, testes e uma justificativa vinculada a uma alteração de rede aprovada. O operador deve conseguir responder quando um prefixo, uma origem ou um vizinho foi acrescentado, quem o autorizou e qual incidente ou projeto justificou a decisão. Um arquivo simples de configuração pode sustentar esse processo, desde que a organização o trate como algo além de uma etapa única de instalação.
Os testes devem incluir casos positivos e negativos. Uma rota legítima planejada deve passar sem alerta. Um anúncio de prefixo exato vindo de uma origem não autorizada deve acionar a classificação esperada. Um evento de subprefixo deve apresentar a gravidade correta, e uma violação de no-export não deve ser confundida com sequestro de origem. A reprodução de dados históricos pode apoiar essas verificações, enquanto um ambiente de homologação pode confirmar que as notificações e os mecanismos de mitigação recebem os dados pretendidos.
Essa disciplina também limita o perigo da perda de conhecimento institucional. Quando a pessoa que implantou ARTEMIS deixa a organização, a política deve continuar compreensível para o operador seguinte. Um detector cuja lógica depende de memória não documentada não é uma infraestrutura confiável, mesmo que seu código seja aberto e a latência dos feeds seja baixa.
FORTH e CAIDA transformaram uma questão de pesquisa em um fluxo operacional
O projeto surgiu de uma colaboração entre pesquisadores da Foundation for Research and Technology-Hellas, no ecossistema da University of Crete, e a CAIDA, na University of California San Diego. A FORTH contribuiu com trabalhos em segurança de roteamento e sistemas. A CAIDA trouxe infraestrutura de medição da internet, experiência com BGPStream e relações que ajudaram a levar o projeto para redes de pesquisa e educação. O projeto, portanto, nunca foi apenas um algoritmo de detecção; ele reuniu conhecimento de protocolos, sistemas de medição e acesso a operadores.
O financiamento seguiu o mesmo padrão institucional misto. Programas de pesquisa europeus e dos Estados Unidos, apoio do RIPE NCC Community Projects Fund, um projeto de implantação NSF EAGER, o US Department of Homeland Security e o Comcast Innovation Fund aparecem no histórico do projeto. O apoio da RIPE em 2017 ajudou a levar o protótipo em direção a uma ferramenta voltada a operadores, enquanto um prêmio de € 50.000 em 2019 financiou trabalhos de verificação do plano de dados com o RIPE Atlas.
Essas verbas mostram como uma pesquisa de interesse público tornou-se software implantável, mas não revelam o custo atual de manutenção de instalações em produção.
O histórico institucional importa para a atribuição. ARTEMIS não é uma fundação constituída separadamente, um serviço da CAIDA nem um detector global pertencente à FORTH. É um software de código aberto sob a licença BSD 3-Clause, com uma linhagem de pesquisa e um mantenedor comercial atual. O caminho de desenvolvimento do projeto é mais bem compreendido como uma sequência de colaborações, e não como propriedade de uma única organização.
O primeiro marco público foi uma demonstração na ACM SIGCOMM em 2016. Naquele estágio, o passo importante foi conectar monitoramento e mitigação em um único ciclo. Muitos sistemas conseguem identificar uma rota suspeita depois de reunir evidências suficientes. ARTEMIS perguntou se um operador poderia detectar o evento com rapidez suficiente e já ter uma contramedida prática disponível, evitando que o incidente passasse horas transitando entre painéis, e-mails e sessões manuais em roteadores.
Uma demonstração não equivale a uma implantação madura em produção. Ela estabelece que os componentes podem funcionar juntos em uma configuração definida e que o problema de pesquisa é concreto o suficiente para ser demonstrado. Ainda assim, o trabalho de 2016 definiu a direção de tudo o que veio depois: observações em tempo real, uma visão interna do roteamento legítimo, classificação e um anúncio preparado. Essa sequência transformou o tempo de resposta, antes uma consideração organizacional posterior, em uma propriedade do sistema.
O projeto foi orientado por evidências de operadores de que a resposta a sequestros podia levar horas. O atraso não vinha apenas de coletores lentos. As equipes precisavam confirmar a titularidade, examinar a propagação, decidir se o evento era planejado, encontrar os contatos upstream corretos e construir uma mitigação segura. ARTEMIS podia reduzir várias dessas etapas mantendo políticas e fluxos próximos ao sistema de monitoramento, mas as relações humanas e comerciais em torno da rota continuavam fora do código.
O artigo de 2018 na IEEE/ACM Transactions on Networking apresentou a afirmação mais memorável sobre ARTEMIS: neutralizar um sequestro de BGP em menos de um minuto. Os pesquisadores avaliaram a abordagem em experimentos reais e relataram detecção em segundos e mitigação dentro de um minuto nas condições testadas. O resultado foi significativo porque mostrou que uma rede vítima não precisava necessariamente aguardar um serviço de terceiros, uma cadeia de telefonemas e um contra-anúncio montado manualmente.
A frase torna-se enganosa quando separada do experimento. O tempo de detecção depende de o evento alcançar um monitor conectado, da rapidez com que o feed entrega a atualização, de como as regras do detector correspondem ao evento e de o sistema estar saudável. O tempo de mitigação depende do comprimento do prefixo da vítima, da autoridade de roteamento, dos filtros upstream, da propagação e do processo de aprovação escolhido. Uma rede que exige confirmação humana pode tomar uma decisão mais segura e demorar mais. Uma rede que automatiza imediatamente pode responder mais rápido e aceitar um risco maior.
A conclusão responsável é delimitada. ARTEMIS demonstrou que um sistema integrado no lado do operador pode abreviar um processo que frequentemente levava muito mais tempo. Não comprovou que todo sequestro seja visível, que toda rota de reação seja aceita ou que toda equipe de produção deva permitir desagregação autônoma. O resultado deve ser lido como um objetivo de projeto respaldado por um experimento, não como garantia universal.
Várias visões incompletas formam um registro útil do incidente
ARTEMIS pode recorrer a várias fontes públicas porque nenhum coletor enxerga todas as rotas. O RIPE RIS e o projeto RouteViews da University of Oregon recebem atualizações de BGP de pares selecionados em pontos distribuídos de coleta. O CAIDA BGPStream oferece uma estrutura para acessar e normalizar dados de roteamento de diversas fontes. Cada serviço amplia o campo de visão do operador, mas também reflete as redes que escolhem estabelecer peering com seus coletores, os locais dessas sessões e o momento de entrega dos feeds.
Essa visibilidade parcial tem consequências práticas. Um evento pode se propagar para uma região e nunca chegar aos coletores usados por uma implantação. Um anúncio muito curto pode ser retirado antes que o feed o entregue. Uma rota pode afetar clientes da vítima por uma relação privada não representada nos dados públicos. Combinar coletores reduz alguns pontos cegos, mas o resultado é uma amostra maior, não uma cópia onisciente do plano de controle global.
A pergunta operacional correta, portanto, não é “ARTEMIS enxergou a internet?”. É “quais observadores viram este anúncio, com que rapidez e que parte do evento ainda pode estar fora da amostra?”. Essa formulação incentiva os operadores a preservar a procedência de cada alerta e a não tratar a ausência em um feed como prova de que uma rota não existiu.
O RIPE NCC apresentou o protótipo público RIS Live em fevereiro de 2019 para transmitir mensagens de BGP com atraso muito menor que o processamento periódico de arquivos. ARTEMIS tornou-se um dos exemplos de por que esse tipo de feed é importante. Um sistema de segurança não pode responder em segundos se sua principal observação chega muitos minutos depois, e um fluxo em tempo real permite que o detector avalie as atualizações à medida que os coletores as recebem.
A menor latência não altera o que os coletores conseguem observar. O RIS Live ainda reflete os pares conectados ao RIPE Routing Information Service e as rotas exportadas por eles. Se um sequestro permanecer local, for filtrado antes de alcançar um coletor ou afetar um caminho oculto por outra relação, o feed talvez nunca contenha a evidência decisiva. A confiabilidade também importa: uma interrupção do fluxo ou mudança de formato pode parecer silêncio, a menos que o serviço diferencie “nenhuma rota suspeita” de “nenhum dado”.
Por isso, a integridade dos feeds faz parte do modelo de segurança. O operador precisa saber se cada monitor está atualizado, atrasado, desconectado ou produzindo um volume incomum de atualizações. Um detector que apresenta um único status confiante enquanto suas entradas estão degradadas pode criar uma forma de ignorância mais perigosa que uma indisponibilidade explícita.
O monitoramento em tempo real responde ao que está aparecendo agora, enquanto bases de informações de roteamento e arquivos de atualizações oferecem contexto. RIPE RIS e RouteViews publicam dados históricos que podem mostrar quais origens e caminhos eram visíveis antes de um incidente, quando uma mudança começou e por quanto tempo persistiu. O CAIDA BGPStream facilita o processamento desses registros por uma estrutura comum, permitindo que ARTEMIS reproduza eventos e teste regras em relação ao comportamento anterior do roteamento.
A reprodução é útil para engenharia e revisão. Uma equipe pode examinar se uma nova política teria detectado um evento conhecido, reproduzir a sequência que gerou um alerta ou treinar responsáveis sem manipular uma rota ativa de produção. Evidências históricas também podem revelar anúncios recorrentes que parecem anormais isoladamente, mas representam um arranjo de contingência estabelecido. A limitação é que um arquivo preserva a visão dos coletores, não o evento inteiro, e uma topologia passada não pode reproduzir todas as relações atuais.
Uma implantação madura pode usar a reprodução como parte do controle de mudanças. Antes que uma nova origem, upstream ou regra de exportação entre em produção, o operador pode testar a referência revisada diante de um histórico representativo e confirmar que ela não transforma o roteamento normal em um alarme permanente. Essa prática faz da configuração do detector um artefato de segurança auditável, em vez de um arquivo editado apenas depois de gerar ruído.
Dados públicos são apenas um lado do projeto. ARTEMIS pode receber atualizações locais por meio do ExaBGP ou de sessões privadas do BGP Monitoring Protocol. O ExaBGP pode atuar como um emissor BGP programável e encaminhar eventos de rota para outros softwares. O BMP permite que roteadores exportem informações de roteamento a um sistema de monitoramento sem torná-lo parte da decisão de encaminhamento. Essas fontes podem mostrar as adjacências e o estado das rotas da própria rede protegida antes que as informações fiquem visíveis em um coletor público.
Feeds locais melhoram a rapidez e o contexto, mas também introduzem infraestrutura sensível na plataforma. Os dados de BMP podem ser volumosos e expor relações internas de roteamento. A integração com ExaBGP exige controle cuidadoso porque a mesma interface programável pode ser usada para anunciar rotas e para observá-las. Credenciais, alcance de rede, validação de mensagens e separação entre monitoramento e mitigação tornam-se, portanto, fronteiras de segurança.
Uma implantação bem projetada usa feeds públicos e privados para finalidades diferentes. Coletores públicos mostram como um anúncio está se propagando além da vizinhança imediata do operador. Fontes locais mostram o que o operador e seus roteadores viram diretamente. Uma divergência entre eles não é necessariamente um erro; pode ser a evidência necessária para entender onde a propagação parou ou onde uma política entrou em vigor.
A aplicação separa observação, detecção e evidências
A plataforma atual é uma aplicação de microsserviços distribuída em vários contêineres, e não um único script lendo um fluxo. Serviços de monitoramento conectam-se a feeds públicos e privados, normalizam as informações de BGP recebidas e publicam eventos. Serviços de detecção consomem esses eventos e aplicam as regras do operador. Armazenamento, APIs, interface web, notificações e supervisão ficam ao redor desse núcleo. A separação permite que os componentes ganhem escala ou falhem independentemente e facilita a adição de um novo feed sem reescrever toda a aplicação.
A modularidade também multiplica dependências. Um monitor pode estar saudável enquanto o detector está paralisado. O barramento de mensagens pode aceitar eventos enquanto o banco de dados está indisponível. A interface web pode carregar um incidente antigo enquanto o processamento em tempo real está interrompido. A orquestração de contêineres pode reiniciar um serviço e ocultar uma falha recorrente. As operações, portanto, exigem verificações de integridade que descrevam o caminho completo, do feed de origem ao alerta, em vez de informar apenas que contêineres individuais estão em execução.
Docker Compose reduz a barreira para uma implantação controlada, enquanto o suporte a Kubernetes atende organizações que já operam plataformas de contêineres. Nenhum dos métodos transforma o sistema em um serviço global gerenciado. A rede responsável pela implantação continua encarregada de capacidade, atualizações, segredos, armazenamento, backups e acesso durante incidentes.
Um barramento de mensagens permite que serviços de monitoramento, detecção e notificação troquem eventos sem que um único processo controle diretamente todos os outros. O projeto pode absorver picos de atualizações e permitir que consumidores trabalhem em ritmos diferentes. Também cria questões sobre ordenação, duplicação e contrapressão. Um incidente de roteamento pode envolver milhares de atualizações, retiradas e mudanças de caminho; por isso, o sistema precisa preservar sequência e procedência suficientes para que o operador reconstrua o ocorrido.
O armazenamento persistente oferece a ARTEMIS uma vantagem sobre um alarme transitório. Atualizações, alertas, estado da configuração e decisões sobre incidentes podem ser preservados para revisão. A arquitetura do projeto utilizou componentes relacionados ao PostgreSQL, armazenamento no estilo Timescale e o ecossistema de APIs Hasura. Essas escolhas apoiam consultas e integrações, mas também criam um repositório sensível de evidências operacionais e de roteamento, que exige limites de retenção, controle de acesso e backups confiáveis.
Auditabilidade não é o mesmo que certeza. Um registro completo do que o sistema recebeu pode comprovar como ARTEMIS chegou a um alerta. Não pode provar que o sistema recebeu todas as rotas relevantes nem que as regras do operador estavam corretas. O banco de dados deve, portanto, preservar a origem e o grau de confiança, e não apenas um rótulo final de incidente.
A interface web apresenta incidentes, estado do sistema e observações de roteamento em um formato utilizável por uma equipe de operações de rede ou segurança. Notificações podem enviar alertas por e-mail, canal móvel ou integração personalizada, enquanto painéis do Grafana podem mostrar a integridade dos serviços e tendências de eventos. Essas funções transformam um mecanismo de pesquisa em um produto operacional porque a equipe de resposta precisa de priorização, histórico e uma visão comum, e não de atualizações brutas de BGP.
A interface também pode criar confiança indevida. Um cartão vermelho de incidente é uma classificação derivada de observações e regras, não uma constatação independente de intenção maliciosa. Um mapa ou uma visualização de caminhos pode parecer completo mesmo quando representa apenas coletores selecionados. Notificações podem virar ruído quando mudanças planejadas não são refletidas na política, e a fadiga de alertas pode levar a equipe a ignorar o único evento importante.
Uma boa prática operacional mantém a interface ligada à verificação. O responsável deve conseguir examinar as atualizações de origem, comparar feeds públicos e locais, verificar o estado atual do RPKI, executar testes no plano de dados e registrar por que o incidente foi escalado, ignorado ou resolvido. O painel é útil quando encurta esse caminho, não quando o substitui.
Um padrão de rota não comprova motivação nem impacto
A pesquisa de ARTEMIS desenvolveu uma taxonomia que distingue eventos pela relação entre prefixos, manipulação do caminho de AS, política e possível efeito no plano de dados. A implementação admite um subconjunto definido desses padrões com base em evidências do plano de controle, incluindo casos de origem com prefixo exato e subprefixo, ocupação indevida e violações de exportação selecionadas. Uma taxonomia oferece linguagem consistente aos operadores e ajuda o detector a aplicar regras diferentes a eventos distintos.
As categorias precisam permanecer vinculadas ao que os dados mostram. Um caminho que começa com um vizinho inesperado pode indicar um segmento fabricado, um vazamento de rota ou uma mudança autorizada não registrada na política. Uma origem não autorizada pode ser um erro, e não um ataque. Mesmo um anúncio deliberado pode ter como objetivo descartar tráfego, imitar um serviço ou observar tráfego em trânsito; atualizações de BGP, isoladamente, não distinguem esses resultados.
Uma linguagem cuidadosa protege a precisão e a qualidade da resposta. “Suspeita de sequestro” ou “violação de política” costuma ser mais seguro no estágio do alerta do que “ataque”. O termo mais forte pode ser usado depois que a titularidade da rota, os contatos dos operadores e as evidências do plano de dados o sustentarem. Essa cautela não enfraquece a segurança; evita que o sistema de incidentes transforme incerteza em uma alegação que outras equipes possam repetir como fato.
Mensagens de BGP descrevem alegações de alcançabilidade e informações de caminho trocadas entre redes. Elas não mostram cada pacote que segue a rota selecionada. Depois de um anúncio suspeito, o tráfego pode ser descartado, interceptado e encaminhado, respondido por um serviço impostor ou permanecer inalterado porque a rota não se propagou até as redes que transportam os usuários relevantes. Diferentes partes da internet podem experimentar resultados distintos ao mesmo tempo.
Essa fronteira é central para ARTEMIS. O detector pode mostrar que uma rota violou a política do operador e apareceu em pontos de observação identificados. Não pode inferir motivação a partir do caminho de AS nem garantir que um traceroute siga na mesma direção que o tráfego da aplicação. Criptografia, comportamento do DNS, cache, anycast e mecanismos de contingência da aplicação também podem alterar a experiência dos usuários. O alerta do plano de controle é, portanto, evidência de um incidente, não o incidente inteiro.
Uma resposta útil combina vários registros. Evidências de BGP estabelecem o anúncio e sua propagação. Testes no plano de dados examinam a alcançabilidade e os caminhos a partir de locais selecionados. A telemetria do serviço mostra erros, latência e impacto sobre clientes. Contatos upstream esclarecem se a rota foi autorizada ou equivocada. Nenhum desses registros é perfeito, mas juntos sustentam uma decisão que um único feed não consegue oferecer.
O prêmio de 2019 do RIPE Community Projects Fund apoiou uma extensão de ARTEMIS que utilizava medições de traceroute do RIPE Atlas para examinar o efeito dos eventos detectados. O trabalho reconheceu uma limitação do ciclo original do plano de controle. Uma rota pode parecer perigosa no BGP e ter pouco impacto observável, enquanto uma propagação pequena ainda pode afetar uma população valiosa de clientes. Sondas do plano de dados acrescentam evidências sobre para onde o tráfego parece seguir e se os pontos finais continuam alcançáveis.
O RIPE Atlas dispõe de uma rede distribuída de sondas, mas sua distribuição é desigual, e o alvo escolhido pode não responder de forma que revele o caminho. Traceroute pode ser afetado por filtragem, balanceamento de carga, túneis e roteamento assimétrico. O caminho de ida da sonda ao destino não precisa coincidir com o caminho percorrido pelo tráfego dos clientes no sentido oposto. Uma medição que falha pode representar indisponibilidade, um salto que não responde ou uma limitação específica do teste.
O ganho prático não é certeza, mas uma triagem melhor. Se coletores de BGP mostrarem um subprefixo não autorizado e sondas em várias regiões perderem alcançabilidade ou mudarem em direção à origem inesperada, o operador terá evidências mais fortes para escalar o caso. Se o evento do plano de controle estiver visível em apenas um coletor e os testes do plano de dados permanecerem estáveis, a equipe poderá investigar antes de alterar anúncios globais. A decisão continua contextual, mas é menos cega.
A desagregação só recupera o tráfego quando o sistema de roteamento permite
A resposta mais conhecida de ARTEMIS é a desagregação. Uma vítima que anuncia um prefixo amplo pode originar rotas mais específicas para que a seleção normal pelo prefixo mais longo atraia o tráfego de volta à rede legítima. O método utiliza o comportamento existente do BGP e pode se propagar rapidamente, o que o tornou adequado ao objetivo experimental do projeto de responder “em menos de um minuto”. Também mantém a autoridade com a vítima, em vez de exigir a cooperação da origem inesperada antes que o serviço comece a se recuperar.
A desagregação tem limites rígidos. Muitas redes filtram rotas IPv4 mais longas que /24 e rotas IPv6 mais longas que /48 para conter o crescimento das tabelas e abusos operacionais. Uma vítima que já anuncia um /24 ou /48 pode não conseguir produzir uma rota mais específica aceita pela internet em geral. Provedores upstream também podem restringir o que um cliente pode anunciar, e objetos de rota, filtros de prefixos ou dados de RPKI talvez precisem autorizar a mitigação. A propagação não é instantânea nem uniforme, de modo que os caminhos antigos e novos podem coexistir.
Um operador preparado deve conhecer esses limites antes do incidente. Quais prefixos podem ser desagregados? Quais upstreams os aceitarão? Quais filtros de rota e Route Origin Authorisations já cobrem o estado de emergência? Como as rotas serão retiradas depois da recuperação? ARTEMIS pode acionar um mecanismo, mas seu êxito depende de acordos existentes fora da aplicação.
Os materiais do projeto usam a expressão mitigação automática, e a pesquisa inclui um ciclo fechado no qual a detecção pode acionar um contra-anúncio. Descrições operacionais detalhadas também mostram confirmação manual e mecanismos personalizados. As duas situações podem ser corretas porque cada implantação escolhe diferentes níveis de autonomia. A formulação segura é que ARTEMIS admite mitigação automatizada ou autorizada pelo operador por meio de fluxos configuráveis.
O risco é assimétrico. Uma resposta atrasada pode prolongar uma indisponibilidade ou interceptação. Uma resposta automática equivocada pode anunciar rotas mais específicas desnecessárias, violar a política de um upstream, expor pressupostos internos ou criar instabilidade enquanto o evento original ainda está sendo investigado. Uma regra desatualizada de referência pode transformar uma mudança planejada em aparente emergência. Se o mecanismo tiver credenciais amplas de roteador, o comprometimento de ARTEMIS poderá tornar-se um ataque de roteamento por si só.
Uma automação mais segura ocorre em etapas. O sistema pode primeiro enriquecer o alerta, verificar vários feeds, validar o estado do RPKI, executar testes no plano de dados e preparar a mudança exata de rota. Uma pessoa pode aprovar ações de alto impacto, enquanto casos de menor risco podem usar automação baseada em políticas. Limites de frequência, credenciais restritas, simulação, registros de mudança e um caminho testado de reversão importam mais que o rótulo “automático”. O objetivo não é preservar trabalho manual por si só, mas garantir que a velocidade não elimine a responsabilização.
RPKI fortalece uma parte da cadeia de evidências
A Resource Public Key Infrastructure permite que titulares de endereços criem Route Origin Authorisations declarando quais sistemas autônomos podem originar prefixos especificados e quais são seus comprimentos máximos. Roteadores ou sistemas de política podem executar Route Origin Validation e classificar uma rota como válida, inválida ou sem registro. Isso acrescenta evidência criptográfica a uma parte do BGP que, de outra forma, depende de confiança distribuída. É um controle preventivo porque outras redes podem rejeitar ou reduzir a preferência de uma origem não autorizada antes que o tráfego a siga.
ARTEMIS atua em outra camada do incidente. Pode usar o estado de validação do RPKI como evidência, mas também compara rotas com regras privadas do operador, registra o evento, combina feeds públicos e locais e conecta detecção a resposta. O RPKI não valida todo o caminho de AS, e sua política de implantação não é universal. Uma rota pode ser válida em RPKI e ainda violar uma relação esperada com um vizinho ou vazar por um caminho não pretendido pelo operador. Uma rota pode ser inválida porque uma mudança operacional legítima não foi refletida na ROA.
Os sistemas são, portanto, complementares. O RPKI pode reduzir o número de rotas com origem não autorizada aceitas pela internet em geral. ARTEMIS pode mostrar à vítima o que está sendo observado, detectar padrões selecionados além da simples validade da origem e organizar a resposta. Futuros mecanismos de autorização de caminhos, como ASPA, podem fortalecer as evidências sobre relações, mas não eliminarão a necessidade de monitorar o que as redes realmente anunciam e como os incidentes afetam os serviços.
Projetos-piloto levaram ARTEMIS além do laboratório sem comprovar escala de mercado
A CAIDA relatou uma implantação experimental de ARTEMIS apoiada pela NSF com Internet2, Great Plains Network e Merit durante 2018–2019. Esses projetos-piloto importaram porque redes de pesquisa e educação têm prefixos, upstreams, processos de mudança e obrigações de serviço reais. Os operadores puderam testar se o software se encaixava no monitoramento existente, se as regras representavam sua intenção de roteamento e como os alertas entrariam na resposta a incidentes.
O registro é confiável, mas delimitado. Um projeto-piloto pode comprovar instalação, retorno de engenharia e determinado uso operacional. Não comprova cobertura contínua em produção, estado atual da versão nem desempenho em todos os tipos de rede. O site do projeto também publica declarações de engenheiros associados a AMS-IX, Internet2 e ESnet e exibe logotipos de organizações. Essas referências indicam testes ou uso, mas não devem ser convertidas na alegação de que toda organização citada seja cliente pagante atual ou de que o projeto tenha participação global conhecida.
Essa distinção importa porque implantações de software de segurança de roteamento muitas vezes são invisíveis. Um operador pode executar uma versão interna, usar o monitoramento sem mitigação ou encerrar o uso após um teste. A ausência de um censo completo não torna o projeto irrelevante, mas impede uma afirmação precisa sobre adoção. Casos identificados são evidências mais fortes que um número elevado sem sustentação.
O controle do operador traz uma carga de integração e cadeia de suprimentos de software
ARTEMIS é distribuído sob a licença BSD 3-Clause. Um operador pode inspecionar o código, executá-lo em infraestrutura controlada, adaptar integrações e evitar o envio de políticas sensíveis a um único provedor central obrigatório. Esse modelo combina com a principal vantagem do projeto porque a referência mais valiosa pertence à própria rede. Também permite uso comercial e versões derivadas, possibilitando que Code BGP e outras partes construam serviços sobre a base aberta.
O controle traz trabalho. A plataforma inclui contêineres, barramento de mensagens, bancos de dados, APIs, aplicação web, sistemas de notificação e integrações com feeds. Cada componente exige correções, credenciais, segmentação de rede, backups e monitoramento. O sistema armazena políticas sensíveis de roteamento e pode guardar credenciais capazes de influenciar anúncios. Uma implantação em produção tem, portanto, uma superfície de segurança muito maior que a do algoritmo original de detecção.
A licença aberta oferece ao operador uma saída em relação a um mantenedor, não uma organização automática de suporte. Alguém ainda precisa testar atualizações, revisar dependências e compreender o código quando um feed ou uma interface de roteador muda. Para redes menores, uma ferramenta de alerta mais simples ou um serviço comercial gerenciado pode ser mais fácil de operar, ainda que ofereça menos controle local.
Um serviço ARTEMIS em produção precisa continuar disponível durante a mesma instabilidade de rede que leva os operadores a precisar dele. Conexões de feeds, barramento de mensagens, banco de dados, API, interface, canal de notificação e camada de autenticação formam uma única cadeia de serviço. Redundância no nível dos contêineres ajuda somente quando estado, armazenamento e dependências externas também são projetados para falhas. Um monitor reiniciado não consegue recuperar atualizações que nunca foram preservadas, e uma interface replicada não pode exibir um incidente que o processo de detecção deixou de processar.
O projeto operacional deve, portanto, incluir modos explícitos de degradação. Quando um feed público desaparece, o sistema deve informar que a cobertura diminuiu, em vez de continuar exibindo um status saudável sem distinções. Quando o banco de dados fica indisponível, o detector pode precisar preservar eventos localmente ou interromper a mitigação porque as evidências de auditoria não podem ser gravadas. Quando o provedor de identidade falha, o acesso de emergência deve ser possível sem deixar uma conta permanente sem controle.
Essas escolhas não são descritas pela taxonomia de sequestros, mas determinam se a ideia de pesquisa se transforma em infraestrutura confiável.
A plataforma também precisa de seu próprio orçamento de desempenho. Uma explosão de atualizações legítimas durante uma grande mudança de roteamento pode pressionar monitores e armazenamento mais que um único sequestro. Filas internas não devem transformar um feed quase em tempo real em um incidente atrasado sem tornar o atraso visível. Testes de capacidade, retenção no banco de dados e contrapressão do barramento fazem parte do planejamento da implantação pelo mesmo motivo que filtros de rota e comprimentos de prefixos: eles delimitam a resposta que o sistema pode prometer honestamente.
ARTEMIS reúne software web, imagens de contêiner, banco de dados, componentes de mensagens, APIs, autenticação e bibliotecas de rede. Essa arquitetura torna o projeto extensível, mas cada dependência representa uma possível vulnerabilidade ou ponto de falha. Uma falha na interface pode expor políticas de roteamento. Uma imagem comprometida pode alterar alertas. Um token de API permissivo pode revelar incidentes, enquanto uma credencial associada ao mecanismo de mitigação pode permitir mudanças de rota. A segurança do detector é, portanto, inseparável da segurança do software usado para operá-lo.
O código aberto ajuda porque os operadores podem inspecionar componentes, fixar versões e criar suas próprias imagens. Não garante que alguém tenha revisado cada dependência transitiva nem que uma vulnerabilidade pública seja corrigida no prazo exigido por uma rede. Uma equipe de produção precisa de um inventário de imagens e bibliotecas, um processo para reconstruí-las, separação entre monitoramento somente para leitura e mitigação com capacidade de escrita, além de uma forma de testar atualizações de segurança sem perder o histórico de incidentes.
Esse requisito muda a forma de avaliar a manutenção do projeto. Um novo recurso de detecção pode receber mais atenção que uma atualização de banco de dados ou correção de autenticação, embora esta última possa ser mais importante para a integridade do serviço. Avisos de segurança, compilações reproduzíveis, atualizações de dependências e uma linha de versões com suporte são evidências de maturidade operacional, mesmo quando não acrescentam uma opção visível ao painel.
Lançamentos e Code BGP definem o teste atual de manutenção
A versão formal mais recente identificada no conjunto de pesquisa é a 2.3.0, chamada Cadmus, datada de 24 de novembro de 2022. Na data-limite de 5 de agosto de 2026, a demonstração em funcionamento exibia uma compilação posterior baseada em commits, e o site atual do projeto permanecia ativo. Esses fatos sustentam a conclusão de que o trabalho continuou depois do último lançamento formal, mas também criam uma questão legítima para produção: qual versão é testada, recebe suporte e é adequada para atualização?
Atividade de commits e uma demonstração funcional mostram desenvolvimento. Um lançamento semântico oferece outra forma de garantia: uma base identificada, notas de versão, expectativas sobre dependências e um ponto de referência para testes dos operadores. Um projeto pode estar ativo enquanto seu processo formal de lançamentos fica atrasado, e uma demonstração atual pode executar código que nenhum operador de produção deveria adotar sem revisão.
Para uma infraestrutura de segurança de roteamento, a disciplina de lançamentos faz parte do modelo de segurança. Os operadores precisam saber quais ramificações recebem correções, como as migrações são tratadas e se dependências antigas continuam expostas. Uma nova versão identificada não comprovaria confiabilidade universal, mas uma política publicada de suporte e segurança reduziria mais a incerteza que apenas um site atualizado.
O site do projeto identifica Code BGP como o mantenedor atual de ARTEMIS e descreve a empresa como uma startup derivada do projeto. A comercialização pode resolver um problema real do código aberto. Software de segurança de roteamento precisa de pessoas que mantenham integrações, respondam a vulnerabilidades, apoiem implantações e transformem recursos de pesquisa em operações confiáveis depois do fim dos financiamentos originais.
Code BGP é, no entanto, uma empresa comercial separada, com contexto mais amplo de produtos e clientes. Ela não deve ser usada como sinônimo de FORTH, CAIDA ou de toda implantação do software aberto. As evidências públicas do conjunto não revelam a receita, a avaliação, a lista de clientes da empresa nem a fronteira exata entre recursos comunitários e capacidades comerciais. Essa ausência não é uma crítica; é um limite para o que um perfil pode afirmar.
A relação cria dois incentivos que podem se alinhar ou divergir. O projeto aberto se beneficia quando a equipe comercial contribui com código testado e documentação. A empresa se beneficia quando o projeto aberto constrói confiança, adoção e uma base técnica para serviços pagos. O teste de longo prazo é saber se lançamentos, correções de segurança e decisões sobre o roteiro permanecem suficientemente visíveis para operadores que não são clientes comerciais.
Uma licença permissiva garante que o código-fonte possa ser copiado, modificado e comercializado. Não garante que outra equipe consiga compreender a arquitetura, reproduzir um lançamento ou assumir a manutenção quando os especialistas atuais saírem. A continuidade de longo prazo depende de documentação, testes, histórico de problemas, conhecimento das dependências e um caminho de contribuição que vá além das pessoas que construíram o sistema de pesquisa original.
A gestão da Code BGP pode fortalecer essa continuidade ao manter engenheiros experientes vinculados à plataforma. Também pode concentrar o conhecimento prático dentro de uma organização comercial, mesmo com o repositório público. A distinção pode ser observada em notas de versões, discussões públicas de projeto, respostas a relatos da comunidade e na disponibilidade de informações suficientes para que implantações não comerciais operem com segurança.
O objetivo não é impedir valor comercial. Uma relação saudável de núcleo aberto pode alinhar suporte pago e manutenção pública. O risco surge quando o projeto aberto se torna uma demonstração histórica enquanto o caminho operacional migra para componentes privados sem documentação. A portabilidade deve, portanto, ser testada na prática: um operador independente consegue instalar, atualizar, auditar e recuperar o sistema usando o registro público disponível naquele momento?
ARTEMIS ocupa uma posição intermediária exigente na segurança de roteamento
O campo da segurança de roteamento inclui coletores públicos, sistemas acadêmicos de inferência, ferramentas abertas de alerta, validadores de RPKI e plataformas comerciais de monitoramento. RIPE RIS, RouteViews e BGPStream fornecem dados, não um fluxo de incidentes específico para o operador. BGPalerter oferece outro modelo aberto de monitoramento. MANRS estabelece normas operacionais, mas não detecta eventos em tempo real. Serviços comerciais podem fornecer monitoramento amplo e apoio de analistas, embora possam não ter contexto local privado sem integração pelo cliente.
A posição distintiva de ARTEMIS está na combinação de controle pelo operador, referência explícita de legitimidade, vários feeds públicos e locais, código aberto e mitigação opcional. Essa posição também é exigente. Uma rede precisa ter conhecimento de roteamento, manter políticas e operar uma plataforma com vários serviços. O projeto pode ser mais adequado a organizações que consideram a segurança de roteamento uma capacidade central, e não uma assinatura de painel.
A comparação não deve ser reduzida a uma tabela de recursos. Modelos diferentes colocam confiança e trabalho em lugares distintos. Um serviço gerenciado centraliza conhecimento e observação. Um sistema operado internamente mantém política e ação mais próximas da rede. A questão relevante é qual parte consegue enxergar o suficiente, agir com segurança e continuar responsável quando as evidências são incompletas.
ARTEMIS Lite apareceu em materiais da comunidade RIPE em 2023 como uma abordagem relacionada e mais leve, destinada a reduzir parte da carga de implantação. A existência de uma variante Lite evidencia que a abrangência da plataforma completa pode ser difícil para equipes menores. Uma estrutura com vários contêineres, armazenamento persistente, diversos feeds e mitigação personalizada pode ser adequada a um grande operador e excessiva para uma rede que primeiro precisa de visibilidade clara e alertas confiáveis.
Um sistema mais leve não deve ser descrito como equivalente apenas porque compartilha o nome e a finalidade. O conjunto de pesquisa caracteriza ARTEMIS Lite como tendo funcionalidade reduzida, e as alegações de apresentações precisam de confirmação independente. A compensação relevante ocorre entre menor custo operacional e o contexto, as integrações, o histórico ou os mecanismos de resposta que podem estar ausentes. Uma implantação menor ainda pode ser valiosa se definir essas fronteiras honestamente.
A adoção depende da quantidade de estrutura institucional exigida pela ferramenta. Um projeto pode ser tecnicamente aberto e continuar inacessível a operadores sem especialistas em contêineres, bancos de dados e segurança de roteamento. Empacotamento, padrões sensatos e um caminho gradual do monitoramento à detecção e à mitigação podem determinar se a arquitetura se difundirá mais amplamente que outro artigo acadêmico.
O verdadeiro produto é um ciclo de resposta governado
ARTEMIS não torna o BGP confiável em uma única etapa. Ele cria um ciclo ao redor de um protocolo desenvolvido sem autorização completa. O operador declara o roteamento pretendido. Feeds públicos e locais mostram parte do roteamento observado. O detector identifica divergências. Armazenamento e interfaces organizam as evidências. Pessoas ou uma automação aprovada escolhem uma resposta, e os feeds mostram então se a propagação mudou. O incidente pode ser resolvido, ignorado, retirado, escalado ou deixado inativo com uma justificativa registrada.
Esse ciclo é a contribuição mais duradoura do projeto. Ele reconhece que a segurança de roteamento não é um certificado emitido uma única vez nem um alarme distante. É uma prática operacional em que a política precisa ser explícita, as observações precisam preservar a procedência e a autoridade de resposta deve estar preparada antes de uma emergência. O valor do sistema está em reduzir a incerteza com rapidez suficiente para que a rede aja, não em fingir que a incerteza desapareceu.
Os limites são igualmente instrutivos. Os coletores de rotas são parciais. A referência de legitimidade pode estar desatualizada. Evidências do plano de controle não comprovam motivação nem todos os resultados para o tráfego. Uma mitigação tecnicamente válida pode ser filtrada ou causar danos. Código aberto ainda exige manutenção contínua. ARTEMIS é mais forte quando esses limites são incorporados ao fluxo de trabalho, em vez de ocultados pela manchete de uma resposta em um minuto.
Uma anomalia de BGP pode chegar a um centro de operações de rede, a um centro de operações de segurança ou a ambos. A equipe de roteamento entende prefixos, políticas upstream e os riscos de alterar anúncios. A equipe de segurança pode estar mais preparada para correlacionar identidade, telemetria de serviços e possível atividade maliciosa. ARTEMIS atravessa esses domínios, o que só é útil se o alerta trouxer evidências suficientes para que cada equipe trabalhe a partir do mesmo evento, em vez de abrir investigações separadas com pressupostos diferentes.
A transferência do caso deve distinguir observação, política e impacto. O sistema observou uma rota em feeds identificados. A rota violou uma regra específica de referência. Verificações de serviço ou sondas do RIPE Atlas mostraram um efeito definido, ou nenhum efeito foi estabelecido até o momento. O operador entrou em contato com um upstream ou com a origem da rota, e a resposta ainda está pendente. Essa estrutura evita que o centro de operações de rede descarte uma preocupação de segurança como roteamento comum e impede que o centro de segurança classifique um anúncio não autorizado como ataque antes de conhecer os fatos operacionais.
Uma linguagem compartilhada também melhora o aprendizado após o incidente. Um caso pode ser encerrado como mudança planejada omitida da política, vazamento acidental de rota, suspeita de sequestro, evento malicioso confirmado ou anomalia não resolvida. Esses resultados devem retroalimentar regras, procedimentos e acordos upstream. Sem esse ciclo, o detector pode se tornar uma máquina de produzir chamados, e não um sistema para melhorar o controle do roteamento.
O alerta mais rápido nem sempre é o mais útil. Um detector pode disparar na primeira atualização inesperada e deixar o responsável descobrir depois que o feed estava desatualizado, a rota era planejada ou a suposta vítima autorizou uma nova origem. Por outro lado, esperar por todos os coletores e testes do plano de dados pode sacrificar a vantagem da resposta antecipada. ARTEMIS precisa de uma medida situada entre a latência bruta da detecção e o encerramento final do incidente: o tempo necessário para reunir evidências confiáveis suficientes para que o operador autorizado tome uma decisão defensável.
Essa medida pode ser decomposta. Com que rapidez chegou a primeira observação? Quantos feeds independentes a confirmaram? A política relevante estava atualizada? RPKI ou BMP local acrescentaram evidências? Quanto tempo levaram as verificações de serviço? Quando a pessoa responsável recebeu o alerta e quando uma resposta foi aprovada? A mitigação alcançou a propagação pretendida e foi retirada corretamente? Essas perguntas revelam onde o atraso realmente ocorre, em vez de atribuir todo o resultado ao algoritmo de detecção.
Uma métrica de decisão confiável também desestimula otimizações perigosas. O sistema não deve ser recompensado por agir mais rápido quando age com menos evidências ou cria mudanças de roteamento desnecessárias. A melhor implantação é aquela que reduz simultaneamente a incerteza e o tempo de resposta, preservando um registro que possa ser revisado depois do incidente.
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance