
Resumo
- Argonne Network é um objeto atual do diretório da BTW associado a uma função real de administração de rede. Os registros da ARIN identificam o Argonne National Laboratory como registrante do AS683 e AS75 e apontam a Argonne Network Administration como grupo de contato técnico; isso não estabelece uma empresa jurídica separada.
- Os registros de registro estabelecem identidade responsável por número-recurso, enquanto as observações públicas de roteamento mostram visões delimitadas do comportamento em execução. Nenhum é um mapa de topologia privada, um resultado de nível de serviço ou prova de controle exclusivo de rota.
- Material oficial de infraestrutura e da ESnet descreve uma superfície real de tráfego de pesquisa cobrindo instrumentos, armazenamento, computação, identidade, rede de campus, provedores externos e colaboradores remotos. As descrições de capacidade e os casos de projeto não comprovam confiabilidade universal nem resultados de usuários.
- Supervisão, integração, manutenção, portabilidade e resposta a exceções continuam a ser custos recorrentes, porque registros, rotas, infraestrutura, operadores externos e fluxos de pesquisa precisam permanecer alinhados diante de mudanças e falhas.
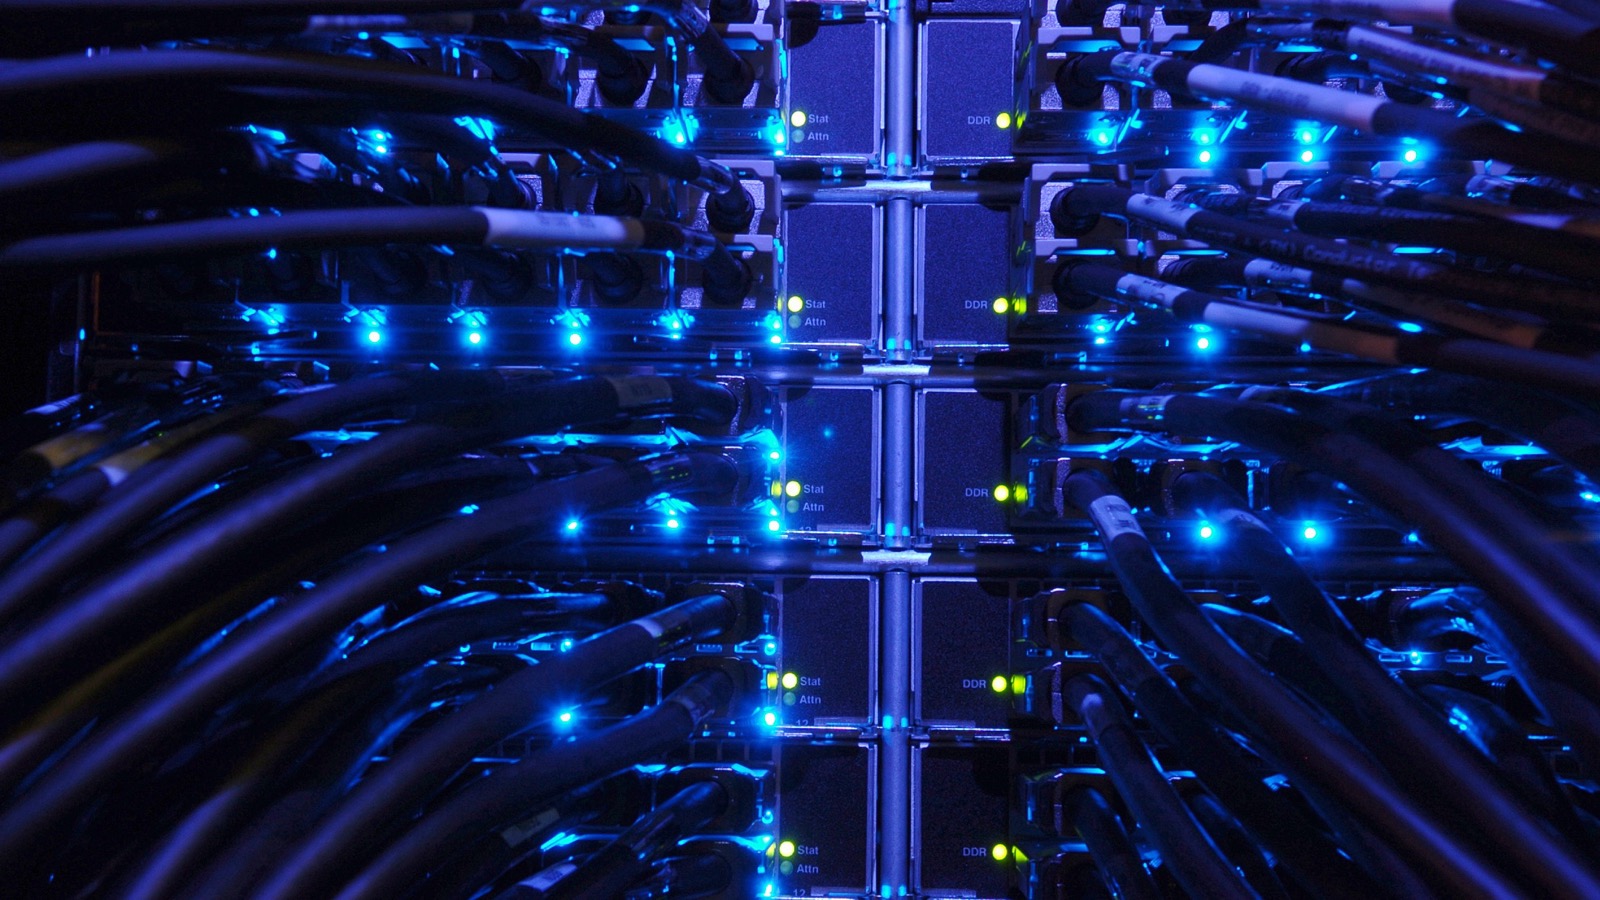
Observação da imagem:A fotografia em Creative Commons mostra equipamentos de computação no Center for Nanoscale Materials do Argonne National Laboratory. Não mostra a Argonne Network Administration, o roteamento do AS683 ou AS75, o backbone do campus, enlaces ESnet ou MREN, topologia privada, controles atuais, incidentes, confiabilidade medida ou resultados de usuários.
Argonne Network aparece no diretório da BTW como objeto de empresa, mas a evidência pública mais útil não sustenta tratar esse rótulo como operador comercial autônomo. O American Registry for Internet Numbers registra o Argonne National Laboratory como registrante para AS683 e AS75. Os mesmos registros identificam a Argonne Network Administration como grupo de contato técnico.[1][2] Essa distinção é o ponto de partida para uma análise responsável.
Ela vincula o objeto do diretório a uma função real de controle de rede sem inventar uma empresa jurídica separada, uma arquitetura privada ou um portfólio de serviços que o registro público não divulga.
Os dois números de sistema autônomo criam uma superfície tecnológica concreta. Registros de registro estabelecem identidades atribuídas e contatos responsáveis. Serviços públicos de observação de roteamento mostram o que coletores externos conseguem ver em uma janela temporal delimitada. Argonne e suas instalações descrevem armazenamento, infraestrutura local e de ampla área, movimentação de dados, controles de acesso, investimento de campus e fluxos de pesquisa.
A Energy Sciences Network do Department of Energy descreve seu próprio papel e publica relatórios e estudos de caso que situam Argonne em um contexto mais amplo de rede de pesquisa.[3][4][5][6][7][8][9][10][11][12][13][14][15][16][17][18][19][20][21][22][23][24][25]
Em conjunto, essas fontes revelam um problema de controle, não uma narrativa simples de produto. Instrumentos científicos, sistemas de alto desempenho, armazenamento compartilhado, redes externas de pesquisa, sistemas de identidade, controles de segurança e fluxos operados por usuário precisam trocar dados por várias fronteiras administrativas. A rede deve preservar identidade de endereço e roteamento enquanto equipamentos, aplicações, provedores e demandas de pesquisa mudam. Uma rota pública pode ser visível enquanto uma transferência permanece lenta.
Uma instalação pode anunciar capacidades robustas enquanto um fluxo de trabalho individual ainda falha. Uma demonstração bem-sucedida pode provar que um desenho funciona sem provar confiabilidade contínua para todos.
Este artigo, portanto, separa três camadas ao longo de toda a análise:
- Capacidade do sistemasignifica que um componente ou protocolo documentado pode executar uma função definida, como originar rota, mover dados, expor armazenamento, autenticar usuário ou medir caminho.
- Confiabilidade operacionalsignifica que essa função permanece disponível, precisa, segura, observável e recuperável sob condições reais de manutenção e falha.
- Resultado de usuário ou pesquisasignifica que uma carga de trabalho identificada produziu resultado medido em período definido, com contexto suficiente para separar efeitos de rede de efeitos de armazenamento, software, instrumento e fluxo.
O registro público é suficiente para examinar capacidade e custo de operação. Ele contém vários exemplos de projeto delimitados. Não fornece um benchmark de disponibilidade em toda a frota, um histórico completo de incidentes, um mapa privado de topologia ou comparação controlada de resultados de usuários. Esses limites não são lacunas a preencher com suposições; definem o que pode e não pode ser concluído.
Fronteira da entidade: rótulo de diretório, um laboratório e uma função operacional
Os registros da ARIN para AS683 e AS75 oferecem os pilares mais fortes de identidade.[1][2] Em ambos, o Argonne National Laboratory é o registrante. A Argonne Network Administration aparece como grupo de contato técnico. Uma entrada de registro é um registro de administração de número-recurso e responsabilidade de contato. Não é uma carta constitutiva, um diagrama de arquitetura, um contrato de nível de serviço nem prova de que toda rota observada sob um ASN seja operada exclusivamente por uma única equipe.
Essa fronteira importa porque nomes podem fundir coisas diferentes. "Argonne Network" pode se referir informalmente à infraestrutura, a uma função administrativa, a um grupo técnico ou ao objeto do diretório da BTW. "Argonne National Laboratory" é a instituição nomeada no registro. Instalações individuais, como o Argonne Leadership Computing Facility, o Advanced Photon Source e o Laboratory Computing Resource Center, publicam sua própria documentação de operação. A ESnet é um operador DOE separado. Tratar tudo isso como um único produto ocultaria as transições que fazem o sistema funcionar.
Uma análise precisa de objeto de empresa pergunta o que a entidade do diretório pode representar validamente. Aqui ela representa a superfície de controle de administração de rede associada às identidades de ASN registradas de Argonne. Essa superfície inclui manter dados de contato e registro precisos, coordenar mudanças de roteamento, apoiar conectividade entre campus e redes externas e participar de continuidade e incidentes. Documentos de instalações mostram por que essas responsabilidades importam.
Eles não mostram que a Argonne Network Administration possui diretamente cada switch, sistema de armazenamento, aplicação de identidade ou circuito externo descrito nesses documentos.
Essa distinção também evita uma narrativa de cliente simplificada. Pesquisadores usando uma instalação não são necessariamente clientes de um produto autônomo Argonne Network. Podem ser usuários de uma instalação do DOE, membros de projeto, colaboradores ou equipe interna. Seus fluxos dependem de serviços de rede, mas seus resultados também dependem de instrumentos, armazenamento, alocações de computação, software, credenciais, política de dados e parceiros externos. A rede é uma camada necessária em muitos casos; necessidade não é sinônimo de causalidade única.
Essa leitura baseada em função é mais útil que um perfil de marca amplo. Ela direciona atenção para registros, sistemas em execução, transições e recuperação. Um ASN só ganha significado operacional quando dados de registro, origem de rota, conectividade upstream, monitoramento, acesso e autoridade de resposta continuam alinhados. Um nome de grupo em registro só ajuda em incidente se o caminho de contato estiver atual e os destinatários puderem agir. O valor está na continuidade entre o papel registrado e a rede em operação.
O que AS683 e AS75 estabelecem, e o que não estabelecem
Um número de sistema autônomo identifica um domínio de roteamento para roteamento interdomínios. Os registros RDAP da ARIN mostram que AS683 e AS75 são registros ativos associados ao Argonne National Laboratory.[1][2] As APIs públicas da RIPEstat fornecem observações externas com janela temporal para os dois recursos, incluindo rótulos gerais, observações de prefixos anunciados e dados de estado de roteamento.[3][4][5][6][7][8] Essas duas classes de evidência têm propósitos diferentes.
O registro é o inventário responsável. Ele identifica o recurso atribuído, registrante, status e papéis de contato. Não é um monitor de rota em tempo real. Um registro correto não prova que qualquer prefixo seja alcançável no momento, que a origem pretendida esteja visível globalmente ou que o tráfego siga determinado caminho. Da mesma forma, um coletor de rota pode observar uma rota, mas isso não prova atribuição legal ou autoridade. Registro e observação devem concordar onde seus escopos se sobrepõem, mas nenhum substitui o outro.
As observações da RIPEstat são recortes. Elas podem mostrar prefixos observados como originados por um ASN no momento da coleta e fornecem visão de estado de roteamento com limite temporal.[5][6][7][8] Não conseguem estabelecer controle exclusivo de cada prefixo, visibilidade global completa, continuidade histórica, topologia interna, volume de tráfego ou qualidade de serviço. Cobertura do coletor, política de roteamento, mudanças transitórias e momento da observação afetam o que um serviço externo relata.
A presença de dois ASNs é operacionalmente relevante, mas não revela por que a instituição mantém ambos. Os registros públicos não provam que os números correspondem a instalações, gerações, políticas, provedores ou domínios de redundância distintos. Eles criam dois conjuntos de objetos que precisam permanecer precisos e sustentáveis. Cada um pode ter políticas de rota distintas, histórico de contato distinto, prefixos observados distintos e requisitos de recuperação distintos.
Para um operador, a gestão dual-AS cria pelo menos quatro tarefas recorrentes. Primeiro, registros e contatos precisam permanecer atualizados. Segundo, origem de rota pretendida e observações externas devem ser conciliadas. Terceiro, mudanças precisam ser autorizadas e aplicadas em etapas sem confundir um recurso com outro. Quarto, equipes de resposta a incidentes precisam de método confiável para decidir se um sintoma é específico de um ASN, compartilhado por ambos ou fora do controle da Argonne.
O ativo crítico não é o número isoladamente. É a cadeia de autoridade e configuração operacional ao redor dele. Essa cadeia inclui acesso de registro, política de roteamento, inventário de prefixos, relacionamentos upstream e de peering, monitoramento, filtros, metadados de segurança, escalonamento de contatos e evidência de recuperação. Fontes públicas mostram partes dessa cadeia. Não divulgam implementação completa.
Tráfego de pesquisa é uma cadeia de handoffs
O Argonne Leadership Computing Facility descreve armazenamento e rede como recursos interconectados em vez de produtos isolados.[9] Seu material público discute sistemas de armazenamento, infraestrutura local, conectividade de ampla área, e vínculos com redes de pesquisa externas.
A orientação separada da ALCF atribui aos usuários responsabilidades de retenção de dados, transferência e compartilhamento.[10] A página de compartilhamento de dados da instalação descreve serviços e mecanismos para expor ou mover dados além de um único job de computação.[11] Esses documentos sustentam uma conclusão clara: o movimento útil de dados de pesquisa atravessa fronteiras de armazenamento, rede, identidade e aplicação.
Essa conclusão não deve ser esticada para uma alegação de disponibilidade. Uma página de instalação descreve a arquitetura pretendida e classes de serviço disponíveis. Ela não relata todos os eventos de manutenção, período de congestionamento, transferência falha ou problema de configuração de usuário. Valores de capacidade, quando informados, descrevem interfaces ou sistemas específicos, não garantia fim a fim. Um caminho é limitado pelo elo mais estreito ou mais degradado, que pode estar fora da instalação.
A política de dados da ALCF acrescenta outra fronteira.[12] O ambiente é descrito como uma rede de pesquisa aberta com expectativas definidas de tratamento de dados. Essa política afeta quais controles técnicos são apropriados. Uma rede de pesquisa otimizada para fluxos científicos grandes tem hipóteses diferentes de uma rede de pagamentos, de sistema classificado ou de escritório corporativo geral. Segurança não pode ser avaliada por cópia de controles de outro contexto; ela deve proteger o fluxo e os dados reais preservando uso científico legítimo.
O Laboratory Computing Resource Center publica orientação de cibersegurança para sua infraestrutura compartilhada.[13] A orientação descreve autenticação selecionada e responsabilidades do usuário. Esses controles são capacidades e compromissos de política. Eles não provam que credenciais nunca são comprometidas ou que todos os usuários seguem a política. A confiabilidade depende de fiscalização, monitoramento, suporte, tratamento de exceções e recuperação quando o caminho de controle normal falha.
O Advanced Photon Source define em sua missão de tecnologia da informação responsabilidades de rede, firewall, acesso, servidor, backup e suporte.[14] Isso é importante porque um fluxo de instrumento moderno não é apenas ligação entre duas máquinas. Envolve aquisição de dados, redes de controle, acesso de usuário, armazenamento, serviços de computação e equipes de suporte. Uma missão estabelece escopo e intenção. Não é relatório de serviço medido.
O padrão recorrente é uma cadeia:
- Um instrumento ou usuário cria dados.
- Sistemas locais fazem buffer, nomeação e proteção desses dados.
- Controles de identidade e política decidem quem ou o que pode movê-los.
- Redes de campus os levam entre instalações ou até um ponto de borda externo.
- Redes de pesquisa e redes parceiras os levam entre domínios administrativos.
- Serviços de armazenamento e computação os recebem e processam.
- Aplicações, motores de workflow e pessoas decidem o que acontece em seguida.
Cada transição é ao mesmo tempo ponto de integração e limite de falha. A rede pode entregar pacotes enquanto uma conta de serviço está inválida. O armazenamento pode aceitar dados enquanto metadados estão errados. Um caminho pode ter capacidade nominal suficiente enquanto host, protocolo ou configuração de workflow limita throughput. Uma transferência pode terminar enquanto o dado resultante fica inutilizável. Por isso capacidade de rede, confiabilidade operacional e resultado de pesquisa devem permanecer separados.
Infraestrutura de campus, provedores externos e continuidade
Os guias de projeto das instalações da Argonne documentam governança e padrões técnicos para edifícios e infraestrutura, incluindo comunicação e cabeamento.[15] Um padrão cria linguagem de projeto comum e ponto de revisão. Ele pode reduzir instalações incompatíveis e tornar manutenção mais previsível. Não prova que cada componente instalado foi atualizado, documentado ou testado recentemente.
O plano de instalações e infraestrutura de 2024 da instituição descreve fibra de campus, redundância de core network, data centers e investimento planejado.[16] Planos são evidência útil de necessidades identificadas, sequência e controles pretendidos. Devem ser lidos temporalmente. Uma melhoria proposta ou financiada não é o mesmo que uma implantação concluída. Uma meta de redundância não prova que todos os domínios de falha sejam independentes.
O relatório de requisitos de rede da DOE para o Basic Energy Sciences fornece contexto externo específico.[22] Ele descreve, na data do relatório, a arquitetura do Argonne no campus e na ampla área, incluindo provedores externos, capacidades de conexão, nós redundantes e caminhos diversos. Esse relatório é útil porque mostra como o tráfego da instituição ultrapassa uma única borda de campus. Não é uma auditoria de disponibilidade atual, e a arquitetura pode mudar após a publicação.
A própria descrição da ESnet estabelece que ela é uma rede de pesquisa DOE que atende colaboração científica.[21] Esse papel não deve ser atribuído à Argonne. A Argonne depende de operadores externos e parceiros, enquanto esses operadores atendem muitas instituições. A responsabilidade está distribuída. Uma equipe Argonne pode controlar uma rota de campus e coordenar uma mudança externa sem controlar todo domínio intermediário.
Essa responsabilidade distribuída cria um problema de continuidade. Um serviço pode falhar por causa de fibra local, política de roteamento, circuito upstream, instituição remota, host, armazenamento, autenticação, middleware ou comportamento de aplicação. Um modelo operacional útil precisa de evidência compartilhada suficiente para estreitar a causa sem exigir que toda organização exponha sua rede privada.
Medida de caminho é uma forma de construir essa evidência compartilhada. O estudo de caso da ESnet sobre transferência de dados entre Argonne e University of Michigan descreve diagnóstico multicamadas usando ferramentas como perfSONAR e uma conexão recente.[24] O caso mostra que desempenho observado pode depender de várias camadas e que o diagnóstico pode exigir mudanças coordenadas. Ele é um caso delimitado, não benchmark de desempenho de frota.
Documentos históricos mostram que esse problema não é novo. Um relatório de requisitos de rede de 2007 registrou base anterior para conectividade e demanda científica da Argonne.[25] A ESnet também registra experimentos históricos de rede definida por software envolvendo banda prioritária.[23] Essas fontes demonstram pressão contínua para conectar instrumentos, instalações e colaboradores remotos. Não estabelecem topologia atual ou comportamento operacional de produção.
Portanto, continuidade exige mais que redundância de link. Exige registros atuais, política de roteamento, caminhos físicos diversos quando justificado, observação independente, escalonamento testado, credenciais utilizáveis, configurações recuperáveis e maneira de manter fluxos críticos operando quando um componente ou organização fica indisponível. A existência e qualidade desses controles não podem ser totalmente inferidos de documentos públicos. São perguntas certas justamente porque o sistema visível cruza tantas fronteiras.
Capacidade, confiabilidade e resultados de pesquisa
O material público inclui vários exemplos de fluxos de pesquisa integrados. Um artigo da ALCF descreve uma equipe liderada por Argonne que diagnosticou e reparou problemas de rede antes de uma demonstração tecnológica no SC19.[17] Outro descreve conexão de supercomputadores e experimentos para acelerar descobertas.[18] Outro artigo discute automação de fluxos de processamento de dados que conectam instrumentos, transferência, armazenamento e computação.[19] A matéria de relatório anual da ALCF sobre Nexus e infraestrutura integrada de pesquisa descreve contas de serviço, movimento suportado por Globus e padrões de workflow sob demanda.[20]
Esses são exemplos úteis, mas respondem perguntas diferentes.
O relato do SC19 sustenta uma alegação detratamento de exceção: uma equipe encontrou problema de rede, investigou, fez mudanças e concluiu a demonstração.[17] Ele não estabelece com que frequência problemas semelhantes ocorrem, qual é o tempo normal de reparo ou se a solução se aplica a todos os caminhos.
As histórias de instrumento para computação sustentam uma alegação decapacidade do sistema: as instalações podem conectar fontes de dados experimentais a fluxos de computação remotos ou sob demanda.[18][19][20] Elas ilustram componentes e padrões de operação. Não estabelecem que todo projeto possa adotar o padrão sem trabalho de integração.
Uma alegação deresultado de pesquisaexigiria uma carga de trabalho nomeada, linha de base, janela de medição e uma conta defensável de causalidade. Alguns relatos públicos de projeto trazem parte desse contexto, mas permanecem restritos ao trabalho descrito. Não são evidência de que Argonne Network, como objeto de diretório, garanta um resultado científico ou ganho de produtividade específico.
Essa separação importa em análise de companhia tecnológica porque alegações de capacidade são frequentemente confundidas com alegações de confiabilidade, e estas depois convertidas em promessas de resultado. Um link de 100 gigabits é um atributo de capacidade. Não significa que uma aplicação sustentará essa taxa. Uma transferência bem-sucedida prova que uma transferência específica terminou sob condições particulares. Não prova serviço contínuo. Um resultado de pesquisa pode depender de movimento de dados mais rápido, mas também depende de qualidade do instrumento, algoritmos, alocação de computação, armazenamento, software e pessoas.
Uma avaliação rigorosa deve fazer, então, três conjuntos de perguntas.
Para capacidade:
- Quais sistemas, protocolos e interfaces estão documentados?
- Quais partes são controladas localmente e quais pertencem a operadores externos?
- Quais identidades e caminhos de autorização são necessários?
- Quais classes de dados, aplicações e limites de segurança estão no escopo?
Para confiabilidade:
- Como a origem pretendida é comparada com observação externa?
- Como falhas físicas, de roteamento, host, armazenamento, identidade e aplicação são distinguidas?
- Quais mudanças são testadas, revertidas e revisadas?
- O que pode continuar quando a superfície de controle normal fica indisponível?
Para resultado:
- Qual carga de trabalho nomeada melhorou?
- Qual era a linha de base e o período de medição?
- Quais restrições mudaram e quais permaneceram?
- É possível separar o efeito da rede de mudanças em computação, armazenamento, software ou método experimental?
As fontes públicas apoiam formular essas perguntas. Elas não fornecem um scorecard completo.
Custo de supervisão
Supervisão é o trabalho necessário para conectar uma mudança tecnicamente possível à intenção institucional autorizada. Em ambiente dual-AS, inclui decidir quem pode alterar registros, política de roteamento, filtros, monitoramento, contatos e acordos de peering/transit externos. Inclui também verificar se a mudança solicitada se aplica a AS683, AS75 ou ambos.
O custo não é apenas tempo de aprovação. O revisor precisa de contexto suficiente para detectar um prefixo inserido no ASN errado, um contato desatualizado, uma política de roteamento que expande além do escopo pretendido ou uma sequência de manutenção que remove ambos os caminhos úteis de uma vez. Esse contexto precisa permanecer disponível conforme mudam equipes, fornecedores, sistemas e demandas de pesquisa.
Ambientes científicos adicionam complexidade de governança. Instalações podem ter agendas operacionais, populações de usuários, requisitos de segurança e janelas de mudança diferentes. Um controle corporativo de campus razoável para um segmento pode interromper um instrumento ou uma computação de longa duração em outro segmento. A supervisão precisa preservar expertise local mantendo accountability institucional.
Um modelo eficaz de supervisão manteria inventário claro de recursos numéricos, contatos autorizados, intenção de rota, dependências externas e proprietários de decisão. Exigiria evidência proporcional à consequência. Uma mudança descritiva pode precisar de uma revisão; uma mudança afetando origem de rota, política de segurança ou continuidade externa pode exigir verificação independente e rollback testado.
O registro público não revela o modelo privado de aprovação da Argonne. Os registros da ARIN estabelecem papéis de contato, e os documentos de instalações estabelecem domínios de responsabilidade.[1][2][14] Esses registros tornam a supervisão um custo operacional visível, ainda que não o quantifiquem.
Custo de integração
O custo de integração surge onde sistemas geridos separadamente precisam funcionar como um único ambiente de pesquisa utilizável. A cadeia visível inclui dados de registro da ARIN, roteamento BGP, infraestrutura de campus, redes de instalação, ESnet e outros provedores externos, sistemas de armazenamento, identidade, serviços de transferência, aplicações, instrumentos e instituições remotas.
Padrões reduzem ambiguidade, mas não eliminam coordenação. O BGP pode trocar rotas enquanto duas organizações discordam sobre política pretendida. Uma ferramenta de transferência pode mover bytes enquanto identidade ou permissões de arquivo tornam o resultado inútil. Um instrumento pode gerar dados mais rápido do que um workflow a jusante consegue validar ou reter. Sistemas de monitoramento podem usar relógios, rótulos e limiares diferentes, tornando difícil uma linha de tempo de incidente compartilhada.
Integração tem lado técnico e lado de propriedade. O lado técnico abrange interfaces, protocolos, nomenclatura, autenticação, capacidade e observabilidade. O lado de propriedade abrange quem pode diagnosticar, quem pode aprovar, quem pode mudar, quem pode comunicar e quem assume risco residual. Falhas ficam caras quando o caminho técnico está visível, mas a autoridade não; ou quando autoridade está clara, porém a evidência necessária fica em outro lugar.
A superfície dual-AS adiciona outra camada de tradução. Equipes internas podem pensar em termos de instalações ou serviços, enquanto operadores externos veem prefixes, caminhos AS, interfaces e circuitos. Um registro útil de incidente precisa conectar essas visões sem expor detalhes sensíveis desnecessariamente.
A orientação pública da ALCF também torna visível a integração do usuário.[10][11][12] Usuários têm responsabilidades de gestão e compartilhamento de dados. Uma equipe central de rede não consegue tornar todo workflow confiável sozinha. Documentação, ferramentas, suporte e feedback devem ajudar usuários a distinguir um problema de rede de comportamento de armazenamento, aplicação ou política.
O custo de integração pode ser reduzido por formatos comuns de evidência, identificadores estáveis, fronteiras claras, observação independente e escalonamento ensaiado. Não é removido apenas comprando mais capacidade.
Custo de manutenção
Manutenção preserva o intervalo entre design documentado e serviço em execução. Inclui ciclo de vida de equipamento e software, revisão de configuração, renovação de certificados e credenciais, manutenção de rotas e filtros, atualização de contatos de registro, mudanças de monitoramento, validação de backup, documentação, planejamento de capacidade e trabalho de infraestrutura física.
O guia de projeto e o plano estratégico mostram que a rede está embutida em prédios de longa duração, sistemas de fibra, data centers e investimento institucional.[15][16] Alguns componentes podem ser atualizados em software; outros exigem trabalho físico, orçamento, licenças, acesso e janelas coordenadas de indisponibilidade. Um desenho lógico pode sobreviver a várias gerações de hardware, enquanto um trajeto físico pode limitar escolhas futuras.
Manutenção também inclui conhecimento. Um procedimento de recuperação pode estar tecnicamente correto, mas inutilizável porque o dono de conta saiu, uma chave expirou, um dispositivo foi substituído ou o contato externo mudou. Procedimentos raramente usados exigem testes precisamente porque podem se degradar silenciosamente.
Demanda de pesquisa não é estática. Novos instrumentos, datasets maiores, motores de workflow diferentes e novos parceiros externos alteram padrões de tráfego. Planejamento de capacidade baseado apenas em média pode ignorar picos e prazos; planejamento baseado apenas em pico pode desperdiçar recursos ou ignorar gargalos em outros pontos. O operador precisa de medição útil tanto para engenharia quanto para priorização.
Manutenção não deve ser confundida com prova de confiabilidade. Um padrão publicado ou plano de investimento mostra que a mantenabilidade está sendo considerada. Confiabilidade exige evidência de que o ambiente em execução é observado, atualizado, testado e recuperável. Fontes públicas não fornecem essa evidência completa.
Custo de resposta a exceções
Tratamento de exceção começa quando a sequência esperada deixa de ser confiável. Uma rota pode ficar visível em alguns coletores e ausente em outros. Uma transferência pode ser lenta apenas para um site remoto. Um token de identidade pode funcionar para um usuário interativo, mas falhar para workflow automatizado. Um evento de manutenção pode expor dependência oculta. Um painel de status pode permanecer verde enquanto o trabalho da aplicação falha.
O estudo de caso da ESnet mostra por que o diagnóstico em camadas importa.[24] Um sintoma descrito como desempenho ruim de rede pode envolver tuning de host, condições de caminho local, roteamento de ampla área ou um endpoint remoto. Adicionar capacidade sem localizar a camada limitada pode manter o problema inalterado. Alterar várias camadas ao mesmo tempo pode tornar incerto o que funcionou.
O tratamento de exceção consome expertise, tempo e coordenação. Os respondentes precisam de linha de tempo compartilhada, identificadores estáveis, observações externas, histórico de configuração e autoridade de mudança clara. Também precisa de contenção. Um probe falho isolado não é prova de indisponibilidade. Um ping bem-sucedido não prova que um fluxo científico funciona. Uma rota anunciada não prova que o serviço pretendido está alcançável ou seguro.
O relato do SC19 mostra uma equipe resolvendo um problema delimitado antes de demonstração.[17] É evidência de que diagnóstico e reparo faziam parte do trabalho. Não é evidência de taxa padrão de incidentes, tempo de resposta típico ou imunidade permanente a falhas semelhantes.
Uma boa resposta de exceção termina com mais do que serviço restaurado. Ela deve preservar o que foi observado, o que mudou, por que a mudança foi autorizada, quais incertezas permanecem e qual controle preventivo merece revisão. Esses registros reduzem o custo do próximo evento e ajudam distinguir falhas sistêmicas recorrentes de sintomas sem relação.
Registro de modos de falha
Os modos a seguir são testes de decisão derivados da superfície de controle pública. Não são alegações de que esses eventos ocorreram na Argonne.
1. Deriva de contato no registro
O registrante permanece correto enquanto um contato técnico ou administrativo fica inacessível, não autorizado ou vinculado a identidade desativada. O roteamento normal pode continuar, deixando a fragilidade oculta até uma mudança de alta consequência. Detectar exige verificação periódica de autoridade e alcançabilidade, não só um campo preenchido.
2. Incompatibilidade de inventário ASN-prefixo
Um inventário interno atribui um prefixo ao ASN errado ou omite uma origem legítima. Uma mudança baseada nesse inventário pode gerar anúncio não intencional ou filtro errado. A reconciliação deve comparar atribuição autorizada, política pretendida, configuração e observação externa.
3. Mudança entre dois ASs confundida com um
Um plano de manutenção pretendido para AS683 é aplicado em AS75, ou uma mudança compartilhada é assumida como cobrir ambos quando não cobre. Nomeação parecida e propriedade comum tornam esse um risco operacional comum. Identificadores estáveis e aprovação por recurso reduzem o risco.
4. Evidência de filtro ou objeto de rota desatualizado
Um upstream ou peer aplica política baseada em registro ou filtro desatualizado. A configuração local pode estar correta enquanto a rota permanece rejeitada. O diagnóstico exige saber qual fonte de dado cada parte externa usa e quando ela foi atualizada.
5. Visibilidade externa parcial
Uma rota é visível em alguns coletores ou provedores, mas ausente em outros. Uma única observação esconda alcance limitado. O operador precisa de múltiplos pontos de observação e definição explícita da intenção de alcançabilidade.
6. Vazamento de rota ou propagação não intencional
Um prefixo é anunciado além da fronteira de política pretendida ou por caminho inesperado. O registro não impede isso sozinho. A detecção depende de observação de rota, comparação de política e contatos responsivos.
7. Atraso de autorização de origem
Metadados de segurança e política de rota em execução ficam inconsistentes durante uma mudança. Um anúncio legítimo pode ser tratado como inválido, ou uma autorização antiga permanece ativa após mudança de intenção. O sequenciamento de mudança e verificação independente são os controles centrais.
8. Modo de falha por caminho físico comum
Dois links lógicos descritos como redundantes compartilham duto, energia, entrada de edifício, equipamento ou autoridade de manutenção. O desenho parece diverso até um único evento físico afetar ambos. A alegação de diversidade requer evidência sobre domínios reais de falha, não apenas nomes de interfaces distintos.
9. Lacuna entre campus e WAN
Uma falha surge entre a fronteira de uma instalação e a fronteira de provedor externo, e nenhum respondedor inicial possui evidência completa. Cada componente pode parecer saudável em seu próprio painel. Um registro de demarcação compartilhada e plano de teste conjunto reduzem essa lacuna.
10. Transferência limitada pelo host
A rede tem capacidade disponível, mas o emissor ou receptor é limitado por CPU, memória, armazenamento, parâmetros de protocolo ou configuração de interface. Tratar o sintoma como problema de capacidade de rede desperdiça tempo e pode introduzir mudanças sem relação.
11. Pressão de armazenamento
Os dados chegam mais rápido do que um nível de armazenamento consegue ingerir, liberar ou tornar disponível para a próxima etapa. Gráficos de rede podem mostrar capacidade ociosa enquanto o workflow atrasa. Observabilidade fim a fim precisa incluir estado de armazenamento.
12. Expiração de identidade durante automação
Uma conta de serviço, certificado, token ou credencial delegada expira durante workflow longo ou não assistido. Testes interativos podem ainda funcionar para um humano. O controle é propriedade de ciclo de vida e teste que exerce a identidade real da automação.
13. Inconsistência de aplicação de política
Documentação permite um fluxo de dados enquanto firewall, lista de acesso ou política de aplicação o bloqueia, ou o contrário. A política escrita e a política em execução divergem. A reconciliação deve testar acesso pretendido e caminhos negados.
14. Incompatibilidade de base temporal
Sistemas registram eventos com relógios, fusos ou retenção inconsistentes. Respondedores não conseguem alinhar mudança de rota, lentidão de transferência, falha de autenticação e evento de armazenamento. Tempo confiável e identificadores comuns são infraestrutura básica de incidente.
15. Cegueira de monitoramento
Monitoramento depende do mesmo caminho, credenciais ou plano de controle que o serviço observado. Uma falha comum faz ambos desaparecerem, ou o monitor reporta sucesso de uma localidade que não representa usuários. Observação independente reduz esse risco.
16. Divergência semântica de painel
Uma equipe reporta disponibilidade de interface, outra reporta alcançabilidade de caminho, e o dono do workflow reporta dados concluídos. Todos usam a palavra "ativo" para condições diferentes. Coordenação de incidente exige métricas e escopos explícitos.
17. Plano estratégico tratado como resiliência concluída
Um plano estratégico descreve redundância futura ou modernização, e leitores posteriores tratam como arquitetura atual. Decisões são tomadas com base em proteção que pode não existir ainda. Planos exigem evidência de conclusão e data efetiva.
18. Padrão tratado como estado instalado
Um guia de projeto especifica práticas de cabeamento ou rede, mas instalações antigas ou excepcionais permanecem. Um padrão melhora consistência futura; não é inventário. Decisões de manutenção precisam de evidência de instalação e teste.
19. Falha de escalonamento com provedor externo
O operador externo correto é identificado, mas o caminho de contato, direito de suporte ou handoff diagnóstico falha. Redundância técnica não ajuda se ninguém consegue autorizar ação. Caminhos de escalonamento devem ser testados antes de incidente.
20. Mudança emergencial excessiva
Respondedores alteram várias rotas, filtros, hosts ou serviços ao mesmo tempo para restaurar workflow crítico. O serviço retorna, mas causalidade e rollback ficam obscuros, e uma falha limitada pode se expandir. Hipóteses controladas e etapas reversíveis reduzem raio de impacto.
21. Configuração de recuperação incompleta
Um backup contém configuração de dispositivo ou serviço, mas omite credenciais, certificados, política externa, versões de dependência ou contexto de aprovação. A restauração produz sistema sintaticamente válido, porém inutilizável. Testes de recuperação devem validar comportamento do serviço, não só presença de arquivo.
22. Deriva de dependência de workflow científico
Um workflow adiciona silenciosamente novo endpoint, formato de dado, escopo de identidade ou suposição temporal. Rede e segurança permanecem baseados no desenho anterior. O primeiro sintoma visível surge em execução de alto valor. A propriedade de mudança precisa cobrir aplicação e infraestrutura.
23. Mal-entendido de retenção de dados
Usuários assumem que uma instalação ou serviço de transferência retém dados por mais tempo que o documentado, ou operadores assumem que usuários mantiveram cópia durável. Uma transferência bem-sucedida é seguida por perda ou inacessibilidade. Fronteiras de retenção e verificação pertencem ao workflow.
24. Assimetria entre sites remotos
O caminho Argonne funciona para um colaborador e não para outro por diferença na rede remota, política, host ou rota. Um teste local de sucesso é tratado como prova universal. Antes de atribuir causa, é preciso evidência comparativa de caminho.
25. Superextensão de demonstração para produção
Uma demonstração de pesquisa prova que uma integração pode funcionar em condições preparadas. Depois, é tratada como evidência de que usuários rotina recebem mesma confiabilidade e suporte. Prontidão de produção exige operação repetida, ownership, recuperação e comportamento de serviço medido.
Uma estrutura prática de avaliação
Uma revisão responsável do Argonne Network deve começar pelos registros responsáveis e avançar para o comportamento em execução.
Primeiro, confirmar identidade. Registrar entidade do diretório, registrante da ARIN, números AS, grupos de contato e data da observação. Registrar ambiguidade em vez de resolver por suposição de nomeação.
Segundo, definir roteamento pretendido. Listar prefixos esperados em cada ASN, origens autorizadas, relacionamentos externos necessários para cada rota e metadados de segurança que devem acompanhá-los. Comparar essa intenção com observações externas em múltiplos pontos.
Terceiro, mapear o workflow em vez de só a ligação. Identificar produtor ou instrumento, armazenamento local, identidade, caminho de campus, rede externa, armazenamento ou computação remota, camada de orquestração e proprietário em cada fronteira. Definir o que significa "funcionando" em cada camada.
Quarto, separar testes de capacidade de evidência de confiabilidade. Uma resposta de protocolo ou transferência com sucesso é uma observação de capacidade. Confiabilidade exige medição repetida, comportamento de manutenção, recuperação e janela de observação conhecida. Não transformar sucesso pontual em percentual de disponibilidade.
Quinto, medir resultado somente no nível suportado por evidência. Se projeto nomeado reporta resultado, preservar escopo do projeto, linha de base e dependências. Não atribuir toda melhoria à rede sem isolar contribuição de rede no estudo.
Sexto, testar portabilidade e continuidade. Perguntar o que acontece se conta de registro fica indisponível, contato está obsoleto, um ASN é retirado, caminho de campus falha, provedor externo fica indisponível, serviço de identidade falha ou endpoint de armazenamento não aceita dados. Verificar se autoridade, evidência e acesso à recuperação sobrevivem ao mesmo evento.
Sétimo, examinar portabilidade e lock-in. Neste contexto, lock-in não é apenas contrato de fornecedor. Inclui configurações, política de rota, histórico de monitoramento, credenciais, conhecimento específico de instalação e dependências externas que não podem ser reproduzidas ou repassadas. O sistema é mais portátil quando outra equipe autorizada consegue entender intenção, restaurar comportamento essencial e validar resultado.
Por fim, preservar incerteza. Observações de rota públicas mudam. Páginas de instalação descrevem ambientes delimitados. Relatórios têm data. Planos podem descrever trabalho futuro. Estudos de caso selecionam eventos notáveis. Uma análise sólida declara exatamente qual camada e período cada fonte sustenta.
A imagem é contexto, não prova
A fotografia em destaque mostra equipamentos de computação no Center for Nanoscale Materials do Argonne National Laboratory. É usada como contexto visual de computação física e trabalho de cabeamento. Não mostra a Argonne Network Administration, roteamento do AS683 ou AS75, backbone do campus, conexão ESnet ou MREN, topologia privada, controles atuais de segurança, incidentes, confiabilidade medida ou resultados de usuário.
Essa fronteira é substancial. Fotografias de infraestrutura podem tornar o artigo mais concreto enquanto sugerem mais do que comprovam. Racks e cabos visíveis não revelam política de rota, redundância, capacidade, propriedade, configuração atual ou qualidade operacional. As alegações factuais deste artigo vêm dos registros de registro, instalações, operadores e fontes reportadas, não da inferência visual.
Conclusão
Argonne Network é melhor entendido como uma superfície real de controle de administração de rede vinculada às identidades registradas AS683 e AS75 do Argonne National Laboratory, e não como operador comercial autônomo inventado.
Registros da ARIN estabelecem a relação com registrante e função técnica de contato.[1][2] Serviços públicos de roteamento oferecem observações delimitadas.[3][4][5][6][7][8] Materiais de instalações da Argonne e da ESnet explicam por que identidade de rota, infraestrutura de campus, conectividade externa, armazenamento, segurança e integração de workflow importam para operação científica.[9][10][11][12][13][14][15][16][17][18][19][20][21][22][23][24][25]
As evidências sustentam uma narrativa forte de capacidade: instalações de pesquisa podem conectar instrumentos, armazenamento, computação e redes externas por meio de sistemas e relacionamentos operacionais documentados. Sustentam exemplos de diagnóstico e integração de fluxos. Não sustentam um escore de confiabilidade universal, uma alegação de arquitetura privada ou promessa de resultados para clientes.
A questão de engenharia duradoura é continuidade. Dois ASNs, múltiplas instalações, provedores externos, armazenamento compartilhado, sistemas de identidade e aplicações científicas têm de permanecer alinhados durante mudanças e falhas. Esse alinhamento gera custos recorrentes de supervisão, integração, manutenção e resposta a exceções. A precisão do registro importa porque ancora autoridade. A observação de rota em execução importa porque registros sozinhos não movem tráfego. Recuperação importa porque a pesquisa não pode depender de todos os controles normais de operação permanecerem disponíveis ao mesmo tempo.
Para compradores, colaboradores e revisores técnicos, o teste útil não é se a Argonne publica declaração de capacidade impressionante ou demonstração bem-sucedida. É se registros responsáveis, rotas pretendidas, comportamento observado, dependências de workflow e autoridade de recuperação podem ser reconciliados quando mais precisam. A evidência pública mostra a forma dessa responsabilidade. Reivindicações sobre desempenho medido exigem dados operacionais que não são públicos.
Fontes
Plano estratégico de investimentos em instalações e infraestrutura da Argonne (2024)
Equipe liderada pela Argonne resolve problemas de rede antes de demonstração no SC19
Integrando supercomputadores e experimentos para acelerar descobertas
Relatório anual da ALCF: Nexus e infraestrutura integrada de pesquisa
História da ESnet: software-defined networking para definir melhor funcionalidades
Wikimedia Commons: Nanoscience High-Performance Computing Facility
Briefing para membros
Contexto aprofundado do perfil
Faça login com o nível de assinatura correto para desbloquear o briefing completo e as notas das fontes.
Apenas para Strategic Circle
Strategic Circle
Aberto a todos os leitores. Desbloqueie Briefings de perfil após se inscrever e fazer login.
Junte-se ao Strategic CircleSomente para Leadership Alliance
Leadership Alliance
Para proprietários e gestores qualificados de ativos de PI; faça login para desbloquear os briefings da Leadership Alliance.
Junte-se ao Leadership Alliance